Article original
Let's Verify Step by Step
- Publication
- ICLR 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2305.20050
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningletsverify2023,
  title = {{Let's Verify Step by Step}},
  author = {Hunter Lightman and Vineet Kosaraju and Yura Burda and Harri Edwards and Bowen Baker and Teddy Lee and Jan Leike and John Schulman and Ilya Sutskever and Karl Cobbe},
  year = {2023},
  eprint = {2305.20050},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.20050}
}
La solution d'un problème de maths, c'est souvent une longue chaîne d'une bonne dizaine d'étapes. Qu'une seule soit fausse, et la réponse le sera aussi, si soignée que soit la suite ; plus gênant encore, il arrive qu'une erreur au milieu aboutisse par chance à la bonne réponse.
Pour rendre un modèle plus fiable, on entraîne souvent un modèle de récompense chargé de distinguer les bonnes solutions des mauvaises. Il peut servir à l'apprentissage par renforcement, ou, à l'inférence, à choisir la meilleure parmi de nombreuses candidates. Dans les deux cas, le système entier n'est au mieux qu'aussi fiable que son modèle de récompense.
Mais comment entraîner ce modèle de récompense ? En 2022, Uesato et al., chez DeepMind, ont comparé deux approches : la supervision du résultat, qui ne regarde que la justesse de la réponse finale, et la supervision du processus, qui vérifie chaque étape une à une. Sur GSM8K, des problèmes de maths de niveau primaire, les deux donnaient des performances finales comparables.
Lightman et al., chez OpenAI, ont refait la comparaison, cette fois avec un modèle plus puissant (GPT-4), beaucoup plus d'annotations humaines et des problèmes bien plus difficiles (MATH, niveau concours de lycée). La conclusion a changé.
Définir le problème
Les deux types de modèles de récompense diffèrent par leur signal d'entraînement :
- Modèle de récompense supervisé par le résultat (ORM) : il apprend à prédire si une solution entière est juste ou fausse. Les étiquettes peuvent être produites automatiquement, puisque chaque problème de MATH a une réponse finale vérifiable automatiquement. À l'inférence, la prédiction du modèle sur le dernier token sert de score à la solution.
- Modèle de récompense supervisé par le processus (PRM) : il apprend à prédire si chaque étape est juste ou fausse. Cela ne se juge pas automatiquement ; il faut que des humains annotent étape par étape.
Les étiquettes de l'ORM ont une faille inhérente ; une solution au raisonnement faux, mais dont la réponse tombe juste par hasard, est étiquetée correcte.
L'article n'étudie que le modèle de récompense lui-même ; il ne s'en sert pas pour entraîner par renforcement le modèle qui produit les solutions. L'évaluation se fait en best-of-N. On fixe un modèle qui produit les solutions (le générateur), on échantillonne N solutions par problème, le modèle de récompense choisit celle qui a le meilleur score, et l'on mesure la part de problèmes résolus. Plus le modèle de récompense est fiable, plus il tombe souvent sur une solution correcte.
Résoudre le problème
Deux échelles de modèles
Les modèles à grande échelle sont tous fine-tunés à partir du modèle de base de GPT-4. Ce modèle de base n'a subi que le préentraînement par prédiction du token suivant, sans RLHF. L'objectif est d'obtenir les meilleurs ORM et PRM possibles.
Les modèles à petite échelle ont une architecture proche de celle de GPT-4, mais leur préentraînement a demandé environ 200 fois moins de calcul ; ils servent aux expériences de contrôle qu'on ne peut pas se permettre à grande échelle.
Tous les modèles passent d'abord par une étape d'entraînement supplémentaire sur MathMix, environ 1.5 milliard de tokens de données mathématiques, qui améliore le raisonnement mathématique.
Le modèle qui produit les solutions est lui aussi fine-tuné. Les auteurs lui font résoudre les problèmes d'entraînement de MATH par prompting few-shot, gardent les solutions correctes et entraînent le modèle dessus pendant une epoch, dans le seul but de lui apprendre un format d'une étape par ligne, qui facilite le découpage en étapes, et non de lui enseigner de nouvelles compétences.
Annoter étape par étape
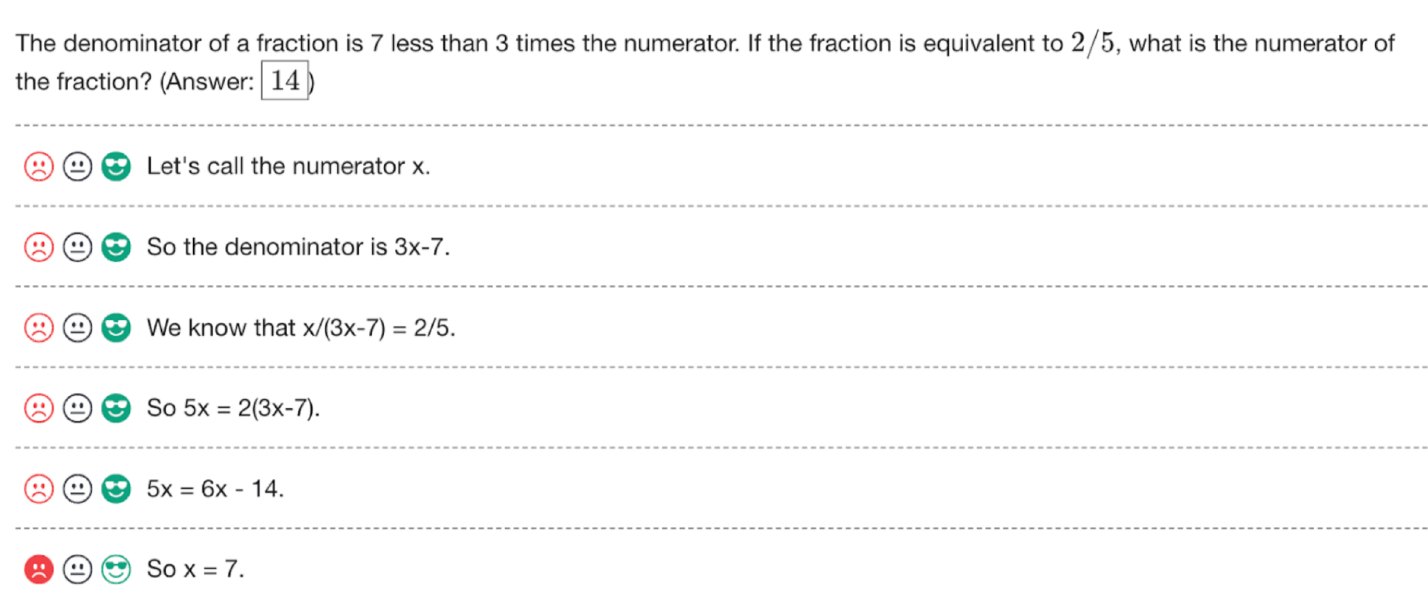
Les annotateurs lisent les solutions écrites par le générateur à grande échelle et attribuent à chaque étape l'une de trois étiquettes :
- Positive : l'étape est correcte, raisonnable, et fait progresser vers la réponse.
- Négative : l'étape est fausse ou déraisonnable.
- Neutre : cas ambigu, par exemple une étape un peu trompeuse, ou techniquement correcte mais qui ne va pas dans une bonne direction.
Garder l'option neutre permet de repousser la décision sur le traitement des cas ambigus ; à l'inférence, on peut compter une étape neutre comme positive ou comme négative. Les annotateurs reçoivent la bonne réponse finale, mais pas de solution de référence, pour qu'ils ne privilégient pas une seule façon de résoudre le problème.
Le tout forme PRM800K : 800 000 étiquettes d'étapes, sur 75 000 solutions de 12 000 problèmes. Faute de problèmes en nombre suffisant, les auteurs ont aussi pris 4 500 problèmes du jeu de test de MATH comme problèmes d'entraînement, et l'évaluation ne porte que sur les 500 problèmes restants, tirés au hasard. L'annexe confirme que ces 500 problèmes ont une difficulté et une répartition par matière proches de celles du jeu de test complet.
Quelles solutions faire annoter ?
L'annotation coûte cher ; il faut donc choisir des solutions riches en information. Une solution manifestement fausse n'apprend pas grand-chose, même une fois annotée.
La stratégie des auteurs consiste à choisir des « mauvaises réponses convaincantes », auxquelles le meilleur PRM du moment donne un score élevé alors que la réponse finale est fausse. Puisque la réponse est fausse, le PRM s'est trompé sur au moins une étape ; faire indiquer par un humain laquelle, c'est combler un angle mort du PRM. Pendant la collecte des données, le PRM est réentraîné plusieurs fois sur les annotations les plus récentes avant le choix du lot suivant.
Entraîner le PRM et calculer le score
Après le dernier token de chaque étape, le PRM prédit un token qui indique si l'étape est juste ou fausse ; on maximise la log-vraisemblance de ce token comme pour l'entraînement d'un modèle de langage ordinaire, sans architecture particulière. À l'inférence, une seule passe avant sur la solution entière donne le score de chaque étape.
Le score d'une solution est défini comme la probabilité que « toutes les étapes soient correctes », c'est-à-dire le produit des probabilités de chaque étape. Reprenons le problème de l'interface d'annotation. Les cinq premières étapes sont justes ; de 5x = 6x − 14, on devrait tirer x = 14, mais la dernière étape écrit x = 7. Il suffit qu'une étape ait une probabilité très faible pour que le produit soit très faible, et le PRM peut en plus indiquer à quelle étape se trouve l'erreur.
Le produit a aussi un effet secondaire ; plus il y a d'étapes, plus il diminue. Une solution de douze étapes à 0.95 chacune obtient environ 0.54, moins qu'une solution de deux étapes à 0.8 chacune (0.64). En annexe, les auteurs comparent quatre façons de calculer le score (étape neutre comptée positive ou négative, produit ou minimum), avec des écarts très faibles :
| Étape neutre | Produit | Minimum |
|---|---|---|
| Comptée positive | 78.2 | 77.6 |
| Comptée négative | 77.4 | 77.8 |
D'après la Table 4 de l'annexe de l'article ; % de problèmes résolus en best-of-1860.
L'article utilise partout la meilleure case, neutre comptée positive avec le produit. Les auteurs reconnaissent aussi que le produit désavantage légèrement les solutions qui comptent beaucoup d'étapes.
N'annoter que jusqu'à la première erreur
La supervision du processus n'annote que jusqu'à la première étape fausse ; la suite n'est pas annotée. La comparaison entre les deux supervisions en devient plus équitable.
Pour une solution correcte, les deux supervisions apportent la même information, à savoir que chaque étape est juste. Pour une solution fausse, toutes deux savent qu'elle contient une erreur, et la supervision du processus sait en plus à quelle étape. Si l'on continuait d'annoter après la première erreur, l'avantage en information de la supervision du processus serait encore plus grand.
Cela rend aussi le coût humain comparable. Sans réponse finale à laquelle se comparer, juger si une solution est juste revient de toute façon à trouver sa première erreur. Les problèmes de MATH ont tous une réponse facile à vérifier, mais les auteurs s'attendent à ce que cette condition ne tienne pas toujours dans des domaines plus complexes.
Discussion
À grande échelle, le PRM l'emporte nettement
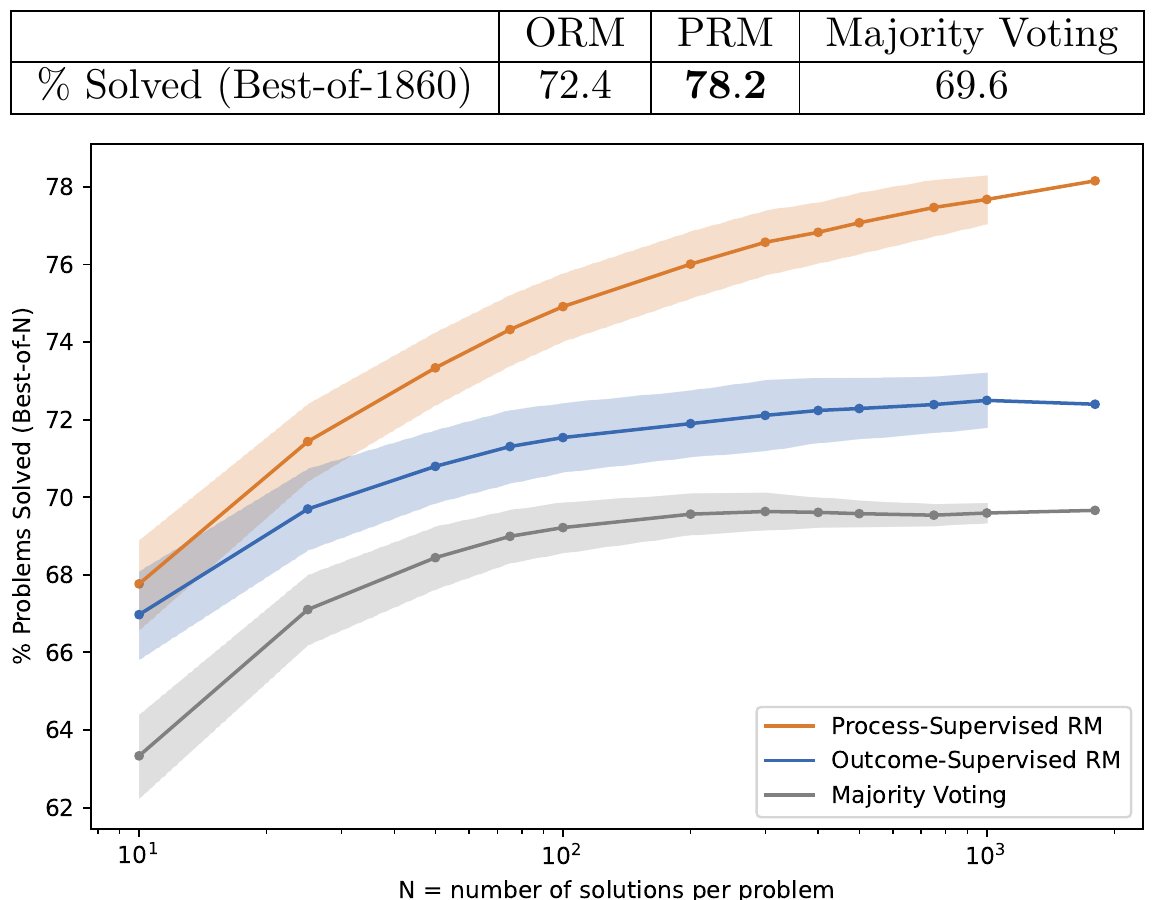
Pour rendre l'ORM aussi fort que possible, les auteurs l'entraînent sur 100 solutions échantillonnées uniformément par problème, soit un ordre de grandeur de plus que PRM800K, sans aucun recouvrement entre les deux jeux de données.
En choisissant une solution parmi 1 860 par problème, le PRM résout 78.2 % des problèmes, l'ORM 72.4 % et le vote majoritaire 69.6 %. L'ORM ne fait qu'un peu mieux que le vote majoritaire, alors que le PRM les dépasse nettement tous les deux, et l'écart grandit avec N. Pour trouver la bonne solution parmi un grand nombre de candidates, c'est le PRM qui est le plus fiable.
Les auteurs ont aussi essayé de pondérer le vote majoritaire par le score du modèle de récompense, dans l'espoir de cumuler les avantages des deux, sans gain notable.
À petite échelle, démêler les facteurs de confusion
Les résultats à grande échelle comportent deux facteurs de confusion. D'abord, les deux modèles n'ont pas les mêmes données d'entraînement ; celles du PRM ont été sélectionnées activement, penchent vers les mauvaises réponses et sont plus petites d'un ordre de grandeur. Ensuite, juger d'après la réponse finale fait étiqueter comme correctes les solutions « au raisonnement faux mais à la réponse juste », ce qui pénalise l'ORM ; faut-il l'imputer à la supervision du résultat elle-même ? Les avis peuvent diverger.
Les annotations humaines coûtent trop cher pour ces expériences de contrôle. Les auteurs prennent donc le PRM à grande échelle (ci-après PRMlarge) comme annotateur pour produire les étiquettes des petits modèles, une façon peu coûteuse de simuler une collecte de données massive.
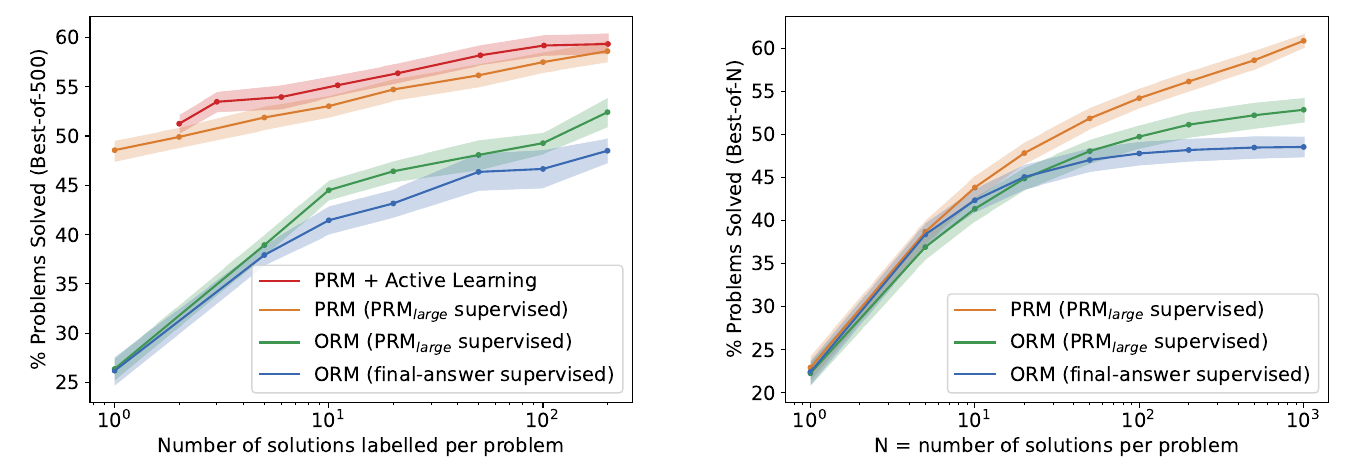
On échantillonne de 1 à 200 solutions par problème, et les mêmes données reçoivent trois supervisions : la supervision du processus, avec une annotation étape par étape par PRMlarge ; la supervision du résultat, PRMlarge jugeant seulement la solution entière ; et la supervision du résultat par comparaison avec la réponse finale. La seule différence entre les trois groupes de modèles est le mode de supervision.
Quelle que soit la quantité de données, la supervision du processus l'emporte nettement sur les deux supervisions du résultat. Entre ces deux dernières, celle qui s'appuie sur le jugement de PRMlarge fait mieux que la comparaison avec la réponse finale, parce qu'elle peut juger fausses les solutions « au raisonnement faux mais à la réponse juste ».
Pour les auteurs, le groupe jugé par PRMlarge est le point de comparaison le plus pertinent. Dans les domaines où ce genre de faux positifs est rare, la supervision du résultat se comporterait plutôt comme lui ; dans MATH, le problème des faux positifs est peut-être amplifié.
Apprentissage actif : on entraîne d'abord un petit PRM sur 1 solution par problème, puis on lui fait noter 1 000 solutions par problème. On en choisit ensuite N par problème, dont 80 % sont les mauvaises réponses qu'il a le mieux notées et 20 % les solutions les mieux notées parmi celles qui restent (justes ou fausses), et on les fait annoter par PRMlarge. D'après les pentes des deux droites d'ajustement, cet apprentissage actif est environ 2.6 fois plus efficace en données que la sélection uniforme.
À 200 solutions par problème, la performance passe légèrement sous la tendance. Selon les auteurs, 200 solutions représentent déjà un cinquième des 1 000 candidates, et la diversité disponible ne suffit plus. Ils ont aussi essayé de réentraîner à plusieurs reprises le PRM de sélection pendant la collecte, mais se sont heurtés à des instabilités qu'ils n'ont pas su diagnostiquer, sans obtenir de meilleurs résultats.
Des problèmes jamais vus
Les problèmes de MATH circulent beaucoup sur Internet et ont pu se retrouver dans les données de préentraînement. Les auteurs ont donc rassemblé des sujets récents d'AP Physics, d'AP Calculus, d'AP Chemistry, de l'AMC10 et de l'AMC12, tous publiés après la fin de la collecte des données de préentraînement. On échantillonne 100 solutions par problème :
| Examen | ORM | PRM | Vote maj. | Problèmes |
|---|---|---|---|---|
| AP Calculus | 68.9% | 86.7% | 80.0% | 45 |
| AP Chemistry | 68.9% | 80.0% | 71.7% | 60 |
| AP Physics | 77.8% | 86.7% | 82.2% | 45 |
| AMC10/12 | 49.1% | 53.2% | 32.8% | 84 |
| Total | 63.8% | 72.9% | 61.3% | 234 |
D'après la Table 1 de l'article.
Les résultats concordent avec ceux de MATH ; le PRM l'emporte sur l'ORM et sur le vote majoritaire. Sur des problèmes difficiles comme ceux de l'AMC, le vote majoritaire n'obtient que 32.8 %, contre 53.2 % pour le PRM.
Pourquoi la supervision du processus fait mieux
Les auteurs l'expliquent par l'attribution du crédit. La supervision du résultat dit seulement au modèle « cette solution est fausse », et le modèle doit deviner lui-même où se trouve l'erreur ; plus les problèmes sont difficiles, plus les solutions du modèle sont fausses, jusqu'à l'être presque toutes, et moins l'étiquette « fausse » apporte d'information. La supervision du processus dit directement au modèle que les premières étapes sont justes et à quelle étape se trouve l'erreur ; le signal est bien plus riche.
Les auteurs abordent aussi la question sous l'angle de l'alignement. La supervision du processus récompense un raisonnement approuvé par des humains, plutôt que le seul résultat ; elle est plus facile à interpréter et incite moins le modèle à exploiter les failles de la récompense. Les approches plus sûres obligent souvent à sacrifier un peu de performance, ce qu'on appelle la taxe d'alignement (alignment tax) ; ici, la supervision du processus, plus sûre, donne au contraire de meilleurs résultats, ce que les auteurs appellent une taxe d'alignement négative. Ils préviennent aussi qu'on ne sait pas encore si cette conclusion se généralise au-delà des mathématiques.
Limites
- Contamination du jeu de test : les auteurs ont retiré les problèmes de MATH de MathMix par correspondance de chaînes, mais des versions reformulées difficiles à repérer peuvent circuler en ligne, et rien ne garantit des données parfaitement propres. En examinant les solutions du modèle, ils n'ont pas vu de signe flagrant de réponses apprises par cœur ; et même avec un peu de contamination, l'effet devrait être semblable pour toutes les méthodes, si bien que la comparaison relative resterait à peu près valable. Le PRM sait d'ailleurs souvent repérer des solutions correctes que le générateur lui-même n'écrit qu'avec une probabilité de quelques pour cent, ce qui va dans le même sens.
- Seul le modèle de récompense est étudié : le PRM ne sert pas à entraîner le générateur par apprentissage par renforcement ; les auteurs laissent cela à des travaux futurs.
- Le coût humain : les 800 000 étiquettes d'étapes de PRM800K reposent sur une masse d'annotations humaines, et l'expérience ne porte que sur les mathématiques.
La suite
Ces 500 problèmes de test sont ensuite devenus MATH-500, l'un des benchmarks les plus courants pour les modèles de raisonnement. DeepSeek-R1 y obtient un pass@1 de 97.3 %.
Au problème du coût de l'annotation humaine, une solution de rechange est vite apparue. En décembre 2023, Math-Shepherd se passe d'annotateurs ; à partir de chaque étape, il fait écrire au modèle plusieurs solutions complètes, regarde combien aboutissent à la bonne réponse, et prend cette proportion comme mesure de la qualité de l'étape. Ses auteurs recoupent en partie ceux de DeepSeekMath.
Le PRM est aussi devenu l'outil principal de la recherche à l'inférence ; il note les candidates à chaque étape et décide dans quelle direction développer l'arbre. Dans ses « tentatives infructueuses », DeepSeek-R1 relève pourtant trois problèmes du PRM. Pour une tâche de raisonnement générale, il est difficile de définir clairement chaque étape ; pour juger les étapes intermédiaires, l'annotation automatique manque de précision et l'annotation humaine passe mal à l'échelle ; enfin, en apprentissage par renforcement à grande échelle, un modèle utilisé comme récompense voit facilement ses failles exploitées. L'équipe a finalement opté pour une récompense à base de règles, qui ne regarde que la justesse de la réponse.
Conclusion
Sur des problèmes difficiles comme ceux de MATH, un modèle de récompense entraîné par supervision du processus, avec une annotation étape par étape, est nettement plus fiable qu'un modèle entraîné par supervision du résultat, qui ne regarde que la réponse. En choisissant une solution parmi 1 860, le PRM résout 78.2 % des problèmes, l'ORM 72.4 % et le vote majoritaire 69.6 % ; les expériences de contrôle à petite échelle confirment qu'à données égales, la supervision du processus reste en tête de bout en bout.
Le prix à payer, ce sont 800 000 étiquettes humaines. L'apprentissage actif permet d'en économiser une partie ; en faisant annoter « les solutions fausses qui ont trompé le PRM », on gagne environ un facteur 2.6 en efficacité, mais il faut toujours que quelqu'un relise chaque étape.
Ce qui a laissé le plus de traces, ce sont peut-être deux sous-produits de l'article, le jeu de données PRM800K et ces 500 problèmes de test. Le premier a servi à entraîner d'innombrables modèles de récompense ; les seconds sont devenus MATH-500, qui figure encore aujourd'hui dans le bulletin de notes de chaque modèle de raisonnement.