Article original
Self-Consistency Improves Chain of Thought Reasoning in Language Models
- Publication
- ICLR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2203.11171
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformersselfconsistency2022,
  title = {{Self-Consistency Improves Chain of Thought Reasoning in Language Models}},
  author = {Xuezhi Wang and Jason Wei and Dale Schuurmans and Quoc Le and Ed Chi and Sharan Narang and Aakanksha Chowdhery and Denny Zhou},
  year = {2022},
  eprint = {2203.11171},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.11171}
}
En janvier 2022, Wei et al., chez Google, présentent le prompting par chaîne de pensée, qui fait écrire au modèle les étapes de son raisonnement avant la réponse ; sur les problèmes de mathématiques, les scores font un bond.
L'article de Wei et al. décodait pourtant de façon très prudente. Comme les problèmes de raisonnement ont une réponse fixe, on utilisait d'habitude le décodage glouton, qui choisit à chaque pas le token le plus probable et ne produit finalement qu'un seul raisonnement. Une seule erreur de calcul en cours de route, et la réponse est fausse, sans possibilité de rattrapage.
Deux mois plus tard, Wang et al., de la même équipe, changent d'approche. Ils font résoudre plusieurs fois le même problème au modèle, qui emprunte chaque fois un chemin différent, puis regardent quelle réponse revient le plus souvent.
Définir le problème
Quand on résout un problème, plusieurs façons de raisonner mènent souvent à la même réponse. Les auteurs font l'hypothèse qu'il en va de même pour les problèmes de raisonnement complexes ; les raisonnements corrects, même rédigés différemment, aboutissent à la même réponse, tandis que les raisonnements faux se trompent chacun à leur manière, et leurs réponses sont plus dispersées.
Si cette hypothèse tient, inutile de savoir quel raisonnement est le bon ; il suffit de regarder si les réponses « se rejoignent ».
Jusque-là, pour choisir la bonne réponse parmi plusieurs candidates, il fallait en général entraîner un modèle supplémentaire. Cobbe et al. ont entraîné sur GSM8K un vérificateur chargé de classer les solutions ; LaMDA a collecté des annotations humaines supplémentaires pour entraîner un modèle de reclassement. Cet article vise à se passer d'entraînement, d'annotations et de modèle supplémentaire, en utilisant directement un modèle de langage existant.
Résoudre le problème
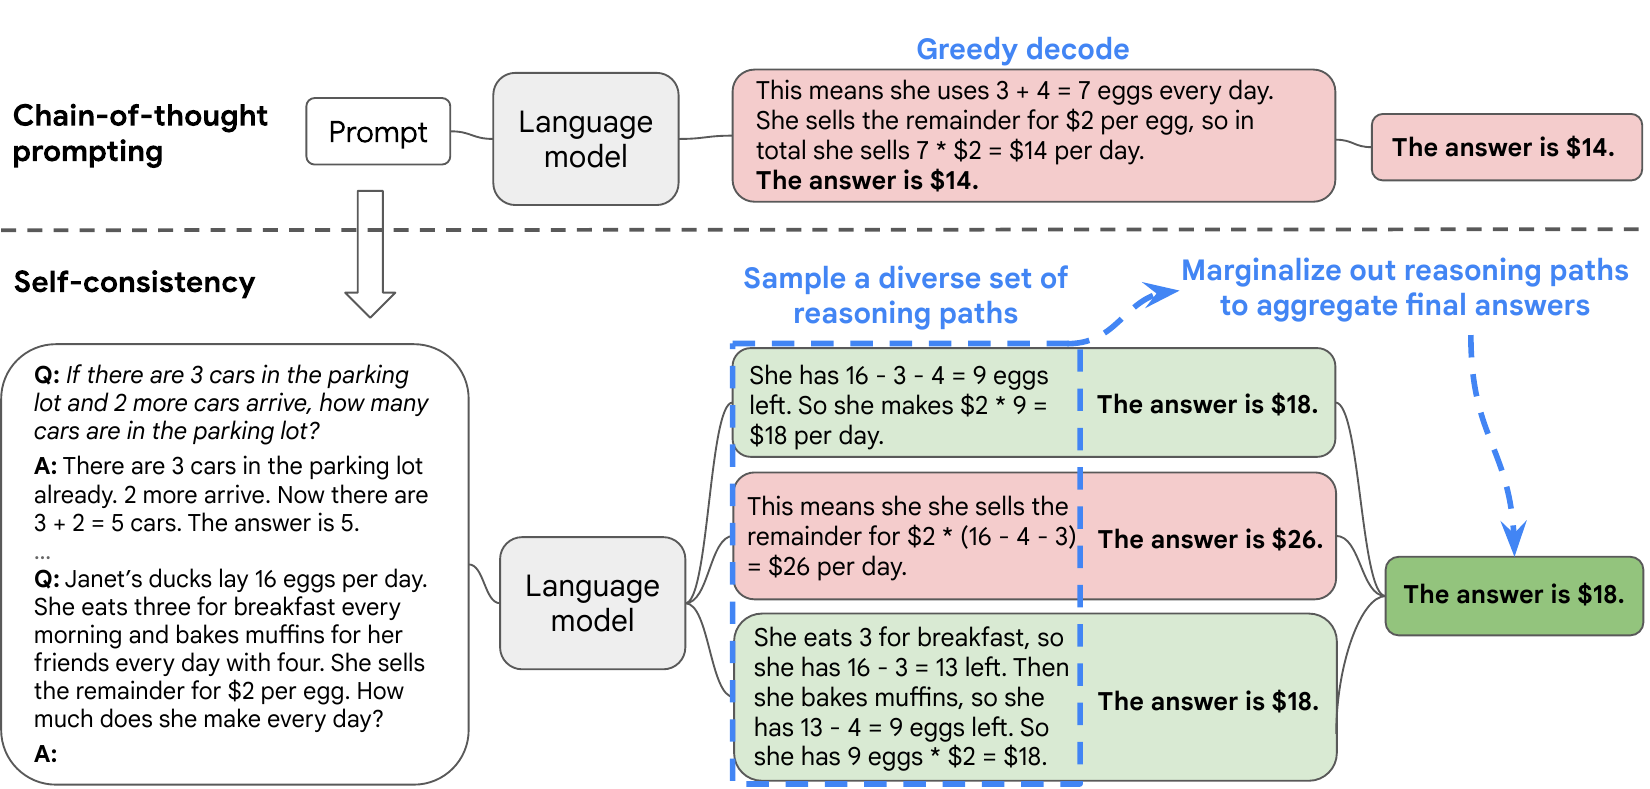
La méthode tient en trois étapes :
- Comme avant, on utilise comme prompt des exemples de chaîne de pensée écrits à la main.
- Au lieu du décodage glouton, on échantillonne sorties depuis le décodeur du modèle, chacune avec son raisonnement et sa réponse.
- On extrait de chaque sortie la réponse qui suit le « The answer is » final, et l'on retient celle qui revient le plus souvent.
L'exemple de la figure est un problème de GSM8K. Les canes de Janet pondent 16 œufs par jour ; elle en mange 3 au petit-déjeuner, en utilise 4 pour des muffins et vend les autres 2 dollars pièce. Combien gagne-t-elle par jour ? Le décodage glouton additionne les œufs mangés et utilisés, soit 7, oublie de les retrancher des 16 et multiplie directement 7 par 2, ce qui donne 14 dollars. Parmi les trois raisonnements échantillonnés, deux arrivent à 18 dollars par des chemins différents, et le troisième se trompe et trouve 26 dollars. Le vote donne 18.
Pourquoi parler de « marginalisation »
Les auteurs décomposent la -ième sortie en un raisonnement et une réponse . Seule la réponse nous intéresse vraiment, le raisonnement n'étant qu'un produit intermédiaire ; on somme donc sur tous les raisonnements, pour ne regarder que le nombre de voix obtenues par chaque réponse :
C'est un vote majoritaire. Le nom fait savant, mais en pratique, on compte les voix.
Faut-il pondérer par la probabilité ?
Puisque le modèle attribue une probabilité à chaque sortie, on pourrait aussi donner plus de voix aux raisonnements les plus probables. Les auteurs essaient plusieurs pondérations ; « normalisée » signifie ici que la log-probabilité de la sortie entière est divisée par son nombre de tokens, pour éviter que les raisonnements longs soient pénalisés parce qu'ils multiplient davantage de probabilités :
Résultats sur PaLM 540B :
| Mode de vote | GSM8K | MultiArith | AQuA | SVAMP |
|---|---|---|---|---|
| Décodage glouton | 56.5 | 94.7 | 35.8 | 79.0 |
| Moyenne pondérée (non normalisée) | 56.3 | 90.5 | 35.8 | 73.0 |
| Moyenne pondérée (normalisée) | 22.1 | 59.7 | 15.7 | 40.5 |
| Somme pondérée (non normalisée) | 59.9 | 92.2 | 38.2 | 76.2 |
| Somme pondérée (normalisée) | 74.1 | 99.3 | 48.0 | 86.8 |
| Sans pondération (vote majoritaire) | 74.4 | 99.3 | 48.3 | 86.6 |
D'après la Table 1 de l'article ; quatre jeux de données arithmétiques seulement, valeurs en %.
La somme pondérée normalisée donne presque exactement le même résultat que le simple décompte des voix. En regardant de plus près, les auteurs constatent qu'après normalisation, les probabilités des différents raisonnements sont très proches ; pour le modèle, ils sont « à peu près aussi probables » les uns que les autres. Autrement dit, le modèle distingue mal lequel de ses raisonnements est correct, et c'est bien pour cela que les travaux antérieurs entraînaient à part un modèle de classement. Puisque la pondération n'aide pas, autant compter les voix.
La « moyenne pondérée », elle, divise la somme pondérée de chaque réponse par son nombre de voix, ce qui revient à ignorer combien de voix elle a recueillies ; les résultats sont nettement moins bons.
La méthode suppose que les réponses appartiennent à un ensemble fixe, sans quoi on ne peut pas dire si deux réponses sont identiques. Un nombre pour un problème de maths ou une option pour un QCM, cela ne pose aucune difficulté ; pour de la génération ouverte, en revanche, cela ne marche pas, à moins de définir à part ce que veut dire, pour deux textes, être « cohérents ».
Dispositif expérimental
- Tâches : en raisonnement arithmétique, AddSub, MultiArith, ASDiv, AQuA, GSM8K et SVAMP ; en sens commun, CommonsenseQA, StrategyQA et ARC ; en raisonnement symbolique, la concaténation de lettres et la pièce retournée, où les exemples ne montrent que deux mots ou deux retournements, alors que le test en compte quatre.
- Modèles : UL2 20B, GPT-3 175B (via code-davinci-001 et 002, de la série Codex), LaMDA 137B et PaLM 540B. Tout passe par le prompt, sans aucun fine-tuning.
- Prompts : les mêmes que dans l'article sur la chaîne de pensée ; tous les problèmes arithmétiques partagent le même jeu de 8 exemples écrits à la main.
- Échantillonnage : température 0.5 et top-k 40 pour UL2 et LaMDA ; température 0.7 et top-k 40 pour PaLM ; température 0.7 sans troncature pour GPT-3. Chaque fois, on échantillonne 40 sorties, et l'on fait la moyenne sur 10 répétitions.
Discussion
Tous les modèles progressent
| Modèle | GSM8K | SVAMP | AQuA |
|---|---|---|---|
| UL2 20B | 4.1 → 7.3 | 12.6 → 19.4 | 23.6 → 26.9 |
| LaMDA 137B | 17.1 → 27.7 | 38.9 → 53.3 | 17.7 → 26.8 |
| PaLM 540B | 56.5 → 74.4 | 79.0 → 86.6 | 35.8 → 48.3 |
| code-davinci-001 | 14.6 → 23.4 | 39.8 → 54.5 | 18.9 → 25.6 |
| code-davinci-002 | 60.1 → 78.0 | 75.8 → 86.8 | 39.8 → 52.0 |
D'après la Table 2 de l'article ; à gauche de la flèche, chaîne de pensée avec décodage glouton, à droite, self-consistency ; valeurs en %.
Les quatre modèles progressent sur toutes les tâches arithmétiques, et le gain est en général d'autant plus grand que le modèle est gros. UL2 20B gagne de 3 à 7 points de pourcentage ; LaMDA 137B et code-davinci-001, de 7 à 24 points environ. Même PaLM 540B et code-davinci-002, déjà très forts, prennent 17.9 points sur GSM8K. Les 78.0 % de code-davinci-002 dépassent les 55 % obtenus à l'époque en fine-tunant GPT-3 avec, en plus, un vérificateur, alors que self-consistency ne demande aucun entraînement.
En raisonnement de sens commun, les gains sont plus modestes ; code-davinci-002 gagne 6.4 points sur StrategyQA et 3.9 sur ARC-challenge. Le raisonnement symbolique est testé sur des problèmes plus longs que les exemples ; avec un modèle assez grand, la méthode aide encore. Mais UL2 20B était à 0.0 % sur la concaténation de lettres, et il y reste après le vote. Sur un problème que le modèle ne sait pas résoudre du tout, échantillonner davantage ne fait que récolter plus de mauvaises réponses.
Plus on échantillonne, mieux c'est, mais ça sature vite
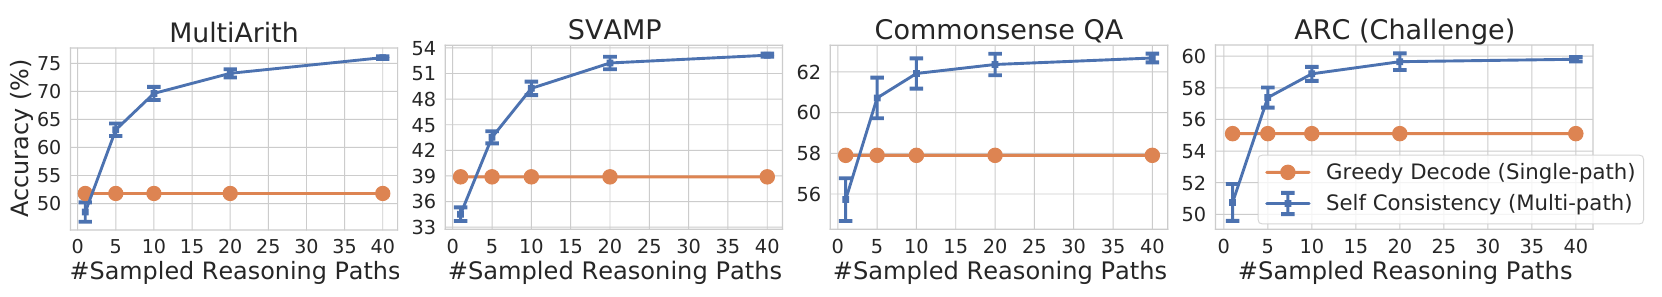
Regardez le point le plus à gauche de chaque graphique. Avec un seul raisonnement échantillonné, la précision est inférieure à celle du décodage glouton, car l'échantillonnage aléatoire se trompe plus facilement que le choix du token le plus probable. Pris isolément, un raisonnement échantillonné est de moins bonne qualité ; ce sont le nombre et le vote qui permettent de reprendre l'avantage.
Entre 5 et 10 raisonnements, la courbe a déjà engrangé l'essentiel du gain, et les auteurs recommandent d'ailleurs, dans leur conclusion, de commencer en pratique par 5 ou 10.
Pourquoi le vote fonctionne
L'hypothèse des auteurs est que les raisonnements corrects, même rédigés de façons très différentes, aboutissent à la même réponse, alors que les raisonnements faux se trompent chacun à leur manière et dispersent leurs réponses sur de nombreuses valeurs. Ainsi, même si la bonne réponse n'obtient que 40 % des voix, elle reste le groupe le plus nombreux tant que les 60 % restants se répartissent entre plusieurs valeurs fausses, et plus on échantillonne, plus le vote majoritaire est stable.
Vue sous l'autre angle, cette hypothèse fixe aussi les limites du vote. Si le modèle commet une erreur systématique, par exemple en oubliant toujours une soustraction, les mauvaises réponses se concentrent sur une même valeur. Avec 40 % de bonnes réponses, si 80 % des 60 % restants tombent sur la même valeur fausse, celle-ci recueille 48 % des voix, plus que la bonne réponse ; plus on échantillonne, plus on choisit la mauvaise avec assurance. Si self-consistency l'emporte, c'est parce que « chaque raisonnement faux se trompe à sa façon ».
Comparaison avec d'autres approches
Échantillonner puis classer : on échantillonne aussi plusieurs sorties, on les classe selon leur log-probabilité, et l'on prend la réponse de la première. Sur code-davinci-001, cette méthode progresse elle aussi avec le nombre de sorties, mais bien moins que le vote, ce qui concorde avec l'observation précédente selon laquelle le modèle ne sait pas distinguer ses meilleurs raisonnements.
Recherche en faisceau (beam search) : sur AQuA avec UL2 20B, quand on garde le meilleur faisceau, plus le faisceau est large, plus le résultat se dégrade, de 23.6 % à 10.2 % pour une largeur de 40. Produire 40 raisonnements par recherche en faisceau puis voter donne 24.2 %, contre 26.9 % en échantillonnant puis en votant. Les candidats issus de la recherche en faisceau se ressemblent trop, alors que le vote a besoin de diversité.
Ensembles : sur GSM8K avec LaMDA 137B, comparaison avec deux façons de combiner des prompts :
| Méthode | GSM8K |
|---|---|
| Chaîne de pensée (décodage glouton) | 17.1 |
| Trois jeux de prompts écrits à la main, décodage glouton puis vote | 18.6 |
| Ordre des exemples mélangé 40 fois, décodage glouton puis vote | 19.2 |
| Self-consistency (40 échantillons) | 27.7 |
D'après la Table 7 de l'article ; valeurs en %.
Changer de prompt ou d'ordre apporte bien moins que de laisser le modèle emprunter lui-même plusieurs chemins. L'annexe essaie aussi de faire voter plusieurs modèles ensemble ; PaLM 540B associé à LaMDA 137B n'atteint que 36.9 %, bien en dessous des 74.4 % de PaLM seul avec self-consistency. Le modèle le plus faible entraîne le plus fort vers le bas.
Les tâches où la chaîne de pensée fait pire
Ye et Durrett ont montré que, sur certaines tâches de NLP courantes, ajouter une chaîne de pensée fait baisser les scores. Les auteurs en testent quelques-unes sur PaLM 540B :
| Méthode | ANLI R1 | e-SNLI | RTE | BoolQ |
|---|---|---|---|---|
| Prompting standard (sans raisonnement) | 69.1 | 85.8 | 84.8 | 71.3 |
| Prompting par chaîne de pensée | 68.8 | 81.0 | 79.1 | 74.2 |
| Self-consistency | 78.5 | 88.4 | 86.3 | 78.4 |
D'après la Table 5 de l'article ; sélection de colonnes, valeurs en %.
Sur e-SNLI et RTE, la chaîne de pensée fait perdre environ 5 points ; self-consistency les récupère et dépasse même le prompting standard sans raisonnement.
Peu sensible aux réglages
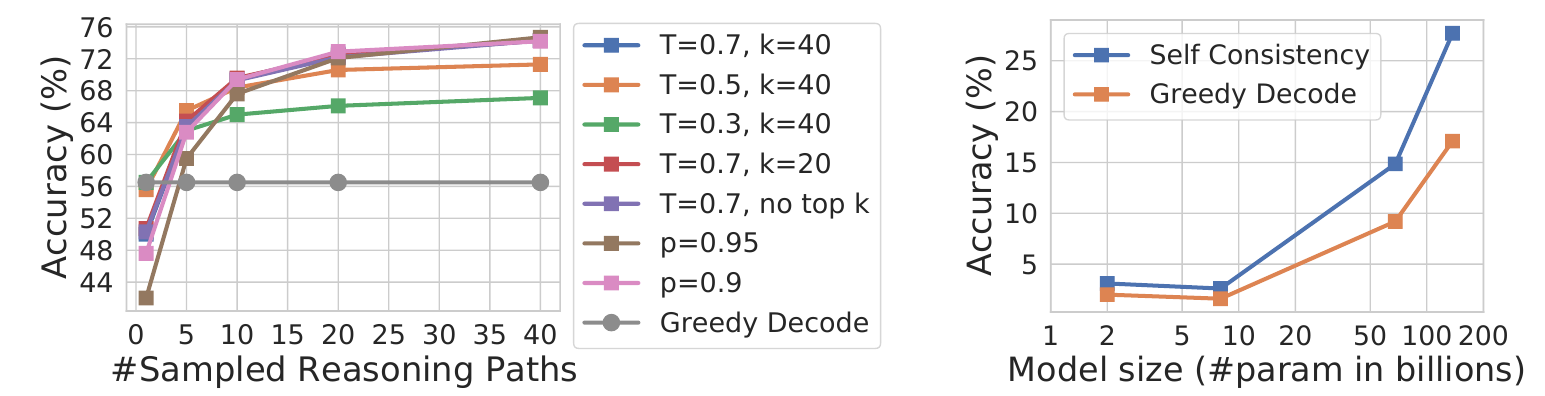
À gauche, quels que soient la température, le top-k ou le réglage de l'échantillonnage nucleus, les résultats à 40 raisonnements sont bien au-dessus du décodage glouton. La figure de droite montre que les petits modèles gagnent peu ; selon les auteurs, des capacités comme l'arithmétique n'apparaissent qu'à partir d'une certaine taille, et tant que le modèle ne sait pas calculer, le vote ne l'aide pas.
Les auteurs mènent aussi quelques tests de robustesse, tous sur GSM8K :
- Exemples erronés : les nombres des raisonnements des exemples du prompt sont remplacés au hasard (seule la réponse finale est conservée) ; avec le décodage glouton, LaMDA 137B passe de 17.1 % à 14.9 %, et remonte à 23.4 % avec self-consistency.
- Équations seules : le raisonnement se limite à des équations du type « 3 + 2 = 5 » ; self-consistency fait passer le score de 5.0 % à 6.5 %, un gain minime. Les équations sont trop courtes pour varier beaucoup, et la diversité manque.
- Chaîne de pensée zero-shot : sans exemple, avec la seule phrase « Let's think step by step », PaLM 540B passe de 43.0 % à 69.2 %, soit 26.2 points de plus.
- Autres prompts : avec deux autres jeux d'exemples écrits pour l'annexe, PaLM 540B gagne respectivement 17.5 et 16.4 points, à peu près autant que les 17.9 de l'expérience principale.
Le degré d'accord comme indice de confiance
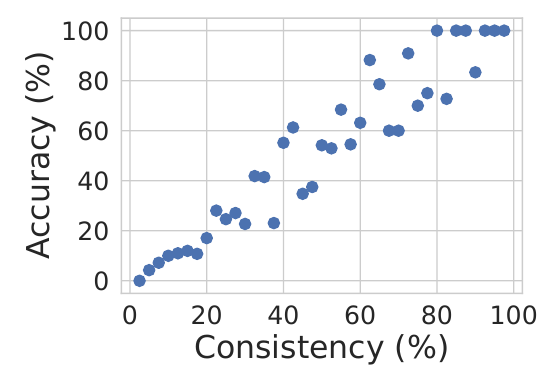
Le vote ne donne pas seulement une réponse, il donne aussi un nombre de voix. Quand 35 raisonnements sur 40 sont d'accord, ou seulement 12, la confiance qu'on peut accorder à la réponse n'est évidemment pas la même. Les auteurs constatent que le taux d'accord est fortement corrélé à la précision ; un faible accord peut donc servir de signal que le modèle « n'est pas sûr de lui ».
Limites
Les auteurs relèvent eux-mêmes trois limites :
- Coût : échantillonner 40 raisonnements, c'est 40 fois plus d'inférence ; d'où leur conseil de commencer par 5 à 10.
- Réponses fixes uniquement : il faut pouvoir dire si deux réponses sont identiques.
- Raisonnement pas forcément correct : le vote peut trouver la bonne réponse alors que le raisonnement raconte n'importe quoi. Dans l'exemple StrategyQA présenté dans un tableau de l'article, le modèle compare la population des deux Albany pour répondre, et aucun des deux chiffres n'est vraiment exact.
Les auteurs proposent aussi une piste pour la suite, utiliser self-consistency pour produire de meilleures données de fine-tuning, afin que le modèle réponde juste en une seule inférence. Le même mois, STaR, de Zelikman et al., faisait justement quelque chose de semblable en réentraînant le modèle sur les raisonnements des problèmes qu'il avait résolus.
La suite
Le vote majoritaire est vite devenu un outil standard de l'évaluation du raisonnement ; les maj@k et cons@64 qu'on croise dans les tableaux des articles désignent justement un vote sur k ou 64 échantillons. Sur AIME 2024, DeepSeek-R1-Zero obtient en moyenne 71.0 % avec une seule réponse, et 86.7 % avec un vote sur 64.
L'idée du « degré d'accord comme indice de confiance » a elle aussi servi. Dans le rapport technique de Gemini, en décembre 2023, Gemini Ultra obtient 90.04 % sur MMLU avec une méthode que l'équipe appelle uncertainty-routed chain-of-thought. On échantillonne d'abord 32 chaînes de pensée ; si leur accord dépasse un seuil, on retient la réponse majoritaire, sinon on revient au décodage glouton sans raisonnement. Le décodage glouton seul donne 84.0 %, le vote sur 32 chaînes seul 85.0 %, et c'est en combinant les deux qu'on atteint 90.0 %.
D'autres ont tenté de lever la contrainte des réponses fixes. En novembre 2023, Chen et al., de la même équipe, proposent Universal Self-Consistency ; au lieu de comparer eux-mêmes les réponses, ils confient toutes les réponses candidates à un modèle de langage et lui demandent de choisir celle qui s'accorde le mieux avec les autres. La méthode s'applique ainsi à des générations sans réponse de référence, comme les résumés ou le code.
Par la suite, la question est devenue « comment répartir au mieux le calcul supplémentaire dépensé à l'inférence ». Le vote est la solution la plus simple ; il existe aussi le choix de la réponse par un vérificateur, ou une recherche déployée à chaque étape du raisonnement.
Conclusion
Self-consistency ne demande ni entraînement ni modèle supplémentaire. Il suffit de remplacer le décodage glouton par 40 échantillons et un décompte des voix pour que PaLM 540B et code-davinci-002 gagnent 17.9 points sur GSM8K et dépassent l'approche de l'époque, fine-tuning plus vérificateur.
La méthode repose sur l'hypothèse que chaque raisonnement faux se trompe à sa façon. Face à un angle mort systématique du modèle, ou à un problème qu'il ne sait pas résoudre du tout, le vote ne fait que choisir la mauvaise réponse avec plus d'assurance ; et le coût est directement multiplié par le nombre d'échantillons. Heureusement, pour la plupart des problèmes, 5 à 10 échantillons apportent déjà l'essentiel du gain.
Ce que l'article a laissé de plus durable, c'est peut-être ce nuage de points entre degré d'accord et précision. Le nombre de voix est en soi un score de confiance ; moins de deux ans plus tard, si Gemini Ultra a grimpé à 90 % sur MMLU, c'est en vérifiant d'abord si les voix étaient assez concentrées avant de décider de se fier ou non au résultat du vote.