Article original
s1: Simple test-time scaling
- Publication
- EMNLP 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2501.19393
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltunings12025,
  title = {{s1: Simple test-time scaling}},
  author = {Niklas Muennighoff and Zitong Yang and Weijia Shi and Xiang Lisa Li and Li Fei-Fei and Hannaneh Hajishirzi and Luke Zettlemoyer and Percy Liang and Emmanuel Candès and Tatsunori Hashimoto},
  year = {2025},
  eprint = {2501.19393},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.19393}
}
En septembre 2024, OpenAI présente o1, avec à l'appui une très jolie courbe, où plus on laisse le modèle réfléchir, plus ses réponses sont justes. Mais OpenAI ne publie pas sa méthode et se contente d'évoquer un apprentissage par renforcement à grande échelle.
Dans les mois qui suivent, de nombreuses équipes tentent de le reproduire. Certaines misent sur la recherche arborescente Monte-Carlo, d'autres sur plusieurs agents qui débattent entre eux ; en janvier 2025, DeepSeek-R1, avec des millions d'exemples et plusieurs étapes d'apprentissage par renforcement, rattrape les scores d'o1. Pourtant, parmi toutes ces reproductions, personne n'avait reproduit publiquement la courbe « plus on réfléchit longtemps, mieux on répond ».
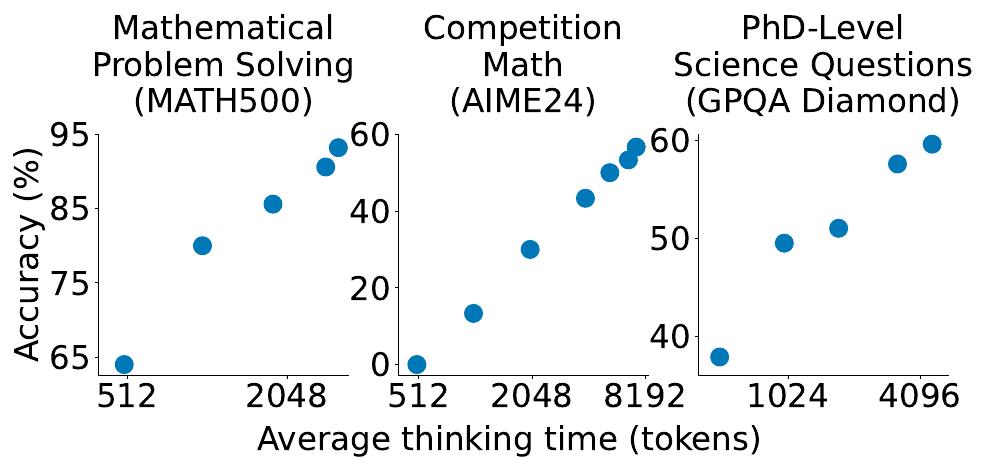
Muennighoff, Yang et leurs collègues de Stanford, de l'Université de Washington, d'AI2 et d'autres institutions posent une question très directe. Quelle est la façon la plus simple d'obtenir à la fois cette courbe et de solides capacités de raisonnement ? Leur réponse est d'une simplicité inattendue. Il suffit de 1 000 exemples, de 26 minutes de fine-tuning sur 16 H100, et d'un « Wait ».
Définir le problème
Les auteurs classent en deux familles les méthodes qui dépensent plus de calcul à l'inférence :
- Séquentielle : les calculs ultérieurs s'appuient sur les résultats précédents, par exemple l'écriture d'un long raisonnement.
- Parallèle : des calculs indépendants, agrégés à la fin, par exemple un vote majoritaire.
Les auteurs se concentrent sur les méthodes séquentielles ; intuitivement, les calculs ultérieurs peuvent exploiter les résultats intermédiaires précédents, pousser le raisonnement plus loin et le corriger à plusieurs reprises.
Pour comparer les méthodes, la précision seule ne suffit pas ; il faut aussi savoir si l'on peut contrôler le calcul, et si la précision augmente quand le calcul augmente. Les auteurs définissent trois indicateurs. On lance une méthode plusieurs fois sur un même benchmark, avec différents niveaux de calcul , ce qui donne une précision :
Le contrôle est la proportion de cas où le nombre de tokens de réflexion effectivement utilisés tombe dans la plage demandée ; le scaling est la pente moyenne de la courbe, qui doit être positive pour être utile ; la performance est la meilleure précision atteinte.
Résoudre le problème
s1K : sélectionner 1 000 problèmes
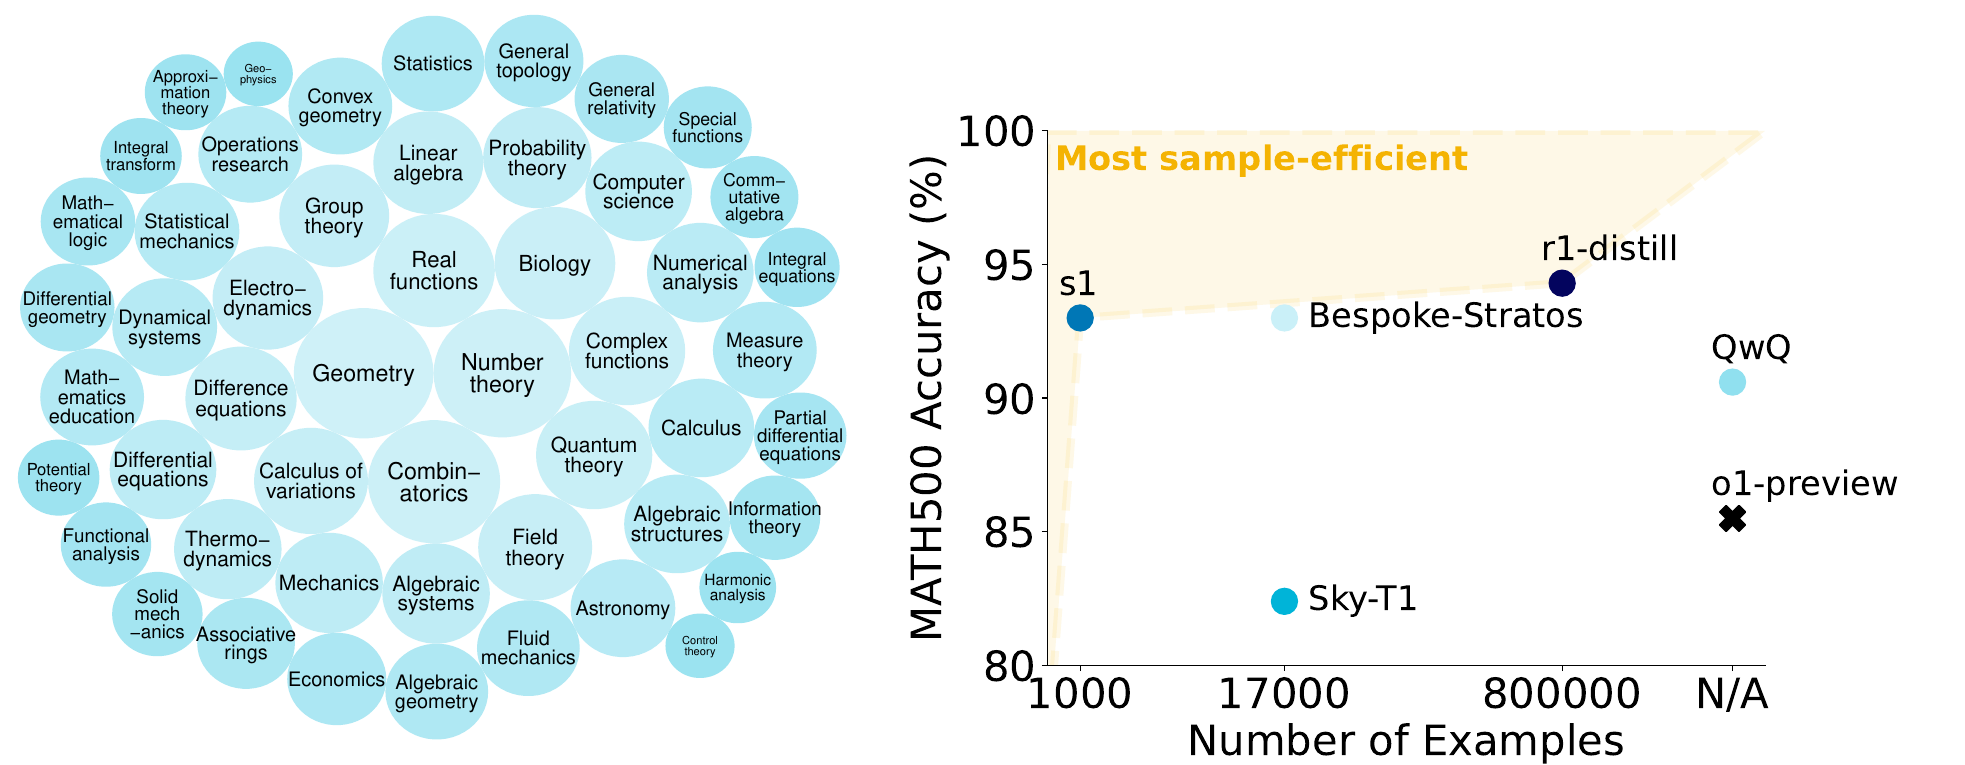
D'abord, collecter 59 000 problèmes. Ils proviennent de 16 sources, dont la plus importante est NuminaMATH, avec 30 660 problèmes de mathématiques ; s'y ajoutent les sujets de l'AIME des années passées (1983 à 2021), OlympicArena, des problèmes d'olympiades multidisciplinaires (4 250 problèmes), OmniMath, des mathématiques de compétition (4 238 problèmes), et AGIEval, des examens standardisés comme le SAT et le LSAT (2 385 problèmes). Les auteurs ont aussi constitué deux jeux maison, 182 problèmes de probabilités tirés des examens de qualification du doctorat de statistique de Stanford, et 23 casse-tête difficiles, classiques des entretiens pour le trading quantitatif.
Chaque problème passe par Gemini 2.0 Flash Thinking, de Google, qui produit un raisonnement et une solution ; on obtient 59 029 triplets « problème, raisonnement, solution ». Toutes les données qui partagent 8 mots consécutifs avec les problèmes des benchmarks (MATH500, GPQA Diamond, AIME24) sont supprimées, ainsi que les problèmes en double.
On filtre ensuite selon trois principes :
- Qualité : on retire les problèmes qui ont provoqué une erreur d'API, ce qui en laisse 54 116, puis ceux dont le format pose problème, par exemple des schémas en ASCII, des renvois à des images inexistantes ou une numérotation incohérente, ce qui en laisse 51 581. Parmi eux, 384 problèmes issus de jeux de données de haute qualité, qui n'ont pas besoin d'être filtrés davantage, entrent directement dans la liste finale.
- Difficulté : Qwen2.5-7B-Instruct et Qwen2.5-32B-Instruct tentent chacun une fois chaque problème, et Claude 3.5 Sonnet note leurs réponses en les comparant à la solution de référence. Il suffit qu'un des deux modèles réussisse pour que le problème soit jugé trop facile et retiré, ce qui en laisse 24 496. La longueur du raisonnement sert aussi d'indicateur de difficulté, en supposant que plus un problème est difficile, plus il demande de réflexion.
- Diversité : Claude 3.5 Sonnet classe chaque problème dans un domaine, selon la classification des sujets mathématiques de l'American Mathematical Society. À chaque fois, on tire d'abord un domaine au hasard, puis un problème de ce domaine, les raisonnements les plus longs ayant plus de chances d'être choisis ; on répète jusqu'à atteindre 1 000 problèmes, qui couvrent au final 50 domaines.
Selon le modèle de notation, seuls 53.6 % des raisonnements de s1K sont corrects. Les auteurs gardent délibérément ces erreurs ; ce qu'ils veulent, c'est le cheminement du raisonnement, et non des solutions parfaitement justes.
Budget forcing
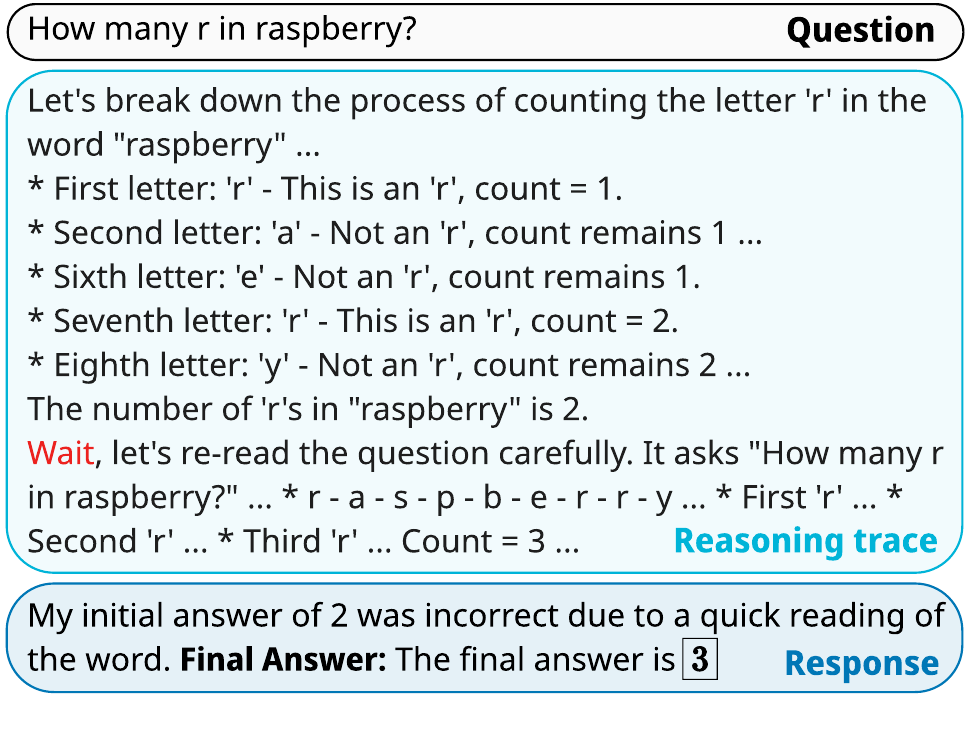
La méthode qui contrôle la longueur de réflexion s'appelle le budget forcing ; elle intervient directement pendant le décodage :
- Fixer un plafond : si le nombre de tokens de réflexion dépasse le plafond, on ajoute directement le délimiteur de fin de réflexion, suivi au besoin de « Final Answer: », pour forcer le modèle à rendre sa meilleure réponse du moment.
- Fixer un plancher : quand le modèle veut terminer sa réflexion, on supprime le délimiteur de fin et l'on ajoute « Wait » à la place, pour qu'il continue à réfléchir.
La figure ci-dessus en donne un exemple. Après un premier comptage, le modèle croit que raspberry ne contient que deux r et veut s'arrêter ; une fois le « Wait » ajouté, il relit la question et trouve le troisième r.
Ce que le modèle écrit après le « Wait » dépend de ce qu'il a appris dans ses données d'entraînement. Les raisonnements de s1K regorgent de phrases comme « attends » ou « revérifions » ; quand le modèle voit « Wait », il se met à vérifier son raisonnement précédent.
Les auteurs comparent aussi plusieurs autres méthodes de contrôle :
- Nombre de tokens indiqué dans le prompt : on indique au modèle le nombre maximal de tokens de réflexion.
- Nombre d'étapes indiqué dans le prompt : on indique au modèle le nombre maximal d'étapes de réflexion, chaque étape faisant environ 100 tokens.
- Longueur indiquée dans le prompt : deux prompts, qui demandent au modèle de réfléchir brièvement ou longuement.
- Échantillonnage de rejet : on échantillonne encore et encore, jusqu'à ce qu'une génération tombe pile dans le budget.
Entraînement
Le modèle de base est Qwen2.5-32B-Instruct. La partie réflexion commence par <|im_start|>think, la partie réponse par <|im_start|>answer. On entraîne 5 epochs sur s1K, avec un batch de 16, soit 315 étapes au total, un taux d'apprentissage de , un échauffement sur les premiers 5 % puis une décroissance cosinus jusqu'à 0 ; la perte ne porte que sur le raisonnement et la solution, pas sur l'énoncé.
L'entraînement a pris 26 minutes sur 16 H100, soit environ 7 heures-GPU.
Discussion
Plus on réfléchit, mieux on répond
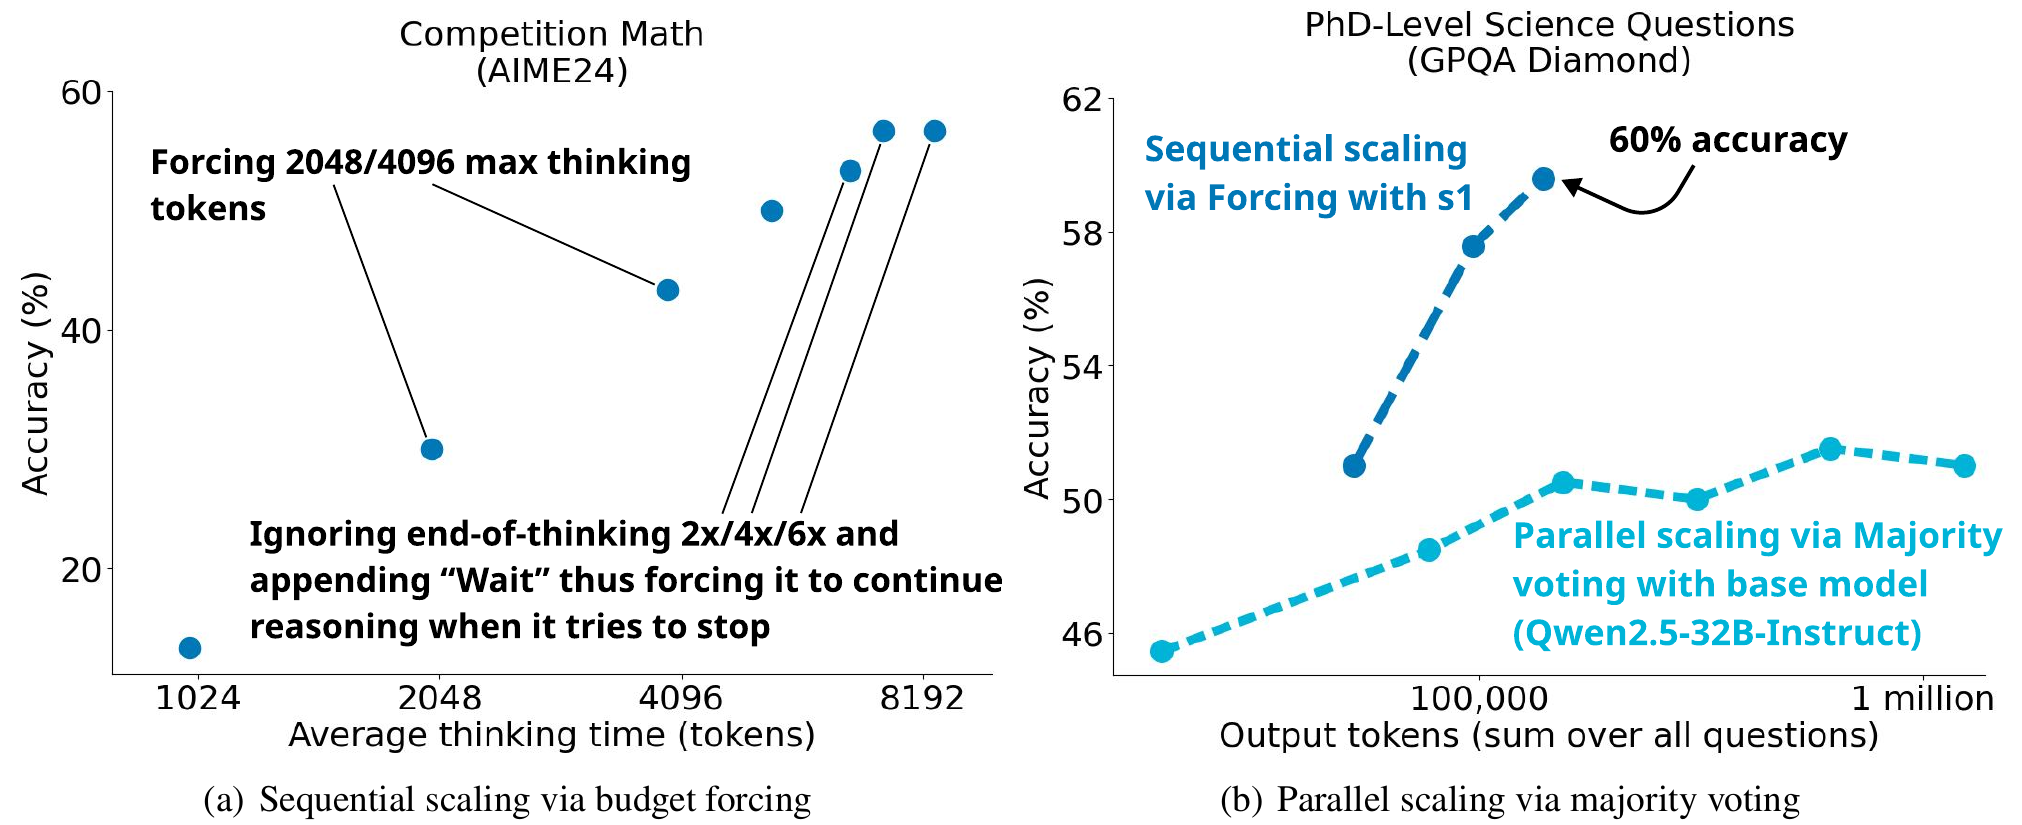
En allongeant la réflexion par budget forcing, AIME24 passe de 50 % sans intervention à 56.7 %. Mais à partir du sixième « Wait », la courbe s'aplatit ; à force de supprimer le délimiteur de fin, on fait tomber le modèle dans des boucles répétitives au lieu de prolonger son raisonnement.
La figure de droite compare les deux types de mise à l'échelle. Le modèle de base, Qwen2.5-32B-Instruct, échantillonne 64 fois par problème, à température 1, et fait un vote majoritaire sur 2 à 64 réponses ; sa précision ne rattrape jamais celle de s1 en mise à l'échelle séquentielle. Pour les auteurs, cela confirme l'intuition de départ, à savoir que la mise à l'échelle séquentielle est plus efficace que la parallèle.
Résultats
| Modèle | Exemples | AIME24 | MATH500 | GPQA |
|---|---|---|---|---|
| o1-preview | Non publié | 44.6 | 85.5 | 73.3 |
| o1 | Non publié | 74.4 | 94.8 | 77.3 |
| Gemini 2.0 Flash Thinking | Non publié | 60.0 | - | - |
| Qwen2.5-32B-Instruct | - | 26.7 | 84.0 | 49.0 |
| DeepSeek-R1 | ≫ 800 000 | 79.8 | 97.3 | 71.5 |
| R1 distillé (32B) | 800 000 | 72.6 | 94.3 | 62.1 |
| Bespoke-32B | 17 000 | 63.3 | 93.0 | 58.1 |
| s1 (sans budget forcing) | 1 000 | 50.0 | 92.6 | 56.6 |
| s1-32B | 1 000 | 56.7 | 93.0 | 59.6 |
D'après la Table 1 de l'article ; sélection de lignes ; « Exemples » : nombre d'exemples du fine-tuning de raisonnement ; scores en %.
Avec seulement 1 000 exemples d'entraînement en plus, s1-32B dépasse le modèle de base de 30 points de pourcentage sur AIME24. Sur AIME24 comme sur MATH500, il dépasse o1-preview ; le « jusqu'à 27 % de mieux » du résumé correspond à l'écart relatif sur AIME24, 56.7 contre 44.6. Sur GPQA, en revanche, il reste une bonne dizaine de points de pourcentage sous o1-preview.
Le R1 distillé, publié à la même période, fait mieux que s1, mais avec 800 fois plus de données. Sur AIME24, s1 approche aussi son professeur, Gemini 2.0 Flash Thinking, signe que la distillation a dans l'ensemble réussi.
Le choix des données compte beaucoup
| Données | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| 1 000 au hasard (qualité seule) | 36.7 | 90.6 | 52.0 |
| Les 1 000 plus variés (diversité seule) | 26.7 | 91.2 | 54.6 |
| Les 1 000 aux raisonnements les plus longs (difficulté seule) | 33.3 | 90.4 | 59.6 |
| Les 59 000 problèmes | 53.3 | 92.8 | 58.1 |
| s1K | 50.0 | 93.0 | 57.6 |
D'après la Table 2 de l'article ; tous les scores de ce tableau sont obtenus avec un plafond de réflexion d'environ 30 000 tokens, pour éviter que le modèle reste coincé dans une boucle ; en %.
Avec un seul principe de sélection, AIME24 perd chaque fois de 13 à 23 points de pourcentage. s1K, qui combine les trois principes, fait à peu près jeu égal avec le modèle entraîné sur les 59 000 problèmes, lequel demande 394 heures-GPU, contre 7 seulement pour s1K.
Comment contrôler la longueur de réflexion
| Méthode | Contrôle | Scaling | Performance |
|---|---|---|---|
| Budget forcing | 100% | 15 | 56.7 |
| Tokens dans le prompt | 40% | −24 | 40.0 |
| Tokens dans le prompt + budget forcing | 100% | 13 | 40.0 |
| Étapes dans le prompt | 60% | 3 | 36.7 |
| Étapes dans le prompt + budget forcing | 100% | 6 | 36.7 |
| Longueur dans le prompt | 50% | 25 | 36.7 |
| Échantillonnage de rejet | 100% | −35 | 40.0 |
D'après la Table 3 de l'article ; AIME24.
Le budget forcing s'en sort bien sur les trois indicateurs, avec un contrôle de 100 %, un scaling positif et la meilleure précision. Les autres méthodes ont chacune leurs problèmes :
- Nombre de tokens imposé : le modèle ne sait pas compter précisément combien de tokens il a écrits, même avec un entraînement spécifique ; sans budget forcing, on ne le contrôle pas.
- Nombre d'étapes imposé : le modèle sait très bien contourner la consigne. Si on lui demande moins d'étapes, il allonge chacune d'elles ; si on lui en demande plus, il les raccourcit, et le nombre total de tokens reste à peu près le même.
- Longueur imposée : demander au modèle de réfléchir plus longtemps le fait effectivement réfléchir davantage, et le scaling est même le meilleur, mais la précision reste faible.
- Échantillonnage de rejet : c'est le plus surprenant. Plus la longueur autorisée est grande, plus la précision baisse, avec un scaling de −35. En y regardant de plus près, les auteurs constatent que les générations courtes correspondent le plus souvent à des cas où le modèle est parti dans la bonne direction dès le début, et les générations longues à des cas où il s'est trompé de chemin et passe son temps à revenir en arrière et à douter de lui-même. Ne retenir que les réponses d'une certaine longueur revient à sélectionner des situations de difficulté différente.
Quant à ce qu'on ajoute à la suite, les auteurs ont comparé plusieurs options :
| Fin de réflexion | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| Sans prolongation | 50.0 | 93.0 | 57.6 |
| 2 suppressions, rien d'ajouté | 50.0 | 90.2 | 55.1 |
| 2 suppressions + « Alternatively » | 50.0 | 92.2 | 59.6 |
| 2 suppressions + « Hmm » | 50.0 | 93.0 | 59.6 |
| 2 suppressions + « Wait » | 53.3 | 93.0 | 59.6 |
D'après la Table 4 de l'article ; en %.
Se contenter de supprimer le délimiteur de fin, sans rien ajouter, fait au contraire moins bien. « Wait » est globalement le meilleur, et le seul qui fasse progresser AIME24.
Pourquoi 1 000 exemples suffisent
L'hypothèse des auteurs est que la capacité de raisonnement est déjà présente dans le modèle. Le préentraînement porte sur plusieurs milliers de milliards de tokens, qui contiennent déjà une masse de données de raisonnement ; le fine-tuning sur 1 000 exemples ne fait que réveiller cette capacité, que le budget forcing amplifie ensuite à l'inférence. C'est proche de l'« hypothèse de l'alignement superficiel » avancée par LIMA, qui avait constaté que 1 000 exemples suffisent pour apprendre à un modèle à répondre selon les préférences des utilisateurs.
Limites
- Plafonnement : au-delà d'un certain point, prolonger par budget forcing n'apporte plus rien, et trop de prolongations font tomber le modèle dans des boucles répétitives. Parmi les pistes d'amélioration proposées par les auteurs figurent l'alternance de différents mots, une pénalité de répétition ou une température plus élevée.
- La longueur de contexte : si longue que soit la réflexion, elle ne peut pas dépasser la fenêtre de contexte du modèle. Sur AIME24, quand on demande au modèle de réfléchir jusqu'à 512 étapes, la sortie dépasse la longueur de contexte pour 12 problèmes sur 30, et le score s'effondre.
- La mise à l'échelle parallèle peut compléter : les auteurs ont essayé REBASE, une recherche arborescente guidée par un modèle de récompense de processus, suivie d'un vote majoritaire ; elle passe mieux à l'échelle que le simple vote majoritaire et, dans cette comparaison, l'emporte aussi sur la mise à l'échelle séquentielle, au prix d'un passage supplémentaire du modèle de récompense à chaque étape.
Par ailleurs, les raisonnements de s1K ont tous été écrits par Gemini, et le modèle ne peut guère dépasser le niveau de son professeur, ce que montre plus clairement encore s1.1, présenté plus bas.
La suite
Sept jours après s1, les auteurs publient s1.1. Mêmes 1 000 problèmes, mais les raisonnements sont régénérés par DeepSeek-R1, avec la même méthode d'entraînement :
| Modèle | MATH500 | GPQA | AIME24 | AIME25 |
|---|---|---|---|---|
| s1 (sans budget forcing) | 92.6 | 56.6 | 50.0 | 26.7 |
| s1 (4 « Wait ») | 92.2 | 58.6 | 56.7 | 36.7 |
| s1.1 (sans budget forcing) | 94.4 | 60.6 | 56.7 | 50.0 |
| s1.1 (2 « Wait ») | 95.4 | 63.6 | 56.7 | 50.0 |
D'après la Table 5 de l'annexe de l'article ; sélection de lignes, en %.
Il a suffi de changer de professeur pour que s1.1, sans aucun budget forcing, rattrape le meilleur score de s1 avec budget forcing ; sur AIME25, les nouveaux problèmes de 2025, il bondit de 26.7 % à 50.0 %. Les auteurs ont aussi essayé Claude 3.7 comme professeur, avec de moins bons résultats qu'avec R1. Détail amusant, une fois le « Wait » ajouté, les scores AIME de s1.1 ne progressent plus.
Le même tableau inclut quelques nouveaux concurrents. LIMO, fine-tuné sur 817 exemples, obtient 56.3 % sur AIME24 et arrive à une conclusion semblable à celle de s1. o3-mini, d'OpenAI, propose carrément trois niveaux d'effort de réflexion ; en low, medium et high, il obtient respectivement 56.3 %, 75.8 % et 83.8 % sur AIME24. Régler la durée de réflexion du modèle est devenu une option du produit.
Conclusion
Avec 1 000 problèmes triés sur le volet, 26 minutes de fine-tuning de Qwen2.5-32B-Instruct et un budget forcing pour contrôler la longueur de réflexion, s1 reproduit publiquement la courbe d'o1, « plus on réfléchit longtemps, mieux on répond ». AIME24 passe de 50 % à 56.7 %, devant o1-preview en mathématiques de compétition.
Le plus instructif, c'est le tableau d'ablation sur les données. Au hasard, les plus variés, les plus longs ; choisir 1 000 problèmes selon un seul de ces critères fait nettement moins bien que les trois réunis, et entraîner sur les 59 000 problèmes n'apporte qu'un tout petit plus. Le peu de données n'est pas le problème ; ce qui compte, c'est de bien les choisir.
Quant au « Wait », il est réellement utile, mais il ne prolonge la réflexion que jusqu'à un certain point, et passer à un meilleur professeur fait une bien plus grande différence. Ce qui permet vraiment à s1 de continuer à réfléchir, c'est moins ce mot que les habitudes de raisonnement que Gemini, puis R1, ont inscrites dans ces 1 000 problèmes.