Article original
Tree of Thoughts: Deliberate Problem Solving with Large Language Models
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2305.10601
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerstreeofthoughts2023,
  title = {{Tree of Thoughts: Deliberate Problem Solving with Large Language Models}},
  author = {Shunyu Yao and Dian Yu and Jeffrey Zhao and Izhak Shafran and Thomas L. Griffiths and Yuan Cao and Karthik Narasimhan},
  year = {2023},
  eprint = {2305.10601},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.10601}
}
De GPT à GPT-4, la façon dont un modèle de langage produit du texte n'a pas changé : de gauche à droite, un token après l'autre, et ce qui est écrit ne se reprend plus.
La chaîne de pensée fait d'abord écrire au modèle les étapes du raisonnement, mais elle suit toujours un seul chemin jusqu'au bout. Self-Consistency en parcourt plusieurs et termine par un vote, mais chacun est encore écrit d'une traite ; jamais le modèle ne s'arrête en route pour se demander s'il vaut mieux faire ce pas « comme ceci ou comme cela ». Si la première étape part dans la mauvaise direction, la suite a beau être impeccable, elle ne sert à rien.
Yao et al., de Princeton, en collaboration avec Google DeepMind, sont allés chercher l'inspiration dans les tout premiers travaux de l'intelligence artificielle. Dans les années 1950, Newell et Simon décrivaient la résolution de problèmes chez l'humain comme une recherche dans un arbre : chaque nœud est une solution partielle, chaque branche une étape suivante possible, des heuristiques décident de la direction à prendre, et quand le chemin est bloqué, on revient en arrière. Cet article fait faire la même chose à un modèle de langage.
Définir le problème
Les auteurs réécrivent les approches de l'époque sous quelques formes unifiées. L'entrée est , la sortie , le modèle de langage :
- Prompting entrée-sortie (IO) : le modèle produit directement la réponse, .
- Chaîne de pensée (CoT) : entre l'entrée et la sortie, on insère une suite de pensées , chacune étant un bout de texte qui a du sens, une ligne de calcul par exemple. En pratique, toute la suite est écrite d'une traite.
- Chaîne de pensée avec Self-Consistency (CoT-SC) : on échantillonne indépendamment chaînes de pensée et l'on retient la réponse qui revient le plus souvent.
Du point de vue d'une recherche dans un arbre, il manque deux choses à ces approches. Localement, elles n'explorent pas plusieurs façons d'écrire une même étape ; globalement, elles ne font ni planification, ni anticipation, ni retour en arrière.
Résoudre le problème
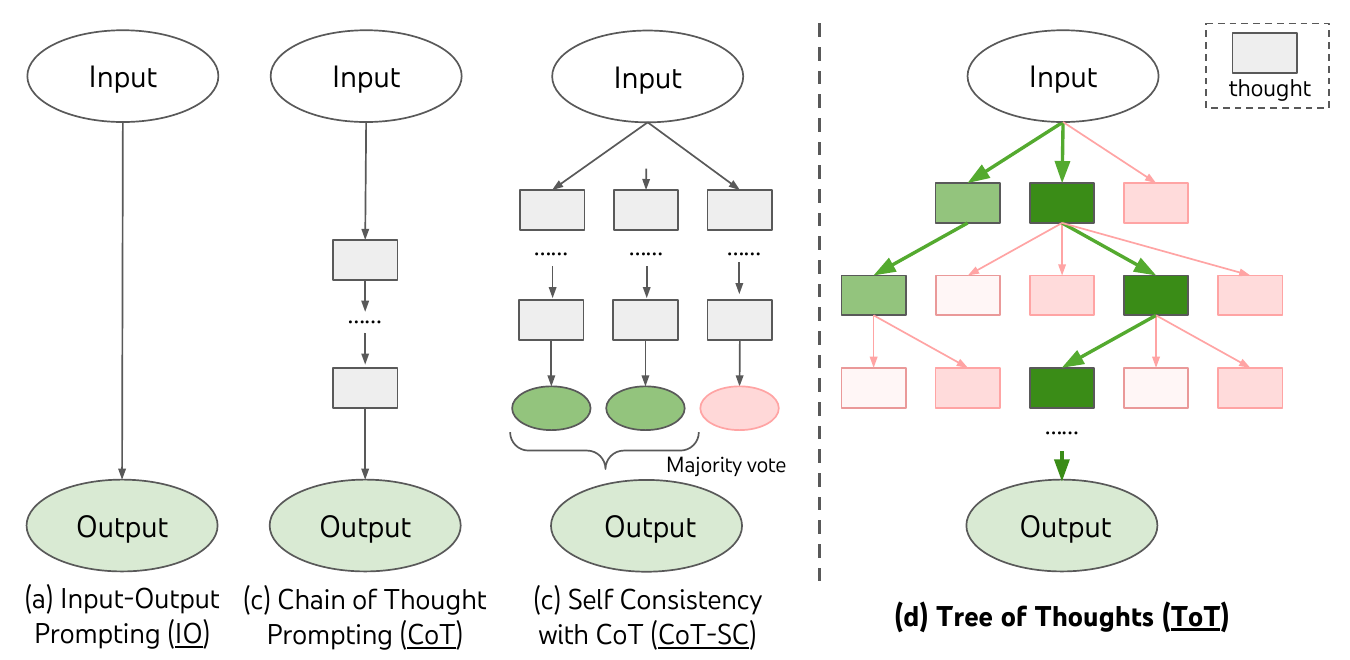
Tree of Thoughts (ToT) traite le problème comme une recherche dans un arbre. Chaque nœud est un état , c'est-à-dire l'entrée plus les pensées écrites jusque-là. Pour l'appliquer à un problème donné, il faut répondre à quatre questions.
1. Quelle taille pour une pensée ?
Une pensée doit être assez petite pour que le modèle puisse produire des candidates variées et prometteuses, mais assez grande pour qu'il puisse juger si elle mène quelque part. Un token est trop petit pour être évalué ; un livre entier est trop grand pour être écrit de façon cohérente.
Les auteurs la découpent différemment selon le problème. Au jeu de 24, une pensée est une ligne de calcul ; en écriture créative, un plan de rédaction ; dans les mots croisés, un mot inscrit pour une définition.
2. Comment produire la pensée suivante ?
- Échantillonnage indépendant : avec un prompt de chaîne de pensée, on échantillonne fois de façon indépendante. Cela convient quand l'espace des pensées est vaste, un plan entier par exemple ; des tirages séparés sont naturellement variés.
- Proposition groupée : avec un « prompt de proposition », on demande au modèle de lister candidates dans une seule et même sortie. Cela convient quand l'espace des pensées est très contraint, une ligne de calcul ou un mot par exemple ; les lister ensemble évite les doublons.
3. Comment évaluer un état ?
C'est là que ToT se distingue le plus des algorithmes de recherche habituels. Dans une recherche classique, l'heuristique est soit une règle codée en dur (Deep Blue, par exemple), soit un modèle entraîné (AlphaGo, par exemple). ToT emprunte une troisième voie et laisse le modèle de langage raisonner lui-même, en texte, pour juger si un état est prometteur.
- Note individuelle : pour chaque état, on demande au modèle une note, ou un classement en « sûr / probable / impossible ». Le jugement peut s'appuyer sur quelques pas d'anticipation, par exemple 5, 5, 14 donnent très vite 5 + 5 + 14 = 24 ; ou sur le bon sens, par exemple 1, 2, 3 sont trop petits, aucun calcul n'atteindra 24.
- Comparaison : quand la réussite est difficile à noter directement, la cohérence d'un texte par exemple, on présente plusieurs candidates ensemble et l'on demande au modèle de voter pour la plus prometteuse. Cela revient un peu à appliquer Self-Consistency à chaque étape.
L'évaluation n'a pas besoin d'être parfaite ; il suffit qu'elle aide à peu près à décider. On peut aussi poser la question plusieurs fois et faire la moyenne, en dépensant davantage pour obtenir un jugement plus fiable.
4. Quel algorithme de recherche ?
- En largeur (BFS) : à chaque étape, on ne garde que les états les plus prometteurs. Les auteurs l'utilisent pour le jeu de 24 et l'écriture créative, dont l'arbre est peu profond (3 étapes au plus).
- En profondeur (DFS) : on suit d'abord la direction la plus prometteuse jusqu'au bout ; si l'évaluation juge qu'aucune solution n'est possible depuis cet état, on élague tout le sous-arbre et l'on remonte d'un niveau pour essayer la candidate suivante. Les auteurs l'utilisent pour les mots croisés, où il faut placer 10 mots.
De ce point de vue, IO, CoT et CoT-SC sont des cas particuliers de ToT, dont l'arbre est limité en profondeur et en largeur. Le cadre ne demande aucun entraînement ; un modèle de langage existant suffit.
Discussion
Les trois expériences utilisent GPT-4 en mode conversation, à température 0.7, et ont été menées entre le 5 et le 16 mai 2023. Les auteurs ont choisi exprès trois tâches où même GPT-4 échoue en IO comme en CoT.
Le jeu de 24
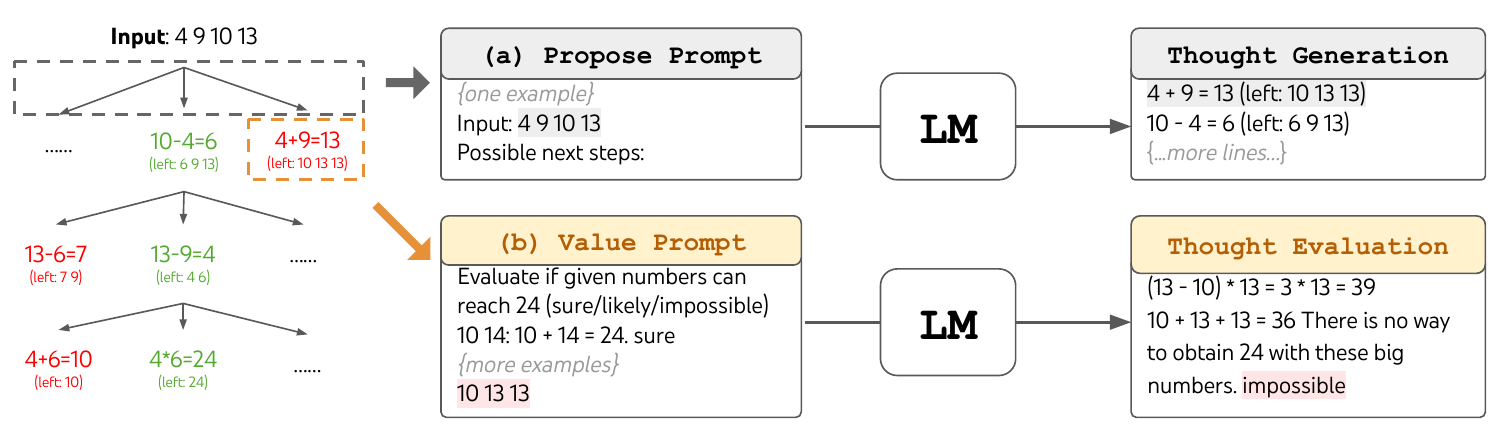
Le jeu de 24 consiste à obtenir 24 avec quatre nombres et les quatre opérations. Les auteurs ont récupéré 1 362 parties sur 4nums.com ; le site les classe de la plus facile à la plus difficile selon le temps de résolution humain, et le test porte sur les 100 parties d'indice 901 à 1 000, parmi les plus difficiles.
Avec ToT, le problème se découpe naturellement en 3 étapes, d'une ligne de calcul chacune. À chaque nœud, les nombres restants passent par le prompt de proposition, qui liste les étapes suivantes possibles ; chaque candidate passe ensuite par le prompt d'évaluation, qui la juge sure, maybe ou impossible ; la question est posée 3 fois pour chaque candidate. La recherche se fait en largeur et garde les 5 meilleures à chaque étape.
| Méthode | Réussite |
|---|---|
| Prompting IO | 7.3% |
| Prompting CoT | 4.0% |
| CoT-SC (vote sur 100) | 9.0% |
| ToT () | 45% |
| ToT () | 74% |
| IO + correction itérative (10 tours max) | 27% |
| IO (meilleur sur 100) | 33% |
| CoT (meilleur sur 100) | 49% |
D'après la Table 2 de l'article.
CoT n'obtient que 4.0 %, moins que la réponse directe ; le vote ne monte qu'à 9.0 %. ToT atteint 45 % en ne gardant qu'une candidate, et 74 % en en gardant 5.
La moitié inférieure du tableau regroupe des comparaisons plus indulgentes. La « correction itérative » demande au modèle de réfléchir à son erreur et de réessayer chaque fois qu'il se trompe, mais elle se sert, comme retour, de la vérité terrain sur la justesse de l'équation. « Meilleur sur 100 » compte un succès dès qu'une tentative sur 100 est correcte ; en usage réel, impossible de savoir laquelle, c'est donc une borne supérieure. Même avec cette borne, CoT ne dépasse pas 49 %, toujours moins que ToT.
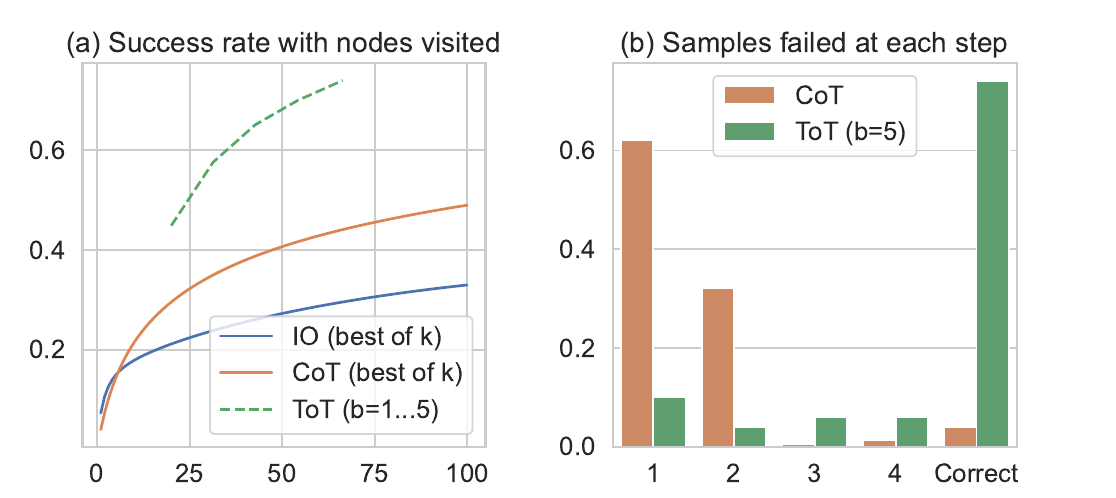
C'est la figure de droite qui mérite le plus d'attention. Environ six échantillons CoT sur dix sont déjà condamnés à ne jamais atteindre 24 une fois la première étape écrite, c'est-à-dire après les trois premiers mots (« 4 + 9 », par exemple).
Pourquoi la première étape compte-t-elle autant ? Prenons 4 9 10 13. En choisissant deux nombres et une opération, on obtient 36 premières étapes possibles, dont 7 seulement permettent encore d'arriver à 24, par exemple 10 − 4, 9 + 10 et 13 − 9. En choisissant au hasard, on tombe huit fois sur dix dans une impasse. CoT, qui écrit de gauche à droite, ne peut pas revenir en arrière ; une première étape ratée, et la partie est perdue.
Sans aucun jugement, une simple recherche en profondeur qui essaie tout et remonte d'un niveau dès qu'elle bute finit, elle aussi, par trouver une solution, par exemple 4 − 10 = −6, 9 − 13 = −4, (−6) × (−4) = 24, mais au prix de plus d'un millier d'états parcourus. Un programme peut se permettre la force brute ; un modèle de langage, qui coûte un appel d'API à chaque pas, ne le peut pas. Le prompt d'évaluation de ToT joue justement le rôle de l'élagage ; il supprime d'emblée les états du type « 10 13 13, trop grand quel que soit le calcul » et ne développe que les quelques branches prometteuses.
Le coût reste considérable. Pour une partie de 24, ToT produit en moyenne 5 500 tokens, presque autant que 100 échantillons CoT (6 700), pour environ 0.74 dollar par partie, contre environ 0.47 dollar pour 100 échantillons CoT. Pour un nombre de tokens comparable, ToT réussit 74 % des parties, et le meilleur de 100 CoT, 49 %.
Les auteurs ont aussi essayé GPT-3.5, avec lequel ToT n'obtient que 19 %. En croisant les deux modèles, GPT-4 pour produire les pensées et GPT-3.5 pour les évaluer donne 64 % ; GPT-3.5 pour les produire et GPT-4 pour les évaluer, 31 % seulement. Pour ce jeu, le goulot d'étranglement est la production de bonnes candidates, et non l'évaluation.
Écriture créative
À partir de 4 phrases tirées au hasard, il faut écrire 4 paragraphes, chacun se terminant par l'une de ces phrases. La tâche n'a pas de réponse de référence ; les auteurs évaluent donc la cohérence de deux façons, par une note de 1 à 10 attribuée par GPT-4 et moyennée sur 5 évaluations, et par une comparaison par paires des textes CoT et ToT, menée par une partie des auteurs sans savoir quel texte vient de quelle méthode.
Le ToT n'a ici que deux niveaux. Il produit d'abord 5 plans de rédaction, puis 5 votes désignent le meilleur ; il rédige ensuite 5 textes à partir de ce plan, et un vote en retient un, de la même façon.
| Méthode | Note GPT-4 |
|---|---|
| IO | 6.19 |
| CoT (plan, puis texte) | 6.93 |
| ToT | 7.56 |
| IO + correction itérative | 7.67 |
| ToT + correction itérative | 7.91 |
D'après la section 4.2 de l'article ; notes moyennes sur 100 problèmes.
La comparaison humaine va dans le même sens ; sur 100 paires, ToT est jugé plus cohérent dans 41 cas, CoT dans 21, et les 38 restantes sont à peu près équivalentes. Sur cette tâche, la correction itérative est très efficace ; les auteurs y voient une troisième façon de produire des pensées, qui consiste à tirer une nouvelle pensée de la retouche d'une ancienne.
Mini mots croisés
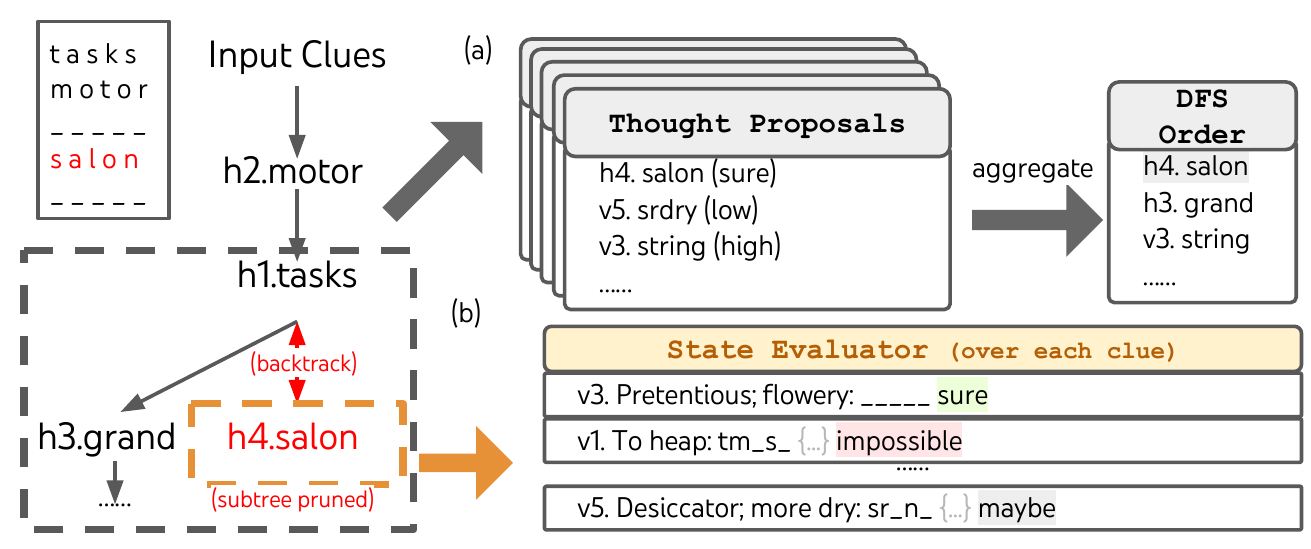
Dans les deux premières tâches, l'arbre est peu profond, 3 étapes au plus. Les mots croisés demandent de placer 10 mots (5 horizontaux, 5 verticaux) qui se contraignent mutuellement ; c'est un problème de recherche plus difficile. Les auteurs ont récupéré 156 grilles sur GooBix et en utilisent 20 pour le test.
La recherche se fait ici en profondeur. À chaque état, les mots déjà placés sont convertis en contraintes de lettres pour les définitions restantes ; le modèle est sollicité 5 fois pour proposer des candidates, avec un niveau de confiance pour chacune, et le tout est regroupé en un ordre de priorité. À l'évaluation, chaque définition restante est vérifiée une à une ; dès que l'une d'elles est jugée impossible à remplir, on élague tout le sous-arbre et l'on remonte d'un niveau. La recherche s'arrête au bout de 100 étapes au plus, et la sortie est l'état le plus profond atteint.
| Méthode | Lettres | Mots | Grilles |
|---|---|---|---|
| IO | 38.7 | 14 | 0 |
| CoT | 40.6 | 15.6 | 1 |
| ToT | 78 | 60 | 20 |
| ToT, meilleur état | 82.4 | 67.5 | 35 |
| ToT, sans élagage | 65.4 | 41.5 | 5 |
| ToT, sans retour arrière | 54.6 | 20 | 5 |
D'après la Table 3 de l'article ; en %, la colonne « Grilles » donne la part des 20 grilles entièrement résolues.
IO et CoT restent tous deux sous les 16 % de mots corrects ; ToT atteint 60 % et résout entièrement 4 grilles sur 20.
Les trois dernières lignes sont des ablations. Si l'on sort pour chaque grille le meilleur état rencontré pendant la recherche (ce qui suppose de connaître la solution, c'est donc une borne supérieure), on en résout 7 ; la règle « sortir l'état le plus profond » peut donc encore être améliorée.
L'élagage peut aussi se tromper. Pour remplir la grille, les mots croisés 5 × 5 recourent à des mots rares ou vieillis ; « agend », par exemple, est une forme ancienne de « agendum », mais GPT-4 y voit une faute de frappe pour « agenda » et élague une grille correcte. Sans élagage, les scores globaux baissent, mais la recherche passe par la bonne grille pour 4 problèmes, dont 3 que le ToT avec élagage ne résout pas en 100 étapes. La qualité de l'évaluateur détermine directement jusqu'où la recherche peut aller.
Sans retour en arrière, en plaçant à chaque fois le mot le plus prometteur, sur 20 étapes au plus et avec la possibilité d'écraser un mot déjà placé, le taux de mots corrects tombe à 20 %.
Inutile sur les problèmes simples
En annexe, les auteurs appliquent un ToT zero-shot à des problèmes ordinaires. Il produit d'abord 5 stratégies de résolution et en choisit une par vote, puis rédige 5 solutions selon cette stratégie et en retient une par vote.
| Méthode | GSM8K | StrategyQA |
|---|---|---|
| IO | 51 | 73 |
| CoT | 86 | 82 |
| ToT | 90 | 83 |
D'après la Table 4 de l'article ; GPT-4, 100 problèmes pour chaque jeu, en %.
ToT fait encore mieux que CoT, mais de peu. GPT-4 avec CoT est déjà très fort sur ces problèmes, et pour StrategyQA, le goulot d'étranglement est la connaissance externe plutôt que le raisonnement. Les auteurs suggèrent d'essayer ToT avec de petits modèles sur les tâches de NLP classiques, et de réserver GPT-4 avec ToT aux problèmes difficiles que même GPT-4 avec CoT ne sait pas résoudre.
Limites
Les auteurs en mentionnent plusieurs dans leur discussion :
- Beaucoup de tâches n'en ont pas besoin : pour les tâches où GPT-4 est déjà bon, une recherche aussi laborieuse est superflue ; l'article n'explore d'ailleurs que trois tâches relativement simples, sur lesquelles GPT-4 échoue pourtant.
- Le coût : selon les prompts et la méthode de recherche, ToT produit 5 à 100 fois plus de tokens que CoT. Pour les expériences principales, le jeu de 24 et l'écriture créative ont coûté environ 106 dollars au total, et les mots croisés, selon l'estimation des auteurs, moins de 100 dollars.
- Des modèles utilisés tels quels : selon les auteurs, on pourrait à l'avenir fine-tuner les modèles à la manière de ToT, pour qu'ils apprennent à décider au niveau de « comment écrire le passage suivant », et pas seulement à prédire le token suivant.
Autre point à noter, avec ToT, chaque tâche doit être conçue à la main : comment découper les pensées, comment écrire les prompts de proposition et d'évaluation, quelle recherche employer. Pour un autre problème, tout est à repenser.
La suite
La piste évoquée par les auteurs en conclusion a été concrétisée plus tard par les modèles de raisonnement, mais par un autre chemin que celui de ToT.
L'article de DeepSeek-R1 contient une section consacrée aux « tentatives infructueuses ». L'équipe a essayé d'explorer à l'inférence avec une recherche arborescente Monte-Carlo (MCTS), en découpant la réponse en petits segments et en guidant la recherche avec un modèle de valeur, mais s'est heurtée à deux problèmes. L'espace de recherche de la génération de tokens est bien plus vaste que celui des jeux de plateau, et même en limitant le nombre d'expansions par nœud, on reste facilement coincé dans un optimum local ; et entraîner un modèle de valeur assez fin est en soi très difficile. Ce qui a finalement marché, c'est l'apprentissage par renforcement avec la justesse de la réponse comme récompense ; le modèle a appris de lui-même, dans une seule et longue chaîne de pensée, à vérifier, à douter et à revenir en arrière pour reprendre sa réflexion.
La recherche à l'inférence n'a pas disparu pour autant. Quand faut-il chercher, quand faut-il laisser le modèle réviser lui-même sa réponse, et comment répartir le calcul au mieux ? Des travaux ultérieurs ont comparé tout cela de façon systématique.
Conclusion
ToT greffe la recherche arborescente de l'IA classique sur un modèle de langage, qui se charge à la fois de proposer les candidates et de les évaluer. Au jeu de 24, GPT-4 obtient 4 % avec CoT et 74 % avec ToT ; aux mots croisés, le taux de mots corrects passe de 15.6 % à 60 %.
L'article montre aussi très clairement ce que coûte ce genre de méthode. Pour chaque problème, il faut concevoir à la main le découpage des pensées, les prompts de proposition et d'évaluation, et la méthode de recherche ; il faut produire de plusieurs fois à une centaine de fois plus de tokens que CoT ; et dès que l'évaluateur se trompe, comme avec ce « agend » pris pour une faute de frappe, la bonne réponse est élaguée.
Un peu plus d'un an plus tard, les modèles de raisonnement ont aplati l'arbre. Dans une longue chaîne de pensée, le modèle s'arrête de lui-même pour se dire « attends, ça ne va pas », puis revient en arrière pour reprendre ; branches, évaluation et retour arrière sont toujours là, mais il n'y a plus besoin d'un programme de recherche extérieur pour les piloter.