原始論文
2 OLMo 2 Furious
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2501.00656
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformersolmo22024,
  title = {{2 OLMo 2 Furious}},
  author = {Team OLMo and Pete Walsh and Luca Soldaini and Dirk Groeneveld and Kyle Lo and Shane Arora and Akshita Bhagia and Yuling Gu and Shengyi Huang and Matt Jordan and Nathan Lambert and Dustin Schwenk and Oyvind Tafjord and Taira Anderson and David Atkinson and Faeze Brahman and Christopher Clark and Pradeep Dasigi and Nouha Dziri and Allyson Ettinger and Michal Guerquin and David Heineman and Hamish Ivison and Pang Wei Koh and Jiacheng Liu and Saumya Malik and William Merrill and Lester James V. Miranda and Jacob Morrison and Tyler Murray and Crystal Nam and Jake Poznanski and Valentina Pyatkin and Aman Rangapur and Michael Schmitz and Sam Skjonsberg and David Wadden and Christopher Wilhelm and Michael Wilson and Luke Zettlemoyer and Ali Farhadi and Noah A. Smith and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2501.00656},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.00656}
}
這篇報告的標題是個玩笑,模仿電影《玩命關頭 2》的英文片名「2 Fast 2 Furious」。
內容倒是很認真。OLMo 是艾倫人工智慧研究所(AI2)的「完全開放」語言模型系列,不只公開權重,連預訓練資料、訓練程式碼、中間 checkpoint、訓練日誌都公開。這類模型對研究很重要,想研究訓練動態、資料與記憶之間的關係,只有完全開放的模型能用;但它們的表現一直落後只公開權重的模型一截。
OLMo 2 想縮小這段差距。它有 7B、13B、32B 三種大小,最多訓練到 6.6T 個 token,後訓練直接套用同團隊的 Tülu 3 配方。報告把重點放在四件事:預訓練的穩定性、中期訓練(mid-training)的配方、後訓練,以及基礎設施。
這篇筆記主要看前兩件。第一件是 OLMo 2 能長大的前提;第二件則用到了模型合併。
定義問題
前一版 OLMo-0424 的表現在預期範圍內,但訓練過程很不安穩。
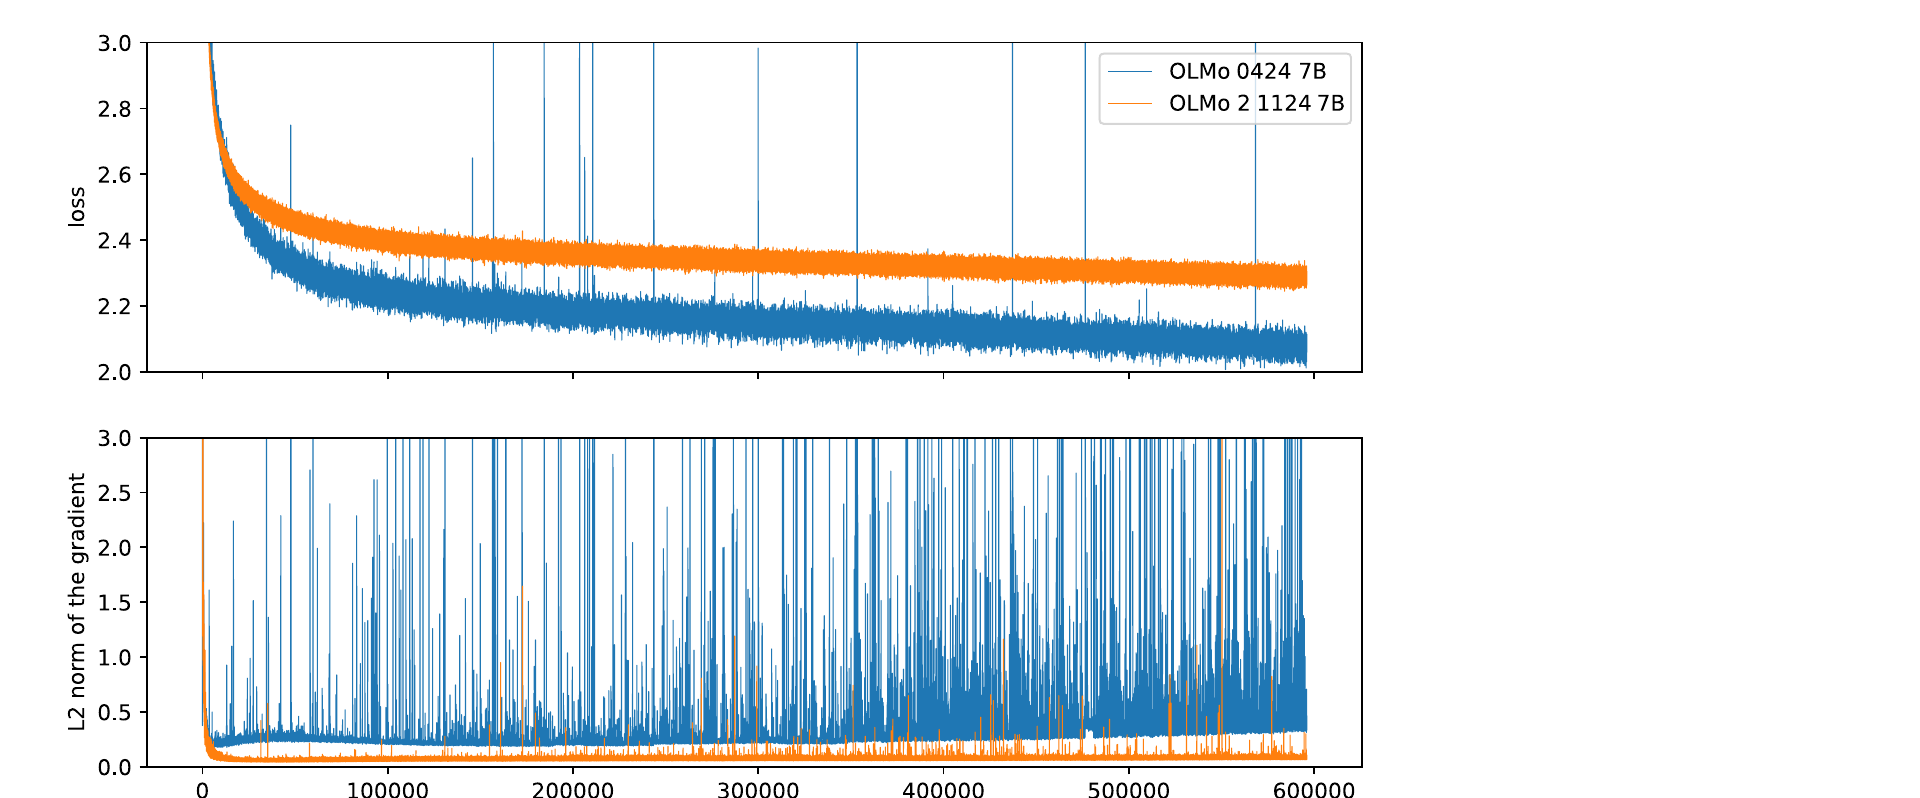
藍色是 OLMo-0424,問題有兩個。第一是損失與梯度範數的突然尖峰,而且梯度的尖峰常常出現在損失尖峰之前。第二是梯度範數的基準線在整個訓練過程中慢慢變大,尖峰也隨之越來越頻繁。作者發現模型越大,尖峰越多,兩者加起來最終會讓訓練發散,根本沒辦法擴大規模。
橘色是 OLMo 2,梯度幾乎貼在底部。上圖的橘色損失看起來比較高,是因為兩次訓練用的資料不同,不能直接比。
那麼,哪些改動把藍線變成了橘線?
解決問題
穩定性的七個改動
作者一共做了七個改動,有的動資料,有的動架構,有的只是改一個超參數。
1. 過濾重複的 n-gram。 作者檢查發生尖峰的批次,常常看到像 g400g400g400g400... 或一長串 255, 255, 255, ... 這種重複片段。關係並不確定,同樣的片段在大模型上會引發尖峰,在小模型上卻不會;換個資料順序也可能就沒事。但整體而言,去掉這類資料能降低尖峰的頻率。
做法是在資料整理時,刪除含有 32 次以上重複 n-gram 的文件(n 從 1 到 13 個 token);訓練程式在載入資料時也會再檢查一次,把漏網之魚的損失遮掉。這能明顯減少梯度尖峰,但對梯度範數慢慢上升的問題沒有幫助。
2. 初始化。 OLMo-0424 用的是縮放初始化,越深的層初始值越小。OLMo 2 改回最簡單的做法,所有參數都從平均 0、標準差 0.02 的常態分布抽樣。作者量測了隨機初始化的模型中,激活值與梯度從第一層到最後一層的放大或縮小程度,新的初始化在不同深度與寬度下都比較能保持尺度不變。
3. RMSNorm。 把不帶參數的 LayerNorm 換成 RMSNorm。
4. 正規化的位置。 這是一個比較少見的選擇。一般的 Pre-LN 是先正規化輸入,再送進注意力或前饋層;OLMo 2 改成正規化子層的輸出:
這個做法來自 Swin Transformer V2。殘差主幹 本身沒有被正規化,但每一層加上去的增量都先被壓到固定尺度,不會有某一層突然加入很大的值。
5. QK-norm。 在計算注意力之前,先對 query 和 key 做 RMSNorm,避免注意力的 logit 變得太大。
6. Z-loss。 在損失中加上 , 是輸出層 softmax 的分母。只要 logit 整體一路變大, 就跟著變大,這一項會把它拉回來。
這一項還有個插曲。FlashAttention 函式庫的交叉熵實作內建 z-loss,作者另外用 PyTorch 寫了一個版本備用。兩者前向傳播的結果相同,反向傳播卻不一樣,作者懷疑是數值精度的差異。雖然訓練損失與下游表現都看不出影響,作者還是決定丟掉換過實作的那段訓練,回到分歧點用原本的實作重跑。訓練進行到一半,他們盡量不換任何實作。
7. 兩個優化器設定。 嵌入層不再做權重衰減;AdamW 的 從 降到 。後者讓訓練初期的梯度範數更低、更穩定。
這七個改動,沒有一個是新發明。作者的貢獻在於一個一個做實驗、量出它們在 OLMo 這個設定下的效果,再全部放進同一個配方。
兩階段預訓練
OLMo 2 的預訓練分成兩個階段。
第一階段佔訓練計算量的九成以上,使用約 3.9T token 的 OLMo 2 Mix 1124,其中超過 95% 是網頁資料(主要來自 DCLM),其餘是程式(StarCoder)、論文(peS2o、arXiv)、數學網頁與維基百科。程式資料只保留 GitHub 星數至少 2 的倉庫;最常出現的一個字超過全文 30% 的文件也會被刪掉,以去除二進位或幾乎全是數字的內容。
第二階段作者稱為中期訓練,佔計算量的 5% 到 10%。學習率在這個階段線性降到 0,資料換成精選的 Dolmino Mix 1124:品質分類器挑出的前 7% 網頁、去污染的 FLAN 指令資料、論文、維基百科、Stack Exchange 問答,再加上專門補數學能力的合成資料。
效果很大。7B 模型經過中期訓練後,開發評測的平均分數提升了 10.6 分,超過了只做完第一階段的 13B。GSM8K 從 24.1 升到 67.5,MMLU 從 59.8 升到 63.7,DROP 從 40.7 升到 60.8。
用小退火篩資料
中期訓練的資料要怎麼選?完整跑一次 50B token 的退火太貴,作者發明了一個便宜的方法,叫做 microanneal。
- 挑出想評估的一個或一小組數學資料來源。
- 從一般資料中取等量的 token,組成一半數學、一半一般資料的小混合。
- 把這個小混合當成退火來訓練,學習率依照它的長度線性降到 0。
一共跑了 19 次 microanneal,總共 130B token,比三次完整的 50B 退火還少,而且通常訓練不到 10B token 就看得出差異。這個想法和 Llama 3 用退火評估小資料集很像,只是做得更系統。
中期訓練的模型湯
接下來是本筆記最關心的一步。中期訓練結束時,作者沒有只跑一次,而是用同一份資料、不同的資料順序跑好幾次,再把結果平均。
為了驗證這麼做有用,作者在 7B 上比較了六種中期訓練配比,每種都用三個不同的資料順序各跑 50B token,比較「三次中最好的一個」與「三個平均起來」:
| 配比 | 評測 | 最好的單一模型 | 三個平均 |
|---|---|---|---|
| A | OLMES | 75.6 | 77.0 |
| B | OLMES | 75.3 | 77.3 |
| C | OLMES | 76.3 | 76.8 |
| A | MMLU | 61.2 | 62.0 |
| B | MMLU | 61.5 | 62.7 |
| C | MMLU | 62.8 | 63.5 |
六種配比、四類評測共二十四組比較,有二十三組平均後不比最好的單一模型差,多數更好,例如配比 B 的 OLMES 多了 2 分。例外是配比 E 的 GSM*,平均後從 60.5 掉到 43.0。
所以最終的 OLMo 2 都是「湯」。7B 平均了三個各跑 50B token 的模型;13B 與 32B 平均了四個,三個各跑 100B token,另一個跑 300B token,作者發現這比只平均三個 100B 的效果更好。
這裡值得和 Tülu 3 對照一下。同一個團隊在 SFT 階段平均不同種子的模型,發現沒有比最好的單一模型好;在中期訓練平均不同資料順序的模型,卻幾乎每一組都有效。兩者的差別在於,中期訓練的每個模型都看了 50B 以上的 token,又都從同一個預訓練 checkpoint 出發、把學習率降到 0,條件很接近 Model Soups 與 PMA 研究的情境。論文沒有正面比較這兩種結果,這只是本文的推測。
後訓練
後訓練基本照搬 Tülu 3:SFT、長度正規化的 DPO、RLVR。改動有兩個。偏好資料改用授權寬鬆的模型生成回答;RLVR 分成多個階段進行,以取得最佳表現。
討論
計算量與表現的帕雷托前緣
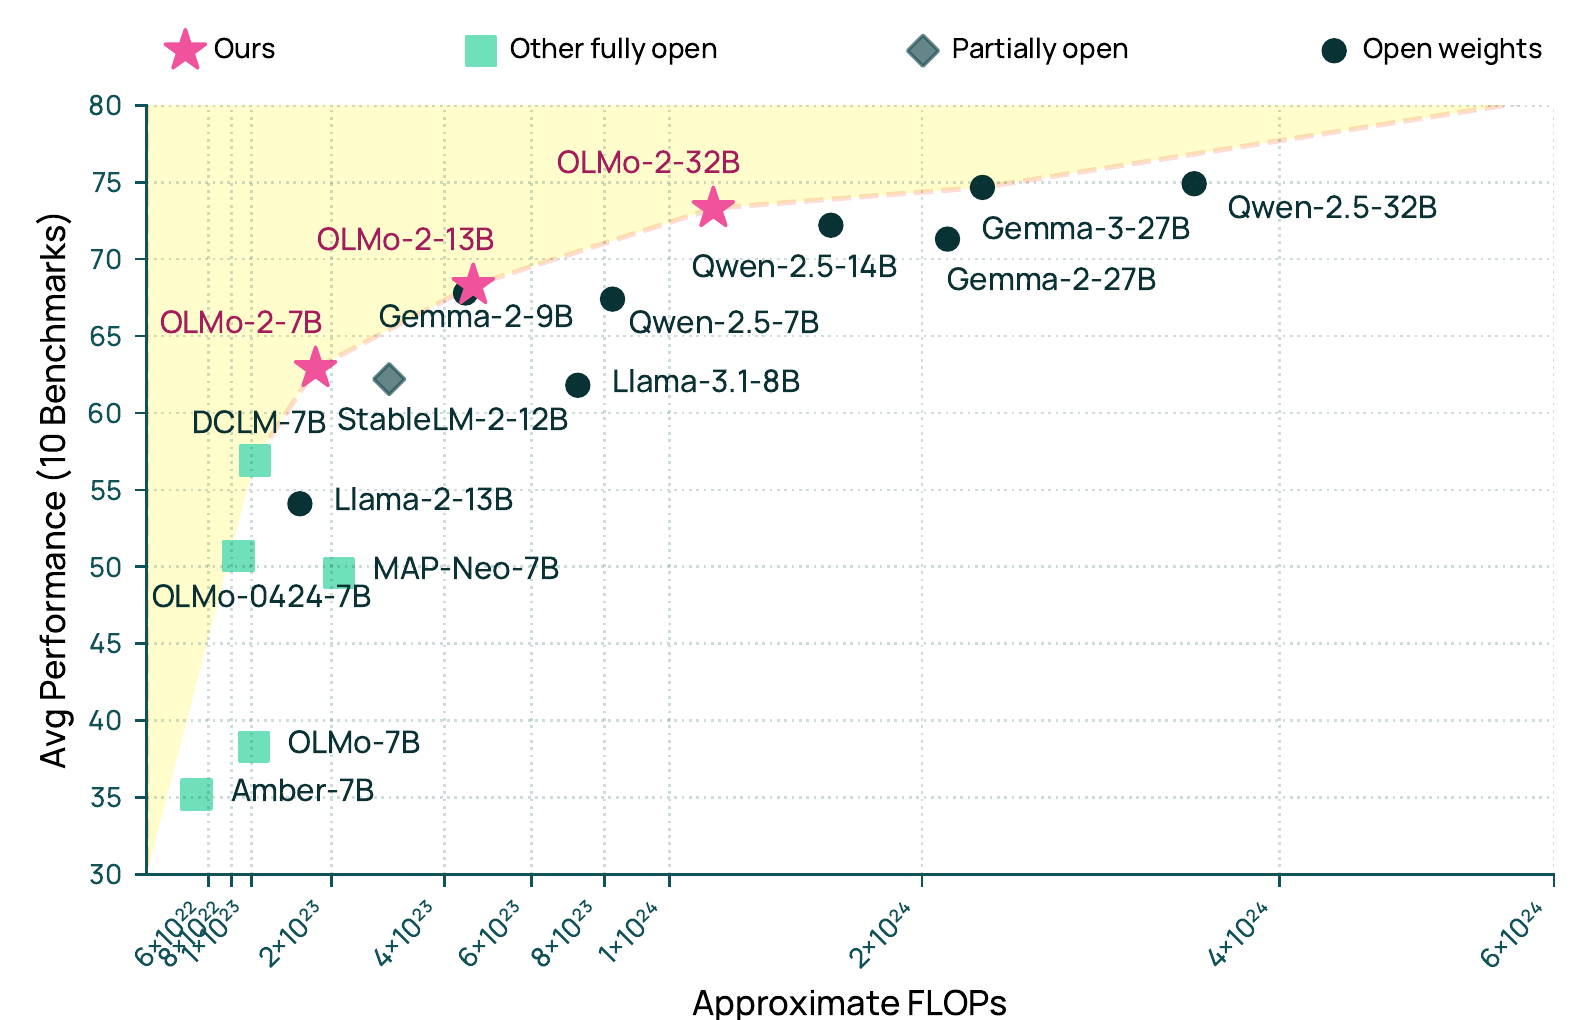
橫軸是預訓練計算量,縱軸是基底模型在 10 個基準上的平均。粉紅星星落在左上方的虛線上,代表同樣的計算量,OLMo 2 的表現比較好;或同樣的表現,它用的計算量比較少。例如 OLMo 2 13B 和 Gemma 2 9B 的分數相近,Qwen 2.5 7B 則用了更多計算才達到差不多的位置。
綠色方塊是其他完全開放的模型,大多落在左下方,OLMo 2 和它們拉開了一大段距離。
後訓練版本的比較,取自報告 Table 7 的平均分數:
| 模型 | 平均 | 預訓練 FLOPs() |
|---|---|---|
| OLMo 2 7B Instruct | 56.5 | 1.8 |
| Llama 3.1 8B Instruct | 59.1 | 7.2 |
| Qwen 2.5 7B Instruct | 61.6 | 8.2 |
| OLMo 2 13B Instruct | 63.5 | 4.6 |
| OLMo 2 32B Instruct | 68.8 | 13.0 |
| Qwen 2.5 32B Instruct | 68.1 | 35.0 |
| GPT-4o mini | 65.7 | — |
7B 仍落後 Llama 3.1 8B 與 Qwen 2.5 7B,但預訓練計算量只有它們的四分之一左右。32B 則以不到 Qwen 2.5 32B 四成的計算量,取得略高的平均分數,也超過 GPT-4o mini。
讀這份報告要注意的事
- 穩定性的證據多半是單一設定下的訓練曲線比較,七個改動是一起放進去的,個別貢獻只有部分消融。
- GSM8K 的處理。作者在發現預訓練後的數學能力很差時,從 GSM8K 的 1,319 題中抽了 200 題當中期訓練的開發集,所以 GSM8K 不完全是未見過的評測。報告的最終成績只用剩下的 1,119 題,作者在註腳中明確交代了這件事。
- 模型湯的證據來自 7B 上 50B token 的中期訓練,13B 與 32B 的四模型組合只說「實驗上較好」,沒有完整的表格。
結論
OLMo 2 是一份很實在的工程報告。它沒有新的架構,而是把穩定性、資料配比、評估方法一件一件做扎實,讓一個完全開放的模型第一次站上計算效率的前緣。
對模型合併來說,它提供了一個乾淨的正面案例:同一個起點、同一份資料、不同的資料順序,退火完平均起來,幾乎不會比最好的那一個差。
手上有多餘算力的話,不必只押一個資料順序。多跑兩次中期訓練,平均起來,比挑出最好的那一次更划算。