Article original
GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
- Publication
- ICML 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2403.03507
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersgalore2024,
  title = {{GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection}},
  author = {Jiawei Zhao and Zhenyu Zhang and Beidi Chen and Zhangyang Wang and Anima Anandkumar and Yuandong Tian},
  year = {2024},
  eprint = {2403.03507},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.03507}
}
Combien de mémoire faut-il pour entraîner depuis zéro un LLaMA de 7 milliards de paramètres, avec un batch réduit à une seule séquence de longueur 2 048 ?
L'article fait le calcul dès son introduction. Les poids en BF16 occupent 14 GB ; les gradients des poids 14 GB, plus 14 GB chacun pour les moments d'ordre un et deux d'Adam, soit 42 GB ; les activations, 2 GB de plus. Au total, 58 GB. Une RTX 4090 n'en a que 24.
L'article affirme qu'avec la méthode qu'il propose, combinée à 8-bit Adam et à des mises à jour couche par couche, le préentraînement d'un 7B ne demande, mesure à l'appui, que 22 GB. Sans découper le modèle, sans activation checkpointing ni déchargement vers le CPU, tout tient sur une seule 4090.
Définir le problème
Les vieilles recettes pour économiser la mémoire ne manquent pas. L'activation checkpointing échange de la mémoire contre du recalcul, ZeRO répartit l'état de l'optimiseur sur plusieurs cartes ou le déplace vers le CPU, 8-bit Adam quantifie les moments, et Adafactor factorise le moment d'ordre deux en sommes de lignes et de colonnes. Chacune économise une partie de la mémoire, au prix de temps, de communication ou de stabilité.
Une autre voie est LoRA. On écrit les poids , on gèle et l'on n'entraîne que deux petites matrices et ; gradients et état de l'optimiseur se réduisent à une taille de .
LoRA réussit très bien en affinage, mais peine en préentraînement. En partant de zéro, n'est qu'une initialisation aléatoire, et tout ce que le modèle peut apprendre est enfermé dans dimensions ; les améliorations comme ReLoRA doivent même commencer par une phase d'échauffement en entraînement de rang plein. Les auteurs y voient deux raisons ; d'une part, les meilleurs poids ne sont pas forcément de rang faible ; d'autre part, la reparamétrisation modifie elle-même la dynamique d'entraînement. Pour prendre un exemple extrême, si la solution optimale d'une régression linéaire est de rang élevé, contraindre à un rang faible empêche de l'atteindre, quel que soit l'optimiseur.
Les auteurs changent donc de question. Les poids n'ont pas besoin d'être de rang faible ; mais qu'en est-il des gradients ?
Résoudre le problème
Le gradient devient de rang faible
Le point de départ théorique des auteurs est une classe de « réseaux réversibles », qui comprend les couches linéaires (sans biais), ReLU, leaky ReLU et autres couches de ce type, ainsi que leurs compositions et leurs sommes, réseaux résiduels compris. Pour ces réseaux, le gradient des poids sur un batch peut s'écrire
et sont des matrices semi-définies positives. Le Lemma 3.3 démontre que si , et restent fixes à partir d'un certain instant, alors, avec une mise à jour SGD ordinaire, le stable rank de (, qu'on peut voir comme un « rang effectif ») décroît exponentiellement, jusqu'à ne plus garder que la partie déterminée par le plus petit sous-espace propre. Le Corollary 3.4 donne une borne supérieure plus concrète. Quand le gradient est une somme de produits extérieurs, un pour chacune des données, et que les vecteurs d'entrée sont de rang , le stable rank final ne dépasse pas ; et comme une somme de produits extérieurs est elle-même de rang au plus , l'article en déduit qu'à long terme, le stable rank ne dépasse pas .
Intuitivement, le gradient d'une couche linéaire est la somme des produits extérieurs « erreur rétropropagée de chaque donnée × entrée de chaque donnée » ; il n'a donc d'emblée qu'un nombre limité de directions, et après un certain temps d'entraînement, l'essentiel de sa masse se concentre en outre sur quelques-unes d'entre elles.
Cette théorie ne couvre que les réseaux réversibles, des matrices de coefficients fixes et des mises à jour SGD. Pour les Transformers, les auteurs utilisent en annexe un autre cadre et ne démontrent que le fait que le gradient de la première projection de la couche feed-forward devient de rang faible ; ni l'auto-attention ni Adam n'entrent dans le champ de la preuve.
Faire de l'Adam dans un petit sous-espace
Puisque le gradient se concentre sur quelques directions, il suffit de tenir l'état de l'optimiseur dans ces seules directions. GaLore (Gradient Low-Rank Projection) se définit par
est un optimiseur quelconque à état, Adam par exemple. En pratique, on n'utilise qu'une projection d'un seul côté. Pour des poids avec , on fait toutes les étapes une SVD du gradient courant, et l'on prend les premiers vecteurs singuliers à gauche comme matrice de projection,
puis, à chaque étape :
(L'article définit comme le gradient négatif, d'où le signe plus dans la mise à jour des poids.) est un coefficient d'échelle, au rôle comparable au de LoRA, mais qui ne varie pas avec .
Déroulons le calcul sur une matrice de poids de la couche feed-forward de LLaMA 7B, de forme , avec le des expériences 7B de l'article. Le gradient est de ; la matrice de projection de ; le projeté n'est plus que de , tout comme les et d'Adam. Adam devait stocker millions de valeurs ; il en faut maintenant 22.54 millions pour et , plus 4.19 millions pour , soit environ 26.74 millions, autour de 30 % de la quantité initiale. La mise à jour elle-même reste une matrice complète, et les poids gardent leur rang plein.
Au total, pour des poids , GaLore doit stocker valeurs, contre pour LoRA (les poids d'origine, les deux adaptateurs, et les deux moments de ces adaptateurs).
Il y a une autre différence avec LoRA. Avec de rang plein, , et avec un SGD simple, la trajectoire de GaLore est identique à celle de l'entraînement d'origine ; avec LoRA, même si est de rang plein, optimiser simultanément et suit une autre trajectoire.
Les auteurs démontrent aussi la convergence à projection fixe (Theorem 3.8). Les conditions sont , c'est-à-dire un SGD sans état, et une plus petite valeur propre du sous-problème projeté supérieure à un seuil fixé par des constantes de continuité. Le théorème suggère d'aligner la projection sur le plus grand sous-espace propre, ce qui justifie précisément de prendre les premières directions de la SVD du gradient. Les auteurs précisent aussi que cette convergence garantit seulement une bonne progression dans ce sous-espace, pas la performance globale.
Changer de sous-espace
En restant dans un sous-espace fixe, la variation des poids n'aurait jamais que dimensions, et l'on retomberait dans le vieux problème de LoRA. GaLore change de sous-espace toutes les étapes :
Chaque segment est de rang faible, mais leur somme peut être de rang plein.
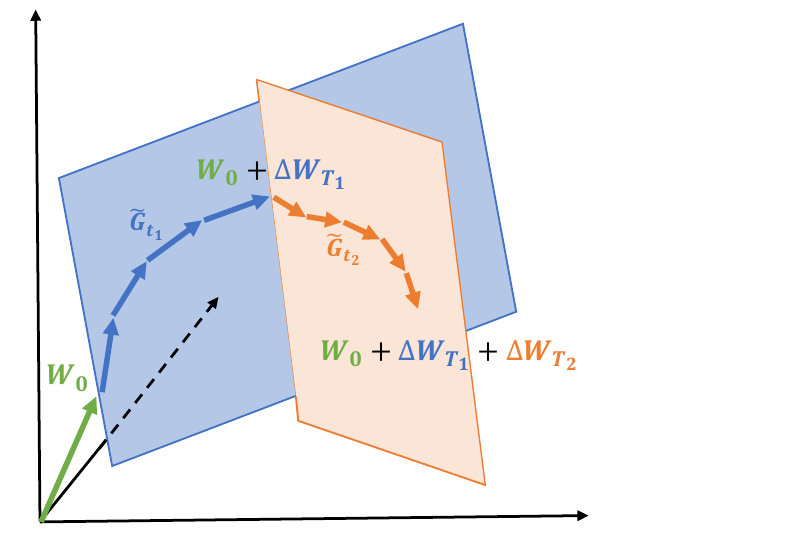
Le plan bleu est le sous-espace des premières étapes, dans lequel les poids avancent un moment ; à , on recalcule la SVD sur le gradient courant, on passe au plan orange, et l'on repart de la position atteinte.
Comment choisir ? En changeant trop souvent, le coût des SVD grimpe, la projection fixe exigée par le théorème n'est plus respectée, et les moments accumulés par Adam se faussent à force de changer de base ; en changeant trop rarement, on risque de rester coincé dans un sous-espace devenu sans importance. Les auteurs constatent que entre 50 et 1 000 fait peu de différence, utilisent 200 pour tous les préentraînements, et estiment le surcoût total des SVD à moins de 10 %. Par ailleurs, lors d'un changement de sous-espace, l'Algorithm 2 conserve et tels quels, sans les réinitialiser ni les convertir dans la nouvelle base.
Deux astuces de plus
GaLore ne compresse que l'état de l'optimiseur ; les auteurs y ajoutent deux techniques existantes. D'abord, remplacer Adam par 8-bit Adam ; c'est cette combinaison que désigne « 8-bit GaLore » dans la suite. Ensuite, les mises à jour couche par couche ; dès que la rétropropagation a calculé le gradient d'une couche, on met cette couche à jour, sans garder les gradients de tout le modèle jusqu'à la fin, à la manière de la famille LOMO.
Discussion
Préentraînement de 60M à 1B
Les expériences reprennent la configuration de ReLoRA : architecture LLaMA (RMSNorm, SwiGLU), entraînement sur C4 sans répétition des données, séquences de longueur 256, 131K tokens par étape, tout en BF16. Pour chaque méthode et chaque taille, on retient le meilleur de cinq taux d'apprentissage ; GaLore, lui, utilise pour toutes les tailles un taux de 0.01, et , soit un taux effectif de 0.0025, plus grand que les taux de 0.001 ou moins qu'utilise d'ordinaire la référence de rang plein.
| Méthode | 60M | 130M | 350M | 1B |
|---|---|---|---|---|
| Rang plein | 34.06 | 25.08 | 18.80 | 15.56 |
| GaLore | 34.88 | 25.36 | 18.95 | 15.64 |
| LoRA | 34.99 | 33.92 | 25.58 | 19.21 |
| ReLoRA | 37.04 | 29.37 | 29.08 | 18.33 |
| 78.18 | 45.51 | 37.41 | 142.53 |
D'après la Table 2 de l'article ; perplexité sur la validation de C4, plus c'est bas, mieux c'est ; les rangs sont respectivement de 128, 256, 256 et 512 (dimensions de modèle 512, 768, 1024 et 2048).
Aux quatre tailles, GaLore colle au rang plein, avec seulement 0.08 d'écart à 1B ; LoRA et ReLoRA décrochent de plus en plus à mesure que le modèle grandit. Factoriser directement les poids en et entraîner depuis zéro donne le pire résultat, avec une perplexité de 142.53 à 1B. Côté mémoire, l'estimation des paramètres et de l'état de l'optimiseur à 1B est de 7.80 GB pour le rang plein, 4.38 GB pour GaLore et 6.17 GB pour LoRA.
Deux choses sont à garder en tête en lisant ce tableau. La mémoire indiquée ici est une taille BF16 estimée d'après le nombre de paramètres, sans activations ni gradients. ReLoRA est comparé sans son échauffement de rang plein ; les auteurs disent que c'est par souci d'équité, mais la méthode a été conçue avec cet échauffement ; et LoRA a lui aussi été conçu pour l'affinage.
Le 7B et la 4090
L'expérience 7B tourne sur 8 nœuds, soit 64 A100 au total, pendant 150 000 étapes et 19.7 milliards de tokens. Faute de puissance de calcul, 8-bit GaLore () et 8-bit Adam ne sont lancés qu'une fois chacun, sans réglage.
| Méthode | 40k étapes | 80k étapes | 120k étapes | 150k étapes |
|---|---|---|---|---|
| 8-bit GaLore | 17.94 | 15.39 | 14.95 | 14.65 |
| 8-bit Adam | 18.09 | 15.47 | 14.83 | 14.61 |
D'après la Table 3 de l'article ; perplexité sur la validation de C4.
GaLore est un peu meilleur au début, 8-bit Adam reprend l'avantage ensuite, et l'écart final est de 0.04.
La fameuse 4090 apparaît dans une autre série d'expériences. Les auteurs y mesurent la mémoire réelle sur un seul appareil, sans activation checkpointing ni offloading, avec une taille de batch de 256 tokens.
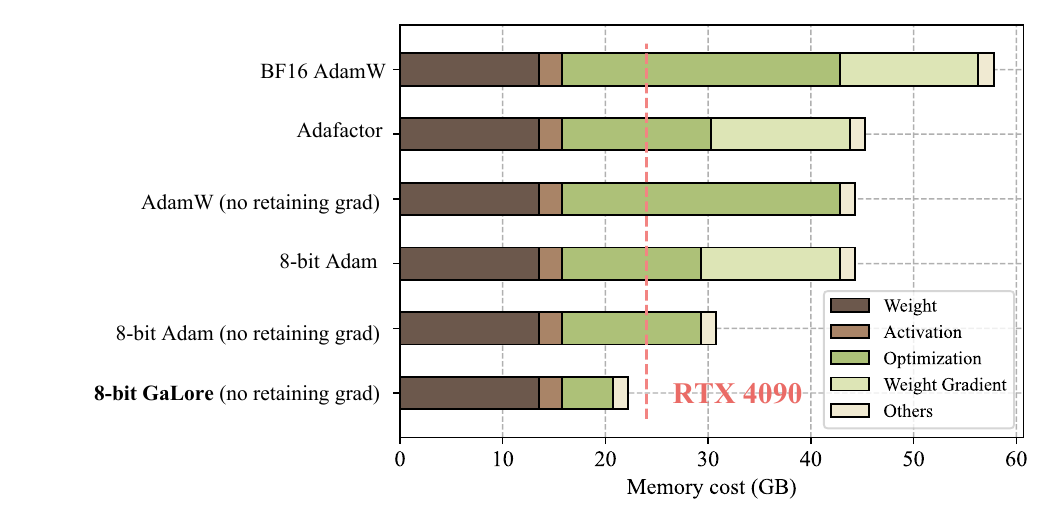
Regardez les deux barres du bas. Sans conservation des gradients, 8-bit Adam occupe environ 31 GB ; avec 8-bit GaLore, le segment de l'état de l'optimiseur (en vert foncé) raccourcit nettement, pour un total d'environ 22 GB, à gauche de la ligne pointillée rouge des 24 GB. Par rapport à 8-bit Adam, la projection de rang faible économise 9.6 GB d'état de l'optimiseur, et les mises à jour couche par couche 13.5 GB de gradients des poids ; par rapport à AdamW en BF16, l'économie totale est de 63.3 %.
« Préentraîner un 7B sur une 4090 » mesure donc si la mémoire tient ; le batch de la mesure n'est que de 256 tokens (environ 500 au plus sans checkpointing), et même avec activation checkpointing, il ne monte qu'à 4 096 ; l'expérience 7B réellement menée à terme dans l'article utilise 64 A100. Les auteurs envisagent de faire du data-parallèle sur de nombreuses cartes grand public, mais l'article ne l'a pas réellement fait.
Vitesse et hyperparamètres
Économiser de la mémoire coûte du temps. Dans une mesure sur LLaMA 1B avec un batch de 256 tokens, 8-bit GaLore avec mises à jour couche par couche traite 1 019.63 tokens par seconde, contre 1 205.31 pour 8-bit Adam, soit un surcoût d'environ 17 % selon les auteurs ; sans mises à jour couche par couche, GaLore remonte à 1 109.38.
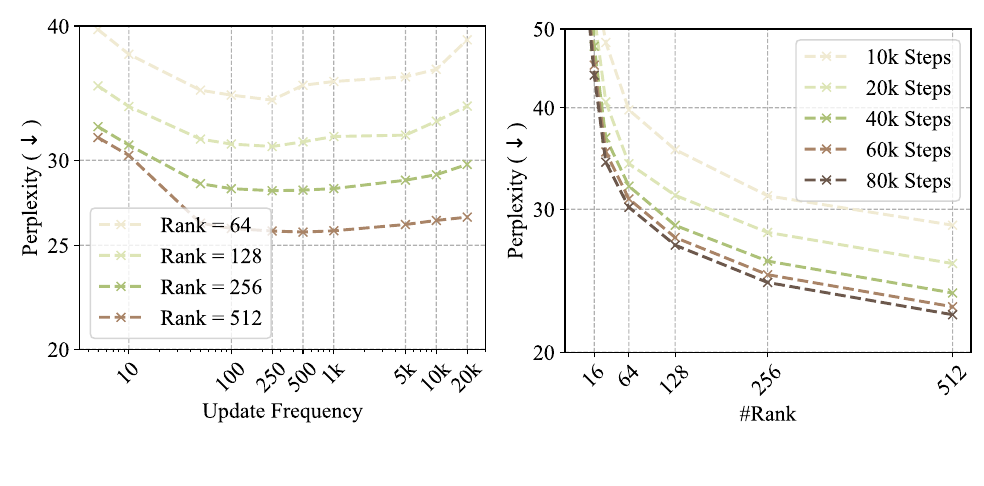
La figure de gauche porte sur la fréquence de mise à jour . Pour les quatre rangs, la courbe est en U ; changer trop souvent ou trop rarement dégrade le résultat, et le creux se situe autour d'un changement toutes les 250 à 500 étapes ; plus le rang est petit, plus il faut changer souvent. La figure de droite porte sur le rang ; dans une certaine plage, réduire le rang ne fait que ralentir un peu la convergence, et le rang 128 sur 80 000 étapes fait mieux que le rang 512 sur 20 000 étapes. Autrement dit, quand la mémoire manque, on peut compenser par du temps.
Affinage
En affinage, les écarts sont bien moins marqués qu'en préentraînement. Pour RoBERTa-Base sur GLUE, au rang 4, GaLore obtient une moyenne de 85.89, LoRA 85.61 et l'affinage complet 86.28 ; au rang 8, 85.94 contre 85.93, quasiment à égalité. La mémoire indiquée dans le tableau, 253M contre 257M, compte elle aussi les paramètres et l'état de l'optimiseur. En annexe, pour LLaMA-7B affiné sur les dialogues d'OpenAssistant, la perplexité de test est de 2.95 pour GaLore et 2.94 pour LoRA ; les écarts plus nets apparaissent sur SQuAD avec BERT-Base (F1 88.29 contre 86.11) et sur l'affinage de Phi-2 sur OpenAssistant (perplexité 3.83 contre 4.24).
Par ailleurs, GaLore met à jour les poids complets à chaque étape, et l'on obtient à la fin un modèle entièrement nouveau ; LoRA permet de ne stocker qu'un petit adaptateur, qu'on branche ou débranche à volonté. Lequel est le plus pratique dépend des besoins du déploiement.
Les vérifications ultérieures
Le coût de la SVD. L'article estime le surcoût des SVD à moins de 10 %, mais ceux qui l'ont mesuré ne sont pas du même avis. Dès le lendemain de la publication de GaLore, l'auteur de LLaMA-Factory publie un test indépendant. Pour l'affinage de LLaMA-2 7B sur A100, avec activation checkpointing, 16-bit GaLore sans conservation des gradients ne demande que 18 GB, contre 40 GB pour 8-bit AdamW, et le débit des étapes ordinaires n'est pas moins bon ; mais une note sous le tableau précise que chaque SVD prend environ 10 minutes pour un 7B, et n'est pas comptée. L'équipe qui a ensuite proposé APOLLO (dont font partie deux coauteurs de GaLore) rapporte elle aussi environ 10 minutes par mise à jour du sous-espace pour LLaMA-7B, avec une chute du débit toutes les 200 étapes. Dans l'intégration Hugging Face, le mode à mises à jour couche par couche ne fonctionne que sur un seul GPU, ne prend pas en charge DDP, et l'écrêtage du gradient comme DeepSpeed peuvent mal se comporter.
La convergence. Dans un article d'octobre 2024, He et al. donnent un contre-exemple explicite, prouvant que sous les hypothèses standard de l'optimisation stochastique, GaLore ne converge pas nécessairement vers un point stationnaire. La raison est que la SVD ne retient que les plus grandes directions ; en fin d'entraînement, le vrai gradient devient petit alors que le bruit demeure, et les premiers vecteurs singuliers risquent de ne capter que du bruit. GaLore n'a de garantie qu'en l'absence de bruit, avec un batch qui grandit avec le nombre d'étapes (par exemple ), ou avec un bruit uniforme dans toutes les directions. Le GoLore qu'ils proposent passe à une projection aléatoire, et ils recommandent d'utiliser GaLore au début, puis GoLore pour la dernière phase.
L'échelle. En avril 2025, deux auteurs de GaLore, Jiawei Zhao et Yuandong Tian, publient GaLore 2 avec l'équipe PyTorch de Meta. Ils indiquent que chaque SVD de LLaMA 7B peut prendre jusqu'à 20 minutes, et qu'une SVD randomisée va 15 fois plus vite ; ils notent aussi que le signe des vecteurs de la SVD n'est pas unique, si bien que les projections issues de deux factorisations peuvent ne pas concorder. Cette fois, LLaMA 7B est entraîné depuis zéro sur 500 milliards de tokens, sur 32 nœuds et 256 H100, avec 8-bit Adam comme témoin. GaLore est légèrement en retard sur les 150 premiers milliards de tokens, passe devant vers 200 milliards, et les deux finissent à égalité.
Conclusion
Garder les poids en rang plein, ne placer que l'état de l'optimiseur dans le sous-espace de rang faible du gradient, et changer régulièrement de sous-espace, voilà ce qui distingue fondamentalement GaLore de LoRA. En préentraînement jusqu'à 1B, il ne s'écarte d'Adam en rang plein que de quelques dixièmes de perplexité, bien mieux que LoRA ; le 7B, lancé une seule fois, finit lui aussi à peu près au niveau de 8-bit Adam. En contrepartie, il faut une SVD toutes les quelques centaines d'étapes, et accepter une théorie qui ne tient que sous des conditions particulières.
Pour un affinage de tous les paramètres sur une seule carte grand public, GaLore vaut la peine d'être essayé. Avant de vous lancer, mesurez le temps d'une SVD, et vérifiez qu'avec les mises à jour couche par couche, votre configuration multi-cartes fonctionne encore. Si vous voulez simplement économiser de la mémoire pour un affinage, LoRA ou QLoRA sont généralement plus simples.
Et la 4090, alors ? La validation à grande échelle de GaLore 2 a utilisé 256 H100.