Article original
Sharpness-Aware Minimization for Efficiently Improving Generalization
- Publication
- ICLR 2021Conférence
- Premier dépôt sur arXiv
- arXiv:2010.01412
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerssam2020,
  title = {{Sharpness-Aware Minimization for Efficiently Improving Generalization}},
  author = {Pierre Foret and Ariel Kleiner and Hossein Mobahi and Behnam Neyshabur},
  year = {2020},
  eprint = {2010.01412},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2010.01412}
}
Le même ResNet, entraîné avec SGD, finit au fond d'un trou étroit et pointu ; avec une autre méthode d'entraînement, il finit au fond d'un large bol. Aux deux points, la perte d'entraînement est très basse, et le modèle a le même nombre de paramètres.
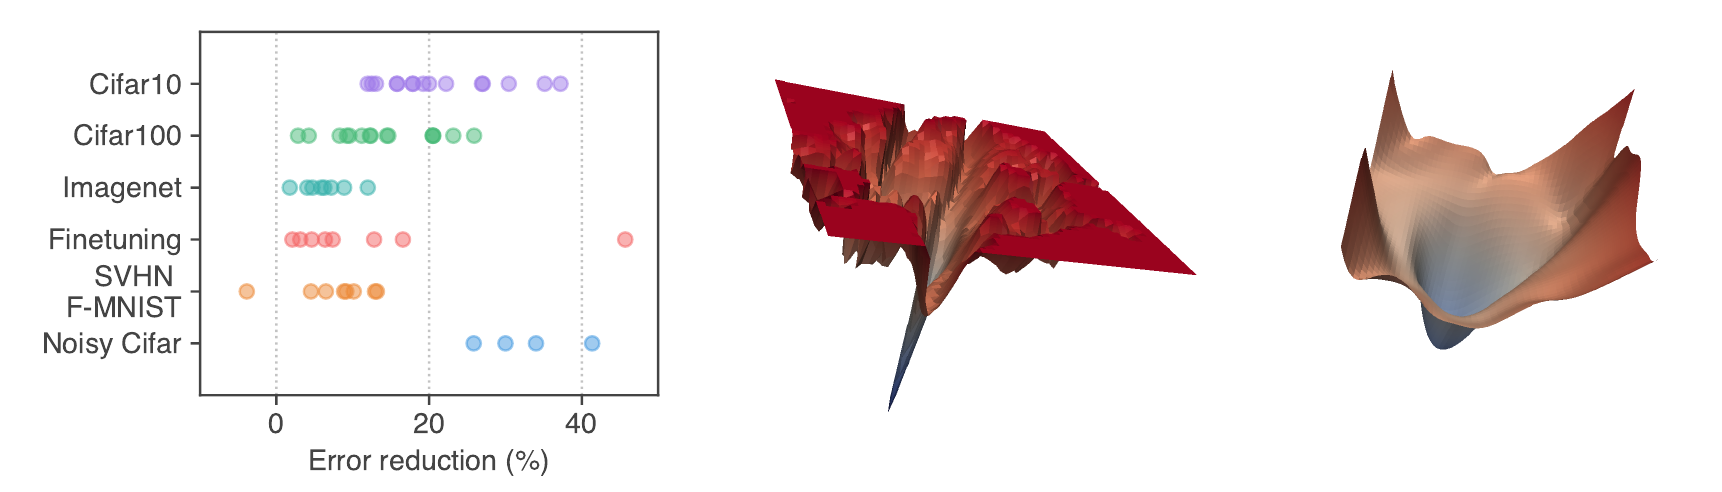
Ces deux paysages, au centre et à droite, sont l'image que Pierre Foret, Ariel Kleiner et Hossein Mobahi, de Google Research, et Behnam Neyshabur, de Blueshift chez Alphabet, ont placée en première page de leur article (avec un ResNet-56 privé de ses connexions résiduelles). Le graphique de gauche montre leur palmarès. Sur des dizaines de configurations, le passage à SAM fait presque toujours baisser le taux d'erreur, de quelques pour cent à plus de 40 %.
L'idée que « les minima plats généralisent mieux » est ancienne et remonte au moins aux années 1990. Ici, puisqu'on veut un minimum plat, on inscrit directement la platitude dans la fonction objectif, à un coût assez bas pour pouvoir entraîner sur ImageNet.
Définir le problème
Les réseaux de neurones modernes ont tant de paramètres qu'ils peuvent mémoriser entièrement leurs données d'entraînement. La perte d'entraînement a de nombreux minima presque aussi bas les uns que les autres, mais leurs performances en test diffèrent beaucoup, et celui qu'on obtient dépend largement de l'optimiseur et de ses réglages.
Le lien entre acuité (sharpness) et généralisation a déjà été beaucoup étudié. Keskar et al. ont observé que l'entraînement à grands lots tend à s'arrêter dans des minima pointus, qui généralisent moins bien ; en 2019, Jiang et al. ont comparé 40 mesures de complexité, et ce sont les mesures fondées sur l'acuité qui sont les plus corrélées à l'écart de généralisation.
L'ennui, c'est que la plupart des mesures d'acuité proposées jusque-là sont difficiles à calculer, et plus encore à différencier. Entropy-SGD régularise plutôt l'entropie locale ; SWA moyenne les poids de la fin de l'entraînement et peut aboutir à une région plus plate, mais sans minimiser directement l'acuité. Les auteurs veulent une procédure qui optimise directement l'acuité tout en passant à l'échelle des grands modèles.
Résoudre le problème
De la borne de généralisation au min-max
Le point de départ est une borne de généralisation PAC-Bayes (version informelle du Theorem 1). Pour tout , avec forte probabilité,
est la perte sur la population, la perte d'entraînement, et une fonction croissante. En décomposant le membre de droite :
Le crochet mesure « de combien la perte peut au plus augmenter dans une boule de rayon autour de » ; c'est l'acuité. En remplaçant par une régularisation L2 ordinaire, , les auteurs obtiennent l'objectif de SAM :
On ne cherche plus un point dont « la perte est basse », mais un point dont « tout le voisinage a une perte basse ».
Approximation du premier ordre :
La maximisation interne ne peut pas être résolue exactement. Les auteurs font un développement de Taylor au premier ordre de en :
Maximiser un produit scalaire dans une boule de norme est un problème classique de norme duale. Pour , la solution consiste à remettre le gradient à l'échelle pour qu'il ait une longueur :
Autrement dit, on avance d'une distance « vers le haut de la pente », dans la direction du gradient. L'annexe essaie aussi (), qui fait moins bien que ; une perturbation de même longueur dans une direction aléatoire fait aussi moins bien qu'une perturbation le long du gradient.
Il faut ensuite calculer le gradient de . Comme dépend lui-même de , la règle de dérivation en chaîne fait apparaître un terme , où se cache la hessienne :
Le second terme pourrait se calculer par un produit hessienne-vecteur, mais les auteurs le laissent tomber pour économiser du calcul ; le gradient final est
On va chercher le gradient au point perturbé , puis on s'en sert pour mettre à jour le d'origine.
Abandonner le terme du second ordre est une approximation, et les auteurs la comparent en annexe. Pendant la première moitié de l'entraînement, les directions de mise à jour avec et sans ce terme sont presque identiques, avec une similarité cosinus proche de 1 ; elles ne se séparent qu'à l'approche de la convergence, et la version sans terme du second ordre a même une erreur de test plus basse, ce que les auteurs reconnaissent être « quite unclear ». Ils ont aussi essayé plusieurs pas d'ascension de gradient projetée dans la boucle interne, pour trouver plus précisément le pire point ; sur CIFAR-10, l'erreur de test vaut 2.77 %, 2.76 %, 2.73 % et 2.77 % pour 1, 2, 3 et 5 pas, à peu près pareil ; sur CIFAR-100, plusieurs pas font un peu mieux (16.72 % contre environ 16.6 %).
Deux gradients
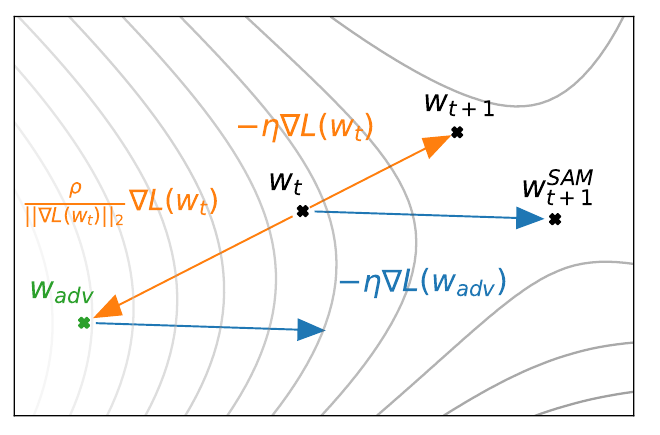
Suivons la figure. Depuis , SGD ordinaire suivrait jusqu'à , en haut à droite. SAM part d'abord dans l'autre sens, remonte un peu la pente le long du gradient et arrive en , estimation au premier ordre du point de perte maximale dans le rayon . Le gradient calculé en donne la flèche bleue ; c'est en reportant cette flèche à partir de qu'on obtient le de SAM. Les deux points d'arrivée sont dans des directions différentes ; SAM suit une direction qui « fait baisser la perte même dans le pire des cas ».
Chaque étape demande donc deux passes avant et deux rétropropagations, soit deux fois le calcul habituel. En PyTorch, avec un SGD ordinaire comme optimiseur de base :
import torch

def sam_step(model, loss_fn, x, y, base_opt, rho=0.05):
    """Une mise à jour SAM (p = 2) : aller d'abord au pire point du voisinage, puis mettre à jour les poids d'origine avec le gradient pris là-bas"""
    params = [p for p in model.parameters() if p.requires_grad]

    loss_fn(model(x), y).backward()                    # 1re rétropropagation : ∇L(w)
    with torch.no_grad():
        norm = torch.norm(torch.stack([p.grad.norm() for p in params]))
        eps = [rho * p.grad / (norm + 1e-12) for p in params]   # ε̂ = ρ ∇L / ‖∇L‖₂
        for p, e in zip(params, eps):
            p.add_(e)                                  # w → w + ε̂
    base_opt.zero_grad()

    loss_fn(model(x), y).backward()                    # 2e rétropropagation : ∇L(w + ε̂)
    with torch.no_grad():
        for p, e in zip(params, eps):
            p.sub_(e)                                  # retour à w
    base_opt.step()                                    # w ← w − η ∇L(w + ε̂)
    base_opt.zero_grad()
Ici, la norme est calculée en concaténant les gradients de tous les paramètres en un seul vecteur, et tout le modèle partage un même .
Choisir
est le seul hyperparamètre ajouté par SAM. Les auteurs le choisissent dans en réservant 10 % des données d'entraînement comme ensemble de validation ; sur CIFAR, les valeurs retenues vont de 0.02 à 0.2. Ils disent aussi que est un « solid default ». En annexe, toutes les expériences CIFAR et d'affinage sont relancées avec 0.05, et les résultats sont le plus souvent identiques ou à peine différents de ceux obtenus avec réglé, tout en battant toujours la référence sans SAM. Toutes les expériences ImageNet utilisent 0.05.
Attention, est une distance absolue dans l'espace des paramètres. Le même 0.05 est une petite perturbation pour des poids de grande valeur, et une grande perturbation pour des poids de petite valeur. Ce point reviendra plus loin.
Discussion
Conditions de comparaison
Chaque expérience remplace directement la procédure d'entraînement d'origine par SAM. Comme SAM calcule deux gradients par étape, les auteurs font tourner la référence sans SAM sur deux fois plus d'époques, et retiennent le meilleur résultat entre la durée standard et la durée doublée ; selon eux, l'allongement n'aide pas nettement dans la plupart des cas. Chaque configuration est lancée 5 fois, avec la moyenne et l'intervalle de confiance à 95 %. L'implémentation est en JAX ; sur plusieurs accélérateurs, chacun calcule son et son gradient SAM sur son propre sous-lot, avant que tout soit moyenné. Ce détail deviendra très important plus loin.
CIFAR
Sur CIFAR, les modèles sont des WideResNet, Shake-Shake et PyramidNet déjà très bien réglés, qui embarquent toutes sortes de régularisations. Voici quelques lignes :
| Modèle et augmentation | CIFAR-10 | CIFAR-100 |
|---|---|---|
| WRN-28-10, 200 ep, basique | 2.7 / 3.5 | 16.5 / 18.8 |
| WRN-28-10, 1800 ep, AA | 1.6 / 2.2 | 12.8 / 16.1 |
| PyramidNet, basique | 2.7 / 4.0 | 14.6 / 19.7 |
| PyramidNet+ShakeDrop, AA | 1.4 / 1.6 | 10.3 / 10.6 |
D'après la Table 1 de l'article ; chaque case donne le taux d'erreur de test « SAM / SGD » (%), et AA désigne AutoAugment.
Avec SAM, un simple WideResNet fait passer l'erreur sur CIFAR-10 de 2.2 % à 1.6 %, un niveau qu'il fallait jusque-là atteindre avec des combinaisons complexes comme PyramidNet plus ShakeDrop. Sur PyramidNet+ShakeDrop, déjà fortement régularisé, le gain est bien plus faible, de 10.6 % à 10.3 % sur CIFAR-100, mais c'est aussi le meilleur résultat de l'époque sans données supplémentaires.
ImageNet
ResNet-50, 101 et 152, lots de 4096, SGD avec momentum, planification en cosinus, label smoothing, , jusqu'à 400 époques d'entraînement.
| Modèle | 100 ep | 200 ep | 400 ep |
|---|---|---|---|
| ResNet-50 | 22.5 / 22.9 | 21.4 / 22.3 | 20.9 / 22.3 |
| ResNet-101 | 20.2 / 21.2 | 19.4 / 20.9 | 19.0 / 22.3 |
| ResNet-152 | 19.2 / 20.4 | 18.5 / 20.3 | 18.4 / 20.9 |
D'après la Table 2 de l'article ; chaque case donne le taux d'erreur top-1 « SAM / entraînement standard » (%).
Lisons ce tableau dans le sens des lignes. Entre 200 et 400 époques, l'entraînement standard régresse au lieu de progresser, ResNet-101 passant de 20.9 % à 22.3 %, un cas typique de surapprentissage ; SAM, lui, s'améliore tout du long. Alignons ensuite les budgets de calcul. 200 époques de SAM coûtent à peu près autant que 400 époques d'entraînement standard ; ResNet-50 donne alors 21.4 % contre 22.3 %, ResNet-152 18.5 % contre 20.9 %, et SAM gagne encore. Pour 100 contre 200 époques, SAM sur ResNet-50 obtient 22.5 %, un peu moins bien que les 22.3 % de l'entraînement standard.
Affinage
L'affinage part des checkpoints publics d'EfficientNet ; EfficientNet-L2 a déjà été entraîné avec NoisyStudent sur ImageNet et JFT jusqu'à 88.2 %. Avec un affinage par SAM, l'erreur top-1 sur ImageNet passe de 11.8 % à 11.39 %, celle de CIFAR-100 de 4.07 % à 3.92 %, et celle de Stanford Cars de 4.93 % à 4.04 % ; ImageNet et CIFAR-100 battent ainsi les records de l'époque. Les statistiques de BN sont gelées pendant l'affinage, et l'entraînement sur ImageNet ne dure que 10 époques.
Étiquettes bruitées
Puisque SAM cherche des paramètres « insensibles aux perturbations alentour », les auteurs supposent qu'il résiste aussi mieux au bruit des données d'entraînement. L'expérience mélange aléatoirement une partie des étiquettes du jeu d'entraînement de CIFAR-10, garde le jeu de test propre, et entraîne un ResNet-32 pendant 200 époques :
| Méthode | 20 % | 40 % | 60 % | 80 % |
|---|---|---|---|---|
| SGD | 84.8 | 68.8 | 48.2 | 26.2 |
| Mixup | 93.0 | 90.0 | 83.8 | 70.2 |
| SAM | 95.1 | 93.4 | 90.5 | 77.9 |
| Bootstrap+SAM | 95.4 | 94.2 | 91.8 | 79.9 |
| MentorMix | 95.6 | 94.2 | 91.3 | 81.0 |
D'après la Table 4 de l'article ; les colonnes donnent la proportion de bruit, les valeurs la précision sur le jeu de test propre (%) ; les chiffres de MentorMix viennent de la littérature.
Quand 80 % des étiquettes sont fausses, SGD tombe à 26.2 %, SAM garde 77.9 %. SAM seul bat toutes les méthodes conçues pour les étiquettes bruitées, à l'exception de MentorMix ; en entraînant une première fois, puis en réentraînant avec les prédictions du modèle comme étiquettes (Bootstrap), on arrive à peu près au niveau de MentorMix. Dans cette série, vaut 0.1, mais il faut passer à 0.05 avec 80 % de bruit pour une convergence stable.
m-sharpness : chaque accélérateur perturbe de son côté
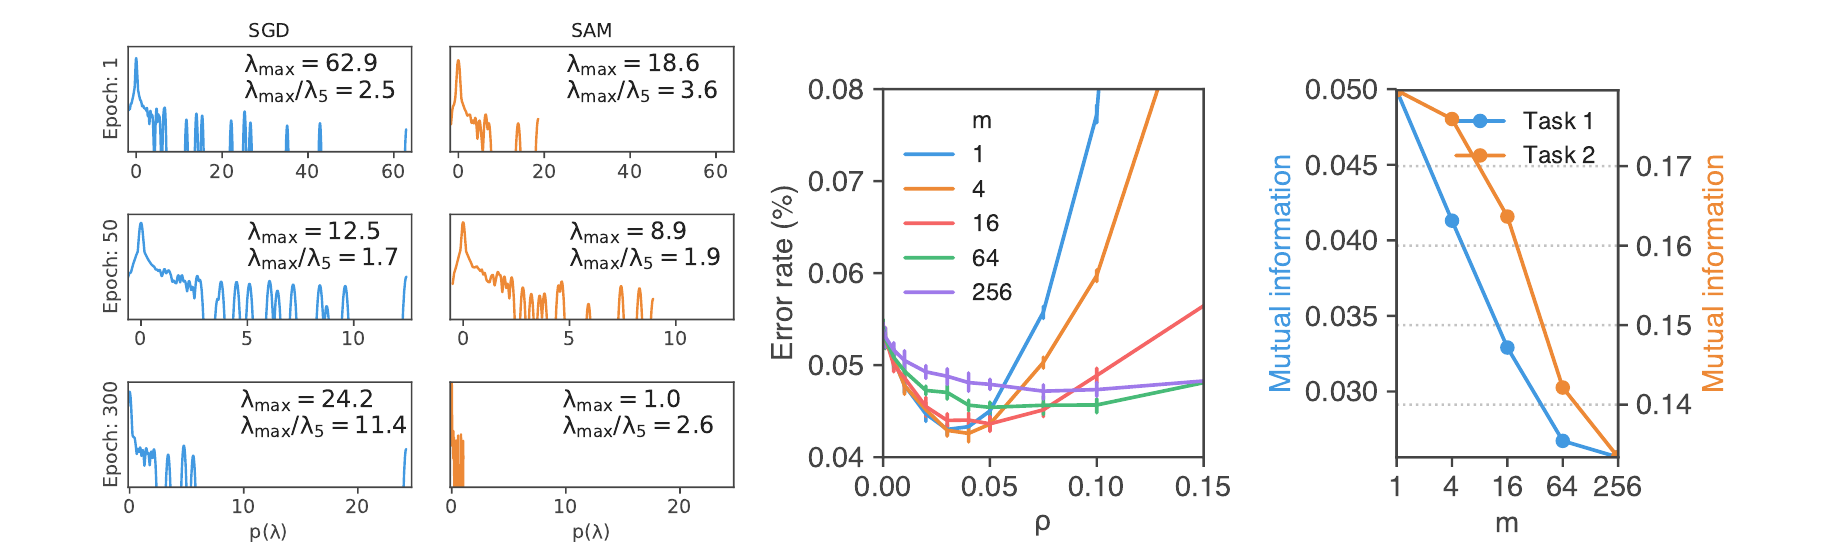
Nous avons vu que, sur plusieurs accélérateurs, chacun calcule sa propre perturbation. Cela revient à changer l'objectif en « une maximisation séparée pour chaque groupe de exemples, puis une somme », où est le nombre d'exemples par accélérateur ; les auteurs appellent cette acuité la m-sharpness.
Commençons par le graphique du centre. Bien que l'axe vertical soit marqué en %, les valeurs sont des proportions ; 0.05 correspond à 5 %. Avec , l'erreur est d'environ 5.3 %. Pour et , le minimum est d'environ 4.3 %, mais il se dégrade vite dès que dépasse 0.05 ; la courbe violette de est la plus plate, mais ne descend qu'à environ 4.7 %. Les petits marchent mieux, ce qui tombe bien pour le parallélisme sur plusieurs accélérateurs. Le graphique de droite montre que, plus est petit, mieux la m-sharpness prédit l'écart de généralisation réel. Les auteurs en déduisent que la m-sharpness pourrait mieux décrire la généralisation que l'acuité mesurée sur tout le jeu d'entraînement.
Les six petits graphiques de gauche confirment que SAM s'arrête bien dans une région de plus faible courbure. Il s'agit d'un WideResNet-40-10 sans BN, dont la distribution des valeurs propres de la hessienne est estimée par la méthode de Lanczos ; en fin d'entraînement, la plus grande valeur propre est d'environ 24 pour SGD et d'environ 1.0 pour SAM, et , qui décrit la forme globale de la distribution, passe de 11.4 à 2.6.
Cette section a une conséquence pratique. Dans le DistributedDataParallel de PyTorch, backward() moyenne automatiquement les gradients de tous les GPU ; si la première rétropropagation est synchronisée comme d'habitude, est calculé sur le lot entier, et grandit d'un coup. davda54/sam recommande de placer la première rétropropagation dans model.no_sync(), pour que chaque GPU garde sa propre perturbation.
Ce qu'on a compris de SAM ensuite
L'acuité elle-même pose problème
Trois ans avant SAM, Dinh et al. avaient déjà montré que la notion de « platitude » tient mal debout pour les réseaux profonds. ReLU vérifie ; si l'on multiplie les poids d'une couche par et qu'on divise ceux de la suivante par , le réseau calcule exactement la même fonction, mais la forme du paysage de perte dans l'espace des paramètres est étirée. Ils le démontrent d'abord sur un réseau à une couche cachée, puis le généralisent à plusieurs couches. Pour tout minimum dont la hessienne est non nulle, on peut trouver des paramètres qui calculent la même fonction avec une norme spectrale de la hessienne arbitrairement grande. Même fonction, donc même généralisation, mais une acuité réglable à volonté ; l'acuité mesurée dans les coordonnées brutes des paramètres ne peut donc pas expliquer à elle seule la généralisation.
Le de SAM a le même défaut, puisque c'est une distance absolue dans l'espace des paramètres. ASAM (Kwon et al., 2021) met l'étendue de la perturbation à l'échelle de la taille des poids, avec la contrainte , où ; cette « adaptive sharpness » est invariante par la remise à l'échelle décrite plus haut. Pour , la perturbation devient , plus grande sur les coordonnées dont les poids sont plus grands ; doit donc être environ 10 fois plus grand (0.5 sur CIFAR-10, 1.0 sur CIFAR-100). Sur ImageNet, la précision top-1 de ResNet-50 est de 75.79 % avec SGD, 76.39 % avec SAM et 76.63 % avec ASAM.
Les bornes de généralisation n'expliquent pas SAM
Andriushchenko et Flammarion (2022) réexaminent les fondements théoriques de SAM. La borne de généralisation conduit à une version qui maximise sur tout le jeu d'entraînement, qu'ils appellent n-SAM ; ce que l'article utilise en pratique, c'est m-SAM, avec une perturbation par lot. Dans leurs mesures sur CIFAR, une perturbation aléatoire ne sert presque à rien, n-SAM non plus, et seules les versions à petit (par exemple 128-SAM) améliorent nettement la généralisation. Si la borne de généralisation était la cause, n-SAM devrait être la meilleure ; c'est exactement l'inverse. Ils concluent que les bornes de généralisation existantes n'expliquent pas SAM, et qu'être « plus plat » au sens de la m-sharpness n'apporte pas forcément une meilleure généralisation.
Ils proposent aussi quelques observations utiles. Sur des réseaux linéaires diagonaux, le biais implicite de 1-SAM favorise des solutions plus parcimonieuses, plus fortement que n-SAM et que l'entraînement ordinaire ; sur CIFAR, passer de l'entraînement ordinaire à SAM seulement pour les derniers 10 % environ des époques améliore déjà nettement la généralisation, si bien qu'on peut utiliser SAM pour affiner un modèle existant.
En 2023, Andriushchenko et al. élargissent l'étude aux Transformers sur ImageNet, à l'affinage de CLIP et à BERT. L'acuité (adaptive sharpness comprise) y est mal corrélée à la généralisation, et l'est plutôt à des réglages d'entraînement comme le taux d'apprentissage ; dans plusieurs cas, plus le minimum est pointu, meilleures sont les performances sur des données hors distribution.
Très utilisé
La théorie a beau faire débat, SAM est largement utilisé en pratique. Chen et al. (2022) constatent qu'entraîné à partir de zéro sur ImageNet sans préentraînement à grande échelle et avec une simple augmentation de données, ViT converge vers des minima extrêmement pointus ; avec SAM, le top-1 de ViT-B/16 passe de 74.6 % à 79.9 %, celui de MLP-Mixer-B/16 de 66.4 % à 77.4 %. C'est aussi avec SAM que le plus grand modèle NFNet, F6, atteint 86.5 % de précision.
Conclusion
SAM transforme « tout le voisinage doit avoir une perte basse » en un objectif min-max ; une approximation du premier ordre ramène la maximisation interne à « monter de le long du gradient », puis le gradient pris en ce point sert à mettre à jour les poids d'origine. Cela coûte deux rétropropagations par étape. Sur CIFAR, ImageNet, l'affinage et les étiquettes bruitées, il l'emporte presque partout ; et dans les comparaisons sur CIFAR, la référence avait même droit à deux fois plus d'époques.
En pratique, est un bon point de départ, et il faut prévoir un budget double ; avec BN, pensez à ne pas mettre à jour les statistiques lors de la seconde passe avant, et sur plusieurs GPU, ne synchronisez pas la première rétropropagation, pour que chaque GPU perturbe de son côté. Si le budget est serré, on peut n'activer SAM qu'en fin d'entraînement, ou pendant l'affinage.
Quant à l'adage « il faut être plat pour généraliser », des articles le contestaient encore en 2023 ; SAM, lui, n'a jamais cessé d'être utilisé.