Article original
Quasi-Dense Similarity Learning for Multiple Object Tracking
- Publication
- CVPR 2021Conférence
- Premier dépôt sur arXiv
- arXiv:2006.06664
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingqdtrack2020,
  title = {{Quasi-Dense Similarity Learning for Multiple Object Tracking}},
  author = {Jiangmiao Pang and Linlu Qiu and Xia Li and Haofeng Chen and Qi Li and Trevor Darrell and Fisher Yu},
  year = {2020},
  eprint = {2006.06664},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.06664}
}
En 2020, l'association en suivi multi-objets repose surtout sur la position.
SORT utilise l'IoU, CenterTrack prédit le déplacement des points centraux, Tracktor laisse la tête de régression du détecteur pousser les boîtes vers l'image suivante. Tant que la détection est assez précise, la relation de position entre deux images consécutives est un indice très fort. Les caractéristiques d'apparence ne jouent en général qu'un rôle d'appoint, pour retrouver une cible disparue un moment, et la recherche doit en plus rester limitée au voisinage, car ces caractéristiques ne sont pas assez fiables ; élargir la zone mène facilement à des confusions.
Pourtant, quand un humain suit un objet, l'apparence lui suffit souvent. Jiangmiao Pang, de l'université du Zhejiang, Fisher Yu, de l'ETH Zürich, Trevor Darrell, de l'UC Berkeley, et leurs collègues estiment que si les caractéristiques d'apparence ne sont pas fiables, c'est que leur entraînement gaspille trop.
Définir le problème
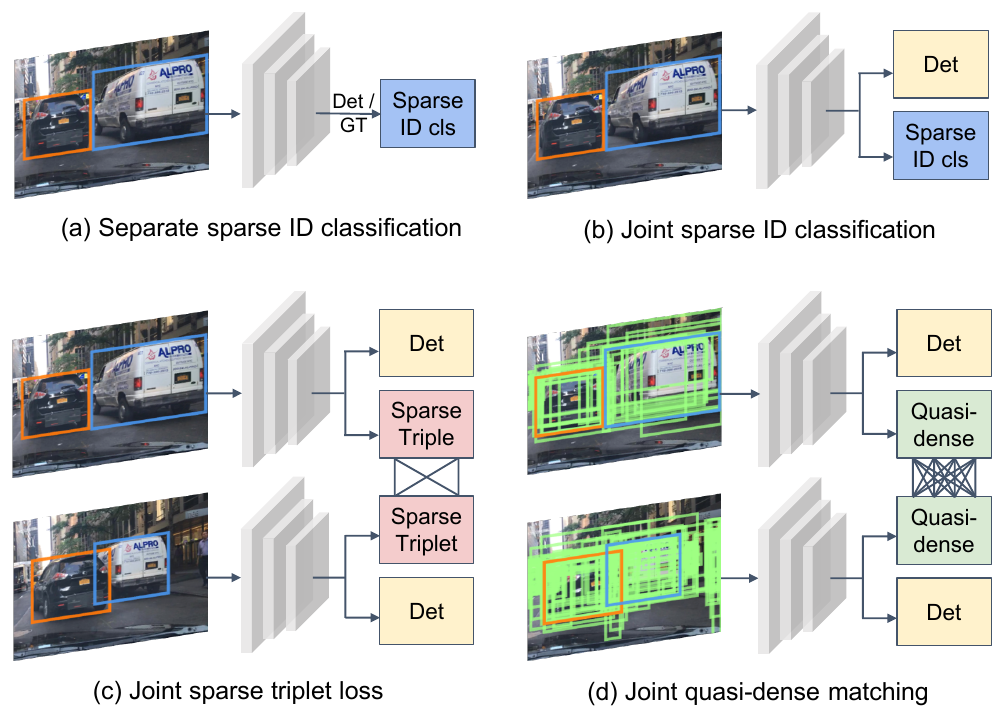
Les méthodes d'apprentissage des caractéristiques d'apparence de l'époque se répartissent à peu près ainsi :
- Classification d'identité : chaque identité du jeu d'entraînement est traitée comme une classe ; c'est le cas du modèle de re-ID de DeepSORT, et des branches d'embedding que JDE et FairMOT ajoutent au détecteur. Plus le jeu de données est grand, plus il y a de classes, et plus il est difficile de passer à l'échelle.
- Triplet loss : chaque exemple n'est comparé qu'à un exemple positif et à un exemple négatif.
Dans les deux cas, les seuls exemples d'entraînement sont les boîtes réelles, parfois à peine une quinzaine par image.
Or le détecteur propose plusieurs centaines de régions candidates sur chaque image. Celles qui sont proches d'une boîte réelle peuvent servir d'exemples positifs supplémentaires ; celles qui tombent sur l'arrière-plan sont des négatifs difficiles tout trouvés. Ces régions ne servaient jusque-là qu'à entraîner la détection, et étaient toutes jetées pour l'apprentissage de l'apparence.
Les auteurs veulent utiliser toutes ces régions candidates pour apprendre l'apparence. Si l'espace de caractéristiques est assez bien appris, l'association n'a plus besoin de position, de mouvement ni de prédiction de déplacement ; il suffit de chercher le plus proche voisin dans l'espace de caractéristiques.
Résoudre le problème
Échantillonnage quasi dense
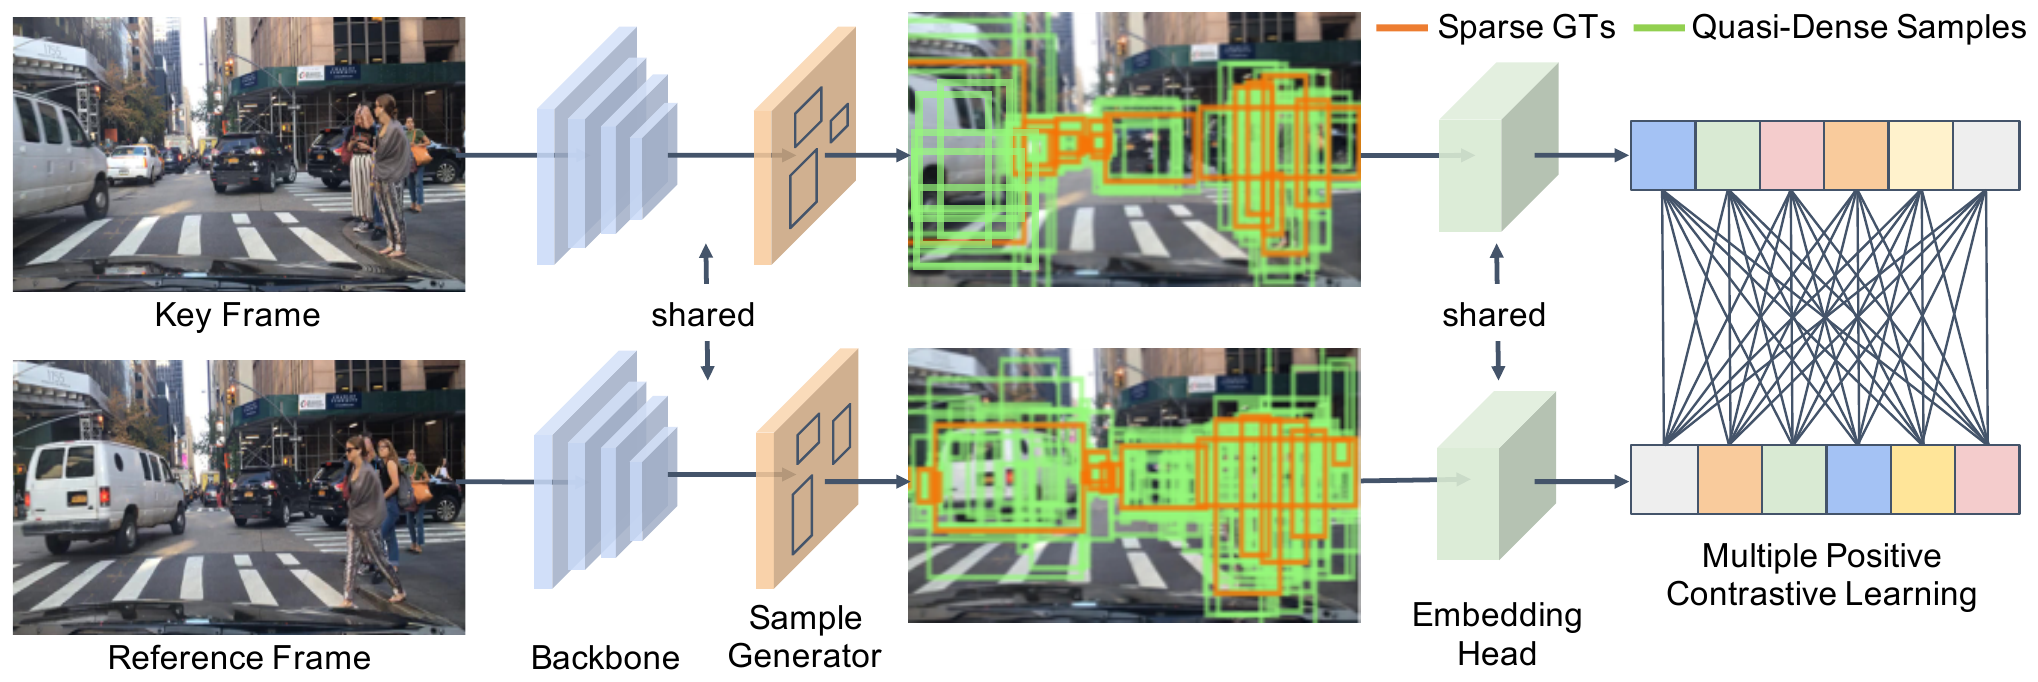
Les auteurs définissent l'« appariement dense » comme la comparaison de boîtes candidates à toutes les positions de pixel ; le « quasi dense » ne prend que les régions informatives susceptibles de contenir un objet, c'est-à-dire les boîtes candidates proposées par le RPN.
Le détecteur est un Faster R-CNN standard avec FPN et un backbone ResNet-50. À côté des têtes d'origine de classification et de régression des boîtes, on ajoute en parallèle une tête d'embedding légère (4 couches de convolution et 1 couche entièrement connectée), qui produit une caractéristique de 256 dimensions pour chaque boîte candidate.
À l'entraînement, on prend chaque fois une image clé, puis on tire au hasard une image de référence parmi les 3 images qui la précèdent ou la suivent. Le RPN tourne sur chacune des deux images et produit des boîtes candidates :
- Une boîte candidate dont l'IoU avec un objet réel dépasse 0.7 compte comme un exemple de cet objet ; en dessous de 0.3, elle compte comme arrière-plan.
- Une boîte candidate de l'image clé et une boîte candidate de l'image de référence forment une paire positive si elles appartiennent au même objet, et une paire négative sinon.
On prend 128 boîtes candidates de l'image clé comme exemples d'entraînement, et 256 de l'image de référence comme cibles contrastives, moitié positives, moitié négatives. Chaque exemple d'entraînement est comparé aux 256 cibles de l'image de référence.
Une perte contrastive à positifs multiples
Avec un seul exemple positif, on peut utiliser l'entropie croisée softmax standard. Soit la caractéristique de l'exemple d'entraînement, l'exemple positif et les exemples négatifs :
Mais avec l'échantillonnage quasi dense, un exemple d'entraînement a plusieurs positifs dans l'image de référence, puisque toutes les boîtes candidates proches d'un même objet comptent. Additionner simplement les positifs au numérateur ferait compter chaque négatif plusieurs fois, et chaque positif une seule fois.
Les auteurs commencent par réécrire la formule ci-dessus sous la forme
puis accumulent aussi les positifs :
Chaque couple positif-négatif est ainsi comparé équitablement, une seule fois.
On ajoute en plus une perte L2 auxiliaire, qui contraint la similarité cosinus des caractéristiques :
Pour les paires positives, ; pour les paires négatives, . Les auteurs précisent que cette perte sert à contraindre l'amplitude des logits et la similarité cosinus, et qu'elle n'améliore pas directement les résultats.
La perte totale s'écrit
avec et . L'annexe indique que les résultats baissent quand dépasse 0.5.
Une association fondée sur la seule apparence
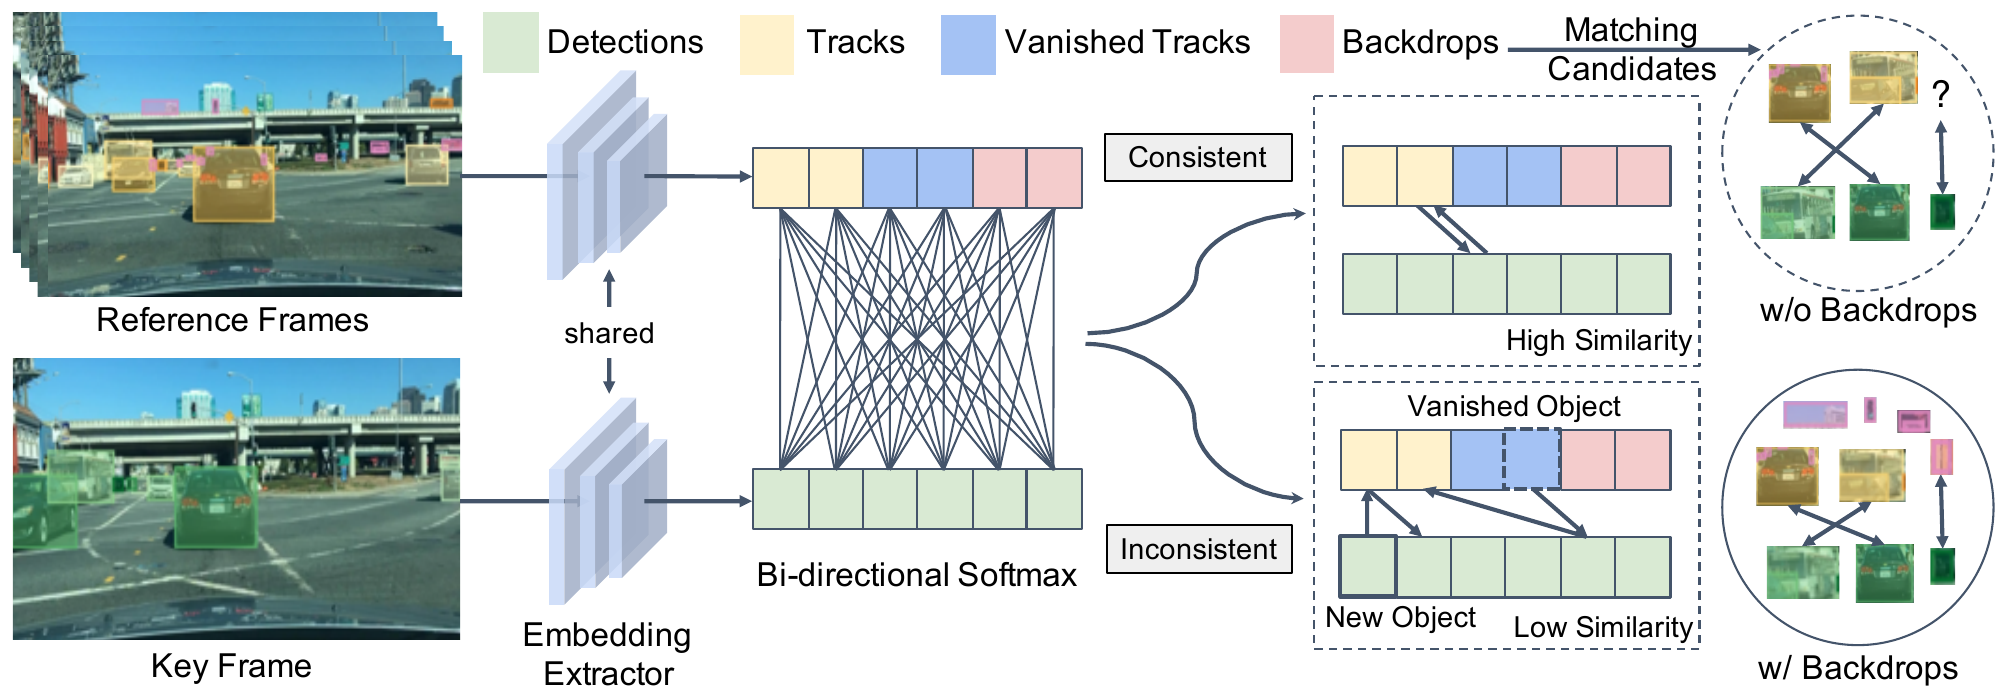
À l'inférence, l'association n'utilise pas du tout la position. Mais chercher le plus proche voisin dans l'espace de caractéristiques devient compliqué quand une détection n'a aucune trajectoire correspondante (nouvel objet, faux positif), ou quand plusieurs candidates se ressemblent toutes. Les auteurs règlent cela avec trois choix de conception.
Softmax bidirectionnel. L'image actuelle compte détections, de caractéristiques ; il y a candidates d'appariement, de caractéristiques . La similarité entre les deux est la moyenne de deux softmax, un dans chaque direction :
Le premier terme demande « parmi toutes les candidates, à laquelle la détection ressemble-t-elle le plus », le second « parmi toutes les détections, à laquelle la candidate ressemble-t-elle le plus ». Le score n'est élevé que si chacun est le plus proche voisin de l'autre. Un objet qui vient d'apparaître ne trouve pas de vrai partenaire parmi les candidates ; il est difficile que ses scores soient élevés dans les deux directions à la fois, et il ne sera naturellement pas apparié.
Conserver les boîtes d'arrière-plan (backdrops). Les méthodes antérieures jetaient directement les détections qui n'étaient appariées à aucune trajectoire. Les auteurs estiment que ces boîtes sont certes surtout des faux positifs, mais que le faux positif de l'image suivante a de bonnes chances de leur ressembler. En les conservant une image comme candidates d'appariement, le faux positif de l'image suivante s'apparie à ces boîtes d'arrière-plan, au lieu d'être imposé à une vraie trajectoire.
Dédoublonnage interclasses. Un détecteur ordinaire ne fait de suppression des non-maxima qu'à l'intérieur d'une même classe ; à une même position, on peut donc trouver à la fois une boîte « piéton » et une boîte « cycliste », chacune avec une caractéristique presque identique. Avant l'association, les auteurs font une suppression des non-maxima supplémentaire entre classes, avec un seuil de 0.7 pour les boîtes de haute confiance et de 0.3 pour celles de faible confiance.
Le reste, ce sont des seuils courants. Seules les détections de confiance supérieure à 0.8 ouvrent une nouvelle trajectoire, les trajectoires disparues sont conservées 10 images, les caractéristiques des trajectoires sont mises à jour avec un momentum de 0.8, et seuls les objets de même classe peuvent être appariés entre eux.
Discussion
Ce qui sert vraiment
| Entraînement | Similarité | Dédoubl. | Backdrops | MOTA | IDF1 | MOTA piét. | IDF1 piét. |
|---|---|---|---|---|---|---|---|
| Clairsemé | cosine | 60.4 | 63.0 | 37.6 | 49.7 | ||
| Quasi dense, 1 positif | cosine | 61.5 | 66.8 | 40.5 | 52.7 | ||
| Quasi dense, multi-positifs | cosine | 62.5 | 67.8 | 44.0 | 54.3 | ||
| Quasi dense, multi-positifs | bi-softmax | 62.9 | 70.0 | 45.5 | 58.8 | ||
| Quasi dense, multi-positifs | bi-softmax | ✓ | 63.2 | 70.1 | 45.5 | 58.3 | |
| Quasi dense, multi-positifs | bi-softmax | ✓ | ✓ | 63.5 | 71.5 | 46.7 | 60.2 |
D'après la Table 4 de l'article, sur le jeu de validation de suivi de BDD100K.
Les ablations portent sur le jeu de validation de BDD100K. C'est un jeu de données de caméras embarquées à 8 classes, bien plus grand que MOT17.
En passant du clairsemé au quasi dense, l'IDF1 monte de 63.0 à 67.8. À elle seule, l'augmentation du nombre de négatifs, avec une perte toujours à positif unique, en apporte 3.8 points, soit environ 80 % de ce gain. Plus il y a de cibles contrastives, même si la plupart sont négatives, mieux les caractéristiques sont apprises. La perte à positifs multiples ajoute 1 point.
Côté inférence, le softmax bidirectionnel fait encore gagner 2.2 points d'IDF1, et 4.5 points pour la classe piéton. Le dédoublonnage et les boîtes d'arrière-plan ajoutent 1.5 point. Du début à la fin, l'IDF1 gagne 8.5 points au total, et les changements d'identité baissent de 30 %. C'est la classe piéton qui progresse le plus nettement, avec respectivement 9.1 et 10.5 points de plus en MOTA et en IDF1.
La position sert-elle encore ?
| Apparence | IoU | Mouv. | Régr. | mMOTA | mIDF1 |
|---|---|---|---|---|---|
| ✓ | 26.3 | 36.0 | |||
| ✓ | ✓ | 27.7 | 38.5 | ||
| ✓ | ✓ | 28.6 | 39.3 | ||
| ✓ | 36.6 | 50.8 | |||
| ✓ | ✓ | 36.3 | 49.8 | ||
| ✓ | ✓ | ✓ | 36.4 | 49.9 | |
| ✓ | ✓ | ✓ | 36.4 | 50.1 |
D'après la Table 5 de l'article, sur le jeu de validation de suivi de BDD100K ; mMOTA et mIDF1 sont les moyennes sur les 8 classes.
Les auteurs suivent la démarche de Tracktor et ajoutent au même détecteur des indices de position, l'IoU, un modèle de mouvement ou la régression des boîtes.
Sans caractéristiques d'apparence, chaque indice de position supplémentaire améliore les résultats. Mais avec les caractéristiques d'apparence apprises de façon quasi dense, ajouter le moindre indice de position n'aide plus, et fait même légèrement baisser les scores. Le meilleur résultat s'obtient avec l'apparence seule.
Des caractéristiques d'apparence assez bien apprises rendent les indices de position inutiles ; c'est la thèse centrale de l'article. Il s'agit toutefois d'un résultat sur BDD100K. Ses annotations de suivi sont à 5 images par seconde, et la caméra est montée sur un véhicule en mouvement ; entre deux images annotées consécutives, la position et la taille des objets peuvent beaucoup changer, et les indices de position y sont d'emblée moins fiables.
Les différents benchmarks
QDTrack rapporte des résultats sur quatre benchmarks, sans autres données d'entraînement que le préentraînement sur COCO.
- MOT17 (détections privées) : MOTA 68.7, IDF1 66.3, à 20.3 images par seconde. C'est 0.9 et 1.6 point de plus que CenterTrack à l'époque, alors que CenterTrack utilisait des données supplémentaires. Ses 3 378 changements d'identité dépassent les 3 039 de CenterTrack ; selon les auteurs, son rappel est plus élevé, avec 14 000 FN de moins, et plus on suit de trajectoires, plus les occasions de changer d'ID se multiplient.
- BDD100K : sur le jeu de test, mMOTA de 35.5 et mIDF1 de 52.3, soit 9.2 et 7.6 points au-dessus de la référence officielle ; la méthode bat aussi le vainqueur du challenge de suivi BDD100K 2020.
- Waymo : sur le jeu de validation, un MOTA de 55.6 pour la classe véhicule, 10.7 points au-dessus de RetinaTrack. Avec ResNet-101 et des convolutions déformables, les résultats sur le jeu de test sont comparables à ceux du vainqueur du challenge de suivi 2D Waymo 2020, alors qu'il ne s'agit que d'un modèle unique.
- TAO : ce jeu de données compte plusieurs centaines de classes, avec une distribution à longue traîne très marquée. L'AP50 globale ne dépasse la référence que de 2 à 3 points, mais pour la classe fréquente piéton, on a 38.6 contre 18.5.
Le goulot d'étranglement, c'est la détection
Deux expériences oracle de l'annexe sont très instructives.
En remplaçant les détections par les boîtes réelles, puis en les associant avec les caractéristiques de QDTrack, l'IDF1 moyen sur les 8 classes atteint 88.8, 38 points de plus qu'à l'origine. À l'inverse, en gardant les détections telles quelles et en les associant avec les vraies étiquettes de suivi, le mIDF1 ne gagne que 4.3 points.
Autrement dit, sur BDD100K, l'association de QDTrack est déjà très proche de son plafond, et l'essentiel de l'erreur vient de la détection. Les cas d'échec le confirment. Les objets manqués sont surtout très petits ou coincés dans la foule, et les faux positifs sont des personnes vues dans un miroir ou sur un panneau publicitaire. Il y a aussi les sauts de classe ; quand le vélo est masqué, par exemple, un « cycliste » est détecté comme « piéton », et comme QDTrack n'autorise que les appariements au sein d'une même classe, l'ID se rompt.
La suite
La conclusion selon laquelle « l'apparence seule suffit » a ensuite été réexaminée sur MOT17. Sur la moitié de validation de MOT17, ByteTrack ajoute aux similarités de re-ID de QDTrack les indices de mouvement d'un filtre de Kalman, puis y applique sa propre association BYTE. Le MOTA passe de 67.3 à 67.7, l'IDF1 de 67.8 à 72.0, et les changements d'identité de 377 à 281. Dans les images de vidéosurveillance, les piétons marchent lentement et régulièrement, et les indices de mouvement y restent très utiles.
DanceTrack est l'extrême opposé. Les danseurs y portent des tenues semblables, et leur apparence est difficile à distinguer ; dans leurs propres expériences d'association, les auteurs de DanceTrack constatent aussi qu'ajouter directement une comparaison d'apparence dégrade les résultats. Mais dans ce même article, QDTrack, réentraîné avec un détecteur YOLOX, obtient un HOTA de 54.2, au-dessus des 47.7 de ByteTrack, avec aussi une précision d'association AssA de 36.8 contre 32.1. Les caractéristiques apprises de façon quasi dense parviennent encore à distinguer quelques différences dans des scènes où les apparences sont presque identiques.
Conclusion
Ce que QDTrack change, c'est la façon d'échantillonner pour apprendre les caractéristiques d'apparence. Au lieu d'une quinzaine de boîtes réelles, il compare entre elles plusieurs centaines de boîtes candidates, avec une perte contrastive qui traite équitablement les positifs multiples.
À l'inférence, il ne reste que l'apparence, avec quelques règles simples, le softmax bidirectionnel, des boîtes d'arrière-plan gardées une image et un dédoublonnage interclasses. Pas de filtre de Kalman, pas d'IoU ; sur BDD100K, ajouter des indices de position dégrade même légèrement les résultats.
L'astuce des boîtes d'arrière-plan est particulièrement intéressante. La plupart des traqueurs cherchent à se débarrasser des faux positifs ; QDTrack, lui, les garde, pour que les faux positifs de l'image suivante aient un endroit où aller.