Article original
Tracking Objects as Points
- Publication
- ECCV 2020Conférence
- Premier dépôt sur arXiv
- arXiv:2004.01177
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingcentertrack2020,
  title = {{Tracking Objects as Points}},
  author = {Xingyi Zhou and Vladlen Koltun and Philipp Krähenbühl},
  year = {2020},
  eprint = {2004.01177},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01177}
}
Début avril 2020, deux articles de suivi fondés sur CenterNet paraissent sur arXiv à deux jours d'intervalle.
Le premier est FairMOT, qui ajoute à CenterNet une branche de re-ID pour que le détecteur produise au passage des caractéristiques d'apparence, ensuite confiées à un appariement à la DeepSORT. Le second, c'est ce CenterTrack, dont le premier auteur, Xingyi Zhou, est justement l'auteur de CenterNet ; ses coauteurs sont Philipp Krähenbühl, qui encadre ses travaux à l'université du Texas à Austin, et Vladlen Koltun, d'Intel Labs. Ils prennent une autre direction ; pas d'apprentissage d'apparence, le détecteur regarde directement deux images et indique au passage d'où vient chaque objet.
Le même détecteur, deux transformations radicalement différentes.
Définir le problème
Aux débuts de la vision par ordinateur, suivre voulait dire suivre des points d'intérêt dans l'image, des coins par exemple, pour voir où ils se déplaçaient dans l'image suivante. La méthode était simple et rapide, mais échouait là où il n'y avait ni coin marqué ni pic de luminosité.
Quand les détecteurs profonds sont devenus performants, le tracking-by-detection s'est imposé : on détecte dans chaque image, puis on relie les boîtes. Les auteurs voient deux inconvénients à cette chaîne. Premièrement, les meilleurs traqueurs dépendent souvent de stratégies d'association lentes et complexes ; ceux qui utilisent l'apparence doivent en plus faire tourner un coûteux réseau de caractéristiques. Deuxièmement, détection et suivi sont séparés ; quand le détecteur cherche les objets de l'image , il ignore tout de ce qui s'est passé à l'image .
Tracktor a déjà réuni détection et suivi, mais il confie les boîtes de l'image précédente à la régression de Faster R-CNN comme boîtes candidates, ce qui suppose que les boîtes d'un objet se recouvrent encore assez d'une image à l'autre. Dans les vidéos à faible fréquence d'images, cette hypothèse ne tient plus, et Tracktor doit ajouter un modèle de mouvement.
Si l'on représente un objet par un point, tout devient beaucoup plus simple. Le point de départ de CenterTrack, c'est de suivre dans le temps le point central de chaque objet, dans l'esprit des premiers travaux qui « suivaient des points », à ceci près que ce point est trouvé par un détecteur.
Les auteurs fixent aussi très tôt les limites de leur méthode. CenterTrack ne fait que du suivi local, en associant uniquement les objets de deux images consécutives ; un objet qui sort de l'image, ou qui réapparaît après avoir été masqué, reçoit un nouvel ID. La capacité à raccorder des objets sur de longues durées est sacrifiée au profit de la simplicité, de la vitesse et de la précision locale.
Résoudre le problème
Petit rappel sur CenterNet
CenterNet est un détecteur qui représente les objets par des points. À partir d'une image, il produit une carte de chaleur réduite d'un facteur 4, avec un canal par classe ; chaque maximum local de la carte de chaleur (le point le plus fort dans son voisinage ) est le centre d'un objet, et la hauteur du pic est son score de confiance. Deux autres branches de sortie lisent, à la même position, la largeur et la hauteur de la boîte, ainsi qu'un décalage local qui compense l'erreur d'arrondi.
À l'entraînement, le centre de chaque objet est dessiné comme un pic gaussien, dont la largeur s'adapte à la taille de l'objet ; la perte est une focal loss, avec et . La taille de la boîte et le décalage local ne sont supervisés qu'au point central, avec une perte L1.
Ce que CenterTrack regarde en plus
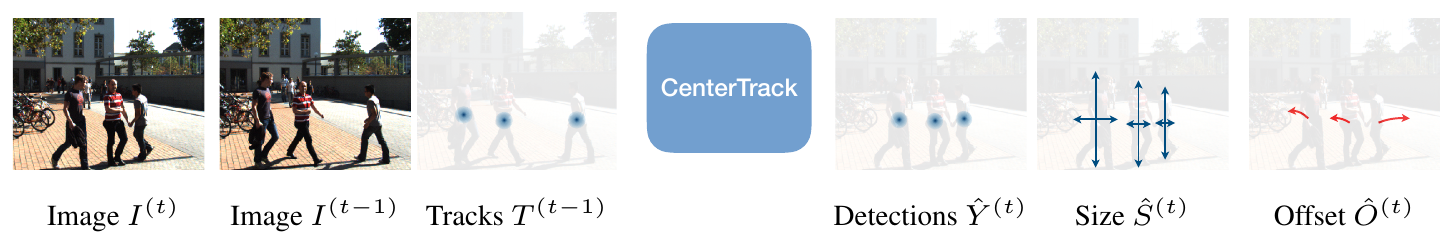
Le réseau de CenterTrack est presque identique à celui de CenterNet ; il n'a que quatre canaux d'entrée et deux canaux de sortie de plus.
Les entrées supplémentaires : l'image précédente , sur trois canaux ; les centres des objets suivis à l'image précédente, dessinés sur une carte de chaleur sans distinction de classe, sur un canal. Pour éviter que les faux positifs ne se propagent indéfiniment, seuls les objets dont le score de confiance dépasse un seuil sont dessinés sur cette carte.
En voyant l'image précédente, le réseau peut estimer comment la scène a changé ; en voyant où se trouvaient les objets de l'image précédente, il a plus de chances de retrouver une personne à moitié masquée dans l'image actuelle.
La sortie supplémentaire : une carte de déplacements à deux canaux, . À chaque centre détecté , le vecteur à deux dimensions qu'on y lit représente le déplacement de cet objet entre l'image précédente et l'image actuelle :
L'entraînement se fait comme pour la taille des boîtes ; aux points centraux réels, une perte L1 fait régresser le déplacement réel.
Suivre une voiture le temps d'une image
Une fois le déplacement prédit, l'association n'a presque plus rien à faire. Déroulons un exemple.
Supposons deux trajectoires à l'image précédente ; le centre de A est à sur la carte de caractéristiques, celui de B à . Dans l'image actuelle, le réseau détecte un centre avec un score de confiance de 0.9, et le déplacement lu à cette position est .
En remontant le déplacement, cet objet devait se trouver, à l'image précédente, en
La distance à A est d'environ 0.5, celle à B d'environ 29.6. Tant que A n'a pas déjà été pris par une autre détection et que la distance reste dans un rayon , cette détection est rattachée à A et reprend l'ID de A. est la moyenne géométrique de la largeur et de la hauteur de la boîte prédite ; un grand objet a donc droit à une erreur un peu plus grande.
Toutes les détections passent par cet appariement glouton, par score de confiance décroissant. Si aucun objet de l'image précédente ne se trouve dans le rayon, on ouvre une nouvelle trajectoire.
Ni filtre de Kalman, ni distance d'apparence, ni algorithme hongrois.
Par rapport à Tracktor, la différence tient au fait que les objets de l'image précédente entrent dans le réseau sous forme de carte de chaleur, et non comme boîtes candidates. Le réseau raisonne sur la correspondance entre les objets des deux images dans tout son champ récepteur ; même si les boîtes des deux images ne se chevauchent pas du tout, il peut les relier.
La clé de l'entraînement : l'empêcher de recopier la réponse
Cela paraît simple, mais les auteurs insistent sur l'importance des détails.
Les objets de deux images consécutives sont presque identiques. Si, à l'entraînement, on dessine la carte de chaleur précédente directement à partir des annotations réelles, le réseau découvre très vite qu'il suffit de recopier la carte d'entrée en sortie pour obtenir une perte faible. Ce qu'il apprend alors, ce n'est pas le suivi, mais la copie.
Or, à l'inférence, vient des prédictions du réseau lui-même à l'image précédente, avec des objets oubliés, des objets mal placés, et aussi des faux positifs. Les auteurs simulent délibérément ces trois erreurs à l'entraînement :
- Position bruitée. On ajoute à chaque centre de l'image précédente un bruit gaussien, d'amplitude égale à fois la largeur et la hauteur de la boîte.
- Faux pics. Avec une probabilité , on dessine un pic de bruit supplémentaire près d'un objet réel.
- Pics manquants. Avec une probabilité , on retire certains objets au hasard.
Sur MOT17, et ; en moyenne, quatre objets sur dix sont donc délibérément retirés de la carte de chaleur précédente. Par ailleurs, l'« image précédente » n'est pas forcément la vraie image précédente ; elle est tirée au hasard parmi les images situées au plus à deux images avant ou après (), pour éviter que le réseau ne s'adapte trop à une fréquence d'images particulière.
Cette augmentation de données est si forte que CenterTrack peut s'entraîner sans aucune vidéo. On prend une image fixe, on lui applique un zoom et une translation aléatoires pour en faire « l'image précédente », on simule les déplacements à partir des annotations de détection d'origine, et l'on obtient un traqueur entraîné.
Autres détails
- Suivi 3D. En passant à la version de CenterNet pour la détection 3D monoculaire, avec des têtes de sortie supplémentaires pour la profondeur, la rotation et les dimensions 3D, on obtient un suivi 3D monoculaire.
- Renaissance des trajectoires (track rebirth). Les trajectoires sans appariement sont gardées images ; pendant ce temps, elles peuvent encore être réappariées et retrouver leur ID d'origine, mais elles ne sont ni dessinées sur la carte de chaleur, ni renvoyées en sortie. Seul le jeu de test de MOT17 l'utilise, avec ; toutes les autres expériences utilisent .
Discussion
Les auteurs évaluent la méthode sur trois jeux de données :
- MOT17 : suivi de piétons dans des scènes encombrées, entre 25 et 30 FPS. Il n'existe pas de jeu de validation officiel ; pour les ablations, chaque vidéo d'entraînement est coupée en deux moitiés.
- KITTI : caméra embarquée sur un véhicule, à 10 FPS, avec de grands déplacements entre images ; seules les voitures sont évaluées.
- nuScenes : suivi 3D monoculaire en conduite autonome ; les images clés évaluées ne sont qu'à 2 FPS, et les déplacements entre images sont très grands. L'indicateur principal est l'AMOTA, une moyenne pondérée du MOTA sur différents seuils de confiance.
Résultats principaux
Le classement officiel de MOT17 n'est ouvert qu'en public detection. Comme CenterTrack fait par défaut ses propres détections, les auteurs construisent une version public selon les règles de Tracktor ; elle garde les boîtes proches des boîtes suivies à l'image précédente, et les nouvelles trajectoires ne peuvent s'ouvrir qu'à proximité des détections publiques.
Dans cette configuration, le MOTA atteint 61.5, 5 points de plus que la meilleure méthode publiée à l'époque, Tracktor v2 (56.5), et les FN passent de 235449 à 200672. Les auteurs y voient deux raisons : la carte de chaleur précédente fait que les objets déjà suivis sont moins souvent manqués, et les déplacements appris rendent l'association plus stable. L'IDF1 est de 59.6, sous les 62.3 de la méthode hors ligne LSST17, mais au-dessus des autres méthodes en ligne.
La version private obtient un MOTA de 67.8 et un IDF1 de 64.7, en 57 millisecondes par image, détection comprise.
Sur KITTI, le MOTA est de 89.44, plus de 4 points au-dessus du suivant au classement, MASS (85.04). Sur le jeu de test de nuScenes, l'[email protected] est de 27.8, contre 6.9 pour la référence monoculaire officielle.
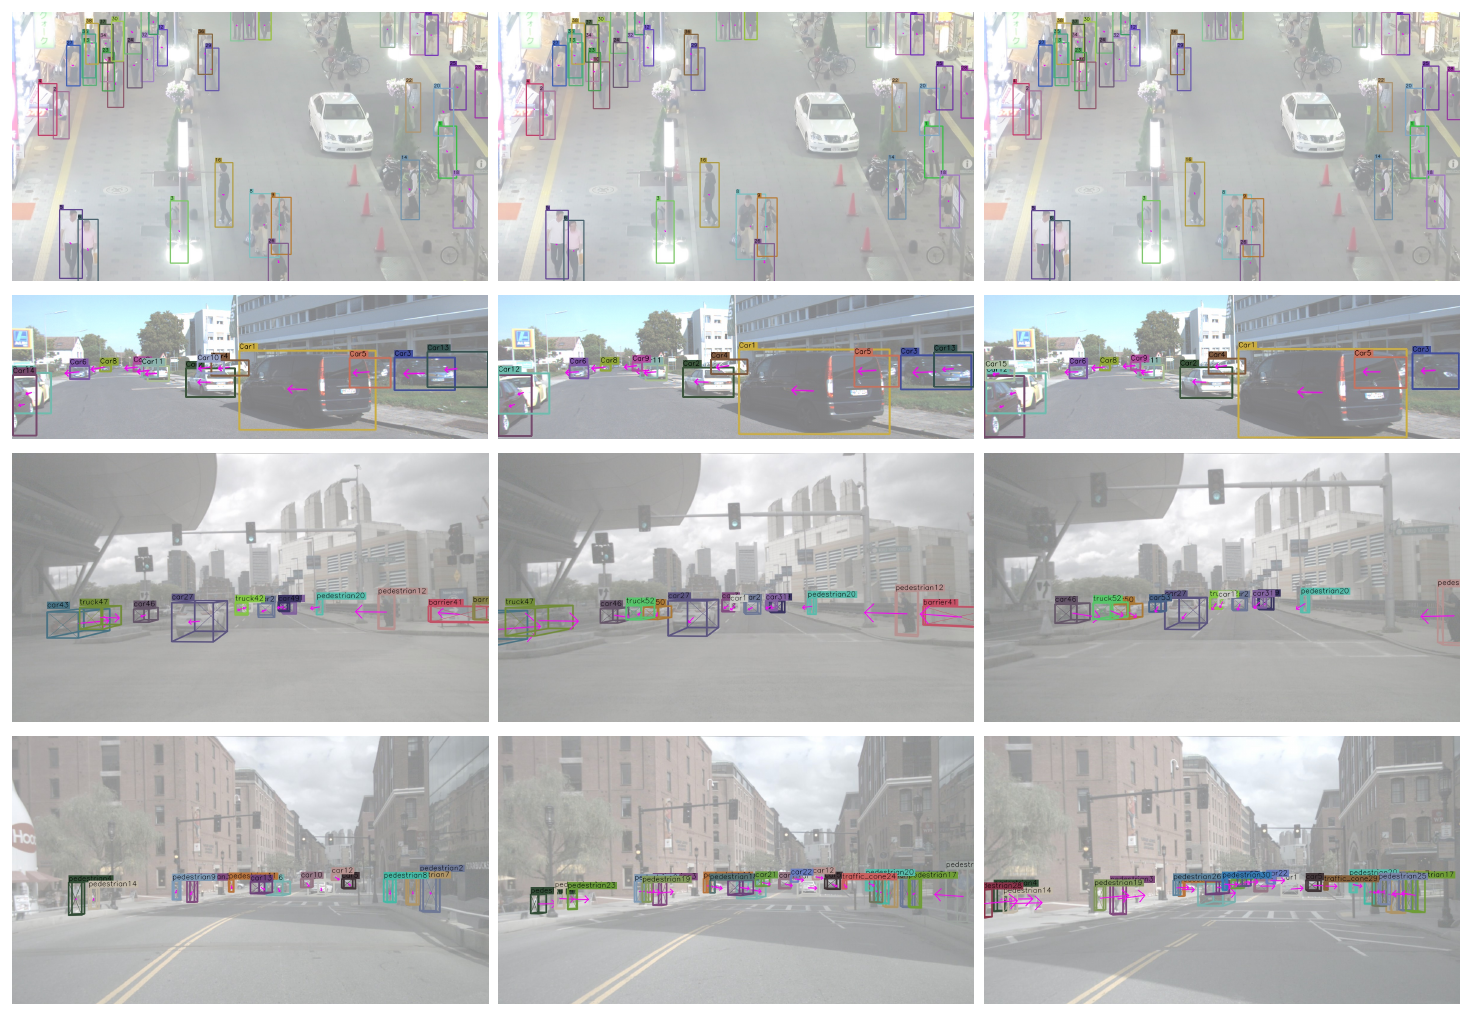
Le même réseau, entraîné sur un autre jeu de données, traite piétons, véhicules et objets 3D monoculaires.
La contribution de chacune des deux idées
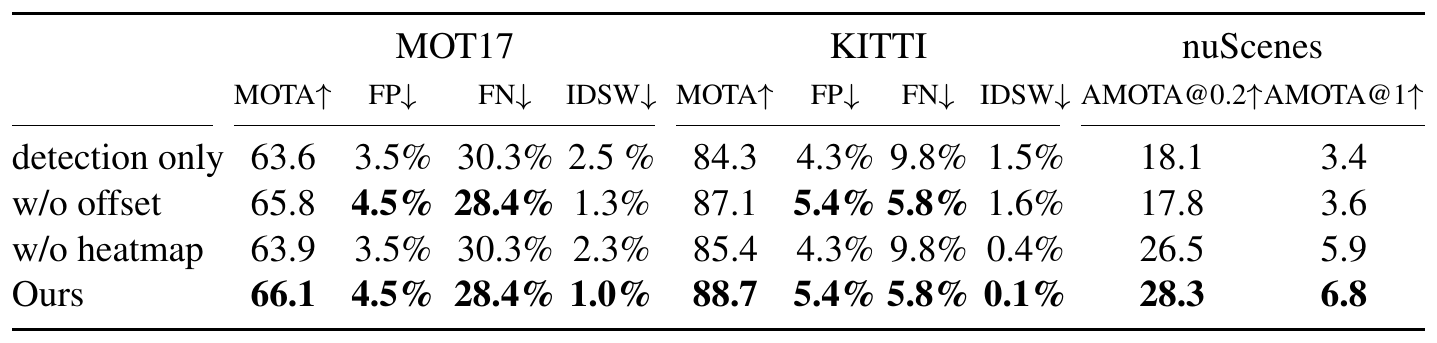
Ce tableau compare quatre configurations :
- detection only : CenterNet tourne indépendamment sur chaque image, et l'association se fait par distance entre points centraux.
- w/o offset : la carte de chaleur précédente est fournie, mais le déplacement est fixé à zéro ; on cherche simplement l'objet le plus proche de l'image précédente.
- w/o heatmap : le déplacement est prédit, mais la carte de chaleur précédente n'est pas fournie.
- Ours : les deux à la fois.
Voyons d'abord l'effet de la carte de chaleur. En comparant detection only et w/o offset, ou w/o heatmap et Ours, l'ajout de la carte de chaleur fait gagner environ 2 points de MOTA sur MOT17, et environ 3 sur KITTI. Les FN baissent, les FP augmentent. Avec l'indice de l'image précédente, le réseau tend à trouver davantage d'objets près des anciens pics ; parfois il retrouve une personne masquée, parfois il se laisse induire en erreur. Au total, l'échange reste avantageux.
Voyons ensuite l'effet du déplacement. Sur MOT17 et KITTI, à fréquence d'images élevée, le MOTA est à peu près le même avec ou sans déplacement, mais les changements d'identité diminuent nettement (de 1.3 % à 1.0 % sur MOT17, de 1.6 % à 0.1 % sur KITTI). Sur nuScenes, à 2 FPS, l'écart se creuse ; sans déplacement, w/o offset n'obtient que 17.8, contre 28.3 pour le modèle complet. Plus la fréquence d'images est basse, plus les objets bougent entre deux images, et moins « chercher le plus proche » est fiable.
Bruit, images fixes, algorithme d'appariement et renaissance
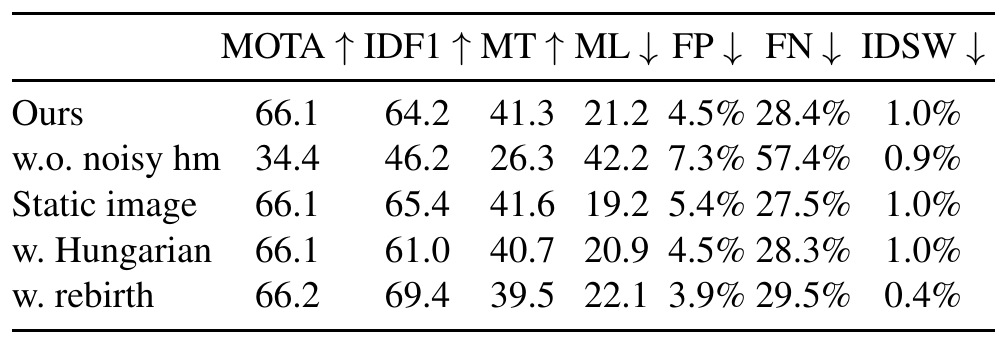
- Sans bruit, le modèle ne marche plus. Si l'on ne simule pas les erreurs de carte de chaleur à l'entraînement, le MOTA tombe de 66.1 à 34.4, et les FN bondissent de 28.4 % à 57.4 %. Les auteurs avancent une raison : à la première image, la carte de chaleur d'entrée est vide, et ce modèle, qui n'a appris qu'à chercher les gens indiqués par la carte, a du mal à découvrir seul les nouveaux objets qui n'y figurent pas.
- Les images fixes suffisent. Entraîné uniquement sur des images fixes, le modèle obtient le même MOTA de 66.1, avec même un IDF1 légèrement supérieur. Les auteurs signalent toutefois que, sur nuScenes, à faible fréquence d'images, l'entraînement sur images fixes donne de moins bons résultats.
- L'algorithme hongrois n'aide pas. Avec un appariement globalement optimal, le MOTA ne change pas, et l'IDF1 baisse même de 64.2 à 61.0. Les auteurs gardent donc le simple appariement glouton.
- La renaissance améliore nettement les ID. Avec une renaissance des trajectoires à , le MOTA ne bouge presque pas, l'IDF1 passe de 64.2 à 69.4, et les changements d'identité baissent de 1.0 % à 0.4 %. Les identités perdues par un suivi purement local pèsent en fait lourd dans une scène aux occultations fréquentes comme MOT17.
Ce que le déplacement appris fait de plus qu'un modèle de mouvement
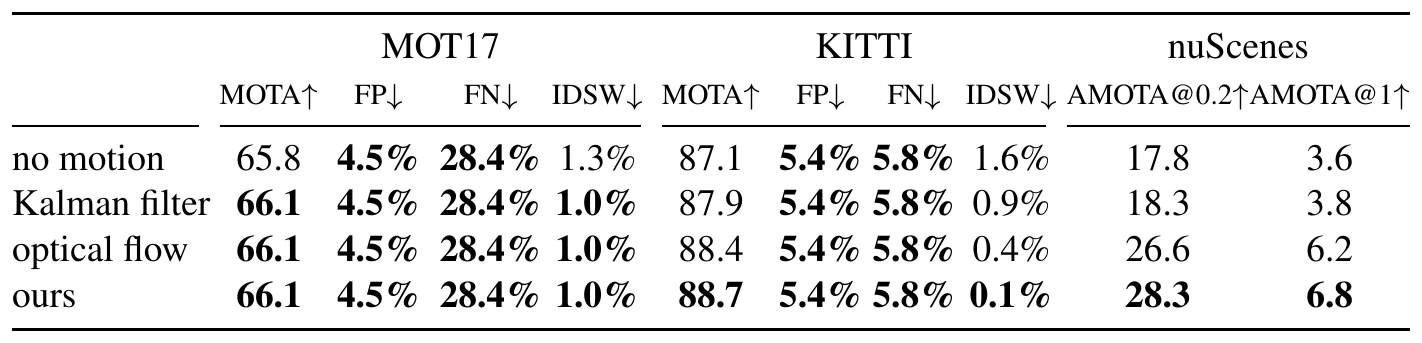
Les auteurs remplacent le déplacement appris par trois modèles de mouvement : aucun mouvement (déplacement nul), le filtre de Kalman de SORT, et le flot optique de FlowNet2 (en lisant le vecteur de flot à chaque centre prédit). Le détecteur est exactement le même.
Sur MOT17, les quatre ne se distinguent presque pas, et même l'absence de modèle de mouvement fait à peu près jeu égal. À 30 FPS, un piéton ne bouge que d'un rien à chaque image ; n'importe quelle supposition tombe juste.
Sur KITTI et nuScenes, les règles de mouvement conçues à la main du filtre de Kalman deviennent nettement insuffisantes ; sur nuScenes, il n'obtient que 18.3, presque autant que l'absence de mouvement. Le flot optique fait bien mieux (26.6), mais reste derrière les 28.3 de CenterTrack, et FlowNet2 demande environ 150 millisecondes par paire d'images.
Selon les auteurs, le déplacement de CenterTrack ne se contente pas d'estimer le mouvement. Le réseau voit où se trouvaient les objets de l'image précédente, et l'entraînement le force sans cesse à faire juste sur des cartes de chaleur bruitées ; ce qu'il apprend, c'est donc à « aligner » le déplacement sur un objet qui existe réellement dans l'image précédente. Le déplacement réalise à la fois l'estimation du mouvement et l'association.
La suite
L'article de FairMOT reproche à CenterTrack de ne pas extraire de caractéristiques d'apparence et de n'associer que des images consécutives ; FairMOT, lui, s'appuie sur l'apparence pour associer à longue portée et gérer les occultations. Ne pas réinitialiser les trajectoires perdues sur de longues durées, c'est précisément la limite que CenterTrack s'était fixée dans son introduction, et l'expérience de renaissance ci-dessus en montre le prix : il suffit de garder les trajectoires perdues 32 images pour que l'IDF1 passe de 64.2 à 69.4. Dans la discussion des résultats sur MOT17, les auteurs mentionnent d'ailleurs que combiner ce type de traqueur local à une méthode de re-ID à longue portée est une piste qui mérite d'être explorée.
ByteTrack, ensuite, a pris CenterTrack comme l'une des références dont on peut remplacer la méthode d'association ; sur des données à faible fréquence d'images comme KITTI, des méthodes construites à partir de CenterTrack ont continué d'apparaître. Relier les détections de deux images par un déplacement est devenu une pièce standard de la voie « détection et suivi réunis ».
Conclusion
On représente les objets par des points, on fait voir au détecteur l'image précédente et une carte de chaleur des objets précédents, et on lui fait produire en plus une carte de déplacements. L'association de CenterTrack se réduit alors à « remonter en arrière et chercher le plus proche », et dépasse pourtant les méthodes publiées à l'époque sur MOT17, KITTI et nuScenes.
L'augmentation de données qui abîme délibérément la carte de chaleur à l'entraînement peut être reprise telle quelle dans vos propres projets. Sans elle, le MOTA tombe de 66 à 34 ; avec elle, même des images fixes suffisent à entraîner un traqueur.
Un an et demi plus tard, ByteTrack a repris les seules boîtes de détection de CenterTrack, y a mis sa propre association et a laissé 30 images de répit aux trajectoires perdues, et l'IDF1 a gagné près de 10 points.