Article original
DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion
- Publication
- CVPR 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2111.14690
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdancetrack2021,
  title = {{DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion}},
  author = {Peize Sun and Jinkun Cao and Yi Jiang and Zehuan Yuan and Song Bai and Kris Kitani and Ping Luo},
  year = {2021},
  eprint = {2111.14690},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2111.14690}
}
En 2021, l'approche dominante du suivi multi-objets s'est à peu près figée ; on détecte d'abord, puis on relie les boîtes d'une image à l'autre avec des caractéristiques re-ID. JDE et FairMOT ajoutent une branche d'embedding au réseau de détection, QDTrack renforce les caractéristiques d'apparence par un apprentissage contrastif quasi dense, et les méthodes à base de Transformer comme TrackFormer et MOTR s'appuient elles aussi sur l'information d'apparence portée par leurs requêtes.
Une équipe de l'Université de Hong Kong, de l'Université Carnegie Mellon et de ByteDance, avec notamment Peize Sun, Jinkun Cao, Kris Kitani et Ping Luo, remet cette tendance en question. Et si les caractéristiques d'apparence ne marchaient si bien que parce que les jeux de données s'y prêtent trop ?
Dans MOT17, les piétons sont tous habillés différemment, et leur direction comme leur vitesse de marche sont très régulières, presque en ligne droite. Sur de telles données, reconnaître les gens à leur apparence ou prédire leur position avec un modèle de mouvement linéaire réussit facilement. Mais dans une autre scène, par exemple un groupe de danseurs en uniforme identique qui changent vite de place sur scène et se croisent sans cesse, ces méthodes tiennent-elles encore ?
Détail amusant, parmi les auteurs, Peize Sun, Yi Jiang, Zehuan Yuan et Ping Luo venaient, à peine plus d'un mois plus tôt, de publier avec d'autres ByteTrack, un traqueur qui obtient des scores très élevés sur MOT17 avec seulement le mouvement et l'IoU.
Définir le problème
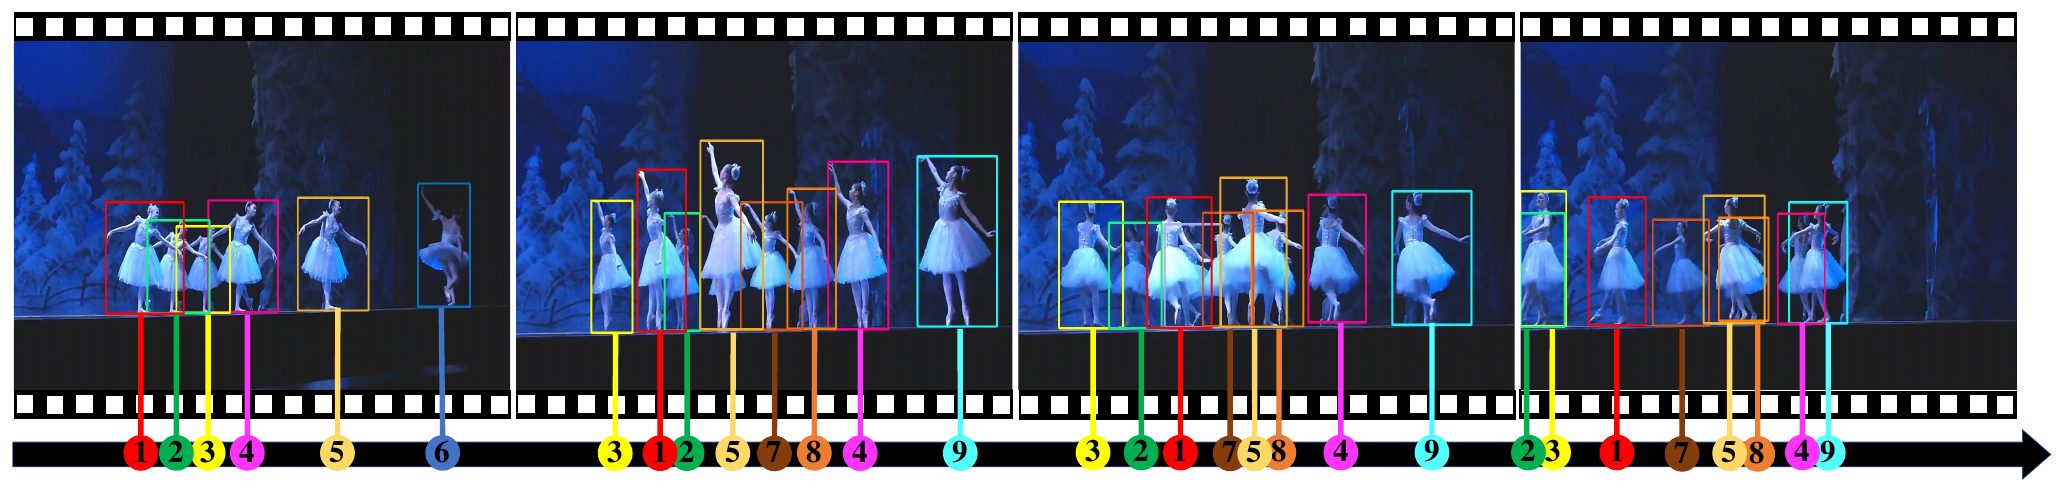
Selon les auteurs, les jeux de données existants ont deux biais :
- Une apparence trop facile à distinguer. La plupart des objets ont des apparences différentes, qu'un modèle re-ID distingue sans peine.
- Un mouvement trop régulier. Piétons et véhicules se déplacent le plus souvent presque en ligne droite à vitesse constante, et un simple modèle de mouvement linéaire suffit.
Les traqueurs développés sur ce type de données s'appuient donc de plus en plus sur la comparaison d'apparence, et les autres indices sont rarement pris au sérieux.
Un point mérite attention. Rendre les scènes plus encombrées ne règle pas ce problème. Les foules de MOT20 sont très denses, mais les piétons s'y déplacent de façon régulière, et leurs positions relatives comme les zones occultées ne changent presque pas ; ce genre d'« encombrement » ne gêne en rien la comparaison d'apparence. Les auteurs cherchent une autre difficulté, avec des objets qui se déplacent sur une grande étendue, des zones occultées qui changent sans cesse, et des objets qui se croisent et échangent leurs places.
Résoudre le problème
Collecte et annotation
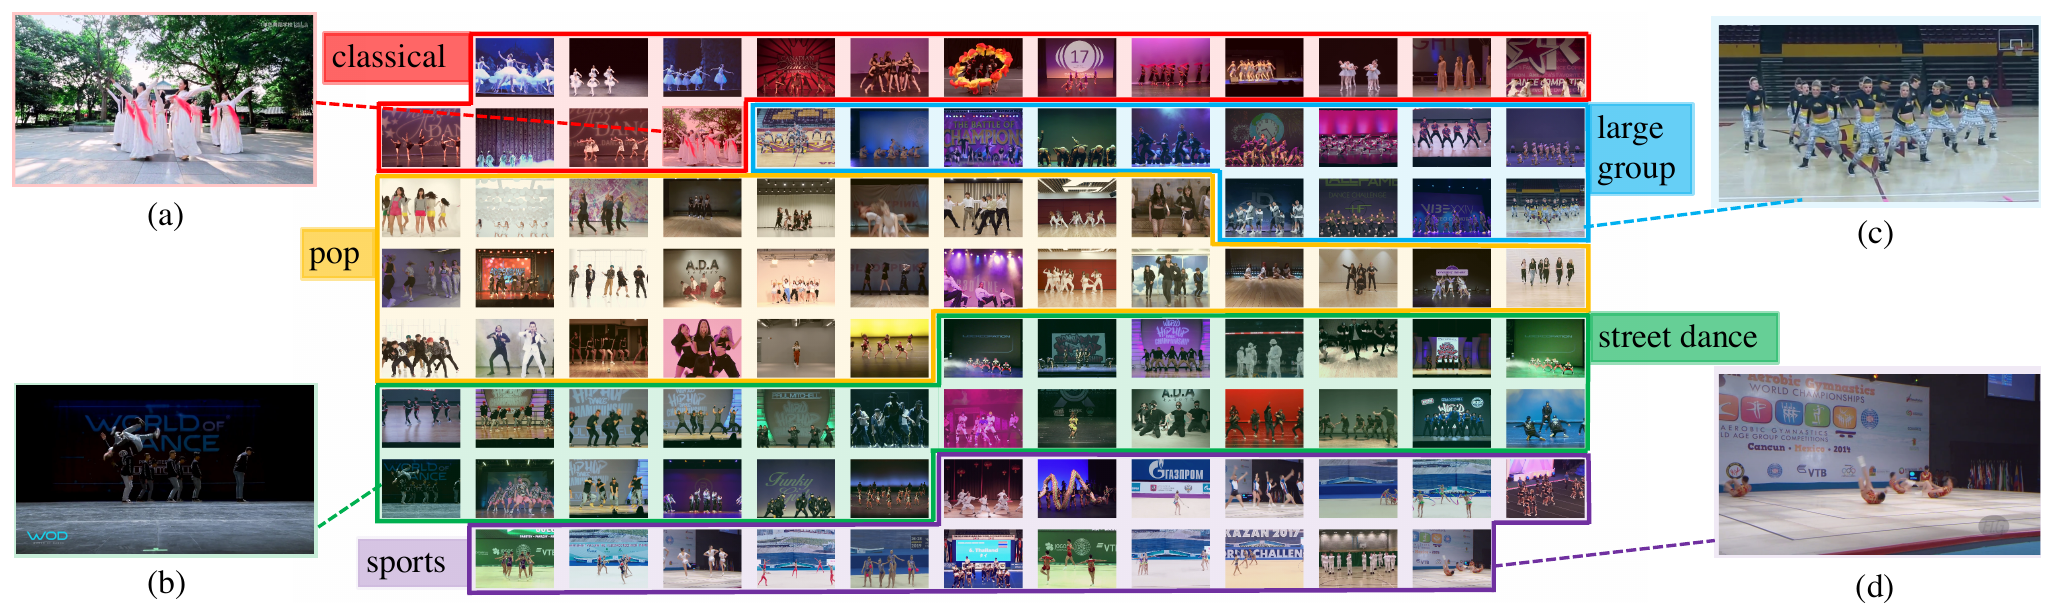
La danse de groupe réunit justement ces deux difficultés. Les danseurs portent souvent des tenues similaires, voire identiques, et ils se déplacent sur de grandes étendues, prennent toutes sortes de poses et se croisent sans arrêt.
Les auteurs collectent sur internet 100 vidéos publiques, avec des mots-clés comme « street dance », « danse hip-hop », « cheerleading » ou « gymnastique rythmique ». On y trouve de la street dance, de la danse populaire, des danses classiques comme le ballet et le tango, de grandes danses de groupe, mais aussi des scènes sportives comme la gymnastique, le kung-fu chinois ou le cheerleading. La plupart sont tournées en intérieur, mais il y a aussi des scènes en extérieur, sombres ou filmées de très loin ; la vidéo la plus peuplée compte 40 personnes.
L'annotation ne comporte que des boîtes et des identités, avec les règles suivantes :
- Une personne partiellement occultée reçoit une boîte complète couvrant tout le corps.
- Une personne entièrement occultée n'est pas annotée ; quand elle réapparaît, elle garde son identité d'origine.
L'outil d'annotation reporte automatiquement les boîtes d'une image à la suivante, et les annotateurs n'ont qu'à les corriger. Une fois l'annotation terminée, une autre équipe la vérifie, et les erreurs sont renvoyées pour être annotées à nouveau.
Les 100 vidéos sont réparties en 40 pour l'entraînement, 25 pour la validation et 35 pour le test, de sorte que la longueur moyenne, le nombre moyen de boîtes, la diversité des scènes et celle des mouvements soient à peu près les mêmes dans les trois ensembles. Les annotations de l'ensemble de test ne sont pas publiées ; elles sont réservées à une compétition.
| MOT17 | MOT20 | DanceTrack | |
|---|---|---|---|
| Vidéos | 14 | 8 | 100 |
| Trajectoires par vidéo (moy.) | 96 | 432 | 9 |
| Trajectoires au total | 1 342 | 3 456 | 990 |
| Durée moyenne (s) | 35.4 | 66.8 | 52.9 |
| Durée totale (s) | 463 | 535 | 5 292 |
| Images au total | 11 235 | 13 410 | 105 855 |
D'après la Table 1 de l'article.
Le nombre de vidéos et le nombre d'images sont environ dix fois ceux des jeux de données MOT. Mais chaque vidéo ne contient en moyenne que 9 trajectoires, bien moins que MOT17. La difficulté de DanceTrack vient de ce que tout le monde se ressemble et bouge dans tous les sens, pas du nombre de personnes.
Mesurer la difficulté en chiffres
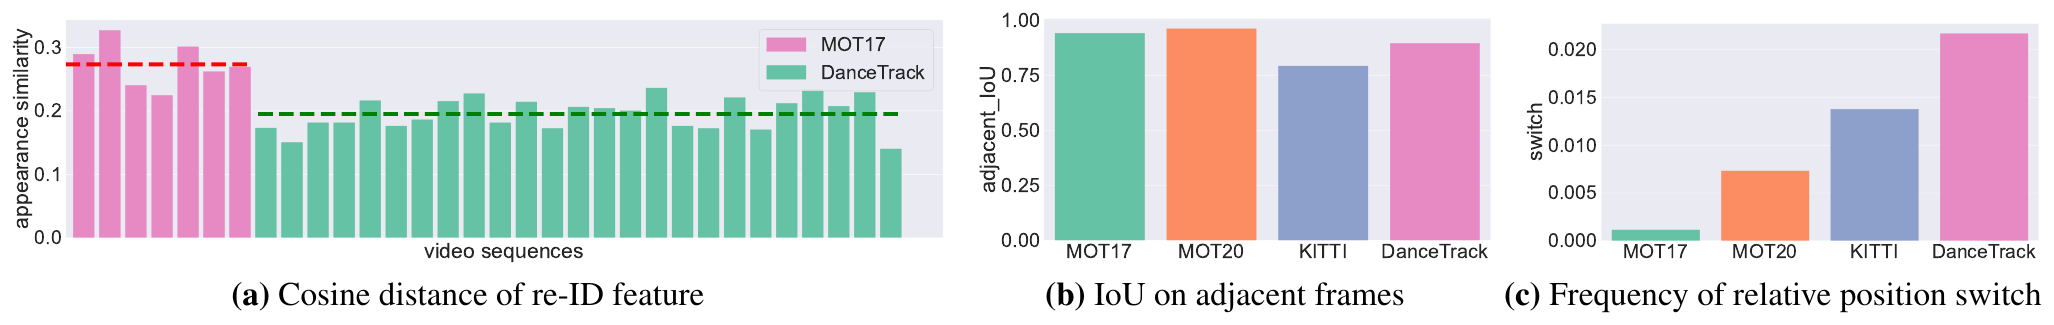
Les auteurs quantifient ces deux difficultés avec trois statistiques.
Similarité d'apparence. Un modèle re-ID préentraîné extrait les caractéristiques de chaque personne ; on calcule la distance cosinus entre toutes les paires de personnes d'une même image, puis on fait la moyenne sur toute la vidéo. La distance moyenne de DanceTrack est nettement plus faible que celle de MOT17 ; les apparences de personnes différentes y sont donc plus proches.
IoU entre images adjacentes. C'est l'IoU entre les boîtes d'une même personne dans deux images adjacentes, moyenné sur toutes les personnes et toutes les images. Un IoU bas indique un mouvement rapide ou une faible fréquence d'images. DanceTrack est proche des jeux de données MOT ; sa difficulté ne vient donc pas de déplacements anormalement rapides.
Fréquence des échanges de position relative. Quand deux personnes dont les boîtes se recouvrent échangent leurs positions relatives, gauche-droite ou haut-bas, entre deux images adjacentes, on compte un échange. Des objets à vitesse constante échangent rarement leurs places ; ce sont les mouvements non linéaires qui produisent des croisements fréquents. Sur ce point, DanceTrack dépasse de loin MOT17 et MOT20, et même KITTI, un jeu de données de conduite où la caméra bouge en permanence.
Prises ensemble, les deux dernières mesures montrent que les personnes de DanceTrack ne bougent pas beaucoup d'une image à l'autre, mais que leurs trajectoires se croisent sans cesse. C'est exactement la situation où un modèle de mouvement linéaire se trompe le plus facilement.
Métriques d'évaluation
DanceTrack prend HOTA comme métrique principale. La capacité d'association se lit dans AssA et IDF1, la qualité de détection dans DetA et MOTA. Pour les auteurs, MOTA penche trop vers la détection, et seul HOTA permet d'examiner séparément détection et association.
Discussion
Avec les boîtes de vérité terrain, le suivi tient-il ?
| Association | MOT17 HOTA | DanceTrack HOTA | DanceTrack AssA | DanceTrack IDF1 |
|---|---|---|---|---|
| IoU | 98.1 | 72.8 | 53.6 | 63.5 |
| IoU + mouvement | 96.4 | 69.4 | 54.8 | 71.3 |
| Apparence + IoU + mouvement | 95.0 | 59.7 | 43.2 | 60.5 |
| Apparence | 93.3 | 68.0 | 47.4 | 58.7 |
D'après la Table 2 de l'article, ensembles de validation des deux jeux de données ; les boîtes de détection sont directement les boîtes de vérité terrain.
Les auteurs mènent d'abord une expérience oracle ; les boîtes de détection sont directement les boîtes de vérité terrain, et seules les méthodes d'association sont comparées.
Sur MOT17, un simple appariement par IoU donne déjà un HOTA de 98.1, presque parfait. Autrement dit, dès que la détection est assez précise, l'association sur MOT17 ne pose presque aucun problème.
Sur DanceTrack, avec les mêmes boîtes de vérité terrain, l'appariement par IoU ne donne plus qu'un HOTA de 72.8 et un AssA de 53.6. La détection est déjà parfaite ; le goulot d'étranglement est entièrement dans l'association.
Les deux dernières lignes ajoutent des caractéristiques d'apparence, et toutes les métriques se dégradent ; le HOTA d'« apparence + IoU + mouvement » est même inférieur de 13 points à celui de l'IoU seule. Dans une scène où tout le monde se ressemble, l'apparence n'aide en rien, et elle fait même dévier l'association.
Les performances des traqueurs existants
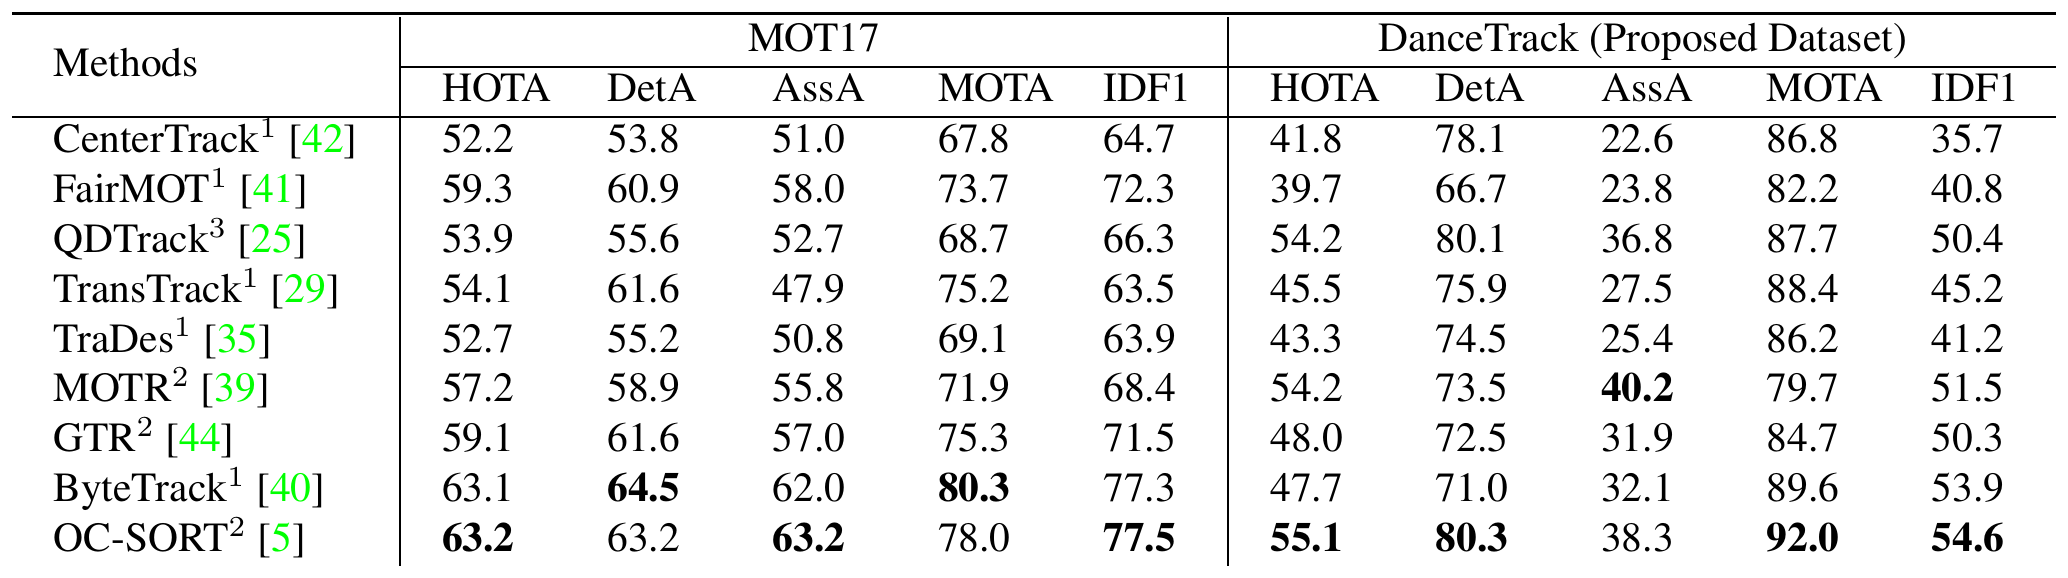
Les auteurs réentraînent et testent sur DanceTrack les principaux traqueurs de l'époque.
Sur DanceTrack, toutes les méthodes voient chuter fortement leurs HOTA, AssA et IDF1. ByteTrack passe de 63.1 sur MOT17 à seulement 47.7 sur DanceTrack ; FairMOT tombe de 59.3 à 39.7.
Les métriques de détection, elles, s'améliorent. Toutes les méthodes ont un MOTA et un DetA plus élevés sur DanceTrack que sur MOT17, avec des MOTA généralement entre 80 et 90. Les gens sur scène sont faciles à détecter ; ce qui coince, c'est de savoir qui est qui.
Ce tableau a été mis à jour entre les versions de l'article. La troisième version remplace le détecteur de QDTrack par YOLOX et le réentraîne avec l'augmentation de données et les seuils de ByteTrack, sans rien changer à l'apprentissage de l'apparence ; QDTrack obtient alors un HOTA de 54.2, plus que ByteTrack. MOTR a l'AssA le plus élevé du tableau, 40.2, mais un DetA de 73.5, inférieur à celui de la plupart des méthodes ; cette combinaison, association forte et détection faible, deviendra le point de départ de MOTRv2.
Méthodes d'association et modèles de mouvement
Pour comparer l'association isolément, les auteurs fixent la détection à YOLOX et ne changent que la méthode d'association :
| Méthode | HOTA | DetA | AssA | MOTA | IDF1 |
|---|---|---|---|---|---|
| IoU | 44.7 | 79.6 | 25.3 | 87.3 | 36.8 |
| SORT | 47.8 | 74.0 | 31.0 | 88.2 | 48.3 |
| DeepSORT | 45.8 | 70.9 | 29.7 | 87.1 | 46.8 |
| MOTDT | 39.2 | 68.8 | 22.5 | 84.3 | 39.6 |
| BYTE | 47.1 | 70.5 | 31.5 | 88.2 | 51.9 |
| OC-SORT | 52.1 | 79.8 | 35.3 | 87.3 | 51.6 |
D'après la Table 4 de l'article, ensemble de validation de DanceTrack, détecteur YOLOX.
Ce tableau montre trois choses.
- DeepSORT fait moins bien que SORT. DeepSORT, c'est SORT plus une comparaison d'apparence, et son HOTA baisse de 47.8 à 45.8. Ici, l'apparence a un apport négatif.
- MOTDT est le pire. MOTDT se sert des résultats de suivi pour compléter les détections, mais la détection sur DanceTrack est déjà très bonne, et cette conception dégrade à la fois la détection et l'association.
- OC-SORT est le meilleur. C'est une méthode fondée uniquement sur le mouvement, qui améliore le filtre de Kalman spécialement pour les mouvements non linéaires ; il atteint un HOTA de 52.1, et son AssA de 35.3 est lui aussi le plus élevé.
Un autre tableau compare les modèles de mouvement. Sans aucun mouvement, avec l'IoU seule, HOTA vaut 44.7 ; avec le filtre de Kalman, 47.8 ; avec un modèle de mouvement appris par LSTM, 51.6. Quand l'apparence n'est pas fiable, les modèles de mouvement ont un grand potentiel.
Ajouter davantage d'informations
Puisque la détection n'est pas le problème, les auteurs essaient de donner au modèle d'autres informations que les seules boîtes. DanceTrack n'a que des annotations de boîtes ; ils utilisent donc CenterNet avec l'association BYTE, et entraînent conjointement avec d'autres jeux de données :
- Masques de segmentation : avec les masques de COCO à l'entraînement, HOTA passe de 36.9 à 38.1 ; en utilisant aussi les masques pour l'association, il atteint 39.2.
- Pose humaine : avec les poses de COCO à l'entraînement, HOTA monte à 40.6 ; en utilisant aussi les poses pour l'association, il atteint 41.0. Le gain est plus important qu'avec les masques. Quand une personne est en grande partie cachée, la boîte n'est pas fiable, alors que les points clés restent plus stables.
- Profondeur : avec la profondeur de KITTI à l'entraînement, HOTA baisse au contraire à 34.4. KITTI contient surtout des voitures, trop éloignées d'une scène de danse. Toutefois, en prenant comme référence le modèle entraîné sur le mélange, utiliser la profondeur pour l'association ajoute quand même 1.7 point d'IDF1.
Les auteurs concluent que des représentations plus fines que la boîte (masques, poses) aident, que l'information de profondeur a du potentiel, et que la modélisation du mouvement est essentielle.
Limites
Les auteurs relèvent eux-mêmes deux limites. L'article ne propose qu'un jeu de données, sans nouvel algorithme qui prenne une large avance, et laisse le problème aux travaux suivants. Par ailleurs, le jeu de données n'a que des annotations de boîtes, sans poses ni masques ; pour des études plus fines, il faut emprunter d'autres jeux de données.
La suite
DanceTrack est vite devenu le benchmark de référence pour tester la capacité d'association.
Quelques mois plus tard, Jinkun Cao et Kris Kitani, coauteurs de l'article, publient OC-SORT, conçu spécialement pour les mouvements non linéaires et les occultations. Plus tard encore, MOTRv2 et Deep OC-SORT font eux aussi de DanceTrack leur principale scène de comparaison.
Conclusion
DanceTrack ne propose pas de nouveau traqueur ; il trouve plutôt une scène où toutes les méthodes existantes souffrent, avec des gens habillés pareil qui sautent dans tous les sens.
Dans cette scène, la détection n'est presque pas un problème ; l'association, si. Les caractéristiques d'apparence font souvent plus de mal que de bien, et les modèles de mouvement linéaires ne suivent pas les pas de danse.
Jusque-là, quand on parlait de la difficulté du suivi, on pensait d'abord à l'« encombrement ». Les vidéos de DanceTrack ne comptent en moyenne que 9 personnes, et pourtant elles sont plus difficiles à suivre que les foules de plusieurs centaines de personnes de MOT20.