Article original
Simple Online and Realtime Tracking
- Publication
- ICIP 2016Conférence
- Premier dépôt sur arXiv
- arXiv:1602.00763
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingsort2016,
  title = {{Simple Online and Realtime Tracking}},
  author = {Alex Bewley and Zongyuan Ge and Lionel Ott and Fabio Ramos and Ben Upcroft},
  year = {2016},
  eprint = {1602.00763},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.00763}
}
En 2015, MOTChallenge est mis en ligne. Ce benchmark réunit les vidéos de suivi multi-objets, les annotations, des détections publiques et le code d'évaluation ; on peut enfin comparer les traqueurs sur un même classement.
Le haut du classement est rempli de systèmes sophistiqués. De vieilles méthodes héritées du suivi radar, comme le Multiple Hypothesis Tracking (MHT) et le Joint Probabilistic Data Association (JPDA), ressortent des tiroirs, accompagnées de modèles d'apparence, d'apprentissage en ligne et de toutes sortes de règles pour gérer les occultations. La précision monte, c'est vrai, mais la vitesse tombe souvent à une ou deux images par seconde.
En examinant ce classement, Alex Bewley et ses collègues de la Queensland University of Technology remarquent deux choses. D'abord, le traqueur le mieux classé est justement la seule méthode qui n'utilise pas les détections ACF officielles. Ensuite, les méthodes les plus précises sont toutes trop lentes pour fonctionner en temps réel.
Si la qualité de détection est le vrai goulot d'étranglement, le traqueur a-t-il besoin d'être aussi compliqué ?
Cet article veut savoir jusqu'où le suivi multi-objets peut être simple, et à quel point il peut alors être bon.
Définir le problème
Le suivi multi-objets (Multi-Object Tracking, MOT) prend en entrée une vidéo et produit, dans chaque image, une boîte pour chaque objet, avec un ID qui reste le même d'une image à l'autre.
L'approche dominante s'appelle tracking-by-detection. Le détecteur trouve d'abord toutes les boîtes de chaque image, indépendamment ; le traqueur relie ensuite ces boîtes en trajectoires. Le détecteur ne s'occupe que de « qui est dans cette image », le traqueur doit répondre à « à quelle boîte de l'image précédente correspond celle-ci ». C'est ce second problème qu'on appelle l'association de données (data association).
L'article ajoute une contrainte, le traqueur doit être online. Autrement dit, quand il traite l'image , il ne voit que l'image et les précédentes, et doit attribuer les ID sur-le-champ. L'autre famille, les méthodes batch, peut regarder toute la vidéo avant de revenir faire une optimisation globale ; elle obtient en général de meilleurs résultats, mais ne convient pas aux situations qui exigent une réaction immédiate, comme la voiture autonome ou la robotique.
Voici à quoi ressemblait le classement à l'époque :
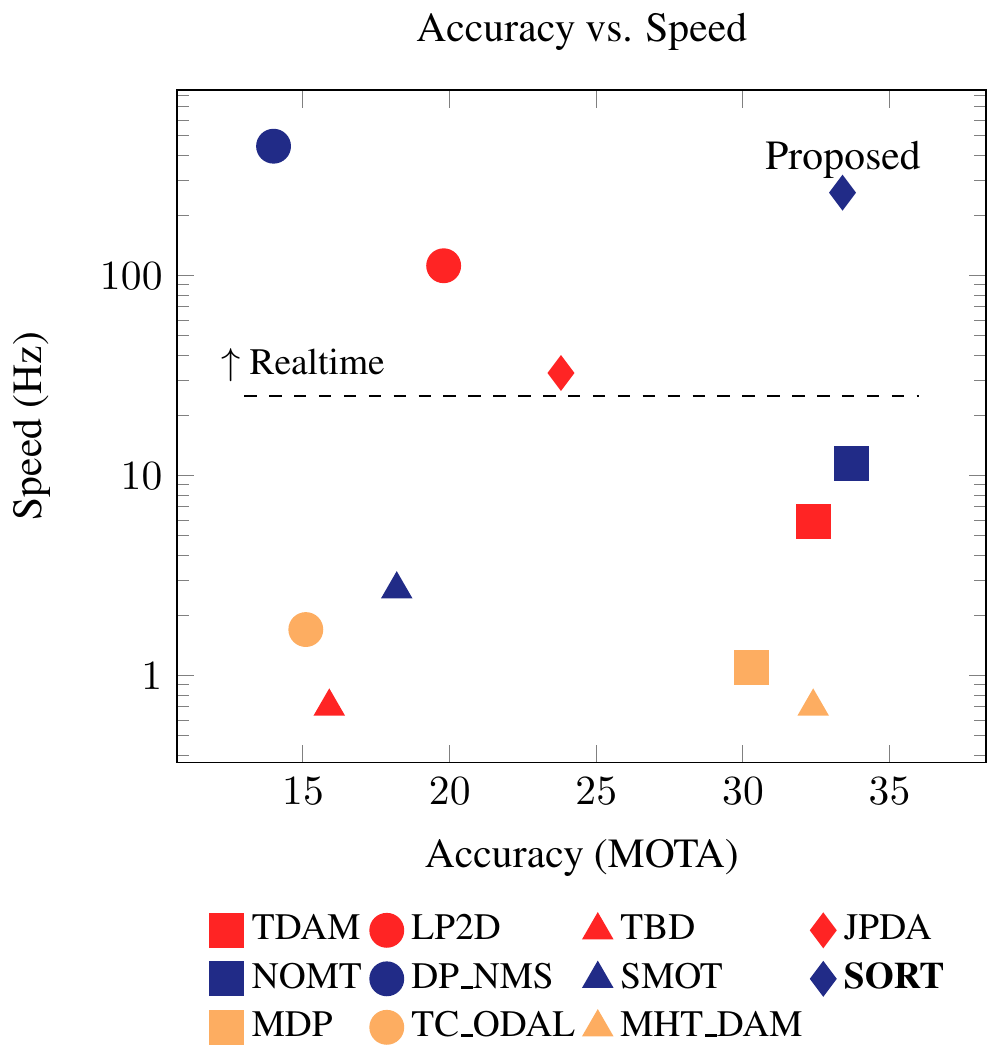
L'abscisse donne la précision, l'ordonnée la vitesse ; plus on est en haut à droite, mieux c'est. En bas à droite, les méthodes précises mais lentes ; en haut à gauche, les méthodes rapides mais imprécises ; le coin supérieur droit était vide.
Au nom du rasoir d'Ockham, les auteurs font pour leur traqueur quelques choix radicaux :
- Seules la position et la taille des boîtes comptent. En dehors du détecteur, aucune caractéristique d'apparence n'est extraite ; l'estimation du mouvement comme l'association de données ne regardent que les boîtes.
- Pas de gestion des occultations. Les auteurs estiment que les occultations de courte et de longue durée sont rares dans ce jeu de données, et qu'un mécanisme dédié ne ferait que compliquer le système. (Sur ce « rares », MOT20 et DanceTrack ne seraient sans doute pas d'accord.)
- Pas de ré-identification. Un objet qui quitte l'image puis revient est traité comme un nouvel objet. Selon les auteurs, la ré-identification ajoute une charge de calcul considérable et gêne les applications en temps réel.
Il ne reste plus qu'à bien apparier les boîtes de deux images consécutives.
Résoudre le problème
SORT se compose de quatre parties : la détection, l'estimation d'état, l'association de données, et la création et la suppression des trajectoires.
Le détecteur
Les auteurs utilisent Faster R-CNN et comparent deux backbones, ZF, moins profond, et VGG16, plus profond. Les poids sont les paramètres par défaut entraînés sur PASCAL VOC, sans réentraînement sur des piétons ; en sortie, seule la classe « personne » est conservée, et seulement au-dessus d'une probabilité de 50 %.
L'étape paraît banale, mais c'est la variable expérimentale la plus importante de tout l'article ; nous y reviendrons dans la discussion.
L'état de chaque cible
Chaque objet suivi est décrit par un vecteur à sept dimensions :
sont les coordonnées en pixels du centre de la boîte, est l'aire de la boîte, son rapport largeur/hauteur, et les trois derniers termes sont les vitesses des trois premiers. Le rapport largeur/hauteur n'a pas de terme de vitesse ; les auteurs le supposent constant.
Le modèle de mouvement est un modèle à vitesse constante : à chaque image, on ajoute la vitesse à la position, et la vitesse reste inchangée. Le code officiel l'écrit sous la forme d'une matrice de transition d'état de taille , et d'une matrice d'observation qui ne garde que les quatre premiers termes :
Les trois premières lignes de disent « nouvelle position = ancienne position + vitesse » ; dit que le détecteur ne voit directement que , et pas les vitesses. Les vitesses doivent être déduites par un filtre de Kalman (Kalman filter) à partir des observations de plusieurs images successives.
À chaque image, le filtre de Kalman fait deux choses. La première étape est la prédiction, qui fait avancer l'état d'une image avec le modèle de mouvement tout en augmentant l'incertitude :
La seconde étape est la mise à jour. Si une boîte de détection lui est attribuée dans cette image, on corrige la prédiction avec la détection :
est la covariance de l'état ; elle dit à quel point le filtre est peu sûr de lui. est le bruit du modèle de mouvement, le bruit des boîtes de détection. Le gain de Kalman décide s'il faut croire la prédiction ou la détection : plus la prédiction est incertaine ( grand), plus il écoute la détection ; moins la détection est fiable ( grand), plus il écoute la prédiction.
Si aucune boîte de détection ne lui est attribuée dans cette image, on fait seulement la prédiction, sans mise à jour.
Comment apparier
Au début de chaque image, toutes les trajectoires existantes font d'abord une prédiction, qui donne la boîte où elles « devraient » apparaître dans cette image. On calcule ensuite l'intersection sur l'union (Intersection over Union, IoU) entre chaque boîte de détection et chaque boîte prédite, et l'on range le tout dans une matrice.
L'appariement doit être un à un : une boîte de détection va au plus à une trajectoire, et une trajectoire reçoit au plus une boîte de détection. Maximiser l'IoU totale sous cette contrainte, c'est le problème d'affectation (assignment problem) classique, dont l'algorithme hongrois (Hungarian algorithm) trouve la solution optimale.
Pourquoi ne pas simplement apparier d'abord les paires de plus grande IoU ? Prenons un petit exemple.
Supposons deux trajectoires A et B, et deux boîtes de détection 1 et 2, avec la matrice d'IoU suivante :
| Détection 1 | Détection 2 | |
|---|---|---|
| Trajectoire A | 0.60 | 0.50 |
| Trajectoire B | 0.55 | 0.00 |
Avec une méthode gloutonne, on prend d'abord la plus grande valeur du tableau, 0.60, et la détection 1 va à A. Il ne reste à B que la détection 2, avec une IoU de 0 ; l'appariement échoue. B perd son observation pour cette image, la détection 2 est prise pour un nouvel objet, et l'IoU totale vaut 0.60.
L'algorithme hongrois regarde l'ensemble. A reçoit la détection 2 (0.50), B la détection 1 (0.55) ; l'IoU totale vaut 1.05, et chaque trajectoire a sa boîte. Quand deux personnes marchent côte à côte et que leurs boîtes se chevauchent, cette situation est très courante.
Une fois l'appariement fait, on défait les paires dont l'IoU est inférieure au seuil , pour éviter de forcer l'appariement de deux boîtes qui ne se chevauchent pas du tout. Dans le code officiel, le seuil est de 0.3.
Les auteurs remarquent aussi un avantage secondaire de l'IoU. Quand une personne passe devant une autre, le détecteur n'encadre en général que celle de devant. La taille de cette boîte est plus proche de la boîte prédite de la personne de devant, et l'IoU tend à la lui attribuer ; la personne masquée ne reçoit aucune boîte de détection, son état est seulement prédit, et aucune observation erronée ne vient l'entraîner ailleurs. Les croisements brefs passent ainsi sans la moindre règle de gestion des occultations.
Naissance et mort des trajectoires
Si une boîte de détection a une IoU inférieure à avec toutes les boîtes prédites, on la considère comme un objet qui vient d'apparaître, et on crée une nouvelle trajectoire. La position est prise directement sur la boîte de détection, la vitesse est mise à zéro, et la covariance de la vitesse est fixée très grande, pour signifier qu'on ne sait pas encore où l'objet se dirige.
Une nouvelle trajectoire passe d'abord par une période d'essai ; elle ne compte qu'après plusieurs appariements réussis d'affilée, ce qui filtre les faux positifs que le détecteur laisse échapper de temps en temps. L'article ne donne pas ce nombre ; dans le code officiel, min_hits vaut 3.
La règle de suppression est encore plus expéditive. Une trajectoire qui ne reçoit aucune boîte de détection pendant images consécutives est supprimée. Les auteurs fixent à 1 dans toutes les expériences, pour deux raisons : le modèle à vitesse constante prédit mal de toute façon, et une prédiction laissée sans correction ne ferait que dériver de plus en plus ; de plus, l'article ne traite que l'appariement entre images consécutives, et la ré-identification sort de son cadre.
Un objet masqué un moment, puis réapparu, reçoit donc un nouvel ID.
Discussion
Les auteurs évaluent la méthode sur MOTChallenge 2015 (MOT15). Pour régler la covariance initiale du filtre de Kalman, et , ils reprennent la séparation entraînement/validation de l'article MDP.
Il faut d'abord connaître deux indicateurs :
- MOTA (Multi-Object Tracking Accuracy) : on additionne trois types d'erreurs, les détections manquées (FN), les faux positifs (FP) et les changements d'identité (ID switch), on divise par le nombre total de boîtes réelles, et l'on soustrait le résultat de 1. Les trois erreurs pèsent autant, mais les deux premières sont en général plus nombreuses que les changements d'identité d'un ou deux ordres de grandeur ; le MOTA reflète donc surtout la qualité de détection.
- ID sw : le nombre de fois où l'ID attribué à une trajectoire réelle change ; il reflète directement la qualité de l'appariement.
Changer de détecteur
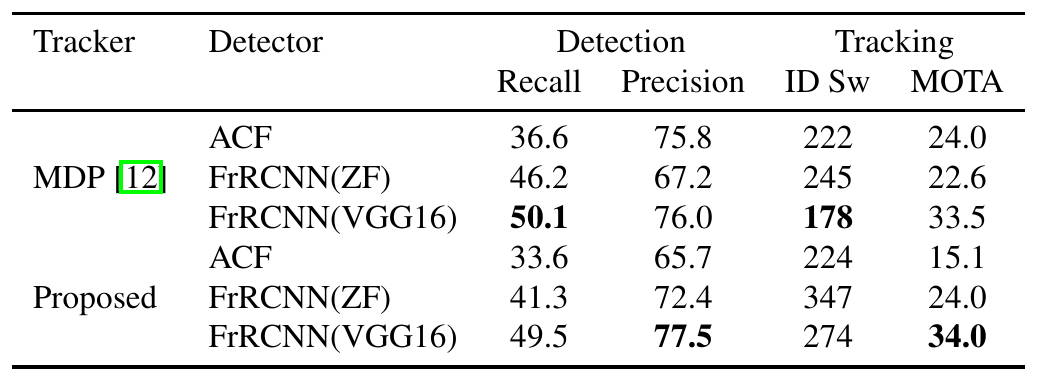
Ce tableau, sur le jeu de validation, associe chacun des deux traqueurs à trois détecteurs. MDP était alors un traqueur en ligne très performant, doté d'un processus de décision appris ; SORT est la méthode de l'article.
Commençons par les trois lignes de SORT. En passant du détecteur ACF à FrRCNN(VGG16), le MOTA monte de 15.1 à 34.0, soit 18.9 points d'écart. C'est cet écart que désigne le résumé quand il annonce un gain « allant jusqu'à 18.9 % » en changeant de détecteur. L'algorithme de suivi, lui, n'a pas bougé.
Passons à MDP. Avec FrRCNN(ZF), le rappel monte de 36.6 à 46.2, mais le MOTA baisse de 24.0 à 22.6. Le problème vient de la précision. Celle de ZF tombe de 75.8 à 67.2 ; les faux positifs augmentent, et le MOTA en pâtit aussi. Un détecteur qui « trouve davantage » n'aide pas forcément le suivi ; les faux positifs aussi se paient.
Avec le meilleur détecteur, les deux traqueurs obtiennent un MOTA de 33.5 et de 34.0, un écart minime. L'écart dû au détecteur est bien plus grand que l'écart entre les traqueurs.
Le jeu de test MOT15
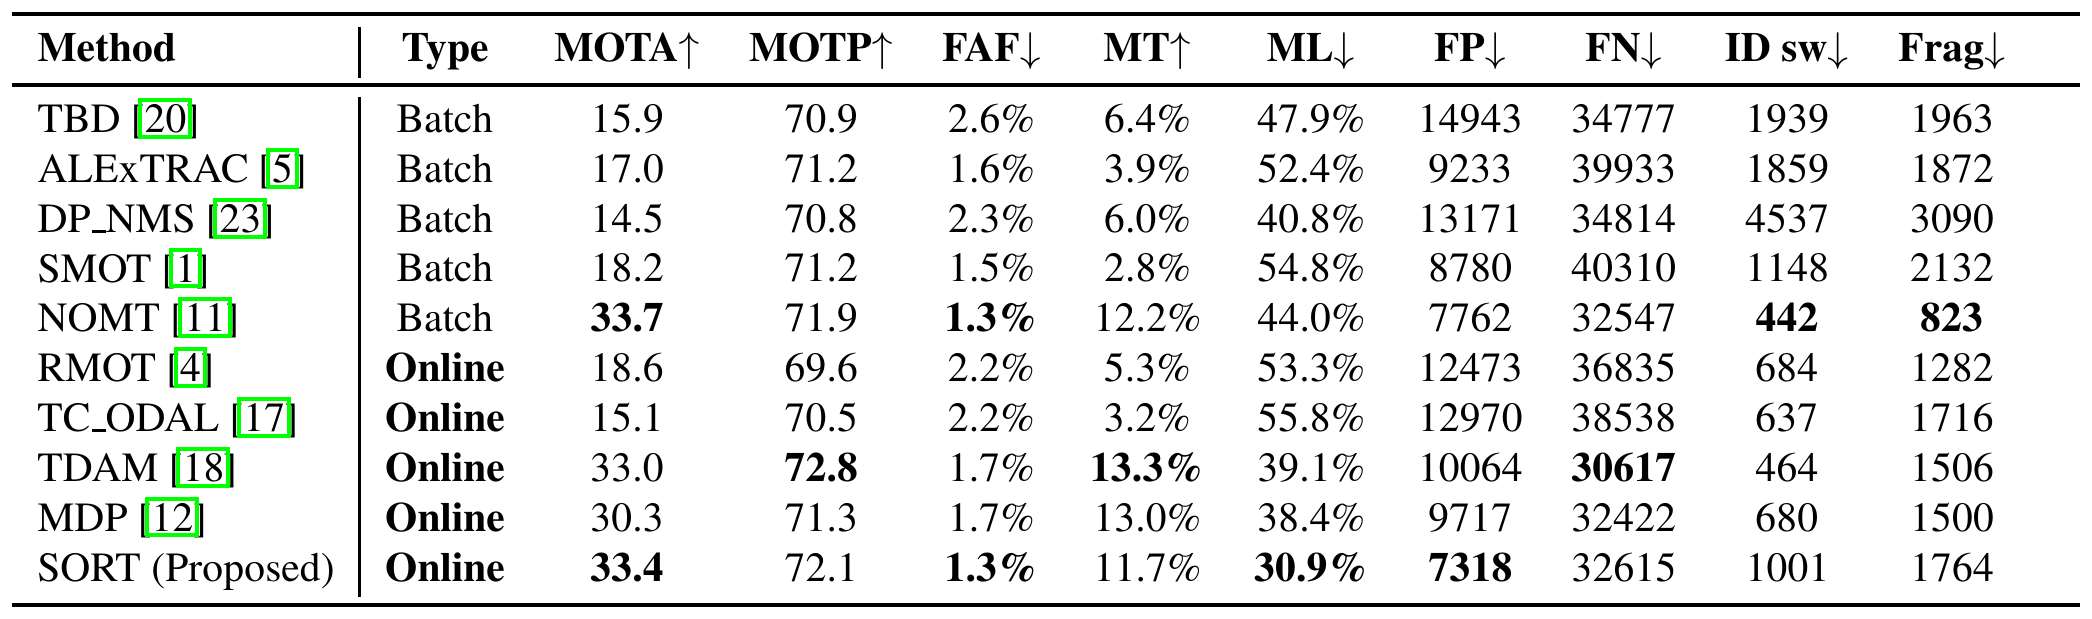
Le jeu de test compte 11 vidéos ; les annotations réelles ne sont pas publiques, et les résultats sont calculés par le serveur officiel.
SORT obtient un MOTA de 33.4, le plus élevé des méthodes en ligne, presque identique à celui de NOMT (33.7), qui jette un œil aux quelques images à venir. Ses 7318 faux positifs sont le plus petit nombre du tableau, et sa proportion de trajectoires presque entièrement perdues (ML), 30.9 %, est aussi la plus basse.
La colonne des changements d'identité, en revanche, est moins flatteuse. SORT en compte 1001, contre 680 pour MDP, 464 pour TDAM et seulement 442 pour NOMT. C'est le prix de et de l'absence d'information d'apparence : un objet masqué plus d'une ou deux images change d'ID à son retour. Le nombre de fragmentations de trajectoires (Frag), 1764, est lui aussi élevé.
Le MOTA est élevé parce que la détection est bonne ; les changements d'identité sont nombreux parce que l'appariement est trop rudimentaire. Ces deux colonnes, côte à côte, montrent clairement les forces et les faiblesses de SORT.
Vitesse
La partie suivi tourne à 260 Hz sur un seul cœur d'un Intel i7 2.5GHz, soit moins de 4 millisecondes par image, plus de 20 fois plus vite que les autres méthodes du tableau.
Ce chiffre ne compte toutefois que le suivi, pas la détection. Le FrRCNN(VGG16) utilisé par SORT tourne à environ 5 images par seconde sur le GPU de l'article original de Faster R-CNN. Pour que tout le système fonctionne en temps réel, le goulot d'étranglement est en fait le détecteur. L'argument de l'article n'en souffre pas ; il veut montrer que l'étape de suivi peut ne coûter presque rien, et laisser le budget de calcul au détecteur.
La suite
La documentation du code officiel indique qu'à sa publication, SORT était le traqueur open source le mieux classé sur MOT15, et rappelle qu'une grande part de sa précision revient aux détections. Le code lui-même fait moins de trois cents lignes, et il est vite devenu la référence par défaut de toutes sortes de projets.
Ses paramètres se sont dispersés du même coup. D'un portage à l'autre, max_age vaut 1 ou 30, et min_hits comme le seuil d'IoU ont chacun leurs réglages. Avant de comparer des chiffres avec le SORT de quelqu'un d'autre, mieux vaut vérifier quels réglages ont été utilisés.
Dans leur conclusion, les auteurs écrivent qu'un cadre simple fait une bonne référence, qui laisse les nouvelles méthodes se concentrer sur les occultations longues et la ré-identification ; ils comptent ensuite coupler plus étroitement détection et suivi. Un an plus tard, DeepSORT, publié par Wojke, Bewley et leurs collègues, remettait des caractéristiques d'apparence sur cette ossature ; JDE, FairMOT et CenterTrack, qui placent détection et suivi dans un même réseau, ont pris un autre chemin.
Conclusion
Avec trois outils de manuel, le filtre de Kalman, l'IoU et l'algorithme hongrois, SORT obtient sur MOT15 le meilleur MOTA des méthodes en ligne, et le suivi lui-même prend moins de 4 millisecondes par image. Le chiffre le plus convaincant de l'article, c'est le changement de détecteur qui fait bondir le MOTA de 15.1 à 34.0, alors que les deux traqueurs, avec le même bon détecteur, ne sont séparés que de 0.5 point.
Pour construire un nouveau système de suivi, faites d'abord tourner SORT comme référence, puis passez à un meilleur détecteur et regardez de combien le score bouge. Ce n'est qu'ensuite, sur l'écart restant, que l'algorithme de suivi a son mot à dire.
Cinq ans plus tard, ByteTrack prenait la première place sur MOT17 en associant toujours les boîtes avec un filtre de Kalman et l'IoU ; il ramassait simplement quelques boîtes à faible score en plus.