Article original
ByteTrack: Multi-Object Tracking by Associating Every Detection Box
- Publication
- ECCV 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2110.06864
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingbytetrack2021,
  title = {{ByteTrack: Multi-Object Tracking by Associating Every Detection Box}},
  author = {Yifu Zhang and Peize Sun and Yi Jiang and Dongdong Yu and Fucheng Weng and Zehuan Yuan and Ping Luo and Wenyu Liu and Xinggang Wang},
  year = {2021},
  eprint = {2110.06864},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06864}
}
L'introduction de cet article s'ouvre sur une citation de Hegel : « Ce qui est rationnel est réel, et ce qui est réel est rationnel. »
Un article de suivi qui cite un philosophe, ce n'est pas courant. Ce que les auteurs veulent dire, c'est que parmi les boîtes à faible score produites par le détecteur, certaines sont bien réelles.
Depuis SORT, presque tous les traqueurs ont la même habitude ; ils jettent d'abord les boîtes dont le score de détection est inférieur à un certain seuil, et n'apparient que les boîtes à score élevé. La raison est sensée ; les boîtes à faible score contiennent beaucoup de fond et de faux positifs, et les garder ne ferait que perturber le suivi.
Mais quand une personne est à moitié cachée par une autre, le score du détecteur baisse aussi. Si l'on jette ces boîtes, la trajectoire de cette personne se brise.
Yifu Zhang, premier auteur de FairMOT, travaille cette fois avec des équipes de l'Université des sciences et technologies de Huazhong, de l'Université de Hong Kong et de ByteDance, et déplace l'attention de l'architecture du réseau vers ce seuil.
Définir le problème
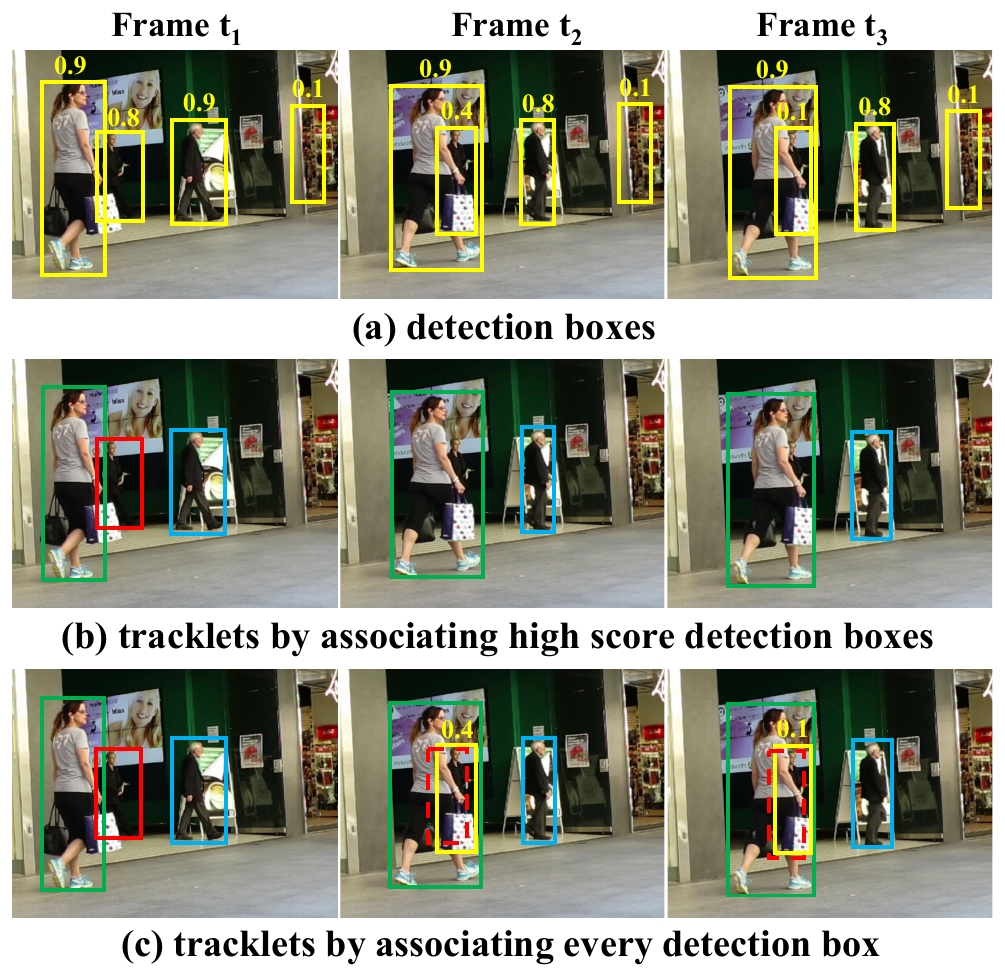
Commençons par la rangée (a). La première image contient quatre boîtes ; les trois personnes ont toutes un score d'au moins 0.8, et la boîte à 0.1 tout à droite est du fond.
À la deuxième image, la femme de gauche passe devant la personne du milieu et la cache en partie ; le score de celle-ci tombe de 0.8 à 0.4. À la troisième, elle la cache davantage, et le score n'est plus que de 0.1.
(b) correspond à l'approche habituelle, qui n'apparie que les boîtes de score supérieur à 0.5. La personne cachée n'est plus observée dès la deuxième image, et la trajectoire rouge disparaît avec elle ; quand elle ressortira de derrière la femme, elle sera prise pour une nouvelle personne.
Et si l'on garde tout ? La boîte de fond à 0.1 tout à droite est gardée elle aussi, et devient une fausse trajectoire.
C'est tout le dilemme du seuil de détection. Un seuil haut fait rater les personnes occultées ; un seuil bas fait entrer des faux positifs issus du fond. Les auteurs relèvent que peu de méthodes s'attaquent vraiment à ce dilemme.
L'indice qu'ils remarquent, c'est la similarité avec les trajectoires existantes. La personne cachée a beau avoir un score très bas, sa boîte recouvre largement la position de la trajectoire rouge prédite par le filtre de Kalman ; la boîte de fond tout à droite n'a aucune trajectoire à proximité. Il suffit de comparer les boîtes à faible score aux « trajectoires restées sans partenaire au tour précédent » pour récupérer les vrais objets tout en filtrant le fond.
(c) montre le résultat de cette approche.
Résoudre le problème
Les auteurs baptisent cette méthode d'association BYTE. Le nom vient de l'octet (byte) en informatique ; chaque boîte de détection est une unité de base de la trajectoire, comme l'octet est l'unité de base d'un programme.
Le processus ne comporte que deux associations :
Préparation : le seuil de score de détection répartit les boîtes de détection de l'image en deux groupes, les boîtes à score élevé et les boîtes à faible score . Le filtre de Kalman prédit la position de chaque trajectoire dans l'image.
Première association : les boîtes à score élevé sont appariées avec toutes les trajectoires, y compris celles temporairement perdues. La similarité peut être l'IoU entre boîte prédite et boîte de détection, ou la distance entre caractéristiques re-ID, et l'algorithme hongrois résout l'appariement. Les boîtes à score élevé restées sans partenaire sont notées , les trajectoires restées sans partenaire .
Seconde association : les boîtes à faible score sont appariées avec , avec l'IoU pour seule similarité. À l'issue de cette étape, les boîtes à faible score toujours sans partenaire sont jetées directement, comme du fond.
Finalisation : les trajectoires restées sans partenaire après les deux associations passent dans l'ensemble des trajectoires perdues, où elles sont gardées 30 images ; si elles sont appariées entre-temps lors d'une première association, elles retrouvent leur identifiant d'origine, et elles ne sont supprimées qu'au-delà de 30 images. Les boîtes à score élevé restées sans partenaire après la première association ouvrent de nouvelles trajectoires. Les trajectoires perdues ne figurent pas dans la sortie.
Pourquoi la seconde association n'utilise-t-elle que l'IoU ? Si une boîte a un score faible, c'est en général à cause d'une forte occultation ou d'un flou de mouvement, et les caractéristiques d'apparence ne sont alors pas fiables. La position l'est davantage ; une personne cachée ne va pas bien loin en une image.
BYTE est indépendant du détecteur et n'impose aucune similarité pour la première association ; on peut le brancher à la suite de n'importe quel traqueur.
Les auteurs branchent ensuite BYTE sur YOLOX, un détecteur très performant à l'époque, et appellent le tout ByteTrack. Sur les jeux de données de piétons comme MOT17 et MOT20, ByteTrack n'utilise que l'IoU dans les deux associations, sans aucune caractéristique re-ID.
Discussion
Le détecteur de ByteTrack est un YOLOX-X, préentraîné sur COCO puis entraîné 80 epochs sur MOT17, CrowdHuman, CityPersons et ETHZ réunis, avec une taille d'entrée de ; il faut environ 12 heures sur 8 V100. La vitesse est mesurée sur V100, en FP16, avec une taille de lot de 1.
Pour les ablations, chaque vidéo de l'ensemble d'entraînement de MOT17 est coupée en deux moitiés, la première pour l'entraînement, la seconde pour la validation, et CrowdHuman est ajouté aux données d'entraînement.
Face aux autres méthodes d'association
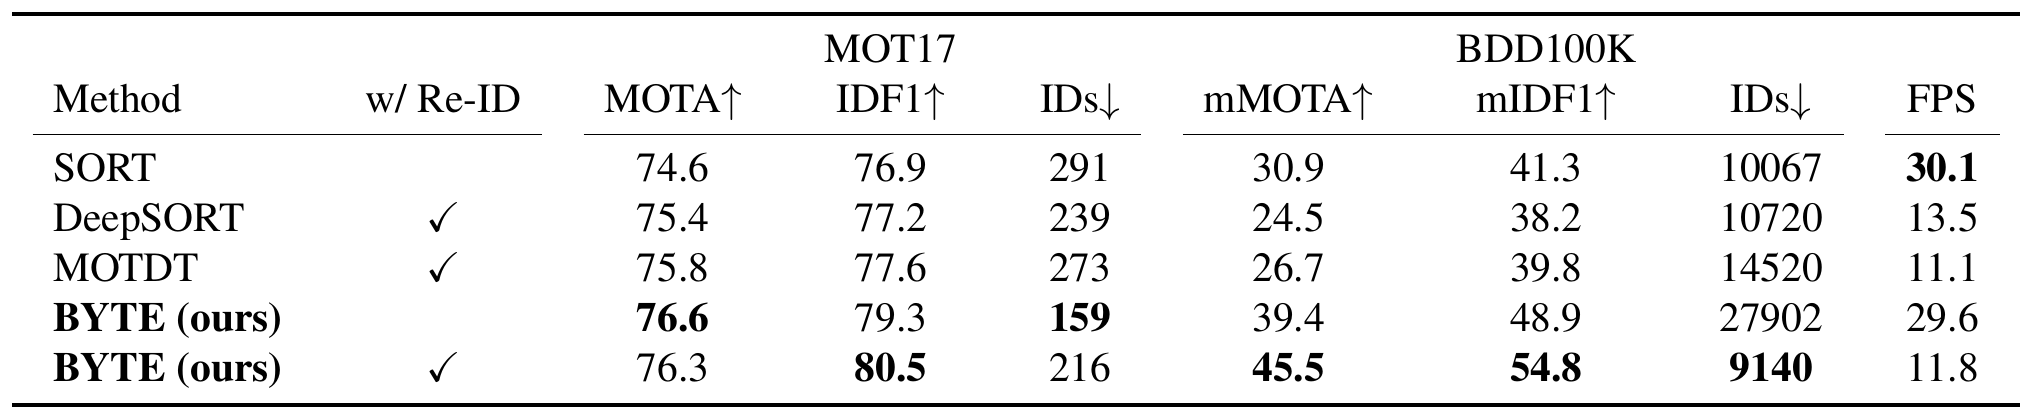
Le détecteur est le même partout dans ce tableau ; seule la méthode d'association change.
SORT peut servir de référence pour BYTE ; tous deux n'utilisent que le filtre de Kalman et l'IoU, et seule la seconde association les distingue. BYTE fait passer MOTA de 74.6 à 76.6 et IDF1 de 76.9 à 79.3, et réduit les changements d'identité (ID switches) de 291 à 159, à vitesse presque inchangée (30.1 contre 29.6 FPS). Voilà ce que valent les boîtes à faible score.
Plus surprenant encore pour les auteurs, il y a DeepSORT. Il dispose d'un modèle re-ID en plus, mais perd face à BYTE, qui n'utilise que l'IoU, en MOTA, en IDF1 et en changements d'identité, et il tourne à moins de la moitié de sa vitesse. Selon l'interprétation des auteurs, quand les boîtes de détection sont assez précises, un simple filtre de Kalman suffit pour bien associer sur de longues distances ; en cas de forte occultation, ce sont au contraire les caractéristiques re-ID qui se trompent facilement, et le modèle de mouvement est plus fiable.
Avec la re-ID, BYTE monte à 80.5 en IDF1, mais son MOTA baisse légèrement et ses changements d'identité augmentent.
Sur BDD100K, la situation est différente. Ce sont des vidéos prises depuis des véhicules, avec de grands mouvements de caméra et une faible fréquence d'annotation ; le filtre de Kalman y échoue, et les auteurs ne l'utilisent donc pas sur BDD100K. BYTE avec l'IoU seule dépasse largement SORT (39.4 contre 30.9), mais avec 27 902 changements d'identité ; avec la re-ID, le mMOTA monte à 45.5 et les changements d'identité tombent à 9140.
Les auteurs comparent aussi les similarités à utiliser dans chacune des deux associations. Sur MOT17, la première peut utiliser l'IoU comme la re-ID ; l'IoU donne de meilleurs MOTA et changements d'identité, la re-ID un IDF1 plus élevé. Sur BDD100K, la re-ID est bien meilleure pour la première association. Mais sur les deux jeux de données, l'IoU l'emporte pour la seconde association, avec environ 1 point de MOTA de plus que la re-ID. Cela conforte l'idée que les caractéristiques d'apparence des boîtes à faible score ne sont pas fiables.
Moins sensible au seuil
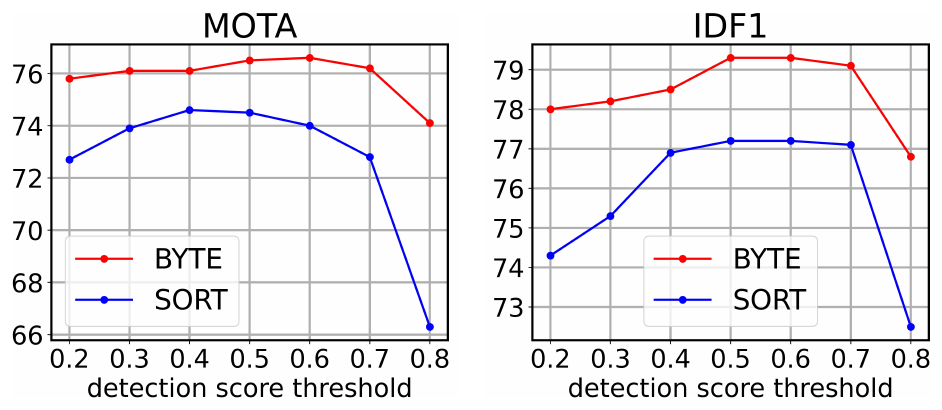
Le seuil de détection est en général l'hyperparamètre le plus sensible d'un traqueur, celui qui demande le réglage le plus soigneux. Les auteurs le font varier de 0.2 à 0.8. Le MOTA de SORT chute rapidement quand le seuil monte, d'environ 74.5 à 0.4 à environ 66 à 0.8 ; celui de BYTE reste relativement stable.
La raison est simple. La seconde association de BYTE récupère les boîtes sous le seuil ; quand on relève le seuil, les boîtes écartées ont encore une seconde chance.
Les auteurs comptent aussi les vrais positifs et les faux positifs parmi les boîtes à faible score. Parmi toutes les boîtes dont le score se situe entre la borne inférieure et le seuil, certaines vidéos (MOT17-02, par exemple) contiennent bien plus de faux positifs que de vrais positifs ; mais parmi les boîtes que BYTE en récupère, les vrais positifs sont nettement plus nombreux que les faux positifs. La similarité avec les trajectoires existantes est bel et bien un filtre efficace.
Greffé sur les traqueurs des autres
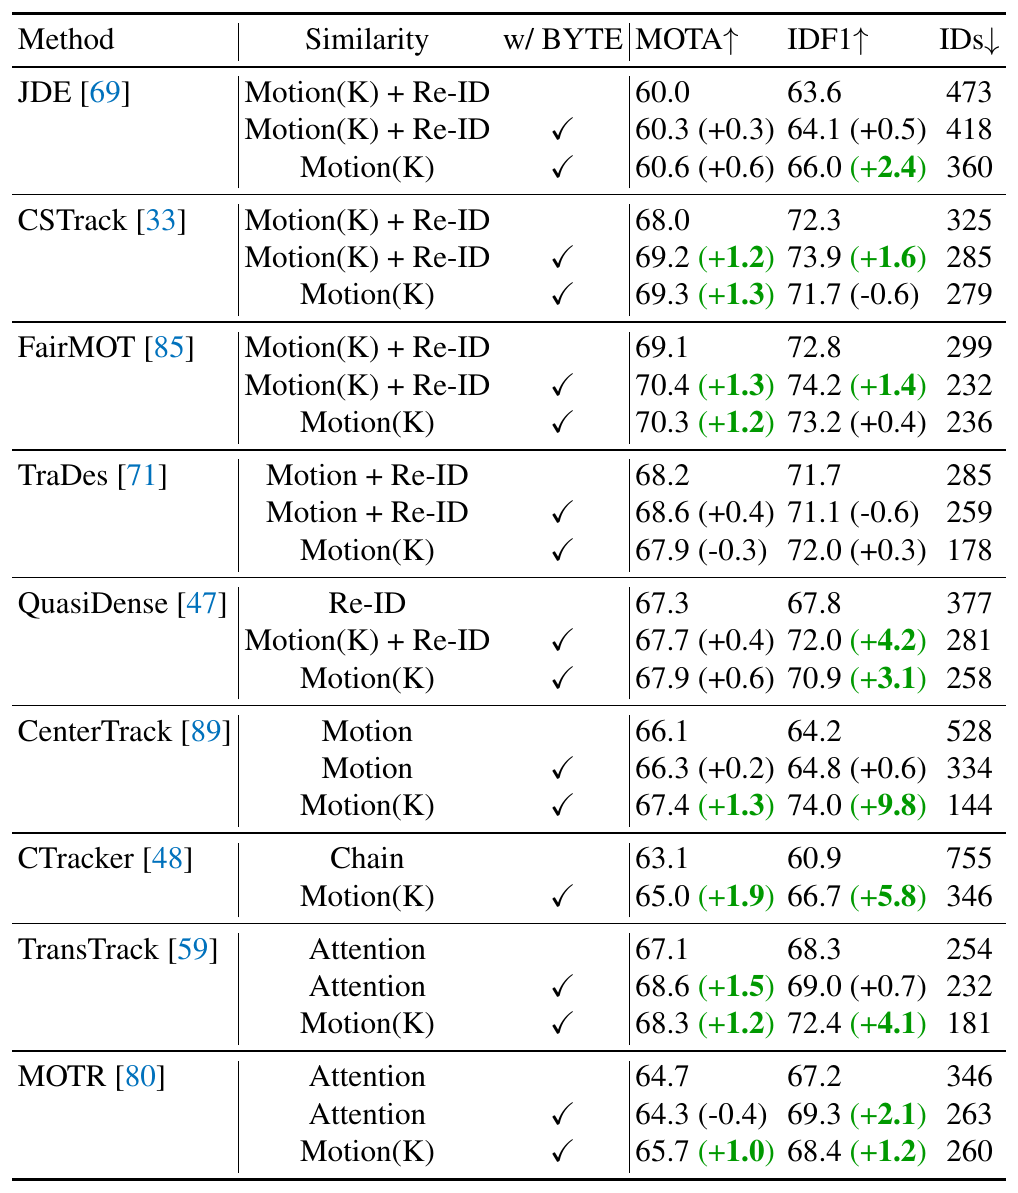
C'est le tableau le plus convaincant de l'article. Les auteurs appliquent BYTE à neuf traqueurs très variés : des méthodes mouvement plus re-ID comme JDE, CSTrack, FairMOT et TraDeS ; QDTrack, qui n'utilise que la re-ID ; CenterTrack, avec son mouvement appris ; Chained-Tracker, à structure en chaîne ; TransTrack et MOTR, qui transmettent les boîtes par attention.
Il y a deux façons de l'appliquer :
- Mode insertion : l'association d'origine se fait normalement, puis les trajectoires restées sans partenaire sont appariées une fois par IoU avec les boîtes à faible score.
- Mode remplacement : on ne garde que les boîtes de détection du traqueur, et toute l'association est remplacée par BYTE.
Presque tous les traqueurs progressent, sur presque toutes les métriques. Le cas le plus net est CenterTrack ; en mode remplacement, il gagne 1.3 point de MOTA et 9.8 points d'IDF1, et ses changements d'identité passent de 528 à 144. CenterTrack ne faisait qu'un appariement local, à partir des déplacements prédits vers l'image précédente, si bien qu'une personne cachée changeait d'identifiant dès que sa trajectoire se brisait ; le mécanisme de conservation des trajectoires perdues de BYTE comble justement ce manque.
Le progrès n'est pas universel pour autant. TraDeS perd 0.3 point de MOTA en mode remplacement ; MOTR perd 0.4 point de MOTA en mode insertion, mais gagne 2.1 points d'IDF1. Ce tableau compare des méthodes d'association avec un même détecteur, et l'apport de BYTE porte surtout sur IDF1 et les changements d'identité.
Classements
| Benchmark | MOTA | IDF1 | HOTA | ID switch | FPS |
|---|---|---|---|---|---|
| MOT17 | 80.3 | 77.3 | 63.1 | 2196 | 29.6 |
| MOT20 | 77.8 | 75.2 | 61.3 | 1223 | 17.5 |
D'après les lignes ByteTrack des Tables 4 et 5 de l'article.
Sur l'ensemble de test de MOT17, ByteTrack dépasse ReMOT, alors deuxième, de 3.3 points de MOTA, 5.3 d'IDF1 et 3.4 de HOTA, et c'est aussi le plus rapide du tableau. Les auteurs soulignent que ByteTrack est entraîné sur environ 29 000 images, moins que les 73 000 utilisées par de nombreuses méthodes.
MOT20, avec en moyenne 170 personnes par image de test, est bien plus encombré. D'après l'article, ByteTrack y fait passer le MOTA de 68.6 à 77.8 et les changements d'identité de 4209 à 1223, soit 71 % de moins. Sur HiEve, il obtient un MOTA de 61.7 et un IDF1 de 63.1 ; sur l'ensemble de test de BDD100K, il fait passer le mMOTA de 35.5 à 40.1. Il est premier sur les quatre benchmarks.
Il faut ici distinguer deux choses. La large avance de ByteTrack dans les classements vient pour une bonne part de YOLOX-X, un détecteur puissant ; l'apport de BYTE lui-même, à détecteur égal, se lit dans les deux séries d'ablations précédentes : face à SORT, 2 points de MOTA et 2.4 points d'IDF1 en plus ; greffé sur d'autres traqueurs, environ 1 à 2 points de MOTA et jusqu'à près de 10 points d'IDF1. L'annexe compare aussi avec de petits modèles YOLOX ; BYTE bat DeepSORT pour toutes les tailles de détecteur, et sur le plus petit, YOLOX-Nano, son MOTA est supérieur de 3 points.
La suite
ByteTrack est vite devenu le choix par défaut en ingénierie. Le module de suivi d'Ultralytics propose deux traqueurs, ByteTrack et BoT-SORT, et présente ByteTrack comme la référence la plus rapide et la plus simple ; OC-SORT et BoT-SORT reprennent directement les poids YOLOX de ByteTrack pour leurs comparaisons, ce qui revient à en faire le SORT de la nouvelle génération.
Ses faiblesses sont apparues tôt, elles aussi. L'article DanceTrack rapporte pour ByteTrack un HOTA de seulement 47.7, avec un AssA de 32.1. Les danseurs sont habillés de façon similaire et bougent de manière non linéaire ; l'appariement par filtre de Kalman et IoU ne tient pas le choc, et MOTR comme OC-SORT le battent sur ce jeu de données. Raccrocher les gens par leur seule position marche très bien quand ils avancent en ligne droite, beaucoup moins quand ils tournent sur eux-mêmes.
Conclusion
Les boîtes à faible score écartées par le seuil sont appariées une seconde fois avec les trajectoires restées sans partenaire au tour précédent, avec l'IoU pour seule similarité. La méthode de ByteTrack se résume à ce seul changement ; les changements d'identité de SORT baissent de près de moitié, neuf traqueurs différents progressent presque tous en l'adoptant, et avec YOLOX, ByteTrack prend la première place sur quatre benchmarks.
La prochaine fois que le réglage du seuil de détection d'un traqueur vous exaspère, essayez d'abord BYTE. Le seuil cesse d'être une ligne de vie ou de mort tranchée net ; il ne décide plus que de « qui est apparié en premier ».
Hegel n'aurait sans doute jamais imaginé se porter un jour garant des boîtes à faible score dans un article de suivi.