原始論文
The Llama 3 Herd of Models
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2407.21783
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformersllama32024,
  title = {{The Llama 3 Herd of Models}},
  author = {Aaron Grattafiori and Abhimanyu Dubey and Abhinav Jauhri and Abhinav Pandey and Abhishek Kadian and Ahmad Al-Dahle and Aiesha Letman and Akhil Mathur and Alan Schelten and Alex Vaughan and Amy Yang and Angela Fan and Anirudh Goyal and Anthony Hartshorn and Aobo Yang and Archi Mitra and Archie Sravankumar and Artem Korenev and Arthur Hinsvark and Arun Rao and Aston Zhang and Aurelien Rodriguez and Austen Gregerson and Ava Spataru and Baptiste Roziere and Bethany Biron and Binh Tang and Bobbie Chern and Charlotte Caucheteux and Chaya Nayak and Chloe Bi and Chris Marra and Chris McConnell and Christian Keller and Christophe Touret and Chunyang Wu and Corinne Wong and Cristian Canton Ferrer and Cyrus Nikolaidis and Damien Allonsius and Daniel Song and Danielle Pintz and Danny Livshits and Danny Wyatt and David Esiobu and Dhruv Choudhary and Dhruv Mahajan and Diego Garcia-Olano and Diego Perino and Dieuwke Hupkes and Egor Lakomkin and Ehab AlBadawy and Elina Lobanova and Emily Dinan and Eric Michael Smith and Filip Radenovic and Francisco Guzmán and Frank Zhang and Gabriel Synnaeve and Gabrielle Lee and Georgia Lewis Anderson and Govind Thattai and Graeme Nail and Gregoire Mialon and Guan Pang and Guillem Cucurell and Hailey Nguyen and Hannah Korevaar and Hu Xu and Hugo Touvron and Iliyan Zarov and Imanol Arrieta Ibarra and Isabel Kloumann and Ishan Misra and Ivan Evtimov and Jack Zhang and Jade Copet and Jaewon Lee and Jan Geffert and Jana Vranes and Jason Park and Jay Mahadeokar and Jeet Shah and Jelmer van der Linde and Jennifer Billock and Jenny Hong and Jenya Lee and Jeremy Fu and Jianfeng Chi and Jianyu Huang and Jiawen Liu and Jie Wang and Jiecao Yu and Joanna Bitton and Joe Spisak and Jongsoo Park and Joseph Rocca and Joshua Johnstun and Joshua Saxe and Junteng Jia and Kalyan Vasuden Alwala and Karthik Prasad and Kartikeya Upasani and Kate Plawiak and Ke Li and Kenneth Heafield and Kevin Stone and Khalid El-Arini and Krithika Iyer and Kshitiz Malik and Kuenley Chiu and Kunal Bhalla and Kushal Lakhotia and Lauren Rantala-Yeary and Laurens van der Maaten and Lawrence Chen and Liang Tan and Liz Jenkins and Louis Martin and Lovish Madaan and Lubo Malo and Lukas Blecher and Lukas Landzaat and Luke de Oliveira and Madeline Muzzi and Mahesh Pasupuleti and Mannat Singh and Manohar Paluri and Marcin Kardas and Maria Tsimpoukelli and Mathew Oldham and Mathieu Rita and Maya Pavlova and Melanie Kambadur and Mike Lewis and Min Si and Mitesh Kumar Singh and Mona Hassan and Naman Goyal and Narjes Torabi and Nikolay Bashlykov and Nikolay Bogoychev and Niladri Chatterji and Ning Zhang and Olivier Duchenne and Onur Çelebi and Patrick Alrassy and Pengchuan Zhang and Pengwei Li and Petar Vasic and Peter Weng and Prajjwal Bhargava and Pratik Dubal and Praveen Krishnan and Punit Singh Koura and Puxin Xu and Qing He and Qingxiao Dong and Ragavan Srinivasan and Raj Ganapathy and Ramon Calderer and Ricardo Silveira Cabral and Robert Stojnic and Roberta Raileanu and Rohan Maheswari and Rohit Girdhar and Rohit Patel and Romain Sauvestre and Ronnie Polidoro and Roshan Sumbaly and Ross Taylor and Ruan Silva and Rui Hou and Rui Wang and Saghar Hosseini and Sahana Chennabasappa and Sanjay Singh and Sean Bell and Seohyun Sonia Kim and Sergey Edunov and Shaoliang Nie and Sharan Narang and Sharath Raparthy and Sheng Shen and Shengye Wan and Shruti Bhosale and Shun Zhang and Simon Vandenhende and Soumya Batra and Spencer Whitman and Sten Sootla and Stephane Collot and Suchin Gururangan and Sydney Borodinsky and Tamar Herman and Tara Fowler and Tarek Sheasha and Thomas Georgiou and Thomas Scialom and Tobias Speckbacher and Todor Mihaylov and Tong Xiao and Ujjwal Karn and Vedanuj Goswami and Vibhor Gupta and Vignesh Ramanathan and Viktor Kerkez and Vincent Gonguet and Virginie Do and Vish Vogeti and Vítor Albiero and Vladan Petrovic and Weiwei Chu and Wenhan Xiong and Wenyin Fu and Whitney Meers and Xavier Martinet and Xiaodong Wang and Xiaofang Wang and Xiaoqing Ellen Tan and Xide Xia and Xinfeng Xie and Xuchao Jia and Xuewei Wang and Yaelle Goldschlag and Yashesh Gaur and Yasmine Babaei and Yi Wen and Yiwen Song and Yuchen Zhang and Yue Li and Yuning Mao and Zacharie Delpierre Coudert and Zheng Yan and Zhengxing Chen and Zoe Papakipos and Aaditya Singh and Aayushi Srivastava and Abha Jain and Adam Kelsey and Adam Shajnfeld and Adithya Gangidi and Adolfo Victoria and Ahuva Goldstand and Ajay Menon and Ajay Sharma and Alex Boesenberg and Alexei Baevski and Allie Feinstein and Amanda Kallet and Amit Sangani and Amos Teo and Anam Yunus and Andrei Lupu and Andres Alvarado and Andrew Caples and Andrew Gu and Andrew Ho and Andrew Poulton and Andrew Ryan and Ankit Ramchandani and Annie Dong and Annie Franco and Anuj Goyal and Aparajita Saraf and Arkabandhu Chowdhury and Ashley Gabriel and Ashwin Bharambe and Assaf Eisenman and Azadeh Yazdan and Beau James and Ben Maurer and Benjamin Leonhardi and Bernie Huang and Beth Loyd and Beto De Paola and Bhargavi Paranjape and Bing Liu and Bo Wu and Boyu Ni and Braden Hancock and Bram Wasti and Brandon Spence and Brani Stojkovic and Brian Gamido and Britt Montalvo and Carl Parker and Carly Burton and Catalina Mejia and Ce Liu and Changhan Wang and Changkyu Kim and Chao Zhou and Chester Hu and Ching-Hsiang Chu and Chris Cai and Chris Tindal and Christoph Feichtenhofer and Cynthia Gao and Damon Civin and Dana Beaty and Daniel Kreymer and Daniel Li and David Adkins and David Xu and Davide Testuggine and Delia David and Devi Parikh and Diana Liskovich and Didem Foss and Dingkang Wang and Duc Le and Dustin Holland and Edward Dowling and Eissa Jamil and Elaine Montgomery and Eleonora Presani and Emily Hahn and Emily Wood and Eric-Tuan Le and Erik Brinkman and Esteban Arcaute and Evan Dunbar and Evan Smothers and Fei Sun and Felix Kreuk and Feng Tian and Filippos Kokkinos and Firat Ozgenel and Francesco Caggioni and Frank Kanayet and Frank Seide and Gabriela Medina Florez and Gabriella Schwarz and Gada Badeer and Georgia Swee and Gil Halpern and Grant Herman and Grigory Sizov and Guangyi and Zhang and Guna Lakshminarayanan and Hakan Inan and Hamid Shojanazeri and Han Zou and Hannah Wang and Hanwen Zha and Haroun Habeeb and Harrison Rudolph and Helen Suk and Henry Aspegren and Hunter Goldman and Hongyuan Zhan and Ibrahim Damlaj and Igor Molybog and Igor Tufanov and Ilias Leontiadis and Irina-Elena Veliche and Itai Gat and Jake Weissman and James Geboski and James Kohli and Janice Lam and Japhet Asher and Jean-Baptiste Gaya and Jeff Marcus and Jeff Tang and Jennifer Chan and Jenny Zhen and Jeremy Reizenstein and Jeremy Teboul and Jessica Zhong and Jian Jin and Jingyi Yang and Joe Cummings and Jon Carvill and Jon Shepard and Jonathan McPhie and Jonathan Torres and Josh Ginsburg and Junjie Wang and Kai Wu and Kam Hou U and Karan Saxena and Kartikay Khandelwal and Katayoun Zand and Kathy Matosich and Kaushik Veeraraghavan and Kelly Michelena and Keqian Li and Kiran Jagadeesh and Kun Huang and Kunal Chawla and Kyle Huang and Lailin Chen and Lakshya Garg and Lavender A and Leandro Silva and Lee Bell and Lei Zhang and Liangpeng Guo and Licheng Yu and Liron Moshkovich and Luca Wehrstedt and Madian Khabsa and Manav Avalani and Manish Bhatt and Martynas Mankus and Matan Hasson and Matthew Lennie and Matthias Reso and Maxim Groshev and Maxim Naumov and Maya Lathi and Meghan Keneally and Miao Liu and Michael L. Seltzer and Michal Valko and Michelle Restrepo and Mihir Patel and Mik Vyatskov and Mikayel Samvelyan and Mike Clark and Mike Macey and Mike Wang and Miquel Jubert Hermoso and Mo Metanat and Mohammad Rastegari and Munish Bansal and Nandhini Santhanam and Natascha Parks and Natasha White and Navyata Bawa and Nayan Singhal and Nick Egebo and Nicolas Usunier and Nikhil Mehta and Nikolay Pavlovich Laptev and Ning Dong and Norman Cheng and Oleg Chernoguz and Olivia Hart and Omkar Salpekar and Ozlem Kalinli and Parkin Kent and Parth Parekh and Paul Saab and Pavan Balaji and Pedro Rittner and Philip Bontrager and Pierre Roux and Piotr Dollar and Polina Zvyagina and Prashant Ratanchandani and Pritish Yuvraj and Qian Liang and Rachad Alao and Rachel Rodriguez and Rafi Ayub and Raghotham Murthy and Raghu Nayani and Rahul Mitra and Rangaprabhu Parthasarathy and Raymond Li and Rebekkah Hogan and Robin Battey and Rocky Wang and Russ Howes and Ruty Rinott and Sachin Mehta and Sachin Siby and Sai Jayesh Bondu and Samyak Datta and Sara Chugh and Sara Hunt and Sargun Dhillon and Sasha Sidorov and Satadru Pan and Saurabh Mahajan and Saurabh Verma and Seiji Yamamoto and Sharadh Ramaswamy and Shaun Lindsay and Shaun Lindsay and Sheng Feng and Shenghao Lin and Shengxin Cindy Zha and Shishir Patil and Shiva Shankar and Shuqiang Zhang and Shuqiang Zhang and Sinong Wang and Sneha Agarwal and Soji Sajuyigbe and Soumith Chintala and Stephanie Max and Stephen Chen and Steve Kehoe and Steve Satterfield and Sudarshan Govindaprasad and Sumit Gupta and Summer Deng and Sungmin Cho and Sunny Virk and Suraj Subramanian and Sy Choudhury and Sydney Goldman and Tal Remez and Tamar Glaser and Tamara Best and Thilo Koehler and Thomas Robinson and Tianhe Li and Tianjun Zhang and Tim Matthews and Timothy Chou and Tzook Shaked and Varun Vontimitta and Victoria Ajayi and Victoria Montanez and Vijai Mohan and Vinay Satish Kumar and Vishal Mangla and Vlad Ionescu and Vlad Poenaru and Vlad Tiberiu Mihailescu and Vladimir Ivanov and Wei Li and Wenchen Wang and Wenwen Jiang and Wes Bouaziz and Will Constable and Xiaocheng Tang and Xiaojian Wu and Xiaolan Wang and Xilun Wu and Xinbo Gao and Yaniv Kleinman and Yanjun Chen and Ye Hu and Ye Jia and Ye Qi and Yenda Li and Yilin Zhang and Ying Zhang and Yossi Adi and Youngjin Nam and Yu and Wang and Yu Zhao and Yuchen Hao and Yundi Qian and Yunlu Li and Yuzi He and Zach Rait and Zachary DeVito and Zef Rosnbrick and Zhaoduo Wen and Zhenyu Yang and Zhiwei Zhao and Zhiyu Ma},
  year = {2024},
  eprint = {2407.21783},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2407.21783}
}
2024 年 7 月,Meta 公開了 Llama 3.1 系列的權重,最大的一個有 4,050 億個參數。
在那之前,能和 GPT-4 正面比較的模型都只能透過 API 使用。這次是第一次,一個在多數基準上和 GPT-4 打成平手的模型,權重可以直接下載。
隨著權重一起公開的,是一份九十多頁的技術報告。標題叫「Llama 3 模型群」(Herd of Models),涵蓋 8B、70B、405B 三種大小,從資料清理、縮放律、訓練基礎設施、後訓練到推論都寫了,最後還附上影像、影片、語音的延伸實驗。
這麼長的報告,很容易讀成一份清單。這篇筆記換一條讀法,跟著報告自己強調的一個原則走:讓開發流程保持簡單。Meta 為了這個原則放棄了一些更新潮的選擇,也在幾個關鍵位置用了一招很樸素的技巧,把好幾個模型平均起來。
定義問題
作者認為開發高品質的基礎模型有三個槓桿:資料、規模,以及管理複雜度。
前兩個很直觀。資料上,Llama 3 用了約 15T 個多語 token 預訓練,Llama 2 只有 1.8T。規模上,405B 的旗艦模型用了 FLOPs,大約是 Llama 2 最大版本的 50 倍。
第三個槓桿值得多看兩眼。作者在架構上選了標準的稠密 Transformer,沒有用混合專家(MoE);後訓練選了監督式微調(SFT)、拒絕取樣(rejection sampling)與 DPO 的組合,沒有用 PPO 這類強化學習。理由都一樣,訓練穩定、容易擴大規模。
我們先驗算一下規模。訓練一個稠密 Transformer 的計算量常用 估計, 是參數量, 是訓練 token 數:
和報告寫的 一致。如果全程都用 16,384 張 H100、每張實際跑到 400 TFLOPs,純計算時間大約是 秒,也就是 67 天左右。這只是粗估,實際訓練前期用的 GPU 比較少,還有各種中斷。
要在一萬多張 GPU 上連續穩定地跑兩個多月,每一個「多一點複雜度」的選擇,都可能變成一次訓練中斷。這就是整份報告的背景。
解決問題
資料:清理比數量更花工夫
預訓練資料的知識截止在 2023 年底,大部分來自網頁。清理流程包括以下幾步:
- 自己寫 HTML 解析器。數學與程式內容會保留結構,數學式常以圖片呈現、公式寫在 alt 屬性裡,所以 alt 文字也保留。另外,作者發現對以網頁資料為主的模型,Markdown 標記反而有害,因此全部移除。
- 三層去重。URL 層級保留最新版本;文件層級用 MinHash 去除近似重複;行層級則很激進,在每 3,000 萬份文件裡出現超過 6 次的行全部刪除。作者坦言這也刪掉了一些高品質的常見文字,但評測上明顯有幫助。
- 模型做品質過濾。用 fastText 判斷一段文字「會不會被維基百科引用」,再用 Llama 2 標註的資料訓練 DistilRoberta 打品質分數;程式與數學另有專門的分類器與抽取流程。多語資料先用語言辨識分成 176 種語言,再各自去重、過濾。
最後的資料配比大約是一般知識 50%、數學與推理 25%、程式 17%、多語 8%。
配比是用縮放律實驗決定的,先在小模型上試不同配比,再預測大模型的表現。對於小型的領域資料集,作者用一個更便宜的方法評估價值。拿一個訓練到一半的 8B 模型,用 40B token 把學習率線性退火到 0,退火資料裡新資料集佔 30%,看分數變化。這比每個小資料集都跑一次縮放律實驗划算得多。
規模:縮放律要能預測考試分數
一般的縮放律預測的是下一個 token 的損失,但大家真正關心的是基準分數。作者用了兩步:
- 先擬合「計算量」與「下游任務正確答案的負對數似然(NLL)」之間的關係,用的是計算量在 到 FLOPs 之間、40M 到 16B 參數的小模型。
- 再擬合「NLL」與「準確率」之間的 S 形關係。這一步加入了 Llama 2 系列模型,因為它們用的計算量比小模型大得多。
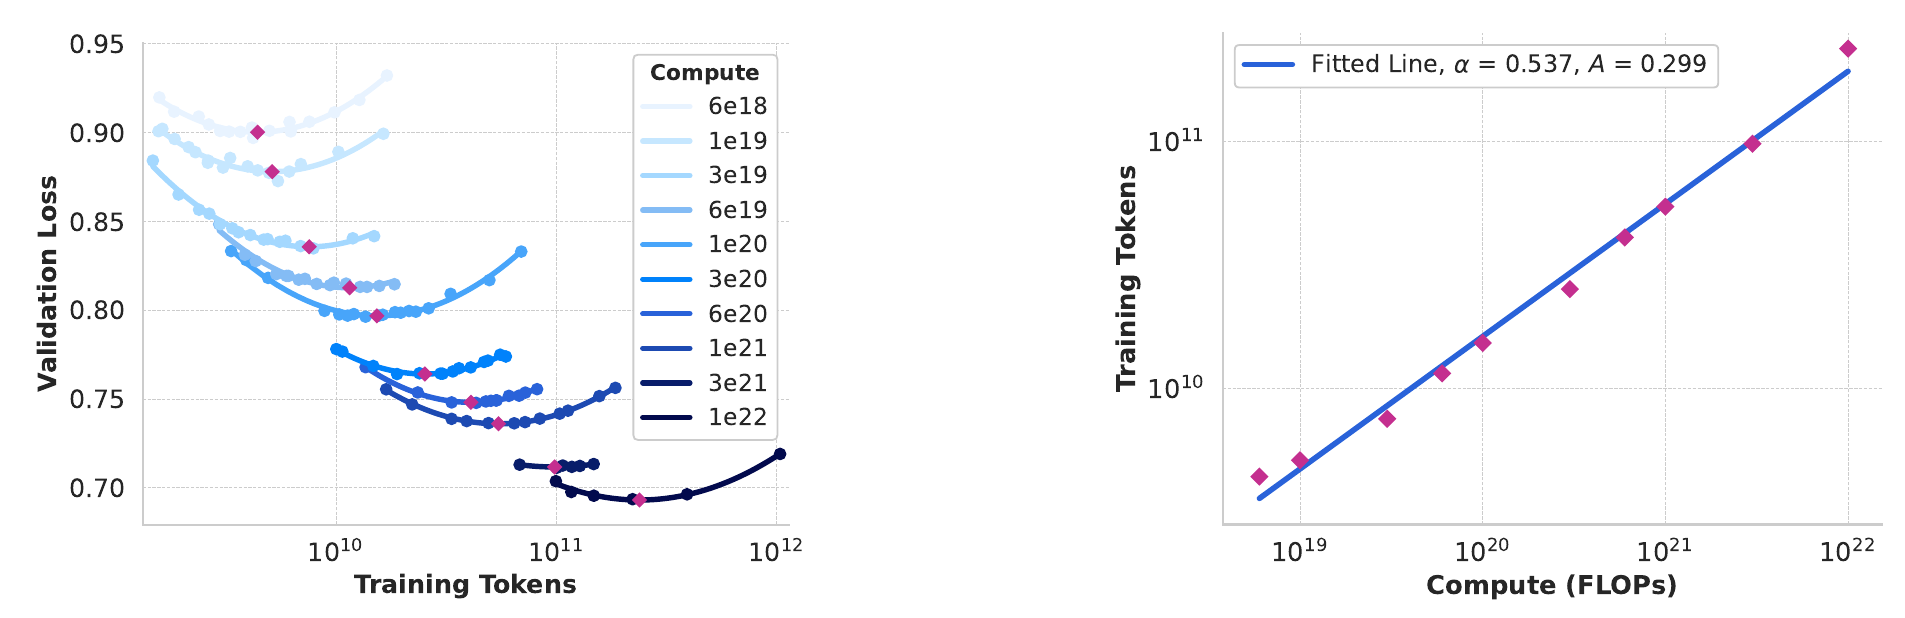
左圖每條曲線是一個固定的計算預算。同樣的預算,模型小一點就能看更多 token,模型大一點就只能看少一點;曲線的最低點就是那個預算下最好的分配。右圖把各個最低點連起來,最佳訓練 token 數 和計算量 呈冪次關係:
報告外推到 FLOPs,得到「402B 參數、16.55T token」的建議。這裡有個小細節值得自己算一次。用圖上的 、 代入,得到約 16.3T token,和報告的數字接近;但正文把參數寫成只取兩位小數的 ,代入會得到約 10.5T。指數只差 0.007,外推四個數量級之後就差了五成,縮放律的外推就是這麼敏感。
作者也觀察到,計算預算越大,IsoFLOPs 曲線的底部越平坦,模型大小稍微偏離最佳值影響不大,所以最後選了 405B。下游預測的效果也不錯,在 ARC Challenge 上,這個兩步驟的方法外推了四個數量級,只略微低估了最終成績。
架構:幾乎沒變
Llama 3 的架構和 Llama 2 差不多,作者明說表現的進步主要來自資料與規模。改動只有四處:
- 分組查詢注意力(GQA):8 個 key-value 頭,減少推論時的 KV 快取。
- 文件遮罩:同一個序列裡拼接了不同文件時,禁止它們互相注意。一般預訓練影響不大,但在很長的序列上繼續預訓練時很重要。
- 128K 詞彙表:tiktoken 的 100K token 加上 28K 個非英語 token。英文的壓縮率從每個 token 3.17 個字元提升到 3.94,同樣的計算量可以「讀」更多文字。
- RoPE 基頻提高到 500,000:支援更長的上下文。
405B 的配置是 126 層、隱藏維度 16,384、128 個注意力頭。
基礎設施:一萬六千張 GPU 的日常
405B 最多同時用了 16K 張 H100。模型用 4D 平行切分:張量平行、管線平行、上下文平行與資料平行(FSDP)。在 8K 張 GPU、序列長度 8K 時,BF16 的模型 FLOPs 使用率(MFU)約 43%;擴到 16K 張是 41%;長上下文階段的 131K 序列長度下是 38%。
報告最有現場感的是一份故障統計。在 54 天的觀察期間,訓練一共中斷了 466 次,其中 47 次是計畫內的維護,419 次是非預期的;非預期中斷裡約 78% 確認或疑似是硬體問題,最常見的是 GPU 本身與 HBM3 記憶體。即使如此,有效訓練時間仍超過 90%。
這解釋了為什麼作者那麼在意穩定性。同步訓練下,一張 GPU 出事就可能讓整個作業重來。
預訓練配方:三個階段
- 初始預訓練:AdamW,峰值學習率 ,暖身 8,000 步,cosine 衰減到 。批次一開始較小以求穩定,4M token、序列長度 4,096;訓練到 252M token 時加倍到 8M token、序列長度 8,192;到 2.87T token 時再加倍到 16M。作者說這個配方很穩定,幾乎沒有損失暴衝。過程中也調整過資料配比,例如增加非英語資料、上採樣數學資料、加入較新的網頁資料。
- 長上下文預訓練:上下文從 8K 分六個階段逐步拉到 128K,總共約 800B token。每個階段都要確認短上下文的表現完全恢復,且「大海撈針」測試在該長度下全對,才進入下一階段。
- 退火:最後 4,000 萬個 token 把學習率線性降到 0,同時上採樣高品質資料,並把退火期間的 checkpoint 取平均,作為最終的預訓練模型。
第三點就是本筆記在意的第一個「平均」。報告只寫了一句,引用的是 Polyak 平均,沒有交代取了幾個 checkpoint、帶來多少提升。
後訓練:六輪的 SFT 加 DPO
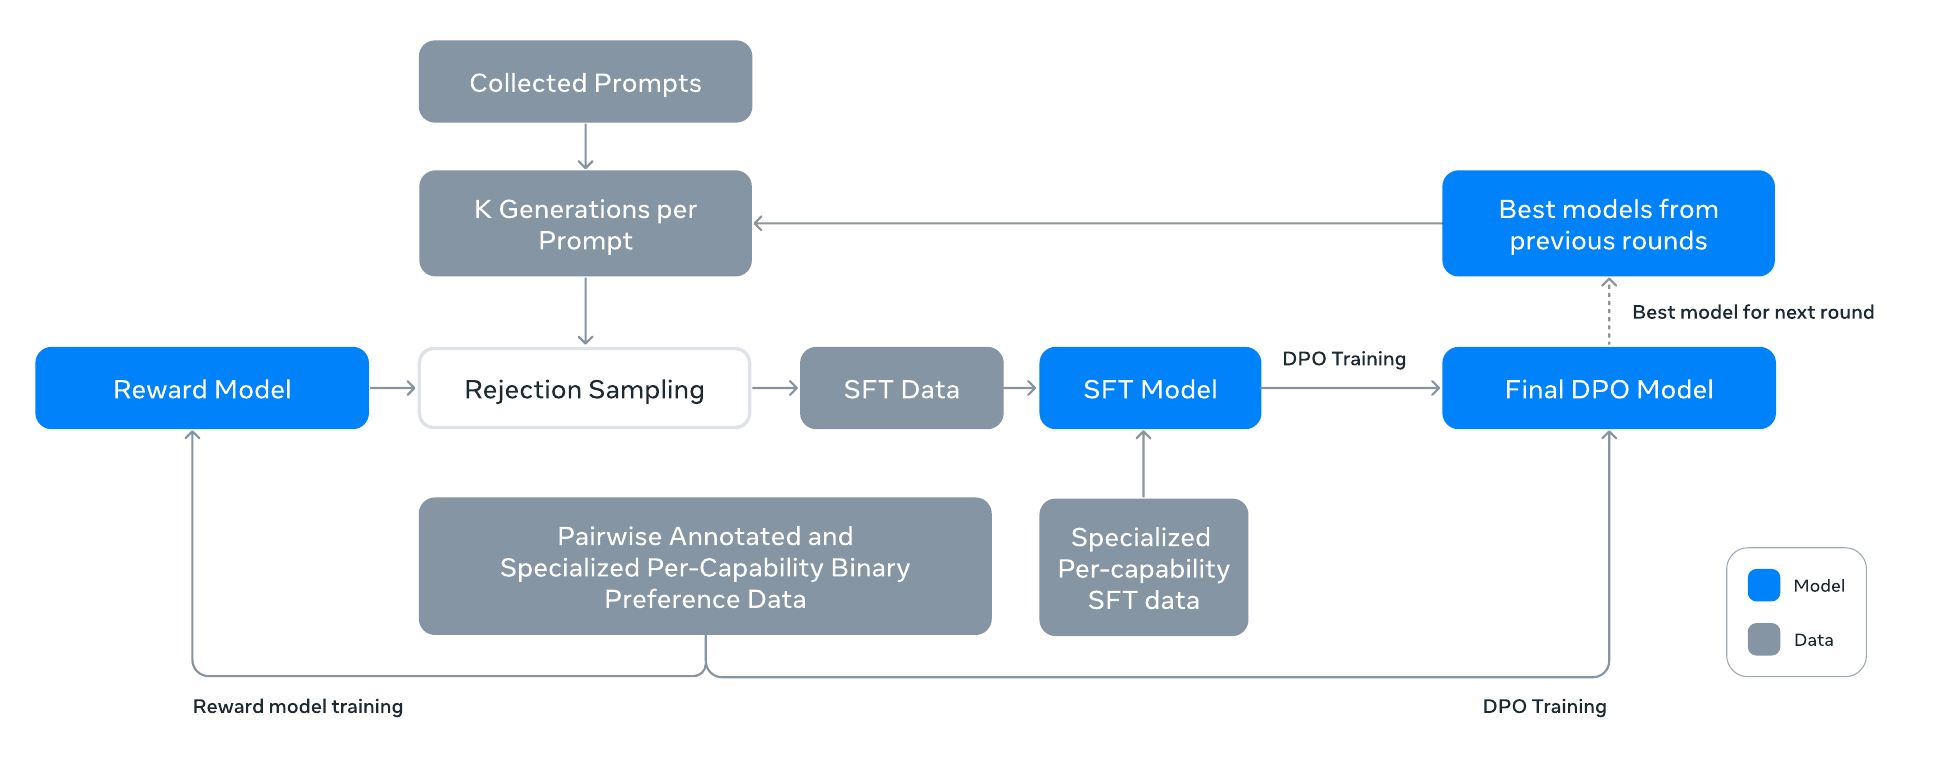
這張圖要從左往右看,再沿著上方的箭頭繞回來。
先用人工標註的偏好資料訓練獎勵模型。標註者除了選出比較好的回答,有時還會再把它改得更好,所以一筆資料可能有「修改後 > 選中 > 未選中」三個等級。接著對每個提示詞,從上一輪最好的模型取樣 10 到 30 個回答,由獎勵模型挑出最好的一個,這就是拒絕取樣,挑出來的回答成為 SFT 的訓練資料。
SFT 的學習率是 ,訓練 8,500 到 9,000 步。之後做 DPO,學習率 、,並做了兩個修改:
- 不計算格式 token 的損失。對話的起始與結束標記在好、壞兩個回答裡都會出現,DPO 同時要提高與降低它們的機率,作者發現這會造成重複輸出或突然結束。
- 加上 NLL 正則項,係數 0.2,避免被選中回答的機率一路下降。
作者也試過 PPO,但 DPO 在大模型上更省計算,在 IFEval 這類指令遵循的評測上表現也更好。
整個流程重複六輪,每一輪都用新收集的標註,以及最新模型生成的合成資料。
然後是第二個「平均」。在獎勵模型、SFT、DPO 每一個階段,作者都把用不同資料版本或超參數訓練出來的模型平均起來,引用的正是 SWA 與 Model Soups。同樣,報告沒有給出消融結果。
能力:專家分支與執行回饋
後訓練資料大部分是模型生成的,品質控制也就成了重點。作者用 Llama 3 8B 做主題分類,用獎勵模型分數與 Llama 自評兩種訊號估品質,再估難度,最後在語意聚類中去重,優先保留品質高、難度高的樣本。
各項能力還有專門的做法,兩個最有代表性:
程式。作者從預訓練主線分出一條支線,用超過 85% 是程式的 1T token 繼續預訓練,得到一個程式專家,專門用來產生程式相關的高品質資料。合成資料總共超過 270 萬筆。
最有意思的發現是,8B 和 70B 用 405B 生成的資料訓練有明顯進步,但 405B 用自己生成的資料訓練沒有幫助,甚至會變差。作者的解法是引入執行回饋:生成的程式要通過語法檢查、靜態分析與模型自己寫的單元測試,失敗就把錯誤訊息丟回去要求修正,只有全部通過的對話才進入訓練資料。大約 20% 的解答一開始是錯的,後來自行修正成功。
長上下文。只用短資料做 SFT,預訓練學到的長上下文能力會明顯退化。但人工標註長文件幾乎不可行,所以改用合成資料,包括長文件問答、階層式摘要、找出被刪掉的程式檔案。消融發現,只要把 0.1% 的長上下文合成資料混進 SFT 就夠了。
討論
成績
後訓練後的 405B,在報告的 Table 2 裡大致和當時最強的閉源模型同級:
| 基準 | Llama 3 405B | GPT-4o | Claude 3.5 Sonnet |
|---|---|---|---|
| MMLU(5-shot) | 87.3 | 89.1 | 89.9 |
| MMLU-Pro(5-shot,CoT) | 73.3 | 74.0 | 77.0 |
| HumanEval(0-shot) | 89.0 | 90.2 | 92.0 |
| GSM8K(8-shot,CoT) | 96.8 | 96.1 | 96.4 |
| MATH(0-shot,CoT) | 73.8 | 76.6 | 71.1 |
| GPQA(0-shot,CoT) | 51.1 | 53.6 | 59.4 |
多數項目差距在幾分之內,GSM8K 與 IFEval 略勝,GPQA 明顯落後。
人工評測的結論也類似。和 GPT-4(0125 版)大致打平;對 GPT-4o 與 Claude 3.5 Sonnet 則有輸有贏,程式與推理落後 Claude 3.5 Sonnet。作者也提醒,人工評測很受語氣、結構、長度這些細節影響。
推論:一台機器裝不下
405B 以 BF16 存放,一台 8 張 H100 的機器裝不下,只能跨兩台做管線平行。作者因此做了 FP8 量化。被量化的是前饋網路裡大部分的權重與激活值,這部分約佔推論計算時間的一半;注意力層不量化,第一層與最後一層 Transformer 也不量化。
這部分有一個很實用的觀察。標準評測顯示 FP8 和 BF16 差不多,但作者發現,如果不限制動態縮放因子的上限,模型偶爾會產生亂碼回答,評測卻看不出來。他們改用 10 萬個回答的獎勵模型分數分布來比較兩者,並把縮放因子上限設為 1200、改成逐列量化。FP8 在預填階段的吞吐量最多提升 50%。
多模態只是實驗
影像、影片與語音的能力,是在凍結的語言模型旁接上編碼器與轉接器:影像透過交叉注意力層接進來,語音則轉成 token 表示直接輸入。報告寫的時候這些模型還在開發中,沒有隨 3.1 版釋出。
視覺部分的後訓練,又出現了第三個「平均」,而且這次報告寫得比較具體。影像 SFT 的做法仿照 Model Soups:先用不同的資料子集、學習率、權重衰減做一輪超參數搜尋,依表現排序,再把前 名的權重平均; 本身也靠評估平均後的模型來決定。作者說,平均後的模型一致地比格狀搜尋找到的最佳單一模型好,對超參數也比較不敏感。視覺的 DPO 則不再固定參考模型,而是每隔 步用指數移動平均更新它,人工評測的表現更好。
報告裡少見的一段
結論裡有一段在技術報告中很少見。作者說,除了技術問題,組織上的決定也很關鍵。例如預訓練資料由另一個團隊負責取得與處理,這個團隊被明確要求避免資料受到基準測試污染;人工評測也只開放給少數不參與模型開發的研究者執行與查看。
讀這份報告要記得的事
這份報告寫了大量「我們做了什麼」,但很多決定沒有附上消融。為什麼不用 MoE、checkpoint 平均與模型平均各帶來多少提升,報告都只給了結論或一句話。預訓練資料的來源與內容也沒有公開,第三方無法重現。
從模型合併的角度看,這份報告的意義在於它說明了「平均」已經是大型實驗室的標準工序,預訓練退火時平均 checkpoint,後訓練每個階段平均不同設定的模型,視覺轉接器的 SFT 也平均前幾名的模型。只是怎麼平均、平均了多少,留給了後來的論文去回答。
結論
Llama 3 走的是更多、更乾淨的資料,更大的規模,以及刻意保持簡單的架構與後訓練。它證明了一個不用 MoE、不用 PPO 的模型,只要資料與規模到位,也能和當時最好的閉源模型並肩。
報告裡也留下不少實用的細節。用退火評估小資料集、405B 不能只吃自己生成的資料、長上下文只需要 0.1% 的合成資料、FP8 量化要看獎勵分數的分布而不是只看基準分數。
至於那段關於組織的提醒,一年後顯得特別有分量。2025 年 4 月 Llama 4 發布時,LMArena 上的高名次來自一個特別為對話調整過的實驗版本,LMArena 隨後表示 Meta 對規則的解讀不符合他們對模型提供者的期待,並更新了排行榜政策。技術報告寫得再仔細,評測的可信度還是要靠組織守住。