原始論文
Tulu 3: Pushing Frontiers in Open Language Model Post-Training
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2411.15124
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerstulu32024,
  title = {{Tulu 3: Pushing Frontiers in Open Language Model Post-Training}},
  author = {Nathan Lambert and Jacob Morrison and Valentina Pyatkin and Shengyi Huang and Hamish Ivison and Faeze Brahman and Lester James V. Miranda and Alisa Liu and Nouha Dziri and Shane Lyu and Yuling Gu and Saumya Malik and Victoria Graf and Jena D. Hwang and Jiangjiang Yang and Ronan Le Bras and Oyvind Tafjord and Chris Wilhelm and Luca Soldaini and Noah A. Smith and Yizhong Wang and Pradeep Dasigi and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2411.15124},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2411.15124}
}
預訓練模型的權重越來越常公開,後訓練卻多半是一團霧。
Llama 3 的技術報告寫了 SFT、拒絕取樣、DPO 跑了六輪,但用了什麼資料、怎麼篩,外人看不到。Tülu 3 報告的註腳提到一個統計,2024 年 11 月時,LMSYS Chatbot Arena 排名前 50 的模型,沒有一個公開了後訓練資料。
開源社群自己的後訓練配方,例如 Tülu 2 和 Zephyr-β,在聊天類評測上還行,但在數學(MATH、GSM8K)和精確的指令遵循(IFEval)上明顯落後。
艾倫人工智慧研究所(AI2)與華盛頓大學的 Lambert 等人在 2024 年 11 月發表 Tülu 3,想把這一段補起來。Tülu 是單峰駱駝與雙峰駱駝的混種,作者把這個名字沿用到第三代。這次除了模型權重,連訓練資料、資料生成流程、訓練程式碼、評測工具與中間 checkpoint 都一起公開。
這篇筆記跟著它的三段式配方走:SFT、DPO,以及作者新提出的 RLVR。
定義問題
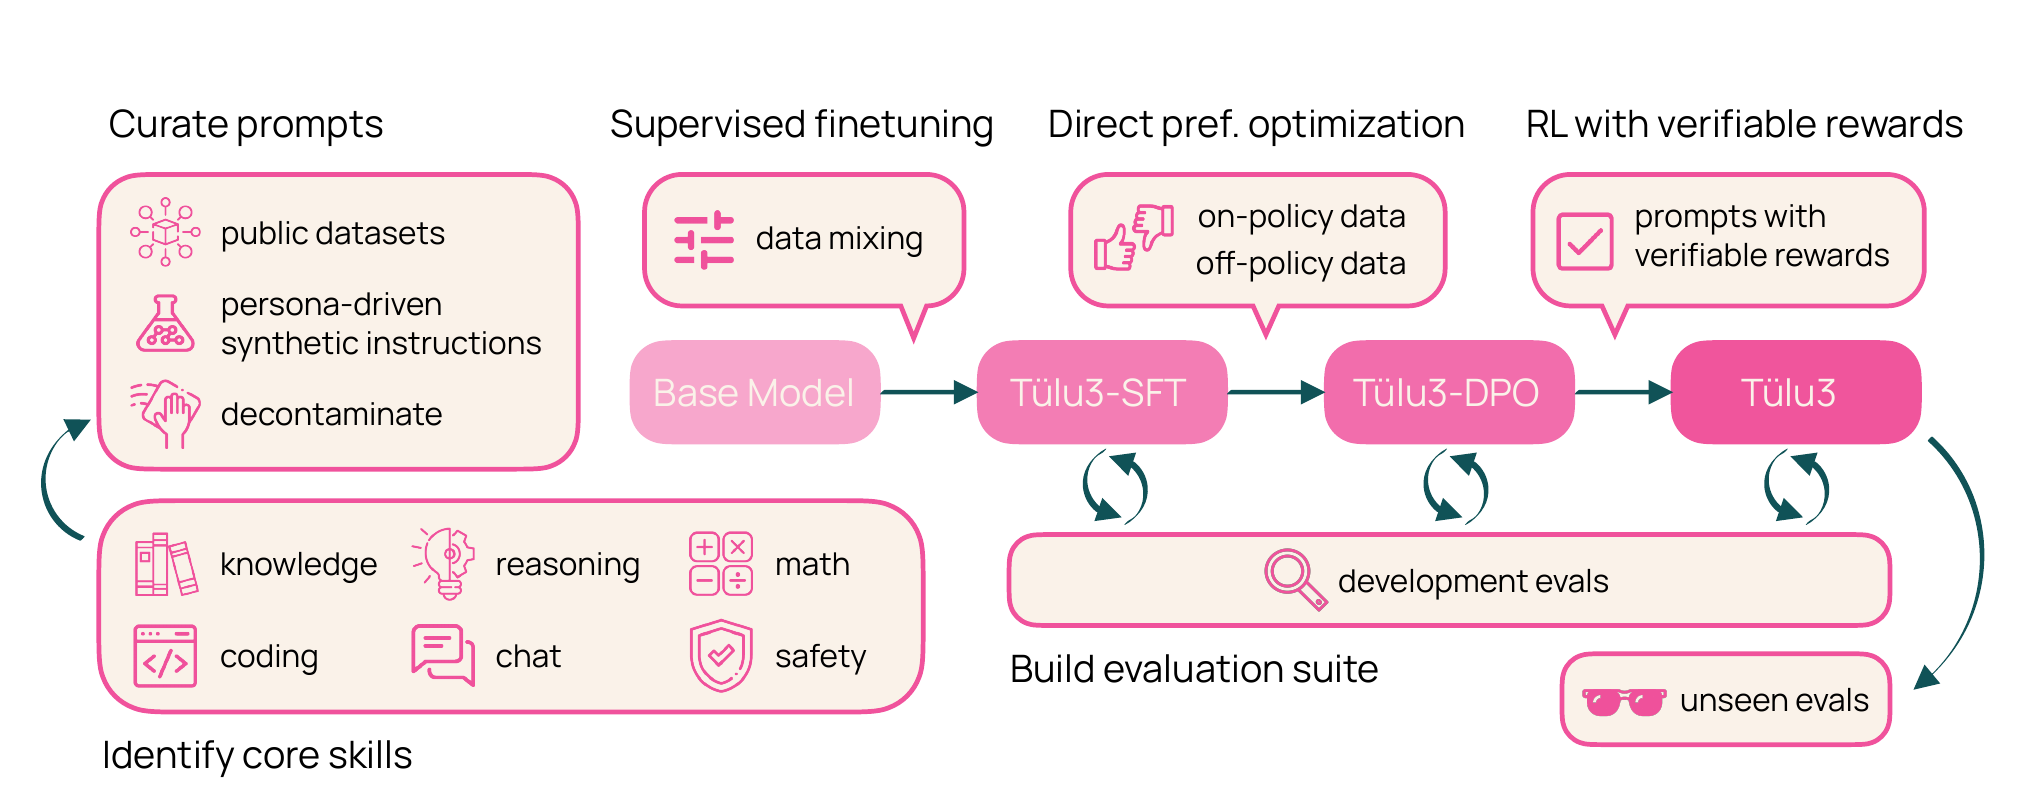
這張圖要從左下角開始看。作者先定出一組要加強的核心能力:知識、推理、數學、程式、指令遵循與聊天、安全。每項能力都對應幾個評測。
評測分成兩組。開發組在整個研發過程中反覆使用,用來挑資料、調超參數;未見組只在最後評估一次,用來確認模型沒有過度貼合開發組。例如知識類的開發評測是 MMLU、PopQA、TruthfulQA,未見評測是 MMLU-Pro 與 GPQA;指令遵循的開發評測是 IFEval 與 AlpacaEval 2,未見評測是 IFEval-OOD 與 HREF。
基底模型是 Llama 3.1 的 8B 與 70B,後來又補上 405B。整個配方要回答的是,只用公開或可公開的資料,能不能做出和 Llama 3.1 Instruct 同級、甚至更好的後訓練模型?
解決問題
資料:先把考題撈出來
提示詞的來源有兩類。一類是現成的公開資料集,例如 WildChat 的真實使用者對話;另一類是合成的。合成資料用了一個有意思的方法,先準備大量「人物設定」(persona),再請 GPT-4o 扮演這些人去出題,用來增加題目的多樣性。數學與程式各合成了約 22 萬與 3.5 萬筆。
公開資料集最大的風險,是裡面混著評測的考題。作者為此做了一套去污染流程:
- 只比對提示詞。訓練資料的回答常常是重新生成的,比對回答沒有意義。
- 用 8-gram 比對。對評測中的每個 token,只要它所在的某個 8-gram 也出現在某筆訓練資料裡,就算這個 token 被匹配到。如果一題評測裡超過 50% 的 token 都和同一筆訓練資料匹配,就認定兩者重疊。作者試過全字串比對與嵌入向量比對,前者太嚴,後者很難區分「改寫」和「只是主題相似」,8-gram 能抓到「只換了數字的數學題」這類情況。
- 整個資料集是否保留。某個訓練資料集只要和任何一個評測有超過 2% 的題目重疊,就算受污染。和未見組重疊的,整個資料集刪掉;和開發組重疊的,若刪掉整個資料集不影響表現就整個刪,否則只刪重疊的那些。
這套流程真的抓到不少東西。例如常用的 NuminaMath-TIR 數學資料,有 11.3% 的題目和 MATH 評測重疊,被刪除後重新發布。
SFT:資料配比與一個損失函數的陷阱
SFT 的重點是配比。作者從 Tülu 2 的配比出發,一輪輪加入新資料、做消融,再經過幾輪去污染,得到最終的 Tülu 3 SFT 配比。去污染會讓開發組的分數小幅下降,這是預期中的代價。
訓練設定是 2 個 epoch、批次 128、最長 4,096 個 token;8B 的學習率 ,70B 是 。8B 在 32 張 GPU 上訓練 6 小時,70B 在 64 張 GPU 上訓練 50 小時。
這一節有兩個和模型合併相關、也和實作相關的發現。
Model Soups 沒有贏過最好的單一模型。 作者用不同的隨機種子訓練多個 SFT 模型,再用 MergeKit 做線性平均。8B 的五個種子,平均分數在 59.8 到 60.1 之間,最好的 soup(兩個種子平均)是 60.2;70B 的三個種子是 71.8、70.0、72.6,最好的 soup 是 72.5。種子之間的差距不小,70B 差了 2.6 分,但 soup 並沒有穩定勝過最好的種子。作者最後直接用最好的單一 SFT 模型。
這和 Model Soups 在影像分類上的結論不同,也和 Llama 3、Gemma 2 把平均寫進正式流程的做法不同。可能的原因是這裡只平均了不同種子,沒有平均不同的資料或超參數,模型之間的差異太小;但論文沒有進一步分析。
損失的平均方式會偷偷改變權重。 訓練初期,作者發現同一份資料在自己的框架和 TPU 上訓練出來的模型表現不同。追到最後,是 Transformers 函式庫在梯度累積時計算損失的方式有問題。
用一個例子算一次。一個批次有兩筆資料,第一筆有 10 個有效 token,總損失 20;第二筆有 90 個有效 token,總損失 90。
- 兩筆一起送進前向傳播,函式庫把全部有效 token 一起平均,。每個 token 權重相同。
- 用梯度累積分兩次送,每次各自平均再取平均,。每筆樣本權重相同,短樣本的 token 被放大了 9 倍。
只是改了梯度累積的步數,訓練目標就跟著變了。作者的解法是改用加總損失,不再除以 token 數,並重新調整學習率;這等於讓每個 token 的權重都相同,實驗中也表現較好。這個問題在 2024 年秋天被社群廣泛討論,論文引用了 Unsloth 等人的說明。
偏好微調:on-policy 資料與長度正規化的 DPO
偏好資料的生成,改良自 UltraFeedback 的流程:
- 選提示詞,包括 SFT 用過的、同來源但 SFT 沒用的,以及新的提示詞。
- 從 22 個模型組成的模型池裡隨機挑四個各自回答。這是 off-policy 資料。另外加入 Tülu 3 SFT 模型自己的回答,這是 on-policy 資料,讓偏好資料更貼近正在訓練的模型會產生的輸出。
- 請 GPT-4o 從有用性、指令遵循、真實性、誠實四個面向,各給 1 到 5 分。平均分最高的回答當作「選中」,再從分數較低的回答中隨機挑一個當作「未選中」。
消融階段,8B 用了 96,911 筆 off-policy 與 19,444 筆 on-policy 資料;最終的偏好資料超過 27 萬筆。作者也發現,偏好資料中不重複提示詞的數量越多,表現越好,單純重複使用同樣的提示詞效果有限。
演算法上,作者比較了 DPO、SimPO、PPO 等方法,最後選擇長度正規化的 DPO:
和原本的 DPO 只差在把兩個對數機率比各自除以回答的長度 、。人類和模型評審都偏好長回答,不做正規化時,模型很容易學到「寫長一點就好」。作者選它,也是因為它比 PPO 簡單、跑得快,方便反覆調整資料配比。
RLVR:答對才給分
第三階段是作者提出的 RLVR(Reinforcement Learning with Verifiable Rewards,具可驗證獎勵的強化學習)。
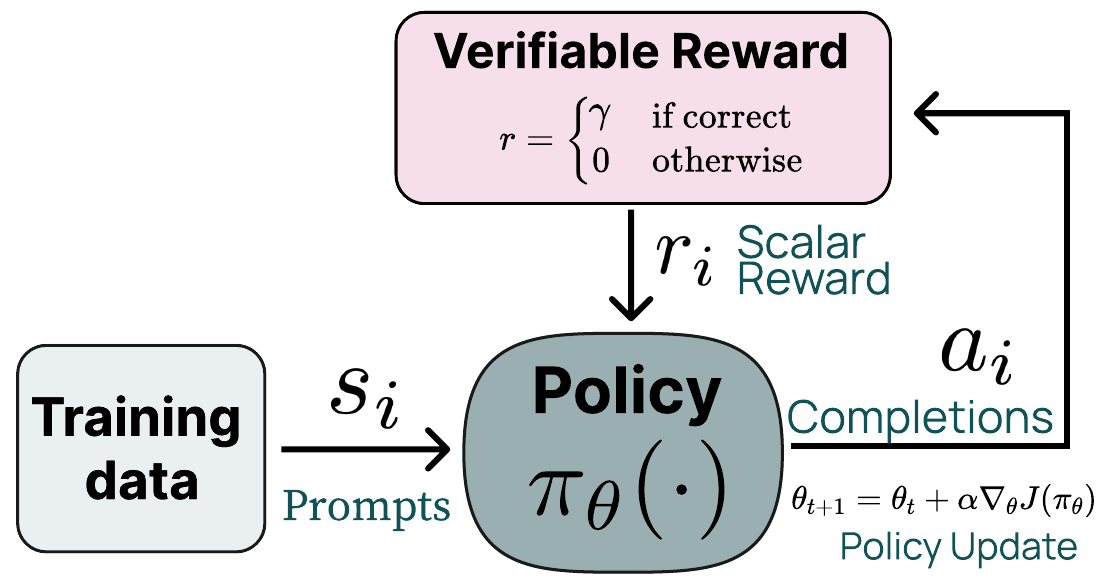
一般的 RLHF 用獎勵模型打分。RLVR 把獎勵模型換成一個確定性的檢查函數:
正文裡的獎勵寫作 ,圖上寫成 ,指的是同一個值,作者根據初步實驗設為 10,沒有再調。
檢查函數只用在三種容易驗證的任務上:GSM8K 與 MATH 的訓練集,抽出最後的答案和標準答案比對;以及從 Tülu 2 的 SFT 資料抽出指令、加上 IFEval 式的格式限制(例如「回答不超過 100 字」),用程式檢查是否遵守。總共約 3 萬個提示詞。
最佳化用 PPO,作者也列了幾個讓 PPO 穩定的實作細節:價值模型從一般的獎勵模型初始化、訓練時關掉 dropout、回答沒有正常結束就扣 10 分、優勢值做標準化。基礎設施上,生成回答用專門的 GPU 跑 vLLM,訓練用另一批 GPU,兩者非同步進行,策略總是用倒數第二新的生成資料訓練,在效率與可重現性之間取得平衡。
討論
RLVR 帶來多少提升
從最好的 DPO 模型開始做 RLVR,論文 Table 23 的結果:
| 8B DPO | 8B RLVR | 70B DPO | 70B RLVR | |
|---|---|---|---|---|
| 平均 | 64.4 | 64.8 | 75.9 | 76.0 |
| MATH | 42.0 | 43.7 | 62.3 | 63.0 |
| GSM8K | 84.3 | 87.6 | 93.5 | 93.5 |
| IFEval | 81.1 | 82.4 | 82.6 | 83.2 |
| 安全 | 87.2 | 85.5 | 89.0 | 88.3 |
8B 上三個目標任務都有進步,GSM8K 多了 3.3 分;但安全分數掉了 1.7 分,整體平均只多 0.4。70B 的提升更小,GSM8K 已經接近飽和。作者也坦白說,有些 8B 的實驗可以把 GSM8K 拉到 89.4、IFEval 拉到 84.8,但其他指標會變差,整體平均反而下降。
訓練曲線顯示,RLVR 確實能讓訓練集上的正確率持續上升,但 KL 散度越大,平均分數往往越低。也就是說,模型離起點越遠,過度最佳化的風險越高。
405B 的做法不太一樣。GSM8K 在 SFT 與 DPO 後已經飽和,IFEval 的資料在初期實驗中也幫助不大,所以只用 MATH 訓練集。只跑 25 步,MATH 就提升了超過 5 分;因為算力限制只跑到 75 步,曲線還沒飽和。405B 用 256 張 GPU,16 張跑 vLLM 生成,240 張訓練;每一輪生成約 550 秒、同步權重約 25 秒、訓練約 1,500 秒。為了省算力,價值模型只用了 8B。
整體成績
在作者整理的評測組合上,Tülu 3 8B 的平均分數是 65.1,高於 Llama 3.1 8B Instruct 的 62.9,但略低於 Qwen 2.5 7B Instruct 的 66.5;Tülu 3 70B 是 76.2,高於 Llama 3.1 70B Instruct 的 74.1、Qwen 2.5 72B Instruct 的 72.8,也高於 GPT-4o mini 的 69.6 與 Claude 3.5 Haiku 的 75.3。405B 版本不計安全項目的平均是 80.0,DeepSeek-V3 是 79.0,GPT-4o 是 80.5,落在同一個區間。
要注意,這些評測大多是作者自己挑的開發組,也是整個研發過程反覆優化的目標;未見組的設計就是為了對沖這個風險。
沒成功的嘗試
作者專門寫了一節「沒有結果的嘗試」,這在技術報告裡不常見:
- Online DPO:每一步從目前的策略取樣兩個回答,用獎勵模型標出偏好再更新。在數學上 GSM8K 幾乎沒有進步,MATH 反而退步。
- 拒絕取樣:Llama 3 用得很重的方法,在這裡投入的算力換到的提升很有限。作者觀察到,評審模型要夠強才挑得出好回答,而把原本的回答也放進候選,效果比只從新生成的回答中挑好得多。
限制
訓練資料以短對話為主,平均只有 2.4 輪,多數樣本不到 2,048 個 token,長上下文與多輪對話是明確的缺口。偏好資料與部分合成資料由 GPT-4o 生成或評分,「完全開源」指的是資料與流程都公開,資料本身仍依賴閉源模型。
結論
Tülu 3 的價值,一半在模型,一半在那份完整的食譜。去污染的門檻、SFT 的配比、損失怎麼加總、偏好資料怎麼生成、PPO 要注意哪些細節,都寫得清清楚楚,連失敗的嘗試也一起交代。
RLVR 本身很樸素,答對給分、答錯不給分,在數學和格式遵循上能帶來穩定但不大的進步。幾個月後,DeepSeek-R1 用規則判定的獎勵把推理能力推得更遠,「可驗證的獎勵」也成了強化學習後訓練的常見做法。
如果你只打算從這份報告帶走一件事,回頭檢查一下自己的訓練程式在梯度累積時,損失是怎麼平均的。