原始論文
Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time
- 發表版本
- ICML 2022會議
- arXiv 首次提交
- arXiv:2203.05482
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingmodelsoups2022,
  title = {{Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Samir Yitzhak Gadre and Rebecca Roelofs and Raphael Gontijo-Lopes and Ari S. Morcos and Hongseok Namkoong and Ali Farhadi and Yair Carmon and Simon Kornblith and Ludwig Schmidt},
  year = {2022},
  eprint = {2203.05482},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.05482}
}
微調一個大模型,標準流程大概是先掃一輪超參數,學習率、權重衰減、訓練輪數、資料增強各試幾組,訓練出一批模型,再挑驗證集上最好的一個,其餘的刪掉。
被刪掉的那些模型也花了不少算力。華盛頓大學、Columbia、Google、Meta 與特拉維夫大學的 Wortsman、Ilharco 等人,半年前才發表 WiSE-FT,把零樣本 CLIP 和微調後的 CLIP 混在一起;這次他們把念頭動到被丟掉的那一批身上。
能不能把它們全部加進來平均,煮成一鍋湯?
定義問題
令預訓練權重為 ,用超參數組合 微調得到 ,。拿這 個模型,有三種用法:
| 做法 | 推論時的模型 | 推論成本 |
|---|---|---|
| 挑驗證集最好的 | ||
| 輸出集成 | ||
| 模型湯 |
整理自原論文 Table 2。三種做法的訓練成本相同。
集成通常最準,但推論時 個模型都要跑。模型湯只跑一個,問題是平均出來的權重還能不能用。
這裡的前提和以往的權重平均不太一樣。SWA 這類方法平均的是同一條訓練軌跡上的點;這篇平均的是從同一個預訓練權重出發、各自獨立微調的模型,超參數可以差很多。
解決問題
三種湯
最直接的是均勻湯(uniform soup), 個全部平均。
它有一個明顯的風險。如果某組超參數訓練出來的模型很差,例如學習率太大,模型跑到了別的盆地,平均就會被它拖下水。
所以作者把重點放在貪婪湯(greedy soup):
import numpy as np

def average(models):
    return np.mean(np.stack(models), axis=0)

def greedy_soup(models, val_acc):
    """models 依驗證集準確率由高到低排好;val_acc(權重) 回傳驗證集準確率。"""
    soup = [models[0]]
    for m in models[1:]:
        if val_acc(average(soup + [m])) >= val_acc(average(soup)):
            soup.append(m)          # 加進去不會變差,就留下
    return average(soup)

# 小例子:二維輸入、兩個類別,用四筆驗證資料選湯的成員。
X = np.array([[2., 0.], [0., 2.], [1., 0.], [0., 1.]])
y = np.array([0, 1, 0, 1])
models = [np.diag([1., 0.5]), np.diag([0.5, 1.]), -4 * np.eye(2)]
val_acc = lambda w: np.mean((X @ w).argmax(axis=1) == y)
models = sorted(models, key=val_acc, reverse=True)
w = greedy_soup(models, val_acc)
print(w.tolist())
print(f"驗證準確率: {val_acc(w):.0%}")
[[0.75, 0.0], [0.0, 0.75]]
驗證準確率: 100%
先把模型依驗證集準確率排好,從最好的那個開始,一個一個試著加進鍋裡。加進去之後驗證集準確率沒有下降,就留下;下降了就跳過。因為第一個放進去的就是最好的單一模型,貪婪湯在驗證集上不會比它差。
例子裡前兩個模型都能分對四筆資料,平均後仍然分對,第三個一加進來就把分類方向翻轉,於是被跳過。套到網路時要把每個對應張量都做平均,篩選邏輯一樣。假如湯裡已經有 個模型,新成員的候選是 ;每次都用一半、一半,會讓後加入的模型權重更大。
排序也有影響。前面留下的成員會改變後面每次測試的平均點,貪婪搜尋又只走一遍,所以它找到的是這個順序下可接受的配方。實驗把排序改成隨機,ImageNet 準確率從 81.03% 變成平均 80.79%。驗證集上的不下降是演算法直接檢查的性質,測試集與部署資料仍要另外評測。
這裡的驗證集不能用 ImageNet 官方的驗證集,那份資料通常被拿來當測試集。作者從訓練集切出大約 2% 當作湯的驗證集。
第三種是學習湯(learned soup),用梯度下降學每個模型、甚至每一層的混合係數。它需要同時把所有模型載入記憶體,對大模型不太實際,論文放在附錄。
具體來說,令 ,用 前向傳播,在保留的驗證資料上最小化交叉熵,另學一個輸出溫度參數。原模型權重固定,更新的是配方係數;softmax 讓係數為正、總和為 1。逐層版本再讓每一層有自己的 ,增加組合彈性。附錄實作用 AdamW、固定學習率 0.1 跑 3 個 epochs,且要保存所有候選權重。它省掉逐個貪婪測試,換來額外的最佳化與記憶體需求。
討論
最好的點在中間
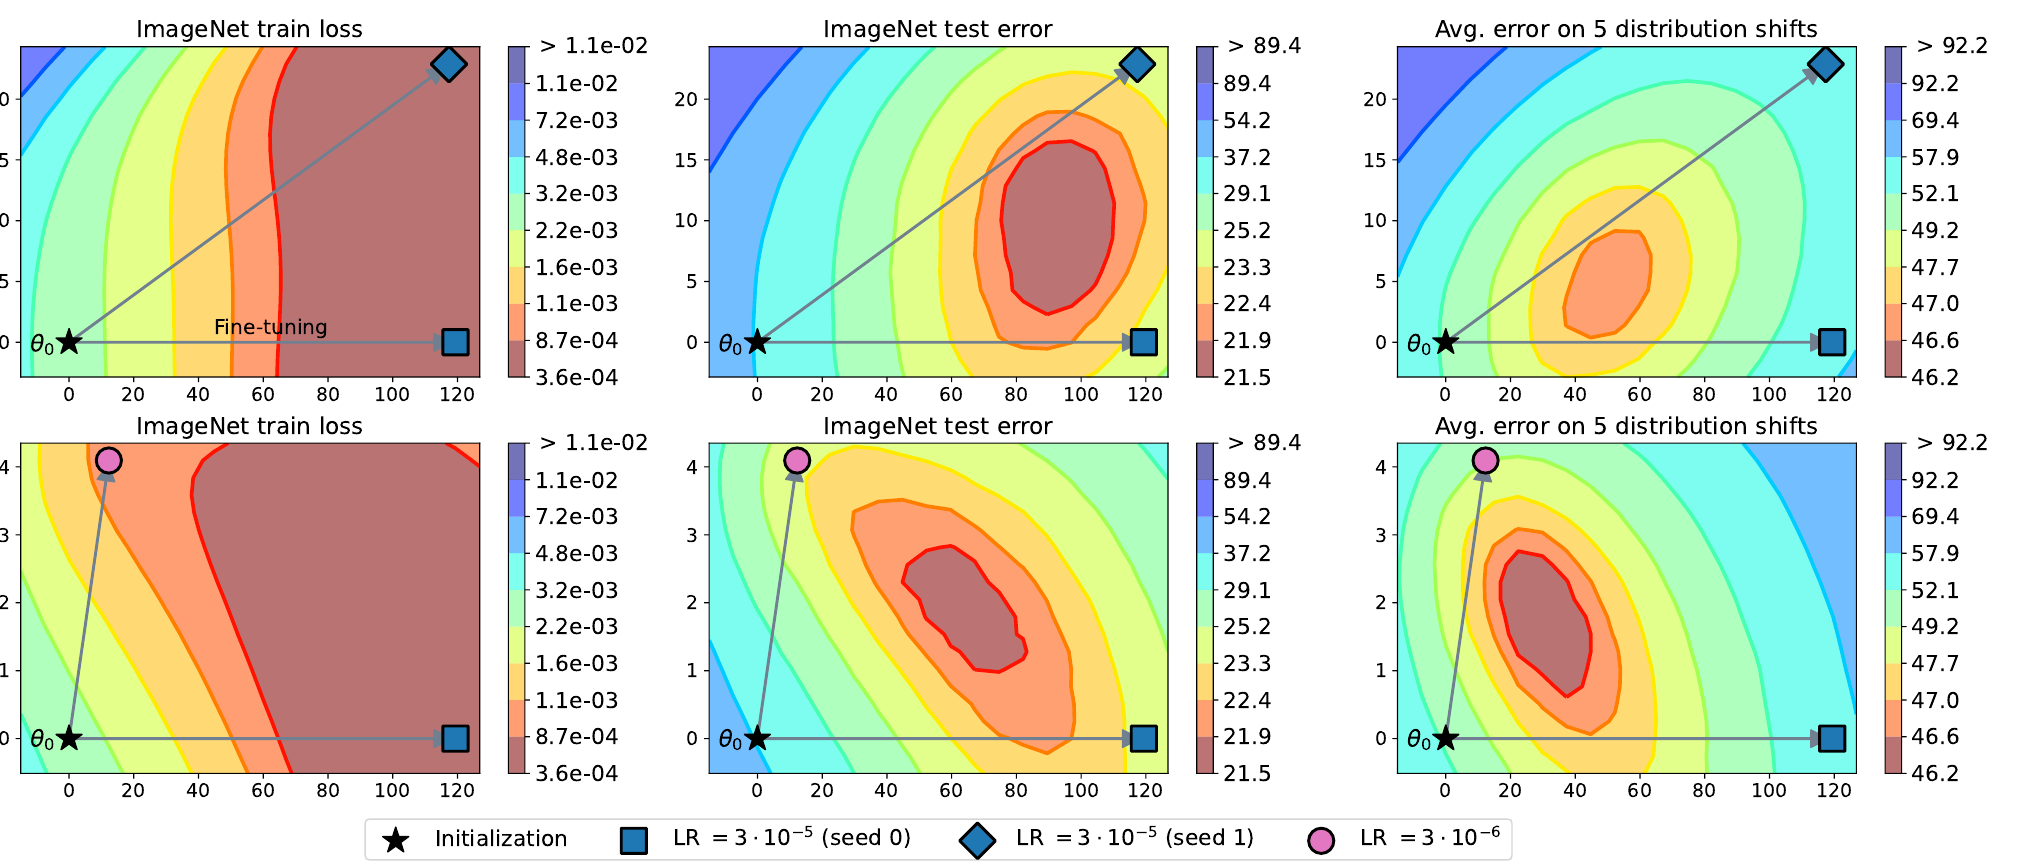
這張圖解釋了為什麼湯可能比較好。作者從零樣本的 CLIP 出發微調兩次,用起點和兩個終點撐出一個平面,在平面上畫出損失和錯誤率。
左邊一欄的訓練損失,兩個微調結果都已經落在很低的區域。中間和右邊的測試錯誤率卻不一樣,等高線是一個盆地,最低的地方在兩個微調結果之間,三個點都不在谷底。微調把模型推向訓練損失低的地方,測試錯誤率最低的地方卻偏到了一旁。
夾角越大,平均越有用
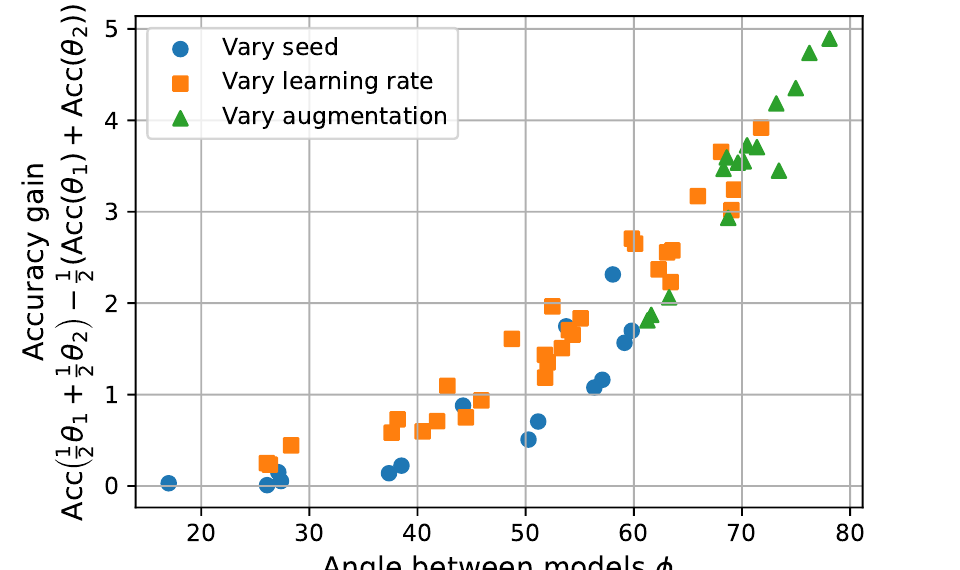
既然最好的點在中間,那平均的好處有多大?作者定義一個「插值優勢」:
再看它和兩個模型夾角的關係。夾角 是 和 之間的角度,也就是把預訓練權重當原點,看兩次微調往不同方向走了多遠。
圖上的點大致排成一條往右上的曲線。只換種子的藍點多半落在左下,夾角較小,好處也小;換學習率或資料增強,夾角容易拉大,平均的好處也跟著變大,最多大約 5 個百分點。
這也說明了為什麼要掃超參數再平均。模型之間越不像,平均起來越有用;前提是它們還在同一個盆地裡。
72 個 CLIP
主要實驗是把 CLIP ViT-B/32 在 ImageNet 上用隨機搜尋的超參數微調 72 次:
這批模型共用預訓練起點,主要設定的分類頭先用 linear probe 初始化,再端到端微調。搜尋會變動學習率( 到 )、weight decay、4 到 16 個訓練 epochs、label smoothing、mixup 和資料增強。它刻意保留一般超參數搜尋會遇到的好壞模型,測的是搜尋結束後能多取回多少收益。
| 做法 | ImageNet | 五個偏移資料集平均 |
|---|---|---|
| 最好的單一模型 | 80.38 | 47.83 |
| 均勻湯(72 個全部平均) | 79.97 | 51.45 |
| 貪婪湯 | 81.03 | 50.75 |
| 學習湯(逐層係數) | 81.37 | 50.87 |
| 72 個模型的輸出集成 | 81.19 | 50.77 |
準確率(%),整理自原論文 Table 3。
均勻湯在 ImageNet 上比最好的單一模型還差,在分布偏移資料上卻高了三個多百分點,顯示有些成員確實把平均拖下水了。貪婪湯在兩邊都贏過最好的單一模型,ImageNet 只比 72 個模型的集成低 0.16 個百分點,推論卻只跑一次。
這鍋 CLIP 的貪婪湯最後只留下 5 個成員;ALIGN 的另一組實驗從 12 個候選裡也選了 5 個。逐層 learned soup 的 81.37% 更高一些,但單一組全域係數的 learned soup 是 80.89%,低於貪婪湯。若改做貪婪輸出集成,ImageNet 還能到 81.90%,偏移資料平均卻是 49.44%。方法排名會跟選模目標一起變,不能只拿最好的一欄代表全部收益。
作者也比較了兩個模型的湯和集成。學習率中等時,兩者的準確率高度相關;集成在 ImageNet 上通常略好,湯在分布偏移資料上略好。學習率太大時,兩個模型離得太遠,集成就明顯贏過湯。
刷新紀錄的那一鍋
最受注意的是 ViT-G/14。這個模型先在 Google 的 JFT-3B 上預訓練,作者在 ImageNet 上微調了 58 次,貪婪湯從中挑了 14 個:
| 模型 | ImageNet | 分布偏移平均 |
|---|---|---|
| CoAtNet-7(當時的最佳紀錄) | 90.88 | – |
| ViT-G,超參數搜尋中最好的單一模型 | 90.78 | 84.68 |
| ViT-G,貪婪湯 | 90.94 | 85.02 |
Top-1 準確率(%),整理自原論文 Table 1。
90.94% 是當時 ImageNet 的最佳紀錄,推論計算量還比 CoAtNet-7 少 25%。和超參數搜尋中最好的模型比,進步是 0.16 個百分點,訓練預算一點都沒多花。
管用的範圍
作者另外在 ALIGN、BASIC、WILDS 的兩個資料集,以及 BERT、T5 的四個 GLUE 文字分類任務上試過。影像分類上的趨勢一致;文字分類也有進步,但幅度沒有影像分類那麼明顯,作者把它當成初步結果。
文字實驗每個任務隨機搜尋 32 組微調設定,變動學習率、batch size、epochs 和種子。四個任務分別是句對改寫 MRPC、蘊涵判斷 RTE、語法可接受度 CoLA、情緒分類 SST-2;指標也不同,MRPC 取 accuracy 與 F1 的平均,CoLA 用 Matthews correlation,RTE 和 SST-2 才是準確率。BERT-base 的 RTE 從 61.0 到 61.7,SST-2 從 92.5 到 93.0,MRPC 與 CoLA 則沒有增加;T5-base 的 RTE 從 78.3 到 79.1。這組結果支持同任務微調模型的合併,還沒有測一鍋湯同時解決四種不同任務。
他們也坦白寫了兩個限制。一是適用範圍,實驗大多用在大規模、多樣資料上預訓練的模型;換成 ImageNet-22k 預訓練的模型,貪婪湯仍有進步,但幅度小得多。二是校準,集成能讓模型的信心更準,湯沒有這個效果。
校準的比較另取 20 個只差亂數種子的模型,避免把超參數差異混進來,再量 expected calibration error。分類得更準和預測機率更可信,是兩項需求;部署時若要靠機率設拒答門檻,還得直接檢查後者。
一樣待在盆地裡,為什麼還會輸給集成?
前面的圖給了幾何直覺,論文還進一步分析湯與 logit 集成的交叉熵差異。對兩模型插值,近似式包含兩部分,一部分和沿線損失的二階導數有關,另一部分是端點 logit 差異在湯的 softmax 分布下的變異數。
損失沿線的彎曲形狀有利於湯時,第一部分會拉低湯的相對損失;第二部分則有利於輸出集成。如果兩個模型本來就很像,logit 差異很小,或湯的預測已很確定、softmax 幾乎集中在一類,變異數項就小。這解釋了為什麼只說「在同一個盆地」還不夠預測兩者的差距。
這個近似建立在 logits 沿線接近線性的情況。作者排除學習率 那組距離太遠的模型後,近似與實際誤差差異更相關;把學習率拉到 的地形對照裡,兩個微調終點之間已經能看到明顯的障礙。貪婪檢查有用,就是因為共享起點仍會遇到這種失敗成員。
結論
模型湯把「掃完超參數只留一個」改成「掃完超參數,挑一些加進去平均」。訓練成本不變,推論仍是一個模型,在 CLIP 和 ViT-G 上都贏過挑最好的那一個。
它成立的條件和 WiSE-FT 一樣,所有成員都從同一個預訓練權重出發,而且最好還待在同一個盆地裡。貪婪湯的驗證集檢查,就是在擋那些跑出盆地的成員。
如果你手上剛好有一批同一個基底、不同超參數的微調模型,與其只留下最好的一個,不如先照這個順序試著煮一鍋。