原始論文
GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
- 發表版本
- ICML 2024會議
- arXiv 首次提交
- arXiv:2403.03507
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersgalore2024,
  title = {{GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection}},
  author = {Jiawei Zhao and Zhenyu Zhang and Beidi Chen and Zhangyang Wang and Anima Anandkumar and Yuandong Tian},
  year = {2024},
  eprint = {2403.03507},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.03507}
}
從零訓練一個 70 億參數的 LLaMA,batch size 只放一條長度 2,048 的序列,需要多少記憶體?
論文開頭先算給我們看。BF16 的權重 14 GB;權重梯度 14 GB,加上 Adam 的一階、二階動差各 14 GB,一共 42 GB;activation 再 2 GB。合計 58 GB。一張 RTX 4090 只有 24 GB。
這篇的主張是,用它提出的方法再搭配 8-bit Adam 與逐層更新,7B 的預訓練實測只要 22 GB。不切模型、不做 activation checkpointing,也不把東西搬到 CPU,一張 4090 就塞得下。
定義問題
省記憶體的老辦法不少。activation checkpointing 用重算換記憶體,ZeRO 把優化器狀態分散到多張卡或搬到 CPU,8-bit Adam 把動差量化,Adafactor 把二階動差分解成列和與行和。這些方法各省一部分,代價是時間、通訊或穩定性。
另一條路是 LoRA。它把權重寫成 ,凍結 ,只訓練兩個小矩陣 、,梯度和優化器狀態都只剩 的大小。
LoRA 在微調很成功,拿去預訓練就吃力了。從零開始時 只是隨機初始化,整個模型能學到的變化被鎖在 維裡;ReLoRA 這類改良,還得先用全秩訓練暖身一段。作者認為原因有兩個,一是最好的權重未必是低秩的,二是重參數化本身也改變了訓練動態。舉個極端的例子,線性迴歸 的最佳解如果是高秩的,把 限制成低秩,用什麼優化器都到不了。
所以作者換了一個問題。權重不必是低秩的,那梯度呢?
解決問題
梯度會變成低秩
作者的理論出發點是一類「可逆網路」,包括線性層(不含偏差)、ReLU、leaky ReLU 這些層,以及它們的串接與相加,殘差網路也在內。對這類網路,一個 batch 的權重梯度可以寫成
、 是半正定矩陣。Lemma 3.3 證明,如果 、、 在某個時間點之後固定不變,用一般的 SGD 更新, 的 stable rank(,可以理解成「有效的秩」)會以指數速度往下掉,最後只剩下由最小特徵子空間決定的那一部分。Corollary 3.4 給了一個更具體的上界。當梯度是 筆資料各自的外積相加、輸入向量的秩 時,最後的 stable rank 不超過 ;而 個外積相加本身的秩也不超過 ,論文據此說長期來看 stable rank 不超過 。
直覺上,一個線性層的梯度就是「每筆資料的反傳誤差 × 每筆資料的輸入」的外積加總,本來就只有有限的方向;訓練一段時間後,大部分的量還會集中在其中少數幾個方向上。
這段理論只涵蓋可逆網路、係數矩陣固定與 SGD 更新。Transformer 的部分,作者在附錄用另一套框架只證明了前饋層第一個投影的梯度會變成低秩;自注意力和 Adam 都不在證明範圍內。
投影到小空間裡做 Adam
既然梯度集中在少數方向,就只在那幾個方向上記錄優化器狀態。GaLore(Gradient Low-Rank Projection)的定義是
是任意需要狀態的優化器,例如 Adam。實作上只用單邊投影。權重是 、 時,每 步對當下的梯度做一次 SVD,取前 個左奇異向量當投影矩陣,
然後每一步:
(論文把 定義成負梯度,所以權重是加上去的。) 是縮放係數,作用類似 LoRA 的 ,但不隨 改變。
我們拿 LLaMA 7B 前饋層的一個權重走一遍,形狀是 ,論文 7B 實驗用 。梯度 是 ;投影矩陣 是 ;投影後的 只有 ,Adam 的 、 也是這個大小。原本 Adam 要存 萬個數,現在是 、 共 2,254 萬,加上 的 419 萬,約 2,674 萬,剩三成左右。更新本身還是一個完整的 矩陣,權重保持全秩。
整體來看,GaLore 對一個 權重要存 個數,LoRA 則是 (原權重加兩個 adapter,再加上 adapter 的兩份動差)。
和 LoRA 的差別還有一個。 取滿秩時,,搭配單純的 SGD,GaLore 的軌跡和原本的訓練一模一樣;LoRA 即使 是滿秩,同時優化 和 也是另一條軌跡。
作者也證明了固定投影下的收斂(Theorem 3.8)。條件是 ,也就是不帶狀態的 SGD,並要求投影後子問題的最小特徵值大於某個由連續性常數決定的門檻。定理建議把投影對準最大的特徵子空間,這正是取梯度 SVD 前 個方向的理由。作者也寫明,收斂只代表在這個子空間內進展良好,不保證整體表現。
換一個子空間
只在一個固定的子空間裡走,權重的變化永遠只有 維,又回到 LoRA 的老問題。GaLore 每 步換一次子空間:
每一段 都是低秩的,累加起來就可以是全秩。
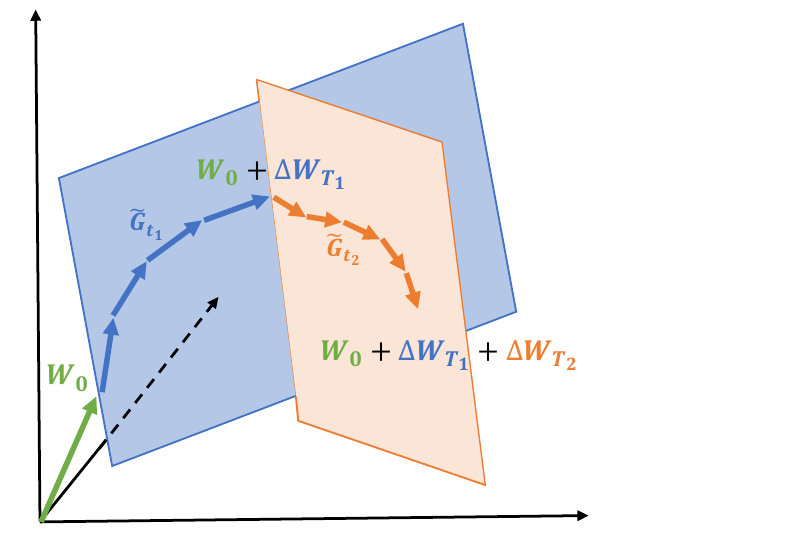
藍色平面是前 步的子空間,權重在裡面走了一段;到了 ,用當下的梯度重算 SVD,換成橘色平面,從剛才的位置繼續走。
怎麼選?換太勤,SVD 的開銷變大,也破壞定理要求的固定投影,Adam 累積的動差還會因為基底一直變而失真;換太少,可能卡在一個已經不重要的子空間裡。作者發現 在 50 到 1,000 之間差別不大,預訓練一律用 200,並估計 SVD 的總開銷在 10% 以內。另外,Algorithm 2 換子空間時, 和 直接沿用,沒有重設,也沒有轉到新的基底上。
再疊兩招
GaLore 只壓縮優化器狀態,作者另外疊了兩個現成技巧。一是把 Adam 換成 8-bit Adam,下文的「8-bit GaLore」指的就是這個組合。二是逐層更新,反向傳播算完一層的梯度就立刻更新那一層,不必把整個模型的梯度存到最後,這是 LOMO 系列的做法。
討論
預訓練 60M 到 1B
實驗沿用 ReLoRA 的設定,LLaMA 架構(RMSNorm、SwiGLU),在 C4 上訓練不重複資料,序列長度 256,每步 131K 個 token,全程 BF16。每個方法、每個尺寸都從五個學習率裡挑最好的;GaLore 則所有尺寸都用學習率 0.01、、,等效學習率 0.0025,比全秩基準通常用的 0.001 以下大。
| 方法 | 60M | 130M | 350M | 1B |
|---|---|---|---|---|
| 全秩 | 34.06 | 25.08 | 18.80 | 15.56 |
| GaLore | 34.88 | 25.36 | 18.95 | 15.64 |
| LoRA | 34.99 | 33.92 | 25.58 | 19.21 |
| ReLoRA | 37.04 | 29.37 | 29.08 | 18.33 |
| 78.18 | 45.51 | 37.41 | 142.53 |
整理自原論文 Table 2,C4 驗證集 perplexity,越低越好;rank 依序為 128、256、256、512(模型維度 512、768、1024、2048)。
GaLore 在四個尺寸都緊貼全秩,1B 只差 0.08;LoRA 和 ReLoRA 隨模型變大越拉越遠。直接把權重分解成 從頭訓練最差,1B 時 perplexity 142.53。記憶體方面,1B 的參數加優化器狀態估計是全秩 7.80 GB、GaLore 4.38 GB、LoRA 6.17 GB。
讀這張表時要記得兩件事。這裡的記憶體是按參數數量估算的 BF16 大小,不含 activation 和梯度。ReLoRA 是拿掉全秩暖身後比的,作者說這是為了公平,但它原本的設計就需要那段暖身;LoRA 本來也是為微調設計的。
7B 與那張 4090
7B 的實驗在 8 個節點、共 64 張 A100 上跑了 15 萬步、197 億個 token。因為算力有限,8-bit GaLore()和 8-bit Adam 各只跑一次,沒有調參。
| 方法 | 4 萬步 | 8 萬步 | 12 萬步 | 15 萬步 |
|---|---|---|---|---|
| 8-bit GaLore | 17.94 | 15.39 | 14.95 | 14.65 |
| 8-bit Adam | 18.09 | 15.47 | 14.83 | 14.61 |
整理自原論文 Table 3,C4 驗證集 perplexity。
前期 GaLore 略好,後期 8-bit Adam 反超,最後差 0.04。
那張 4090 出現在另一組實驗裡。作者在單一裝置上量測實際記憶體,不開 activation checkpointing、不做 offloading,token batch size 是 256。
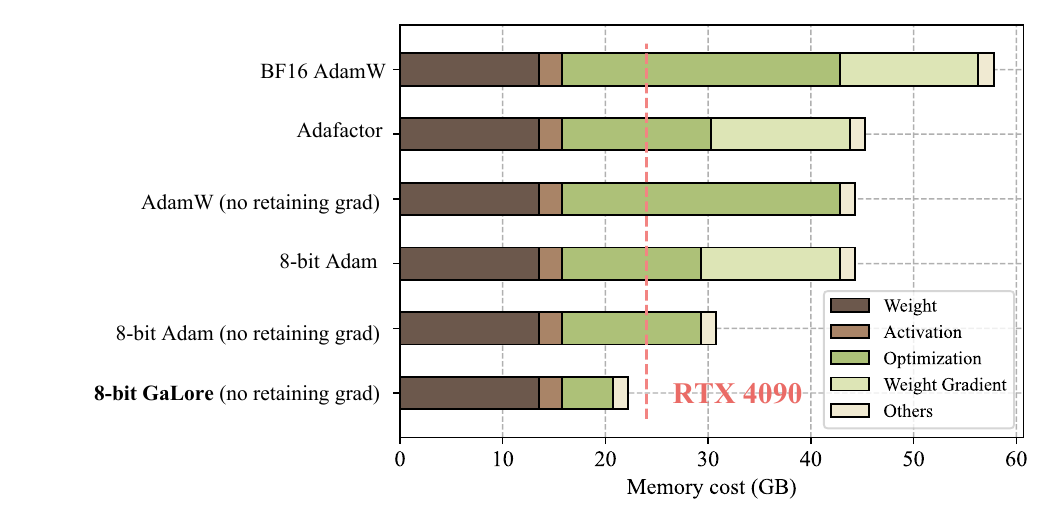
看最下面兩條。8-bit Adam 不保留梯度時約 31 GB,換成 8-bit GaLore 後優化器狀態那段(深綠色)縮短很多,總共約 22 GB,落在 24 GB 的紅色虛線左邊。和 8-bit Adam 相比,低秩投影省下 9.6 GB 的優化器狀態,逐層更新省下 13.5 GB 的權重梯度;和 BF16 的 AdamW 相比,總共省了 63.3%。
所以「在 4090 上預訓練 7B」量的是記憶體能不能塞進去,量測用的 batch 只有 256 個 token(不開 checkpointing 最多約 500),開了 activation checkpointing 也只到 4,096 個;論文裡真正跑完的 7B 實驗用的是 64 張 A100。作者的設想是用許多張消費級顯卡做資料平行,論文沒有實際跑過。
速度和超參數
省記憶體要付出時間。在 LLaMA 1B、token batch 256 的量測裡,開逐層更新的 8-bit GaLore 每秒 1,019.63 個 token,8-bit Adam 是 1,205.31,作者稱約 17% 的額外開銷;關掉逐層更新,GaLore 回到 1,109.38。
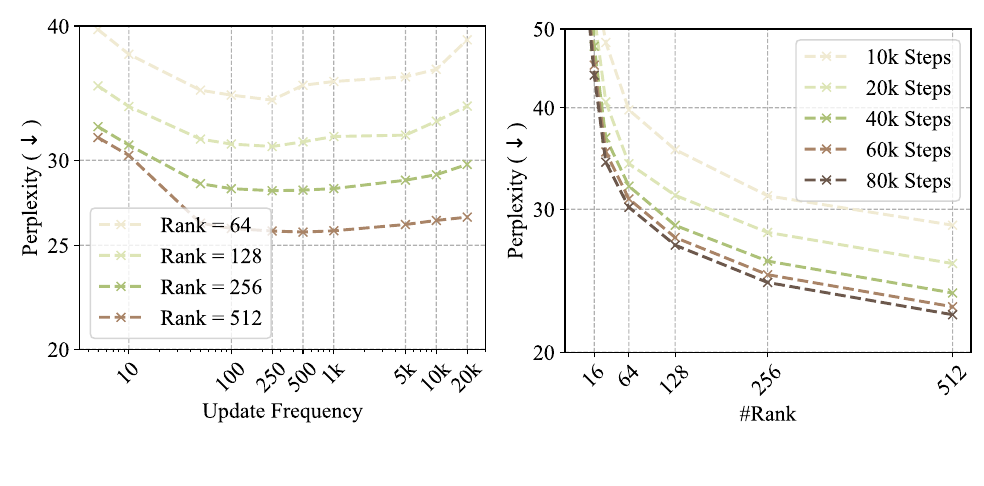
左圖是更新頻率 。四個 rank 都是 U 形,換得太勤或太少都變差,谷底在每 250 到 500 步換一次附近;rank 越小,越需要常換。右圖是 rank,在一定範圍內降低 rank 只讓收斂慢一些;rank 128 跑 8 萬步,比 rank 512 跑 2 萬步還好。換句話說,記憶體不夠時可以用時間換。
微調
微調的對照比預訓練溫和得多。RoBERTa-Base 在 GLUE 上,rank 4 時 GaLore 平均 85.89、LoRA 85.61、全參數 86.28;rank 8 時 85.94 對 85.93,幾乎打平。表上的記憶體 253M 對 257M,算的也是參數加優化器狀態。附錄裡 LLaMA-7B 在 OpenAssistant 對話資料上微調,測試 perplexity GaLore 2.95、LoRA 2.94;拉開比較明顯差距的是 BERT-Base 的 SQuAD(F1 88.29 對 86.11)和 Phi-2 的 OpenAssistant 微調(perplexity 3.83 對 4.24)。
另外,GaLore 每一步都更新完整的權重,訓練完得到的是一整個新模型;LoRA 則可以只存一個小 adapter,隨時掛上或卸下。哪個方便,要看部署的需求。
後來的檢驗
SVD 的代價。 論文估計 SVD 的開銷在 10% 以內,實測的人看法不同。LLaMA-Factory 的作者在 GaLore 發布隔天就做了第三方測試。在 A100 上微調 LLaMA-2 7B、開著 activation checkpointing,16-bit GaLore 不保留梯度只要 18 GB,8-bit AdamW 要 40 GB,一般步驟的吞吐量也不輸;但表格底下註明,7B 每做一次 SVD 大約要 10 分鐘,沒算進去。之後提出 APOLLO 的團隊(成員包括 GaLore 的兩位共同作者)也回報 LLaMA-7B 一次子空間更新約 10 分鐘,吞吐量每 200 步就掉一次。在 Hugging Face 的整合裡,逐層更新的模式只能用單張 GPU,不支援 DDP,梯度裁剪和 DeepSpeed 也可能不正常。
收斂性。 He 等人在 2024 年 10 月的論文給了一個明確的反例,證明 GaLore 在標準的隨機最佳化假設下,不一定收斂到 stationary point。原因是 SVD 只挑最大的方向;訓練後期真正的梯度變小、雜訊還在,前 個奇異向量抓到的可能全是雜訊。GaLore 在沒有雜訊、batch 隨步數變大(例如 ),或雜訊各方向均勻時才有保證。他們提出的 GoLore 改用隨機投影,並建議前期用 GaLore、最後一段換成 GoLore。
規模。 2025 年 4 月,GaLore 的兩位作者 Jiawei Zhao、Yuandong Tian 與 Meta 的 PyTorch 團隊發表 GaLore 2。他們寫明 LLaMA 7B 的每次 SVD 最多要 20 分鐘,改用隨機化 SVD 後快了 15 倍;也提到 SVD 的正負號不唯一,兩次分解出來的投影可能對不上。這次在 32 個節點、256 張 H100 上用 5,000 億個 token 從零訓練 LLaMA 7B,對照組是 8-bit Adam。GaLore 在前 1,500 億 token 稍微落後,約 2,000 億時超前,最後兩者相當。
結論
權重保持全秩,只把優化器狀態放進梯度的低秩子空間,再定期換子空間,這是 GaLore 和 LoRA 最根本的差別。在 1B 以下的預訓練,它和全秩 Adam 只差零點幾的 perplexity,遠好於 LoRA;7B 只跑了一次,最後也和 8-bit Adam 差不多。代價是每隔幾百步一次的 SVD,以及一段只在特定條件下成立的理論。
想在單張消費級顯卡上做全參數微調,GaLore 值得一試。動手前先量一次 SVD 要花多久,也確認開了逐層更新之後,你原本的多卡設定還能不能用。單純想省記憶體做微調,LoRA 或 QLoRA 通常更省事。
那張 4090 後來呢?GaLore 2 的規模驗證,用的是 256 張 H100。