原始論文
Kimi k1.5: Scaling Reinforcement Learning with LLMs
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2501.12599
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerskimik152025,
  title = {{Kimi k1.5: Scaling Reinforcement Learning with LLMs}},
  author = {Kimi Team and Angang Du and Bofei Gao and Bowei Xing and Changjiu Jiang and Cheng Chen and Cheng Li and Chenjun Xiao and Chenzhuang Du and Chonghua Liao and Chuning Tang and Congcong Wang and Dehao Zhang and Enming Yuan and Enzhe Lu and Fengxiang Tang and Flood Sung and Guangda Wei and Guokun Lai and Haiqing Guo and Han Zhu and Hao Ding and Hao Hu and Hao Yang and Hao Zhang and Haotian Yao and Haotian Zhao and Haoyu Lu and Haoze Li and Haozhen Yu and Hongcheng Gao and Huabin Zheng and Huan Yuan and Jia Chen and Jianhang Guo and Jianlin Su and Jianzhou Wang and Jie Zhao and Jin Zhang and Jingyuan Liu and Junjie Yan and Junyan Wu and Lidong Shi and Ling Ye and Longhui Yu and Mengnan Dong and Neo Zhang and Ningchen Ma and Qiwei Pan and Qucheng Gong and Shaowei Liu and Shengling Ma and Shupeng Wei and Sihan Cao and Siying Huang and Tao Jiang and Weihao Gao and Weimin Xiong and Weiran He and Weixiao Huang and Weixin Xu and Wenhao Wu and Wenyang He and Xianghui Wei and Xianqing Jia and Xingzhe Wu and Xinran Xu and Xinxing Zu and Xinyu Zhou and Xuehai Pan and Y. Charles and Yang Li and Yangyang Hu and Yangyang Liu and Yanru Chen and Yejie Wang and Yibo Liu and Yidao Qin and Yifeng Liu and Ying Yang and Yiping Bao and Yulun Du and Yuxin Wu and Yuzhi Wang and Zaida Zhou and Zhaoji Wang and Zhaowei Li and Zhen Zhu and Zheng Zhang and Zhexu Wang and Zhilin Yang and Zhiqi Huang and Zihao Huang and Ziyao Xu and Zonghan Yang and Zongyu Lin},
  year = {2025},
  eprint = {2501.12599},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.12599}
}
2025 年 1 月 20 日,DeepSeek 發布 R1,大約一個小時後,月之暗面(Moonshot AI)也發布了 Kimi k1.5。
兩個模型想做的事情很像。2024 年 9 月 OpenAI 發表 o1 之後,大家都知道「讓模型先想很久再回答」能大幅提升數學與程式的表現,但 OpenAI 沒有說怎麼做。這兩份報告都給出了答案,而且答案相近:用強化學習訓練模型寫長的思考過程,不需要蒙地卡羅樹搜尋、不需要價值函數、也不需要逐步評分的過程獎勵模型。
不同的是,R1 公開了權重,k1.5 沒有,只能透過 Kimi 的產品與 API 使用。這篇報告也沒有交代模型的參數量。所以讀 k1.5,重點不在模型本身,而在它的訓練方法;其中有兩件事是 R1 報告沒有的:把強化學習的上下文長度擴到 128K,以及一整節討論怎麼把長思考的能力搬回短回答的模型,其中一個方法就是模型合併。
定義問題
預訓練的縮放受限於高品質資料的總量。作者想找另一條可以繼續擴大的路,讓模型透過獎勵自己探索,不再只學固定的資料集。
問題的設定很單純。給定題目 與標準答案 ,模型先寫出一段思考過程 ,再給出答案 。獎勵 只有 0 或 1。程式題看能不能通過測試,數學題看答案對不對:
作者對「長思考」有一個有意思的觀點。傳統的推論時搜尋,例如樹搜尋,需要一個評估器去判斷哪條路比較有希望,再決定展開哪個節點。但如果把搜尋過程中的所有嘗試、評估、回頭,都寫成一段很長的文字,那麼一個能寫很長的模型,就可以在自己的上下文裡隱式地做搜尋。
這個觀點把問題轉成兩件事:上下文能拉多長,以及強化學習能不能教會模型好好利用這段長度。
解決問題
先把題目挑好
作者發現,強化學習的成敗很大程度取決於題目集。好的題目集要涵蓋多種領域、難度分布均勻,而且答案能被準確驗證。
難度的估計用模型自己來做。讓 SFT 模型用較高的取樣溫度對每題回答 10 次,通過率越低,題目越難。這也順便濾掉了太簡單的題目。
驗證的部分則要防止「猜對」。有些推理題的答案很容易猜,模型可能用錯誤的推理得到正確的答案,獎勵就被騙了。作者排除了選擇題、是非題與證明題;一般問答題則先讓模型不思考、直接猜 8 次,只要猜中一次,就判定這題太好猜而刪除。
長思考的暖身
正式做強化學習之前,作者先用提示工程生成一小批高品質的長思考範例,內容刻意包含規劃、評估中間步驟、反思修正、嘗試其他解法這些行為,再做一輪輕量的 SFT。目的是讓模型先學會這種寫法,強化學習再去放大它。
策略最佳化:線上鏡像下降
作者用的是線上鏡像下降(online mirror descent)的一個變體。第 輪以當前模型 當參考,求解一個帶有 KL 正則的問題:
這個問題有封閉解,。兩邊取對數,可以得到一個對任何樣本都要成立的等式,作者再把它寫成平方誤差的代理損失:
用同一題取樣 個回答的平均獎勵 近似。對這個損失取梯度,第一項就是以平均獎勵為基準的策略梯度,第二項是一個 正則項。
翻成白話:同一題取樣 個回答,答對的(獎勵高於平均)提高機率,答錯的壓低機率,同時不要離上一輪的模型太遠。每一輪結束後,參考模型換成新的模型,優化器狀態也重置。
這套方法沒有價值網路。作者的理由很有啟發性。假設模型寫到一半,下一步可以選一條直接通往正確答案的路,也可以選一條會犯錯的路。傳統的價值函數會懲罰後者;但只要模型犯錯之後能發現並修正,最後仍然答對,這段「犯錯再修正」的經驗反而是學會長思考最需要的東西。所以作者只看最終答案,不對中間步驟做信用分配。
長度懲罰
強化學習進行時,回答越來越長。表現確實變好,但推論成本也一路上升。作者加了一個長度獎勵。
同一題的 個回答中,令最短與最長的長度分別是 min_len 與 max_len,第 個回答的長度獎勵是
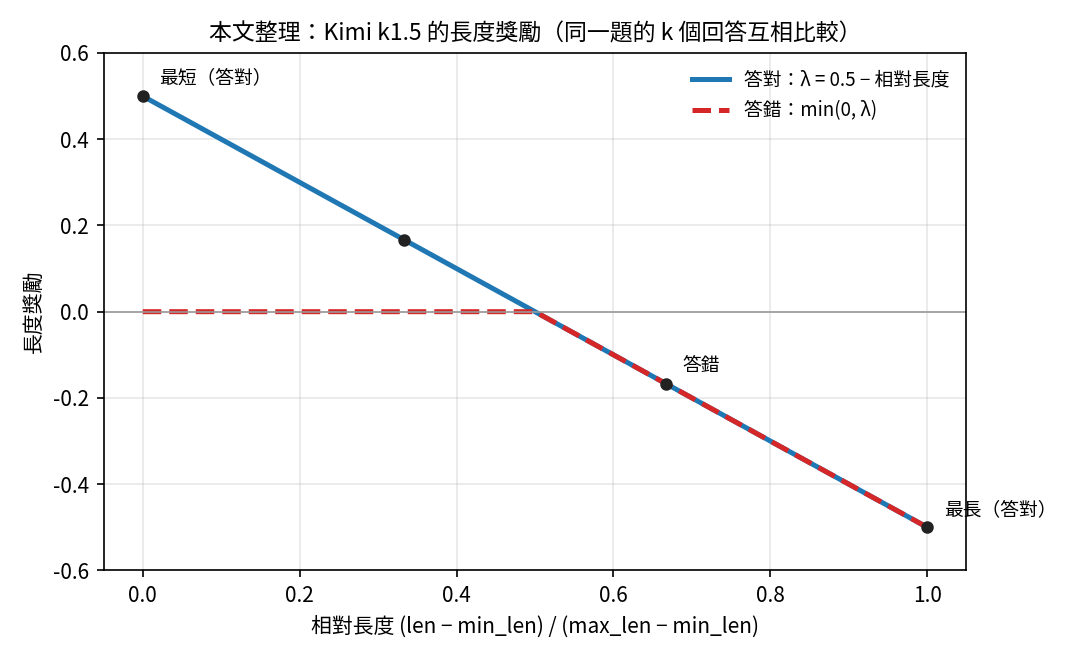
用一個例子算一次。同一題取樣四個回答,長度分別是 1,000、2,000、3,000、4,000 個 token,第三個答錯:
def length_reward(lengths, correct):
    lo, hi = min(lengths), max(lengths)
    if hi == lo:
        return [0.0] * len(lengths)
    out = []
    for n, ok in zip(lengths, correct):
        lam = 0.5 - (n - lo) / (hi - lo)
        out.append(lam if ok else min(0.0, lam))
    return out

lengths = [1000, 2000, 3000, 4000]
correct = [True, True, False, True]
for n, ok, r in zip(lengths, correct, length_reward(lengths, correct)):
    print(f"長度 {n:>5}  {'答對' if ok else '答錯'}  長度獎勵 {r:+.3f}")
長度  1000  答對  長度獎勵 +0.500
長度  2000  答對  長度獎勵 +0.167
長度  3000  答錯  長度獎勵 -0.167
長度  4000  答對  長度獎勵 -0.500
答對的回答中,越短越好;答錯的回答不會因為短而得到獎勵,但太長一樣會被扣分。注意最長的那個答對回答,長度獎勵是 −0.5,比答錯的那個還低。這沒有問題,因為長度獎勵是以某個權重加到原本 0 或 1 的正確性獎勵上,答對的 1 分仍然主導。
作者也發現長度懲罰會拖慢訓練初期的進展,所以先不加,等訓練一段時間後才固定加上。
取樣策略與獎勵模型
題目的取樣有兩種策略。課程取樣先練簡單題再練難題,因為一開始模型太弱,花算力在難題上幾乎拿不到正確樣本。優先取樣記錄每題的成功率 ,按 的比例抽題,專練模型最弱的地方。
程式題的網路資料常常沒有測試案例,作者用模型搭配測試生成函式庫 CYaRon 自動產生。每題先生成 50 個測試案例,用 10 份正確解答驗證,至少 7 份結果一致才保留這個案例;整題要有 9 份以上解答通過全部保留下來的案例,才放進訓練集。從 1,000 題線上比賽題目中,最後只收進 323 題。
數學題的難處在於同一個答案可以有很多寫法,例如 和 。作者比較了兩種獎勵模型:一般輸出分數的獎勵模型,人工抽查的準確率約 84.4%;先寫推理過程再判斷對錯的 CoT 獎勵模型,準確率約 98.5%。強化學習用的是後者。
128K 的長上下文與部分展開
讓模型在強化學習中寫到 128K token 時,一條特別長的回答會霸佔取樣資源,拖慢整批訓練。這是最大的工程問題。
作者的解法叫部分展開(partial rollouts)。每次取樣設一個固定的輸出長度上限,寫不完的回答先存進重播緩衝區,下一輪再接著寫。只有當前這一段需要用目前的策略計算,之前的段落直接從緩衝區取用。取樣的工作者是非同步運作的,有的在處理長回答,其他的同時處理短回答,資源不會閒置。這套系統也能偵測重複內容,提早截斷並給予懲罰。
討論
長思考的成績
長思考版本的 k1.5,成績與 OpenAI o1 相當。AIME 2024 是 77.5(o1 是 74.4),MATH-500 是 96.2(o1 是 94.8),Codeforces 是第 94 百分位(與 o1 相同),LiveCodeBench 是 62.5(o1 是 67.2)。視覺方面,MathVista 是 74.9,MMMU 是 70.0。
作者也用一個中型模型觀察擴展性。隨著訓練進行,回答長度與準確率同時上升,越難的評測,長度增加得越陡。
另一個消融比較了模型大小與長思考。用同樣的資料訓練大小兩個模型,大模型一開始表現較好,但小模型透過更長的思考,最後可以追上;不過大模型的 token 效率比較高。若追求最好的表現,擴大大模型的上下文上限更高;若推論預算有限,訓練小模型寫長一點也是可行的選擇。
還有兩個消融。與只學習最佳回答、不懲罰錯誤回答的 ReST 相比,作者的方法樣本效率明顯較好,可見負向梯度在長思考訓練中很重要。課程取樣也明顯優於均勻取樣。
長話短說
長思考很強,但很貴。作者在第 2.4 節比較了四種把長思考的能力搬到短回答模型的方法:
- 模型合併:把長思考模型和短回答模型的權重直接平均,不需要任何訓練。
- 最短拒絕取樣:同一題取樣 8 次,挑最短的正確回答拿來做 SFT。
- DPO:最短的正確回答當作正例,錯誤的長回答與長度超過正例 1.5 倍的正確回答當作負例。
- 長轉短強化學習:挑一個表現與長度平衡最好的模型,再加上長度懲罰、大幅縮短取樣長度上限,另外跑一輪強化學習。
結果是第四種的 token 效率最高。短回答版的 k1.5 在 AIME 2024 上平均只用 3,272 個 token,就拿到 60.8 分;GPT-4o 是 9.3,Claude 3.5 Sonnet 是 16.0。MATH-500 上,最短的版本以和其他短回答模型相近的 token 數拿到 88.2 分。
模型合併在這裡是有效但不是最好的方法。它的優點是完全不用訓練;相較之下,有訓練的方法能更精準地控制長度。這個結論也被後來的 Assembly of Experts 引用,用來說明合併在縮短推理上的極限。
讀這份報告要注意的事
模型沒有開源,參數量與預訓練規模也沒有公開,報告中的數字無法被第三方驗證。長轉短的比較只以圖呈現 token 效率,各方法的具體數字大多沒有列出。多數消融是在較小的模型上做的。
結論
Kimi k1.5 和 DeepSeek-R1 在同一天給出了相近的答案。只靠結果是否正確的獎勵,配合足夠長的上下文,就能讓模型學會長思考,不需要樹搜尋、價值函數或過程獎勵。
k1.5 自己的貢獻,是把這條路的工程細節寫得很具體:怎麼挑題、怎麼防猜、怎麼在 128K 的長度下有效率地取樣、怎麼用長度獎勵抑制過度思考,以及怎麼把長思考壓回短回答。
想拿長思考模型做產品的人,只要它和原本的短回答模型來自同一個基底,可以先試試把兩者平均一下。不用訓練,只是一次權重運算;不夠好,再考慮跑一輪長轉短的強化學習。