原始論文
The Marginal Value of Adaptive Gradient Methods in Machine Learning
- 發表版本
- NeurIPS 2017會議
- arXiv 首次提交
- arXiv:1705.08292
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersmarginalvalue2017,
  title = {{The Marginal Value of Adaptive Gradient Methods in Machine Learning}},
  author = {Ashia C. Wilson and Rebecca Roelofs and Mitchell Stern and Nathan Srebro and Benjamin Recht},
  year = {2017},
  eprint = {1705.08292},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1705.08292}
}
「These results suggest that practitioners should reconsider the use of adaptive methods to train neural networks.」
這是這篇論文摘要的最後一句,建議大家重新考慮要不要用自適應方法訓練神經網路。
2017 年 5 月,Adam 才發表兩年多,論文自己的引言就寫,它已經是許多深度學習框架裡的預設演算法。當時流傳兩個說法,一是 AdaGrad、RMSProp、Adam 這類自適應方法收斂得快,二是它們幾乎不用調參。柏克萊的 Ashia Wilson、Rebecca Roelofs、Mitchell Stern、Benjamin Recht 與 TTIC 的 Nathan Srebro 把兩個說法都拿出來檢查。
他們先構造了一個簡單的分類問題,SGD 在上面的測試錯誤率是 0,自適應方法卻接近一半;接著在影像分類、字元級語言模型與兩種句法剖析上做實驗,結論都是調好的 SGD 贏。
這篇筆記會先拆那個構造例,再看實驗和他們的調參方式,最後看兩年後另一組人怎麼用同一份程式碼,把差距調到看不見。
定義問題
深度網路的參數量通常遠大於訓練樣本數,能讓訓練損失降到 0 的解不只一個,而是一大片。優化器最後停在哪一個,取決於它走的路線;不同的解在訓練集上一樣好,在新資料上卻可能差很多。
這篇要問的是,自適應方法和 SGD 在這種情況下會不會挑到不同的解,而挑到的解泛化能力有沒有差別。
為了比較,論文先把各種方法寫進同一個框架。SGD 直接沿梯度走;自適應方法則在梯度前面乘上一個對角矩陣的倒數,
的選法決定了它是 AdaGrad、RMSProp 還是 Adam,動量項另外加上。SGD 相當於 ,用的是參數空間原本的 幾何;自適應方法則依照歷史梯度,替每個座標換一把尺。
解決問題
SGD 會找到最小範數解
先看最單純的情況,用最小平方法做二元分類:
當 ,只要有一個解讓損失為 0,就有無限多個。
SGD 的每一個梯度都是 的形式,落在 的列空間裡。從 出發,只用梯度和過去迭代點的線性組合,就永遠離不開這個空間。列空間裡滿足 的解只有一個,,剛好是所有解裡 範數最小的那個,也是邊界(margin)最大的那個。
所以 SGD、動量、小批次 SGD、Nesterov,乃至共軛梯度法,最後都會到同一個點。論文說,梯度下降自然地找到最大邊界解,是一個令人愉快的意外。
自適應方法會找到符號解
自適應方法的分母每個座標都不一樣,就沒有列空間這個限制了。一般情況很難算出它會收斂到哪裡,論文挑了一個能算的特例(Lemma 3.1):
若存在純量 使得 ,則從 出發,AdaGrad、Adam 與 RMSProp 都收斂到唯一的解 。
證明的想法很直接。在 與 成正比的時候,梯度會和 成正比,分母 會和 成正比;兩者一除,每個座標的更新量大小都一樣,只差在正負號。所以每一步之後, 仍然和 成正比,歸納下去就得到結論。
換句話說,在這個特例裡,自適應方法把每個特徵都當成一樣重要,每個權重的絕對值都相同。論文的說法是,它們會收斂到 範數小的解,SGD 則收斂到 範數小的解。
構造一組會讓它出錯的資料
接著論文設計了一組資料,讓這個差別變成測試錯誤率。
每個樣本的標籤 以機率 是 ,否則是 。特徵向量很長,前三維和後面分開看:
- 第 1 維就是標籤本身,;
- 第 2、3 維永遠是 1;
- 後面每個樣本各有一段只屬於自己的特徵,正例有 1 個、負例有 5 個,值都是 1。
真正有用的只有第 1 維;第 2、3 維是常數,後面那些特徵各自只在一個樣本身上出現。它們在訓練集上看起來很有鑑別力,每一個都能「認出」某個樣本,但對新樣本毫無用處。
這組資料剛好滿足 Lemma 3.1 的條件,。我們取 10 個訓練樣本(6 正、4 負)實際算一遍,從 出發,梯度下降和 Adam 都把訓練損失降到 0,學到的權重如下:
| 特徵 | SGD | Adam |
|---|---|---|
| 第 1 維(標籤) | 0.756 | 0.25 |
| 第 2、3 維(常數) | 0.087 | 0.25 |
| 正例的專屬特徵 | 0.070 | 0.25 |
| 負例的專屬特徵 | −0.084 | −0.25 |
本文試算。SGD 欄是最小範數解,梯度下降迭代到收斂的結果與解析解一致;Adam 欄用預設的 、學習率 迭代兩萬步,AdaGrad 得到相同的權重。
SGD 把大部分的權重放在第 1 維。Adam 給每個特徵一樣大的權重,正負號跟著該特徵在訓練集上和標籤的關係走。
現在來一個新樣本。它的專屬特徵是全新的,訓練時從沒出現過,和 重疊的只有前三維:
- SGD:分數是 。正例得 ,負例得 ,兩個都分對。
- Adam:分數是 。正例得 ,負例得 ,兩個都判成正例。
在這組資料上,自適應方法會把每一個沒見過的樣本都標成正例,測試錯誤率就是負例的比例 。 越接近 ,錯誤率越接近一半;SGD 的錯誤率則是 0。附錄還把它寫成從固定分布抽樣的版本,結論相同。
這個例子的維度不必真的無限大,論文說取 維就夠了,而深度網路的參數量常常是樣本數的 25 倍以上。作者的解讀是,真實資料裡也常有少數幾個頻繁出現、真正有用的特徵,加上大量稀疏的特徵;有限的訓練集上,稀疏特徵看起來很能分辨樣本,其實只是過擬合。
照 Lemma 3.1 的機制來看(這是本文的解釋),自適應方法的分母來自各座標自己的歷史梯度,很少出現的稀疏特徵分母小,相對步伐就大,最後被推到和真正有用的特徵一樣大的權重,正好放大了這個問題。
這個構造有它的前提。它要求從 出發、資料滿足 這種特殊結構,分析時也把分母裡的 拿掉了。它證明了「自適應方法可以泛化得很差」,至於神經網路上會不會發生,要看實驗。
討論
實驗設定
論文比較兩個非自適應方法(SGD、動量固定 0.9 的 heavy-ball,下稱 HB)和三個自適應方法(AdaGrad、RMSProp、Adam),另外加一條完全用預設值的 Adam。四個任務都用網路上找得到的程式碼,盡量不改架構和前處理:
| 任務 | 模型 | 資料 |
|---|---|---|
| 影像分類 | VGG+BN+Dropout | CIFAR-10 |
| 字元級語言模型 | 2 層 LSTM | 《戰爭與和平》 |
| 判別式句法剖析 | 2 層 LSTM+前饋 | Penn Treebank |
| 生成式句法剖析 | 3 層 LSTM | Penn Treebank |
整理自原論文 Table 2。四套程式碼用了 Torch、DyNet、TensorFlow 三種框架,前兩個任務都是 Torch。
句法剖析是把句子拆成巢狀的子句、片語與詞的樹狀結構。判別式的做法把建樹轉成一連串動作的序列預測,用 F1 衡量;生成式的做法把樹寫成深度優先走訪的序列,當成語言模型來打分,用困惑度衡量。
每個設定從隨機初始化跑 5 次。訓練的 epoch 數事先固定,有驗證集的任務,挑在預算內驗證成績最好的設定;CIFAR-10 沒有另外切驗證集,改挑訓練損失最低的設定。
調參方式
作者發現影響最大的兩個超參數是初始學習率和衰減方式,就只調這兩個,其他維持各框架的預設值。
學習率在對數尺度上取 5 個點。如果最好的點落在邊界,就往外再加點,直到最好的值在中間;例如試過 2、1、0.5、0.25、0.125 而 2 最好,就再試 4,4 更好就試 8。衰減方式有兩種:
- dev-decay:記錄目前最好的驗證成績,某個 epoch 沒有刷新,就把學習率乘上 ;
- fixed-decay:每 個 epoch 乘一次 。
作者建議有驗證集時用 dev-decay,它的超參數比較少,結果也不比 fixed-decay 差。附錄列了每個方法試過的學習率。以 CIFAR-10 為例,SGD 最好的是 0.5,Adam 最好的是 0.0003,比預設的 0.001 小三倍多。
CIFAR-10
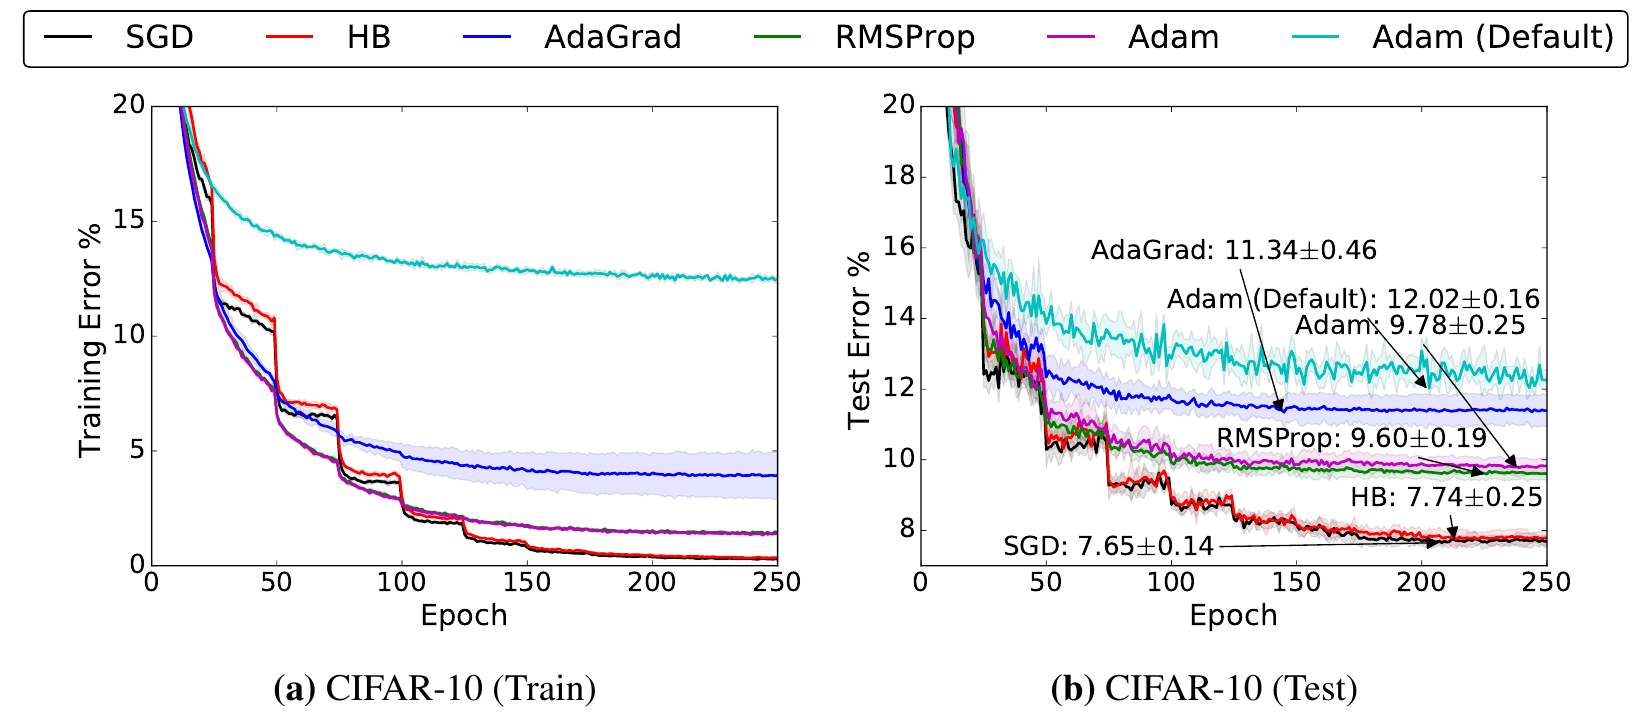
模型是 Torch 部落格上的 VGG+BN+Dropout,原本的測試錯誤率是 7.55%。右圖標出每個方法最好的測試錯誤率,SGD 是 ,自適應方法裡最好的 RMSProp 是 ,調過的 Adam 是 ,預設 Adam 是 。
順著時間看更有意思。前 50 個 epoch,自適應方法的訓練錯誤率明顯領先,測試錯誤率則和 SGD、HB 不相上下。大約從第 50 個 epoch 開始,自適應方法的訓練錯誤率還比較低,SGD 和 HB 的測試錯誤率已經開始領先;到第 100 個 epoch,SGD 和 HB 在訓練與測試上都贏了。左圖 SGD 和 HB 每 25 個 epoch 往下跳一階,那是學習率衰減;兩年後重跑這組實驗的 Choi 等人記下的設定,是每 25 個 epoch 把學習率乘 0.5。自適應方法的曲線在同樣的位置平得多。
作者也試過替自適應方法加大學習率。前 50 個 epoch 確實會進步,但後面停滯得更嚴重,換什麼衰減方式都救不回來。
三個語言任務
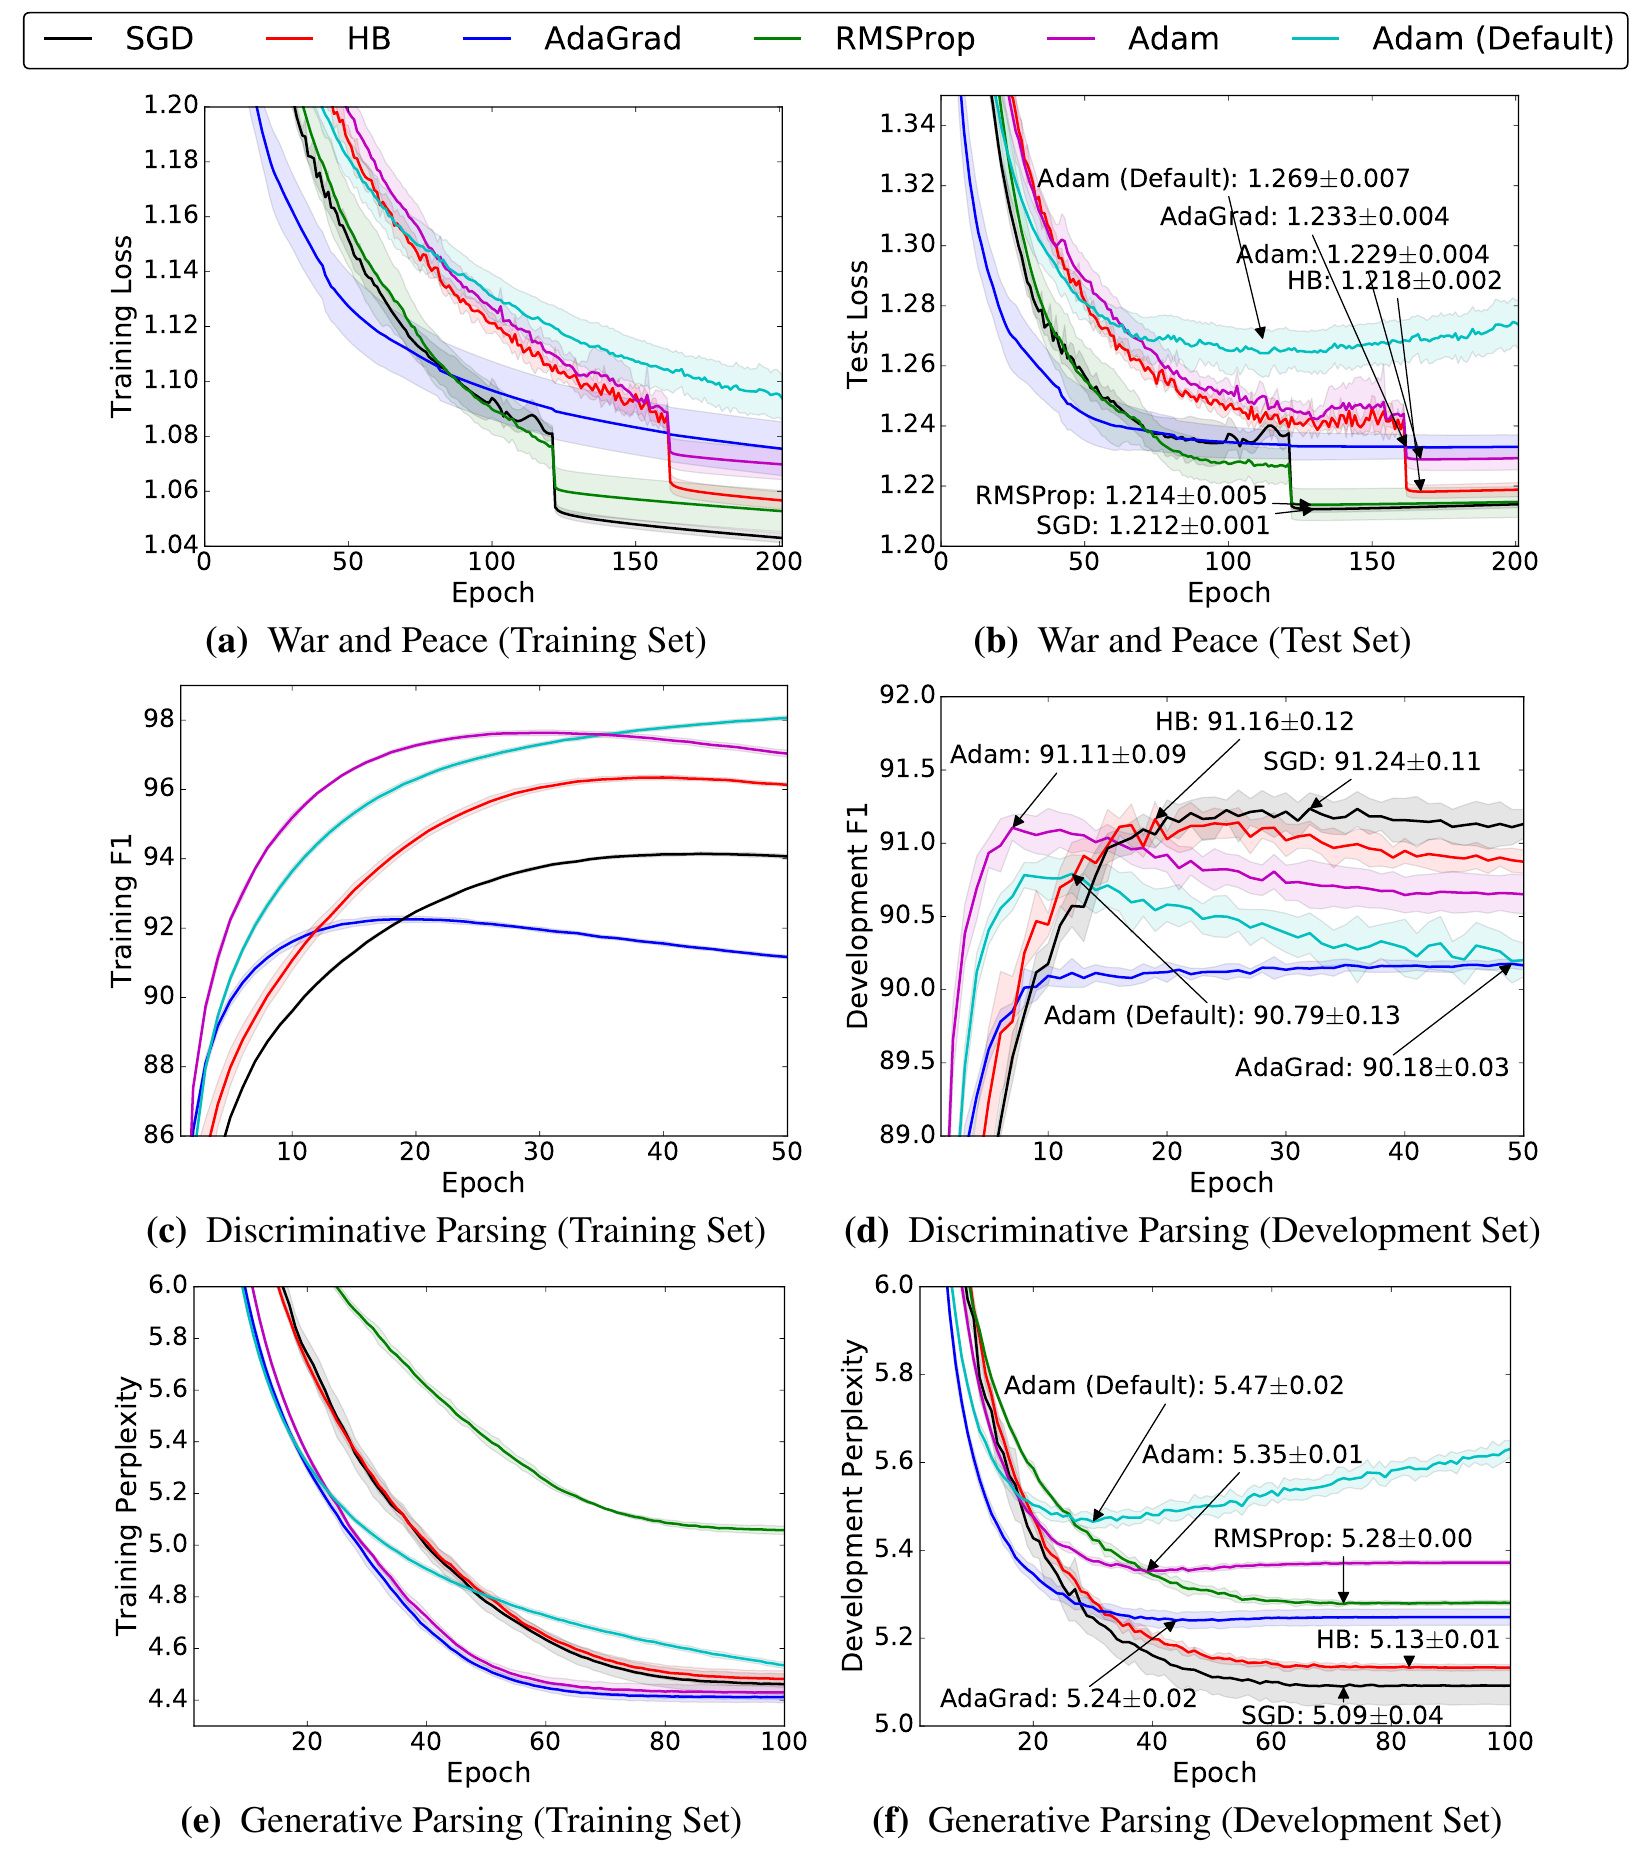
每一列左邊是訓練集,右邊是驗證或測試集,標註的是每個方法的最佳值。
- 字元級語言模型(第一列)。用 torch-rnn 在《戰爭與和平》全文上訓練 200 個 epoch。SGD 的測試損失最低,;RMSProp 以 緊跟在後,作者特別說明這證明了自適應方法並非不可能找到泛化好的解。fixed-decay 的搜尋還有一個發現,除了 AdaGrad,所有方法最好的設定都是在訓練進行到 60% 或 80% 時才一次把學習率除以 10。
- 判別式剖析(第二列)。Cross 與 Huang 的剖析器,在 Penn Treebank 上訓練 50 個 epoch,dev-decay 的 ;當時的 DyNet 沒有 RMSProp。SGD 的驗證 F1 最好,91.24,HB 與 Adam 緊追在後。Adam 只花 6 個 epoch 就達到它的最佳值 91.11,SGD 要 18 個 epoch 才追上這個數字,31 個 epoch 才到 91.24。之後 Adam 在訓練集上繼續進步,驗證成績卻往下掉。
- 生成式剖析(第三列)。Choe 與 Charniak 的模型,為了省計算把 LSTM 的隱藏維度從 1500 降到 500,dropout 從 0.7 降到 0.5,訓練 100 個 epoch。SGD 的驗證困惑度最好,5.09;Adam 的訓練曲線屬於最好的一群,驗證困惑度卻是調過的方法裡最差的,5.35。
四個任務歸納起來是四點:
- 自適應方法找到的解,泛化比非自適應方法差。
- 就算訓練損失一樣低甚至更低,自適應方法的驗證或測試成績還是比較差。
- 自適應方法一開始在訓練集上進步得快,但驗證成績很快就停住。
- 調學習率和衰減,對 Adam 的改善在每個任務上都很明顯。預設值的 Adam 在四張圖上都墊底或接近墊底,「Adam 不用調」的說法站不住。
作者在結論裡說,他們不太確定 Adam 為什麼還這麼受歡迎。和其他研究者聊過之後的猜測是,Adam 在 GAN 與搭配函數近似的 Q-learning 上特別流行,而這兩者嚴格來說都不是在解最佳化問題,Adam 的動態也許剛好適合它們。
調好 再比一次
兩年後,多倫多大學與 Google Brain 的 Dami Choi、Christopher Shallue、George Dahl 等人在〈On Empirical Comparisons of Optimizers for Deep Learning〉裡回應了這篇論文。
他們的出發點是優化器之間的包含關係。動量設成 0 就是 SGD,所以調到最好的動量不可能輸給調到最好的 SGD。Adam 也能模仿動量。把 設成 0、 調得很大,分母 幾乎就是常數 ,再配合學習率的排程抵銷偏差修正,Adam 的更新就變成帶動量的 SGD。所以只要所有超參數都調,Adam 不該比動量差。
Wilson 等人只調了學習率和衰減, 維持各框架的預設值;構造例的分析也把 拿掉了。Choi 等人拿 Wilson 等人公開的 CIFAR-10 程式碼重跑:
- 照原本的做法只掃學習率,重現了 RMSProp 和 Adam 比較差的結果;
- 用隨機搜尋多調動量相關參數和 ,SGD、動量、RMSProp、Adam 四者的測試錯誤率幾乎一樣;
- 換成他們自己的程式碼並搜尋學習率排程,四者也落在誤差範圍內。
他們也注意到 Wilson 等人在 CIFAR-10 上是用訓練損失挑設定,改成用驗證集挑,結論不變。 這個參數的影響比想像中大,他們在四個任務上找到的最佳 橫跨 10 個數量級。
兩篇論文的結論怎麼放在一起,Choi 等人自己給了說法。如果把「預設 的 Adam」和「調過 的 Adam」看成兩個不同的優化器,結論就沒有矛盾。這裡要多想一步, 調大的 Adam,分母的自適應效果也被沖淡了,越來越接近動量 SGD。Choi 等人在 Wilson 的程式碼上替 Adam 調 ,最後的搜尋範圍落在 到 ,比梯度的尺度大了好幾個數量級,分母幾乎就是常數。所以兩篇加起來可以這樣讀,預設設定下的自適應更新確實可能泛化較差,而把 Adam 調到不輸 SGD 的那組超參數,有一部分正是讓它變得沒那麼自適應。
其他的回應
同一時期還有幾條路線,從不同角度處理這個差距。
- 把權重衰減寫對。 2017 年 11 月,Loshchilov 與 Hutter 引用這篇論文,認為 Adam 泛化差的一大原因是 L2 正則化在 Adam 裡沒有發揮作用,提出 AdamW。
- 後段換成 SGD。 Keskar 與 Socher 的 SWATS 先用 Adam 訓練,在某個條件觸發時切換到 SGD;AdaBound 則讓 Adam 每個參數的學習率被一個逐步收窄的上下界夾住,從 Adam 平滑過渡到 SGD。
- 大規模重新比較。 Schmidt 等人用超過五萬次訓練比較 15 種優化器,沒有一種在所有任務上明顯勝出,Adam 仍然是很強的選擇。
另一個反方向的發展是 Transformer。Choi 等人在 LM1B 的 Transformer 語言模型上就看到明顯的排名,Adam 達到目標錯誤率所需的步數只有動量的 60%,達到同樣的最終結果只需 SGD 的 25%。Zhang 等人 2019 年認為,注意力模型的梯度雜訊呈重尾分布,是 SGD 表現差的原因之一;Kunstner 等人 2023 年則把批次一路加大到整個資料集,發現雜訊減少時 Adam 進步得比 SGD 多,差距並沒有因此縮小。這篇論文的實驗停在 2017 年的 CNN 與 LSTM,它的結論不能直接外推到這類模型。
結論
這篇論文用一個構造例證明,在過度參數化的問題上,自適應方法和 SGD 會走到不同的解;在特定的資料結構下,自適應方法學到的解可以把新資料錯判一半,SGD 則完全正確。四個實驗裡,只調學習率與衰減時,SGD 和 HB 的測試成績都比較好,預設值的 Adam 更是明顯落後。兩年後 Choi 等人重跑同一份程式碼,把 等超參數一起調,CIFAR-10 上的差距就消失了。
讀優化器比較的論文時,先找調參的那一段,看調了哪些超參數、各調了幾組、用什麼挑設定。自己做比較也一樣,Adam 至少要調學習率、學習率排程和 ,並像這篇的附錄那樣,把每個方法實際試過的網格寫出來。
Choi 等人在 ImageNet 上訓練 ResNet-50,最好的那組 NAdam, 是 9475。這個原本只用來避免除以零的常數,在 Wilson 等人的網格裡根本沒有位置。