原始論文
On the Variance of the Adaptive Learning Rate and Beyond
- 發表版本
- ICLR 2020會議
- arXiv 首次提交
- arXiv:1908.03265
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersradam2019,
  title = {{On the Variance of the Adaptive Learning Rate and Beyond}},
  author = {Liyuan Liu and Haoming Jiang and Pengcheng He and Weizhu Chen and Xiaodong Liu and Jianfeng Gao and Jiawei Han},
  year = {2019},
  eprint = {1908.03265},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1908.03265}
}
If warmup is the answer, what is the question?
這是 RAdam 在 GitHub 上的開場白。暖身(warmup)在當時已經是訓練 Transformer 的標準配備,前幾千步把學習率從接近 0 慢慢拉上去,Adam 才訓練得起來;至於為什麼非這樣不可,當時缺少理論上的解釋,暖身要多長,各家多半靠試誤。
2019 年 8 月,伊利諾大學與微軟的 Liyuan Liu 等人放出這篇論文,說原因出在 Adam 的自適應學習率,訓練初期看過的梯度太少,它的變異數大到失控。他們順手提出一個修正版,叫 Rectified Adam,簡稱 RAdam。
論文放上 arXiv 大約一週後,Less Wright 在 fast.ai 論壇和 Medium 上把它介紹成「新的 SOTA 優化器」,論壇上很快就有人拿去測試。又過了兩個月,Jerry Ma 與 Denis Yarats 發表了一篇反駁,說 RAdam 拆開來看,就是 Adam 加上一段固定的暖身。
這篇筆記把兩邊都看一遍。
定義問題
Adam 的自適應學習率
作者先把各種自適應優化器寫成同一個框架(Algorithm 1)。每一步算出動量 與自適應學習率 ,再更新 。所有運算都是逐元素的。Adam 的 是:
也就是二階動差估計開根號後取倒數,分子的 是偏差修正。梯度一直很大的參數,步伐就縮小;梯度一直很小的參數,步伐就放大。
不暖身會怎樣
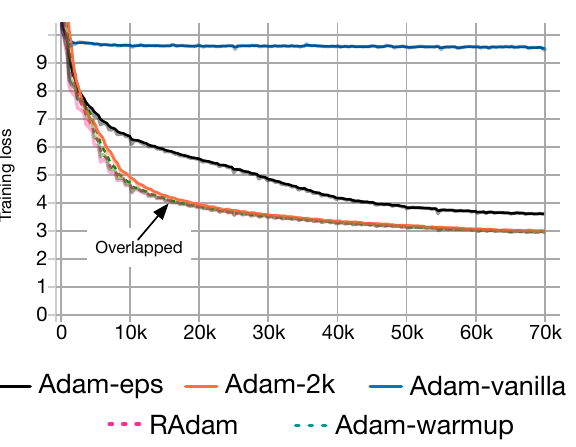
先看藍線 Adam-vanilla 和最下面的 Adam-warmup。同一個 Transformer、同一份 IWSLT'14 德翻英資料,不暖身的訓練損失停在 10 附近,暖身之後降到 3 以下。其他三條線是作者的對照實驗,等一下會講到。
作者把每一步梯度絕對值的分布畫出來,發現不暖身時,前 10 步之內分布就被扭曲,重心擠到很小的值。他們的解讀是,Adam 在最初幾步做了有害的更新,把模型帶進一個不好的區域,暖身的作用是降低這些更新的影響。
那麼,最初幾步的更新為什麼有害?
解決問題
第一步只有一個樣本
先看最極端的 。這時 ,整個自適應學習率只靠一個梯度估出來。
假設梯度服從 ,那麼 服從自由度為 1 的縮放逆卡方分布, 的變異數是發散的。直覺上也不難理解, 只要剛好很接近 0, 就會非常大。
小的學習率可以壓住這個變異數,因為 。這就是作者對暖身的解釋,訓練初期自適應學習率的變異數太大,暖身用小的 把它壓下來。
兩個對照實驗
如果問題真的出在變異數,那麼換個方式降低變異數,應該也能解決。作者設計了兩個 Adam 的變體。
- Adam-2k:前 2,000 次迭代只更新 ,動量和參數都凍住,等於先多看 2,000 個樣本把二階動差估準,再開始訓練。
- Adam-eps:把分母的 從 加大到 ,直接限制 的上限。
前面那張圖裡,Adam-2k 沒有暖身,卻和 Adam-warmup 疊在一起;梯度分布也不再被扭曲。Adam-eps 同樣避開了卡在 10 的問題,但最後停在 3.6 左右,比暖身差。作者推測,太大的 在自適應學習率裡引入了偏差,拖慢了最佳化,所以需要一個更有原則的方法。
變異數隨樣本數下降
接下來要把變異數算出來。Adam 用的是指數移動平均(EMA),不好分析,作者把它近似成簡單移動平均(SMA),並假設 服從自由度為 的縮放逆卡方分布。這裡的 可以理解成「估計二階動差時,等效用了幾個樣本」。
Theorem 1 說,在這個假設下, 的變異數隨 增加而單調遞減,並在 時給出閉合式(式 (2))。換句話說,樣本越少,自適應學習率越不可靠; 時,論文把這段的變異數當成無法處理(intractable)。
EMA 等效於幾個樣本
那麼第 步的 EMA,相當於多長的 SMA?作者要求兩者的「重心」相同,也就是各樣本的時間位置用權重平均起來要一樣,解出:
是 的極限。用預設的 代進去,。前幾步的 算出來是:
| 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|
| 1.000 | 1.999 | 2.999 | 3.997 | 4.996 |
依原論文的 定義計算,。
訓練初期 幾乎就等於 ,很符合直覺,看過幾個梯度,就等效用了幾個樣本。 越接近 1,EMA 的記憶越長, 要越久才會接近上限。
整流項
有了 ,作者把目標定成讓自適應學習率的變異數在每一步都一樣,等於 時的最小值 。做法是乘上一個縮放因子 。
式 (2) 的閉合式在數值上不穩定,作者改用一階近似,得到式 (5):
把 和 各代一次再相除, 就消掉了:
這就是 RAdam 名字裡的 rectification(整流)。我們算幾個點看看它長什麼樣:
| 步數 | 5 | 10 | 100 | 1,000 | 2,000 | 5,000 |
|---|---|---|---|---|---|---|
| 0.017 | 0.049 | 0.215 | 0.645 | 0.828 | 0.983 |
依原論文 4.2 節的 計算,。
一開始非常小,一千步時約 0.65,到五千步才接近 1。這條曲線乘在學習率前面,看起來就是一段暖身。
完整的演算法
整理成 Algorithm 2,每一步做的事情是:
- 算梯度 ,更新二階動差 與一階動差 。
- 偏差修正一階動差,。
- 計算 。
- 如果 ,計算 與 ,更新 。
- 否則,不用自適應學習率,直接 。
第 5 步就是 RAdam 退化成動量 SGD 的情況。照前面 的表, 時 的只有 到 4,所以前 4 步是帶偏差修正的動量 SGD,第 5 步起才進入整流後的 Adam。後來 Ma 與 Yarats 證明,只要 , 恰好等價於 。論文另外提到,若 ,,RAdam 就整個退化成動量 SGD。
和暖身的關係
作者在 4.3 節直接拿 和線性暖身比較。線性暖身等於把學習率乘上 ,形式上和 很像,所以他們認為這驗證了「暖身是一種降低變異數的技巧」。差別在於 RAdam 不需要暖身長度 這個超參數,而且會隨著 自動調整。
他們也強調,這個修正和梯度裁剪、調大 、初始化、正規化層等穩定訓練的技巧互相獨立,可以一起用。
討論
實驗設定
實驗分三類,Adam 類方法的權重衰減都採用 AdamW 的解耦寫法。
- 語言模型:One Billion Word,兩層 LSTM、2,048 個隱藏單元,學習率 0.001,批次大小 128。
- 影像分類:CIFAR-10 用 ResNet-20(186 個 epoch),ImageNet 用 ResNet-18(90 個 epoch),學習率階梯式下降,權重衰減 。
- 機器翻譯:fairseq 的 Transformer,IWSLT'14 德英互譯與 WMT'16 英翻德;Adam 用 4,000 步線性暖身。
語言模型與影像實驗中,Adam 與 RAdam 的 都是 。
和原版 Adam 比
不暖身的情況下,RAdam 在三個資料集上都贏過原版 Adam。One Billion Word 的測試困惑度從 36.92 降到 35.70;RAdam 在最初幾個 epoch 比 Adam 慢,之後收斂得比較快。影像分類的測試準確率如下:
| 資料集 | SGD | Adam | RAdam |
|---|---|---|---|
| CIFAR-10 | 91.51 | 90.54 | 91.38 |
| ImageNet | 69.86 | 66.54 | 67.62 |
整理自原論文 Table 1(%)。
RAdam 比 Adam 好,但兩個資料集上都沒有贏過 SGD。作者另外報告 ImageNet 的訓練準確率,SGD、Adam、RAdam 分別是 69.57、69.12、70.30,RAdam 最高。訓練得比 SGD 好、測試卻比較差,差距看起來出在泛化,不過這是從訓練準確率推回去的判斷,論文本身沒有這樣分析。
對學習率不敏感
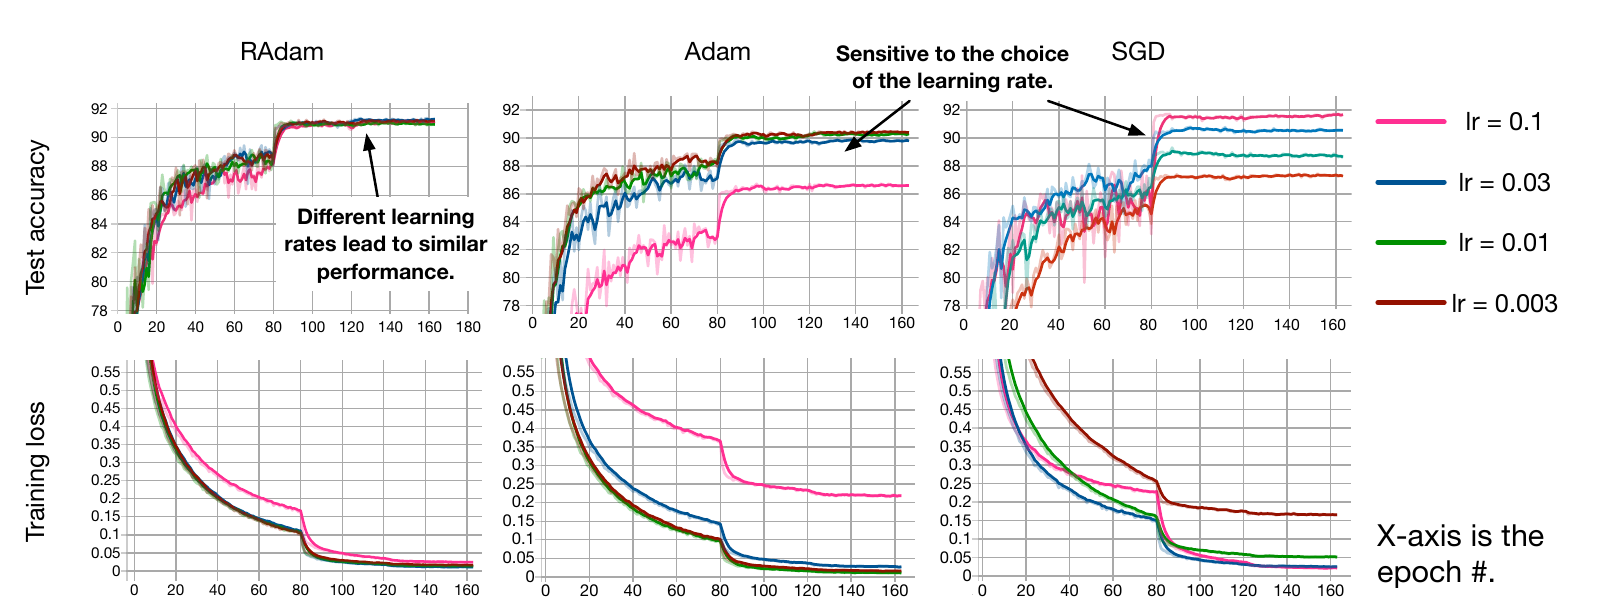
學習率在 0.1 到 0.003 之間變動時,RAdam 的四條測試準確率曲線幾乎疊在一起;Adam 在學習率 0.1 時掉到約 86%,SGD 則四條線各走各的。作者把這解讀成整流讓 RAdam 能適應更大範圍的學習率。不過 README 的常見問題也老實寫著,RAdam 的穩健性不是無限的,學習率還是要調。
和暖身比
翻譯是最離不開暖身的場景,所以這裡的對手換成調好的 Adam 加暖身:
| 任務 | Adam + 暖身 | RAdam |
|---|---|---|
| IWSLT'14 德→英 | 34.66 | 34.76 |
| IWSLT'14 英→德 | 28.56 | 28.48 |
| WMT'16 英→德 | 27.03 | 27.27 |
整理自原論文 Table 2;BLEU,IWSLT 為 5 個隨機種子的平均。
兩者打平,作者的結論也是「達到和暖身相近的效果」。這裡有一個附錄才看得到的設定。翻譯實驗的 設成 0.9995,附錄寫的理由是讓 。代進 ,正好是 3,999,和 Adam 那組的 4,000 步暖身對齊。也就是說,在這組比較裡,RAdam 的「自動暖身」長度是透過 對齊過的。
CIFAR-10 上,Adam 加暖身的最佳準確率是 91.29%,和 RAdam 的 91.38% 相當;但暖身長度有 100、200、500、1,000 步可選,學習率 0.1 配 100 步暖身時只有 90.13%,同一個學習率下 RAdam 是 91.06%。作者的主張因此比較精確地說,是 RAdam 少了一個要調的超參數,最好的成績本身差不多。
前幾步的動量 SGD
退化成動量 SGD 那幾步重要嗎?附錄 C 在 CIFAR-10、學習率 0.1 下做了替換實驗(5 次平均)。全程 RAdam 的測試準確率是 91.08%;把前 4 步換成普通 Adam,掉到 89.98%;前 4 步用 SGD、第 5 到 8 步換成未整流的 Adam,則是 90.29%。作者認為這符合理論,越早的更新傷害越大,但也說明這部分只是演算法裡次要的設計,重點在暖身的機制與整流項的推導。
Ma 與 Yarats 的反駁
2019 年 10 月,Jerry Ma(芝加哥大學)與 Denis Yarats(紐約大學、Facebook AI Research)在 arXiv 放出〈On the Adequacy of Untuned Warmup for Adaptive Optimization〉(AAAI 2021)。摘要開門見山,說他們要反駁這份分析。論點有三層。
第一,RAdam 是一段固定的暖身。 只跟 和 有關,和梯度實際長什麼樣完全無關。前面已經提到, 恰好是前 4 步,所以 RAdam 可以用一句話描述,先做 4 步動量 SGD,之後是套上固定暖身排程的 Adam。他們也試過把前 4 步換成什麼都不做、或用很小學習率的 Adam,差別都可以忽略。
第二,變異數的論證有漏洞。 RAdam 假設梯度均值為 0,但訓練初期模型離極小值很遠,梯度的均值通常比標準差還大;他們在 EMNIST 上量到,大約要到第 50 步,多數參數的變異係數才穩定超過 1。更關鍵的是,Adam 實際的更新量是 ,而 和 高度相關。第 1 步時兩者甚至完全相等,每個參數的更新量都恰好是 ( 時)。換句話說,自適應學習率的變異數「發散」的那一步,實際更新量的變異數是 0。
第三,該看的是更新量的大小。 他們做了一個模擬,讓梯度在一個極小值附近純粹是零均值的雜訊,跑 Adam 看更新量。結果更新量從 開始,大約 40 步後才穩定在 左右。也就是說,即使模型已經停在極小值上,Adam 剛開始的幾十步也會邁出偏大的步伐;SGD 在同樣的情況下不需要暖身,這可以部分解釋為什麼 Adam 比 SGD 更需要暖身。
在這些分析之上,他們提出兩條不用調的經驗法則:
前者的時間常數 是仿照 Adam 二階動差的偏差修正項 選的,作者自己也說這個直覺純屬推測;後者是 步的線性暖身, 時就是 2,000 步。
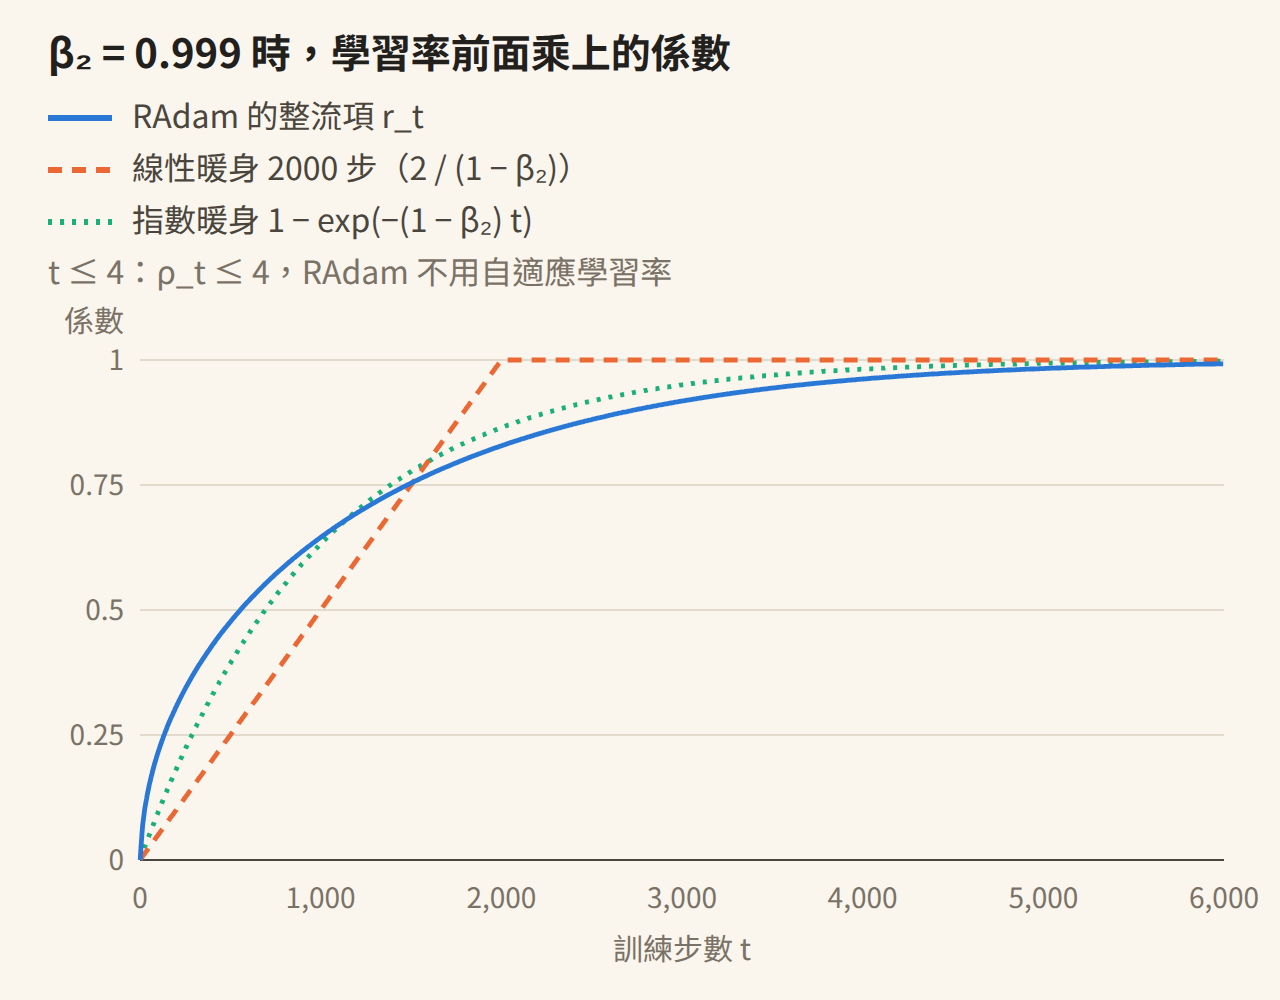
三條曲線的形狀不完全一樣,RAdam 在前幾百步上升得最快,過了 1,500 步左右反而落在最後。Ma 與 Yarats 用「有效暖身長度」 來比較,也就是暖身總共壓掉了多少步的學習率; 時,三者都在 1,000 步左右(照公式算,RAdam 約 1,033 步),而且在各種 下都幾乎一樣。
實驗也支持這個說法。他們在 ImageNet 的 ResNet-50、WikiText-103 的 Transformer 語言模型、WMT16 英翻德的 Transformer 上,各掃 9 到 12 組學習率與 ,三種方法的差距多半只有零點幾。以 ImageNet 的 top-1 誤差為例(5 個隨機種子):
| 學習率 | 指數 | 線性 | RAdam | |
|---|---|---|---|---|
| 0.99 | 27.9 | 28.0 | 28.4 | |
| 0.997 | 27.9 | 27.9 | 28.3 | |
| 0.999 | 28.2 | 28.3 | 28.4 |
整理自 Ma & Yarats Table 1,節錄學習率 的三列(%)。
這三列裡 RAdam 反而略差一點。整張表差最多的一組是學習率 、,RAdam 的誤差比兩條經驗法則高了約 1 個百分點。他們的建議是,用 Adam 時就做 步的線性暖身。
誰比較對?
兩篇論文都同意 Adam 在最初幾千步需要比較小的學習率,分歧在於為什麼。
RAdam 這邊的證據,是 Adam-2k 這類對照實驗,以及在翻譯與影像上和調好的暖身打平。Ma 與 Yarats 那邊,則指出 只是一個由 決定的固定排程,並用更新量的分析與跨三個任務的實驗說明,不用調參的線性暖身就能做到一樣的事。RAdam 的論文正式版沒有回應這篇反駁;README 的常見問題倒是承認,當梯度均值遠大於變異數時,變異數的問題可能不大,並把這當成某些模型比較需要暖身的可能解釋。
零均值這個假設,RAdam 論文自己在 5.3 節用模擬檢查過。梯度改從 取樣, 取 0、0.001、0.01、0.1、1、10 六種,,各跑 5,000 條、每條 6,000 步的軌跡;六種情況下,原始自適應學習率的變異數都在初期偏大,整流後大致維持一致。同一節也確認式 (5) 的一階近似和式 (2) 的閉合式幾乎重疊。這組模擬量的仍是自適應學習率本身的變異數,沒有涉及 Ma 與 Yarats 指出的 與 的相關性。
Ma 與 Yarats 也沒有把問題完全解決。他們的模擬顯示更新量大約 40 步就穩定,照這個邏輯,暖身幾百步應該就夠;可是不論 RAdam 還是他們的經驗法則,有效暖身都在 1,000 步左右,有些手調的暖身甚至拉到一萬步。他們在討論裡自己寫,Adam 為什麼需要這麼長的暖身,仍是一個未解的問題。
站在工程的角度,雙方在實務上的結論一致,RAdam 等價於一段長度約 步的暖身。這也帶出一個容易忽略的後果。後來的大型語言模型常把 設成 0.95,例如 GPT-3 和 LLaMA;這時 ,照公式算,RAdam 內建的有效暖身只有約 24 步,而 LLaMA 實際用的是 2,000 步暖身。
整流項本身倒是被保留了下來。PyTorch 內建了 torch.optim.RAdam;Schedule-Free 的官方套件在 2024 年底也收進一個社群貢獻的 RAdam 版本,說明寫著連暖身都可以省掉。
結論
RAdam 從 Adam 的自適應學習率出發,用 SMA 近似估出第 步等效的樣本數 ,再用整流項 把變異數拉到一致; 的前幾步則直接退化成動量 SGD。在翻譯與影像分類上,它不必另外設定暖身長度(翻譯實驗的 有特別對齊),就能追上調好的 Adam 加暖身。Ma 與 Yarats 隨後指出, 只是一段由 決定的固定暖身,簡單的線性暖身就能取得幾乎相同的結果。
如果你手上已經有調好的暖身,換成 RAdam 多半不會多得到什麼;如果沒有,RAdam 和「線性暖身 步」是兩個差不多可靠的起點。只是要記得,用 RAdam 時改 ,等於同時改了暖身長度。
README 開頭問,如果暖身是答案,問題是什麼。Ma 與 Yarats 給的答案是 Adam 初期的更新量太大;至於為什麼要暖這麼久,他們自己也承認還不知道。