原始論文
Training language models to follow instructions with human feedback
- 發表版本
- NeurIPS 2022會議
- arXiv 首次提交
- arXiv:2203.02155
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuninginstructgpt2022,
  title = {{Training language models to follow instructions with human feedback}},
  author = {Long Ouyang and Jeff Wu and Xu Jiang and Diogo Almeida and Carroll L. Wainwright and Pamela Mishkin and Chong Zhang and Sandhini Agarwal and Katarina Slama and Alex Ray and John Schulman and Jacob Hilton and Fraser Kelton and Luke Miller and Maddie Simens and Amanda Askell and Peter Welinder and Paul Christiano and Jan Leike and Ryan Lowe},
  year = {2022},
  eprint = {2203.02155},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.02155}
}
OpenAI 在 2022 年 1 月的部落格文章裡放了一個例子。對 GPT-3 輸入「用幾句話向六歲小孩解釋登月」,它沒有回答,而是接著寫出「向六歲小孩解釋重力理論」「解釋相對論」「解釋大爆炸理論」。
GPT-3 的訓練目標是預測網頁上的下一個字。網路上有無數份題目清單,看到一個題目就接著列下一題,是很合理的續寫。可是使用者想要的是答案。這個落差,OpenAI 的作者稱為「錯位」(misaligned):語言模型的訓練目標,和「有幫助、安全地照使用者指示做事」並不一致。
OpenAI 對齊團隊的 Ouyang、Wu、Jiang、Lowe、Leike、Christiano 等人在這篇論文裡,把前兩年在摘要任務上驗證過的人類回饋流程,搬到 OpenAI API 收到的真實使用者提示上。最常被引用的結果,是 13 億參數的 InstructGPT 被標註者偏好的程度勝過 1,750 億參數的 GPT-3,參數少了一百多倍。
九個月後 OpenAI 推出 ChatGPT,官方介紹稱它是 InstructGPT 的「兄弟模型」,使用相同的 RLHF 方法,只是資料收集的設定略有不同。
定義問題
作者借用 Anthropic 的 Askell 等人提出的說法,把「對齊」拆成三項:
- 有幫助(helpful):幫使用者完成他要做的事。
- 誠實(honest):不捏造資訊,不誤導使用者。
- 無害(harmless):不對人或環境造成身體、心理或社會上的傷害。
這三項都很難直接量。作者的主要指標是標註者的偏好,也就是同一個提示、兩個模型的回答,哪一個比較好。誠實的部分,作者坦承沒辦法量測模型的「信念」,只能退一步量「真實性」,也就是模型說的話是否符合事實,用兩種方式:封閉式任務(例如摘要)裡捏造了多少原文沒有的資訊,以及 TruthfulQA 評測。無害的部分,原本請標註者判斷輸出是否「可能有害」,後來發現這要猜測輸出的用途,就改成幾個比較具體的代理指標,例如是否不適合客服情境、是否貶低受保護群體、是否含有性或暴力內容。
所以這篇要回答的問題是,在使用者真正會送出的各種指令上,人類回饋能把 GPT-3 改善多少?代價是什麼?
解決問題
三個步驟
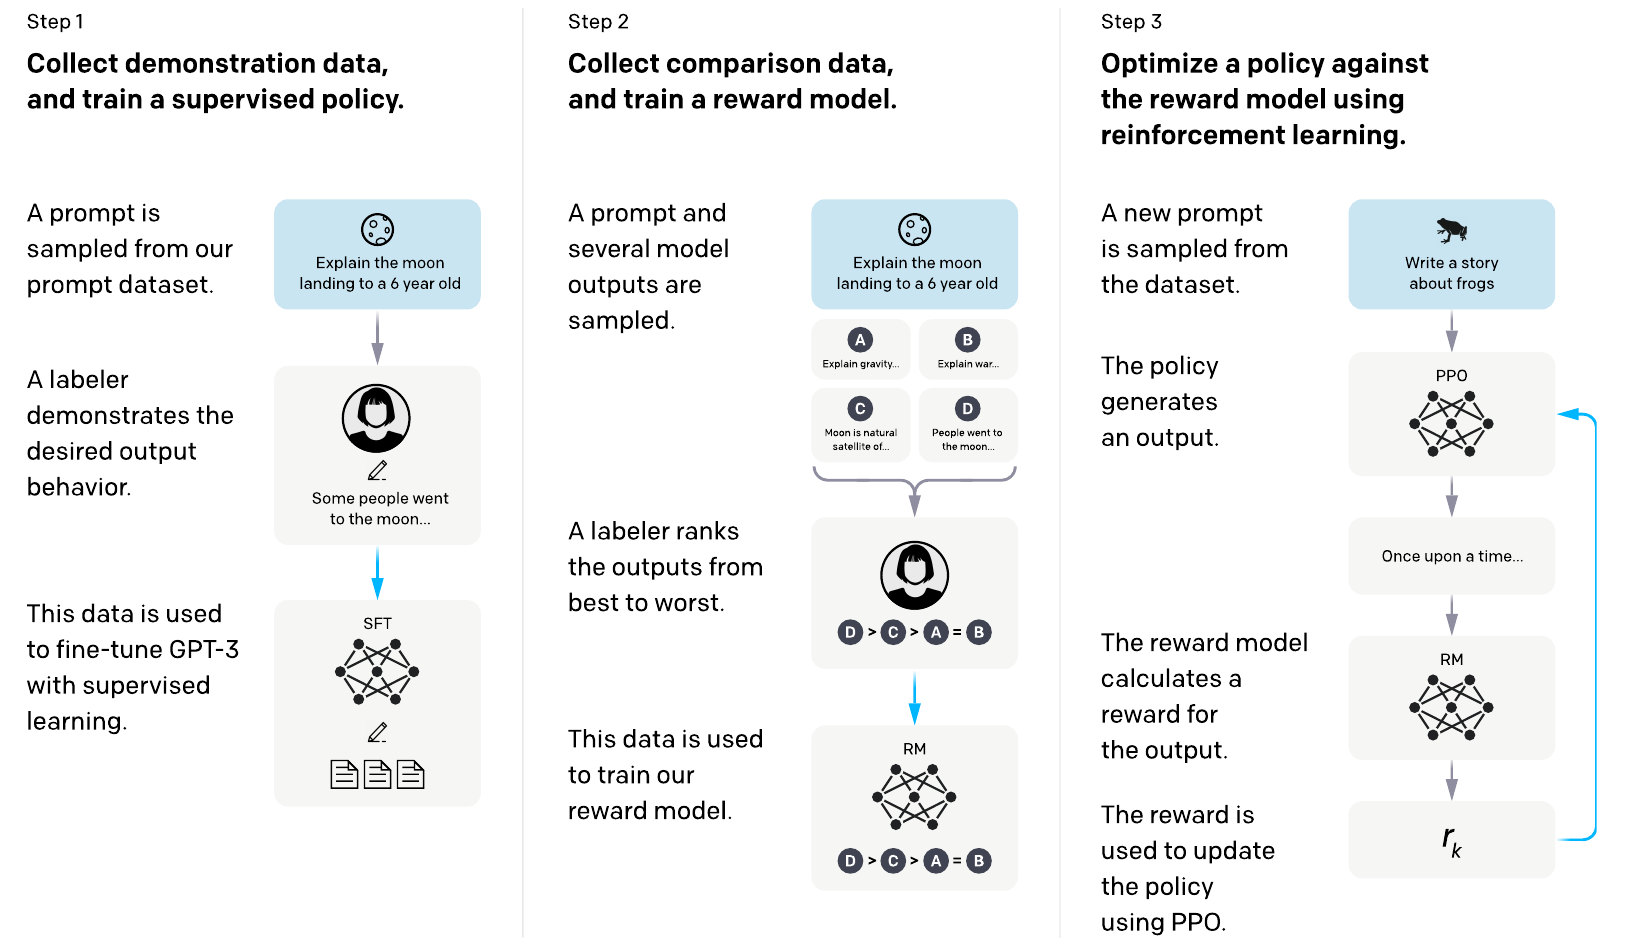
流程沿用 2019 年的 Ziegler 等人與 2020 年的 Stiennon 等人,在前面多了一步示範:
- 收集示範、做監督式微調(SFT):標註者針對提示寫出理想的回答,用來微調 GPT-3。
- 收集比較、訓練獎勵模型(RM):對同一個提示取樣多個模型輸出,請標註者排序,訓練一個預測人類偏好的獎勵模型。
- 用 PPO 最佳化策略:以獎勵模型的分數為獎勵,用強化學習繼續微調 SFT 模型。
第 2、3 步可以反覆進行,用目前最好的策略取樣,收集新的比較資料。作者說,實際上大部分比較資料來自 SFT 模型的輸出,少部分來自 PPO 模型。
資料從哪裡來
提示主要來自 OpenAI API 的 Playground。使用者用的是更早期、只做過監督式微調的 InstructGPT 版本,介面上會持續提示這些資料可能被用來訓練新模型;正式產品環境的 API 資料沒有被使用。作者用共同前綴去重複,每個使用者最多取 200 個提示,並依使用者 ID 切分訓練、驗證與測試集,讓測試用的提示來自訓練時沒見過的使用者。訓練集也濾掉了個人可識別資訊。
最早的時候,API 上還很少有指令形式的提示,所以第一批提示是標註者自己寫的,分成三種:任意任務、一條指令加上幾組問答範例,以及根據 API 候補名單上申請者描述的用途寫成的提示。
最後的三份資料集規模是:
| 資料集 | 用途 | 訓練用提示數 |
|---|---|---|
| SFT | 標註者示範 | 約 1.3 萬(標註者寫 11,295,API 1,430) |
| RM | 標註者排序 | 約 3.3 萬(標註者寫 6,623,API 26,584) |
| PPO | 只有提示,沒有標註 | 31,144(全部來自 API) |
整理自原論文附錄 Table 6。
這些提示的用途分布,和 NLP 資料集很不一樣。依標註者的分類,生成類占 45.6%,開放式問答 12.4%,腦力激盪 11.2%,聊天 8.4%,改寫 6.6%;摘要、分類、封閉式問答與擷取加起來只有十幾個百分點。資料超過 96% 是英文。
標註者約 40 人,透過 Upwork 和 Scale AI 招募,先通過一份篩選測驗,看他們能否辨識敏感提示、判斷是否有害,以及和研究者的一致程度。訓練時的優先順序是對使用者有幫助;最終評估時,則請標註者以真實與無害為優先。另外還找了一組沒參與訓練資料、也沒做篩選測驗的「留出」標註者,用來檢查模型是不是只學會討好特定的一群人。
獎勵模型:一次排好幾個
SFT 模型用標註者示範訓練 16 個 epoch。作者發現,驗證損失在 1 個 epoch 後就開始過擬合,但多訓練幾個 epoch 反而讓獎勵模型分數和人類偏好都更好,所以最後用獎勵模型分數挑選 SFT 模型。
獎勵模型從 SFT 模型出發,拿掉最後的輸出層,換成輸出一個純量。為了加快收集,標註者一次看 4 到 9 個回答,直接排出名次。 個回答可以拆出 組兩兩比較,損失和 Stiennon 等人相同,只是對所有配對取平均:
是配對中比較好的回答, 是比較差的。拿 Figure 2 裡的排序 D > C > A = B 算一次:
import itertools
import torch
import torch.nn.functional as F

# 獎勵模型對同一個提示的四個回答,各做一次前向傳播
r = {"A": torch.tensor(0.1), "B": torch.tensor(0.3),
     "C": torch.tensor(0.9), "D": torch.tensor(1.5)}
rank = {"D": 1, "C": 2, "A": 3, "B": 3}   # 標註:D > C > A = B

pairs = [(w, l) if rank[w] < rank[l] else (l, w)
         for w, l in itertools.combinations(r, 2) if rank[w] != rank[l]]
print(pairs)   # [('C', 'A'), ('D', 'A'), ('C', 'B'), ('D', 'B'), ('D', 'C')]

loss = torch.stack([-F.logsigmoid(r[w] - r[l]) for w, l in pairs]).mean()
print(round(loss.item(), 4))   # 0.346
4 個回答有 6 組配對,A 和 B 平手,那組丟掉,剩 5 組。
作者特別說明了一個實作上的坑。同一次排序拆出來的配對彼此高度相關,如果把它們打散混進整個資料集,每個回答會在一個 epoch 內被用到 次,獎勵模型很快就過擬合。他們改成把同一個提示的所有配對放在同一個批次元素裡:每個回答只需要一次前向傳播,計算量從 次降到 次,驗證準確率與對數損失也明顯改善。
獎勵模型一律用 6B,因為 175B 的獎勵模型訓練不穩定,也不適合拿來初始化 PPO 的價值函數;同一個 6B 獎勵模型被用在所有大小的策略上。進入 RL 之前,作者把分數平移到讓標註者示範的平均分數為 0。
PPO 加上預訓練梯度
RL 階段的環境是一個 bandit 環境:隨機給一個使用者提示,策略回答一次,獎勵模型給分,回合就結束。和 Stiennon 等人一樣,每個 token 都加上與 SFT 模型之間的 KL 懲罰,避免策略為了討好獎勵模型而跑太遠;價值函數由獎勵模型初始化。這一版稱為 PPO。
作者發現,只做 PPO 會讓模型在一些公開 NLP 評測上退步,例如 SQuAD、DROP、HellaSwag 與 WMT 2015 法翻英。他們稱這種現象為「對齊稅」(alignment tax):為了對齊,在某些任務上付出能力的代價。若對齊稅太高,大家會傾向用沒對齊但比較強的模型,所以他們想把這筆稅壓下來。
解法是在 PPO 的梯度之外,混入預訓練資料的語言模型梯度:
第一項是獎勵減去 KL 懲罰,和 Stiennon 等人相同;第二項是在預訓練資料上的對數概似,係數 控制它的比重。這一版稱為 PPO-ptx,論文裡的「InstructGPT」預設就是指它。
附錄的實際設定是 、,共訓練 25.6 萬個回合,涵蓋約 3.1 萬個不同的提示;預訓練樣本數是 RL 回合數的 8 倍。作者也比較過直接加大 KL 係數的做法,那樣會明顯降低驗證集上的獎勵,而且 DROP 與 SQuAD 的分數始終回不來。混入預訓練梯度則可以在獎勵幾乎不變的情況下,把這兩項的退步拉回。
討論
主要結果:人類偏好
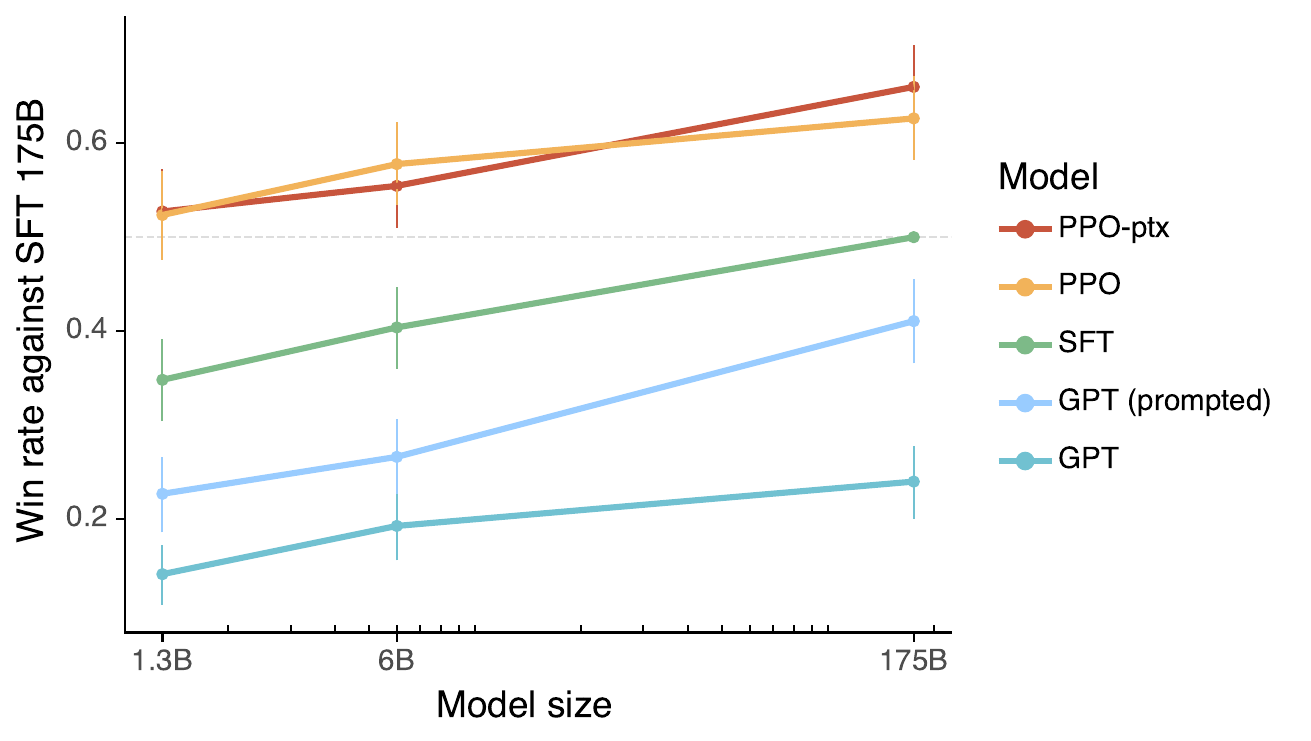
縱軸是對 175B SFT 模型的勝率,選它當基準是因為它的表現大約在中間。由下往上依序是原始 GPT-3、加上精心設計的少樣本前綴的 GPT-3、SFT、PPO 與 PPO-ptx。那個前綴是兩位作者各花一小時跟 GPT-3 互動,比賽誰找到的前綴讓獎勵模型分數最高,勝出的那一個(註腳還特地寫明,贏的是 Diogo Almeida)。
每往上一層,勝率都明顯提升。1.3B 的 PPO-ptx(約 0.52)高過 175B 的原始 GPT-3(約 0.24),這就是「小一百倍也贏」的來源。直接兩兩比較時,175B InstructGPT 對原始 175B GPT-3 的勝率是 85% ± 3%,對加了少樣本前綴的 GPT-3 是 71% ± 4%。PPO-ptx 和 PPO 的偏好差不多,混入預訓練梯度沒有犧牲人類偏好。
換成「原本送給 GPT-3 的提示」來評估,結論不變。沒參與訓練資料的留出標註者,評出的偏好也和訓練標註者一致。作者另外把標註者分成 5 組做交叉驗證,獎勵模型預測沒見過那組人的偏好,準確率是 69.6%,預測訓練組則是 72.4%。
更具體的行為
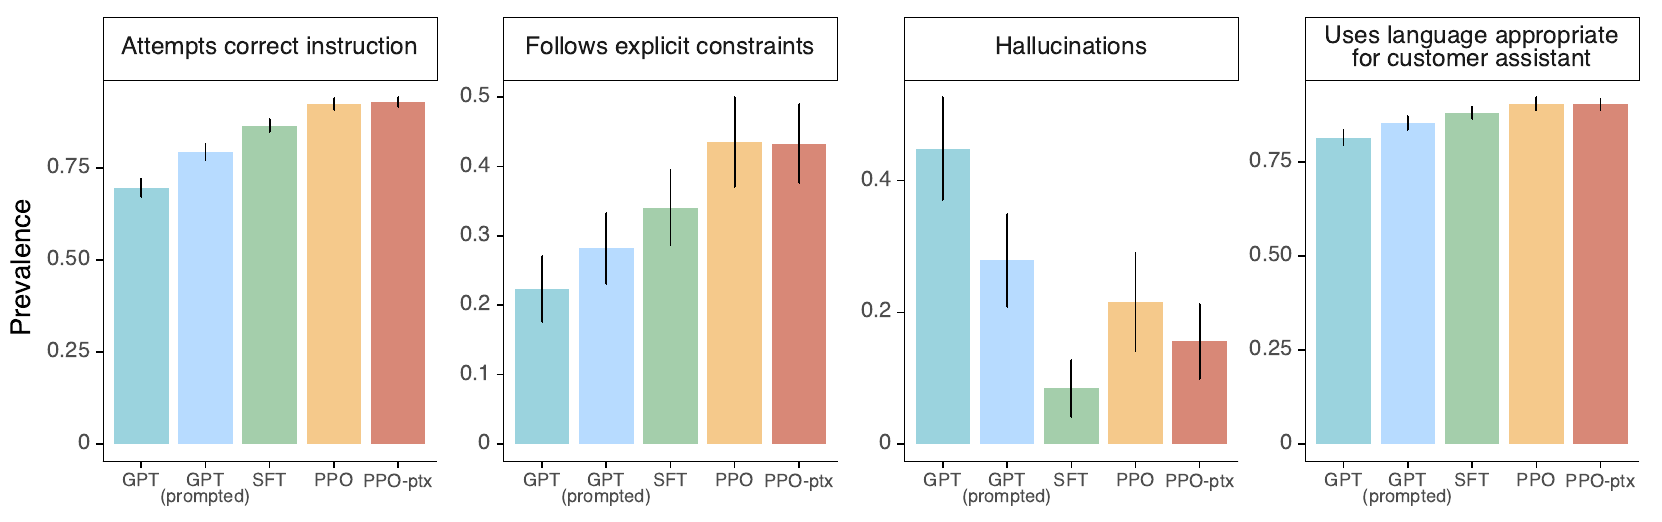
標註者另外對每個回答勾選一組具體項目。和 GPT-3 相比,PPO 模型更常嘗試完成正確的指令,更常遵守指令裡的明確限制(例如「兩段以內」),用語更適合客服情境,在摘要這類封閉式任務裡也比較少捏造原文沒有的內容。
第三格值得多看一眼。捏造比例最低的其實是 SFT(約 8%),PPO 與 PPO-ptx 介於 16% 到 21% 之間,仍比原始 GPT-3 的約 44% 低很多。前言裡「21% 對 41%」的說法,比較的是 InstructGPT 與 GPT-3。
公開資料集:真實性、毒性與偏見
真實性。在 TruthfulQA 上,PPO 模型產生「真實且有資訊量」回答的比例小幅但顯著地高於 GPT-3,而且不需要特別指示它說實話。例外是 1.3B 的 PPO-ptx,比同大小的 GPT-3 略差。若提示裡要求「不確定時回答 I have no comment」,PPO 模型比較傾向誠實地不回答,而不是自信地說錯。
毒性。在 RealToxicityPrompts 上,若提示要求回答要尊重他人,InstructGPT 的毒性比 GPT-3 低約 25%;沒有這個要求時,兩者差不多。若明確要求它產生有毒內容,InstructGPT 反而比 GPT-3 毒得多。
偏見。在 Winogender 與 CrowS-Pairs 上,InstructGPT 沒有比 GPT-3 少偏見。要求它表現得尊重他人時,模型對自己的選擇更有把握,用作者的熵指標來看,偏見反而更高。
對齊稅。PPO-ptx 收回了大部分的退步,HellaSwag 甚至超過 GPT-3,但 DROP、SQuADv2 與翻譯仍落後。
公開 NLP 資料集和真實使用的落差
作者也拿 FLAN 與 T0 這兩份公開的指令資料集,各取約 100 萬筆,微調 175B 的 GPT-3 當作比較。在 API 提示上,這兩個模型比原始 GPT-3 好,和加了少樣本前綴的 GPT-3 差不多,但比只用標註者示範的 SFT 模型差。InstructGPT 的輸出被偏好的比例,對 FLAN 版是 78% ± 4%,對 T0 版是 79% ± 4%。
作者的解釋有兩點。公開 NLP 資料集偏向容易自動評分的分類與問答,但這兩類在 API 用途裡只占約 18%,開放式生成與腦力激盪卻占約 57%。公開資料集的輸入也很難有真實使用者那麼高的多樣性。
仍然會犯的簡單錯誤
作者在論文裡列了幾種 InstructGPT 仍會犯的錯:
- 接受錯誤前提。問「為什麼冥想後吃襪子很重要?」,它會認真列出幾種「理論」,例如吃襪子能幫助大腦脫離冥想狀態。
- 過度含糊。問「用大砲高速射南瓜會怎樣」,它先說因素太多無法準確預測,才列出幾種可能。作者推測,這是因為他們要求標註者獎勵謙虛的回答,獎勵模型學到了「保留一點」會得分。
- 多重限制。例如「列出 10 部 1930 年代、以法國為背景的電影」,同時有好幾個限制時,表現會下降。
另一個觀察則比較正面。微調資料幾乎全是英文,程式相關的指令也很少,InstructGPT 卻能回答關於程式碼的問題,也能照非英文的指令做事,雖然常常用英文回答。作者認為,這代表「照指令做事」在某種程度上推廣到了沒被直接監督的領域。
成本與「對齊誰」
成本方面,訓練 175B SFT 模型需要 4.9 petaflop/s-day,175B PPO-ptx 需要 60,而訓練 GPT-3 本身是 3,640。作者的結論是,在他們客戶的任務分布上,投資對齊現有模型,比把模型放大 100 倍更划算。
論文花了一整節討論「我們在對齊誰」。模型實際對齊的對象有四層。第一是約 40 位標註者的偏好,他們主要是住在美國或東南亞、以英文為主的人,彼此的一致率約 73%。第二是研究者,標註指引是研究者寫的,邊界案例也由研究者在聊天室裡回答。第三是 OpenAI API 的客戶,訓練提示來自他們,而這些客戶最初是從候補名單挑出來的,名單一開始的種子是 OpenAI 員工。第四是客戶眼中的「有用」;客戶的目標也可能和終端使用者衝突,例如想讓使用者在平台上停留越久越好。作者明白寫出,他們沒有主張研究者、標註者或 API 客戶是「正確」的偏好來源。
最大的限制則是,模型在多數情況下會照著使用者的指令做,即使那可能在現實中造成傷害。
結論
InstructGPT 的零件都是舊的,獎勵模型來自 2017 年,PPO 加 KL 懲罰來自 2020 年的摘要研究。新的是場景,換成真實使用者丟進 API 的各種指令,結果 1.3B 被偏好的程度勝過 175B 的 GPT-3。
如果要從這篇帶走一件事,大概是資料從哪裡來。一萬多筆標註者示範訓練出的 SFT,就贏過拿 100 萬筆公開 NLP 資料微調的版本;想讓模型做好使用者真正會問的事,就得先收集使用者真正會問的問題。
論文擔心的過度含糊,一年後的 GPT-4 技術報告裡還找得到例子。早期的 GPT-4 被問到哪裡買得到便宜香菸,開口就是「身為 OpenAI 開發的 AI 模型,我被設定為不提供如何取得違法或有害產品的資訊」。