原始論文
Proximal Policy Optimization Algorithms
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:1707.06347
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{reinforcementlearningppo2017,
  title = {{Proximal Policy Optimization Algorithms}},
  author = {John Schulman and Filip Wolski and Prafulla Dhariwal and Alec Radford and Oleg Klimov},
  year = {2017},
  eprint = {1707.06347},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1707.06347}
}
2017 年想用深度強化學習訓練一個策略,大概有三種選擇,各有各的毛病。
DQN 在 Atari 上很強,碰到連續控制(例如機器人關節要輸出多少力)就不太行。一般的策略梯度法實作簡單,但很浪費資料,每批互動資料只能拿來更新一次。TRPO 比較省資料,也比較穩,可是要解一個帶約束的最佳化問題,得用共軛梯度法近似二階資訊,程式複雜;網路裡若有 dropout,或策略與價值函數共用參數,TRPO 也不好處理。
OpenAI 的 Schulman 是 TRPO 的第一作者。這篇 PPO(Proximal Policy Optimization)是他和同事給出的簡化版,目標是保留 TRPO 的資料效率與穩定性,但只用一階最佳化,也就是一般的 SGD 或 Adam。作者在結論裡說,從普通的策略梯度實作改成 PPO,只要改幾行程式。(實際要改的地方多得多,後面會講)
後來 InstructGPT 用 PPO 微調語言模型,PPO 也就成了 RLHF 最常見的強化學習演算法。
定義問題
最常見的策略梯度估計式是:
是對一批樣本取平均。用自動微分實作時,會寫一個目標函數,讓它的梯度剛好等於上式:
收集資料很貴,自然會想對同一批軌跡多做幾步最佳化。作者說這麼做沒有理論依據,實驗上常導致破壞性的大幅更新:策略一下子跳得太遠,表現崩掉,又因為之後收集的資料都來自這個壞策略,很難救回來。
TRPO 的處理方式是在更新時加上約束:
新舊策略之間的 KL 散度不能超過 。這就是「信賴域」:只在舊策略附近找更好的策略。
理論上其實更支持用懲罰項取代約束,也就是最大化目標再減掉 。TRPO 沒這麼做,因為很難挑一個在各種問題都好用的 ,甚至同一個問題在訓練不同階段,合適的 也會變。作者也試過固定 加 SGD,結果不夠好。
所以問題是,能不能只用一階方法,也能在同一批資料上安心地多跑幾輪,又不讓策略跳太遠?
解決問題
機率比與截斷
先定義新舊策略的機率比:
剛開始更新時 ,所以 。TRPO 最大化的目標可以寫成 ,CPI 指 conservative policy iteration。沒有約束的話,最大化它會讓 被推得很遠。
PPO 的主要目標是:
是超參數,論文的預設值是 0.2。min 裡的第一項就是 ;第二項把機率比截斷在 ;最後取兩者較小的那個。
為什麼要取 min?我們拿幾個數字實際算一次。假設舊策略選某個動作的機率都是 0.30,更新後變成不同的值,再搭配正或負的優勢:
import torch

eps = 0.2
logp_old = torch.log(torch.tensor([0.30, 0.30, 0.30, 0.30, 0.30]))
p_new = torch.tensor([0.33, 0.39, 0.18, 0.45, 0.18], requires_grad=True)
adv = torch.tensor([2.0, 2.0, -1.0, -1.0, 2.0])

ratio = torch.exp(torch.log(p_new) - logp_old)
unclipped = ratio * adv
clipped = torch.clamp(ratio, 1 - eps, 1 + eps) * adv
objective = torch.min(unclipped, clipped)
objective.sum().backward()

print(ratio.detach())      # tensor([1.1000, 1.3000, 0.6000, 1.5000, 0.6000])
print(objective.detach())  # tensor([ 2.2000,  2.4000, -0.8000, -1.5000,  1.2000])
print(p_new.grad)          # tensor([ 6.6667,  0.0000,  0.0000, -3.3333,  6.6667])
實作上通常存的是對數機率,所以機率比寫成兩者相減再取指數。逐一看這五個樣本:
- 好動作,稍微變多(,):還在範圍內,兩項相同,梯度正常,繼續把機率往上推。
- 好動作,已經變太多():截斷項是 ,比未截斷的 2.6 小,min 選中截斷項。截斷項對參數的梯度是零,這個樣本不再推動更新。
- 壞動作,已經壓得夠低(,):截斷項 比未截斷的 小,同樣選中截斷項,梯度歸零。
- 壞動作,機率反而變高():未截斷項 比較小,min 選它,梯度是負的,把機率往下拉。
- 好動作,機率反而變低(,):未截斷項 1.2 比截斷項 1.6 小,min 選它,梯度照樣把機率往上推。
第 2、3 個樣本顯示截斷的作用,已經往正確方向走過頭的樣本,不能再提供更多獎勵。第 4、5 個樣本顯示 min 的作用,往錯誤方向走的樣本不受截斷保護,照樣受罰。作者的說法是,機率比的變化只有在讓目標變好時才被忽略,讓目標變差時一定算進去。因此 是未截斷目標的一個悲觀下界。
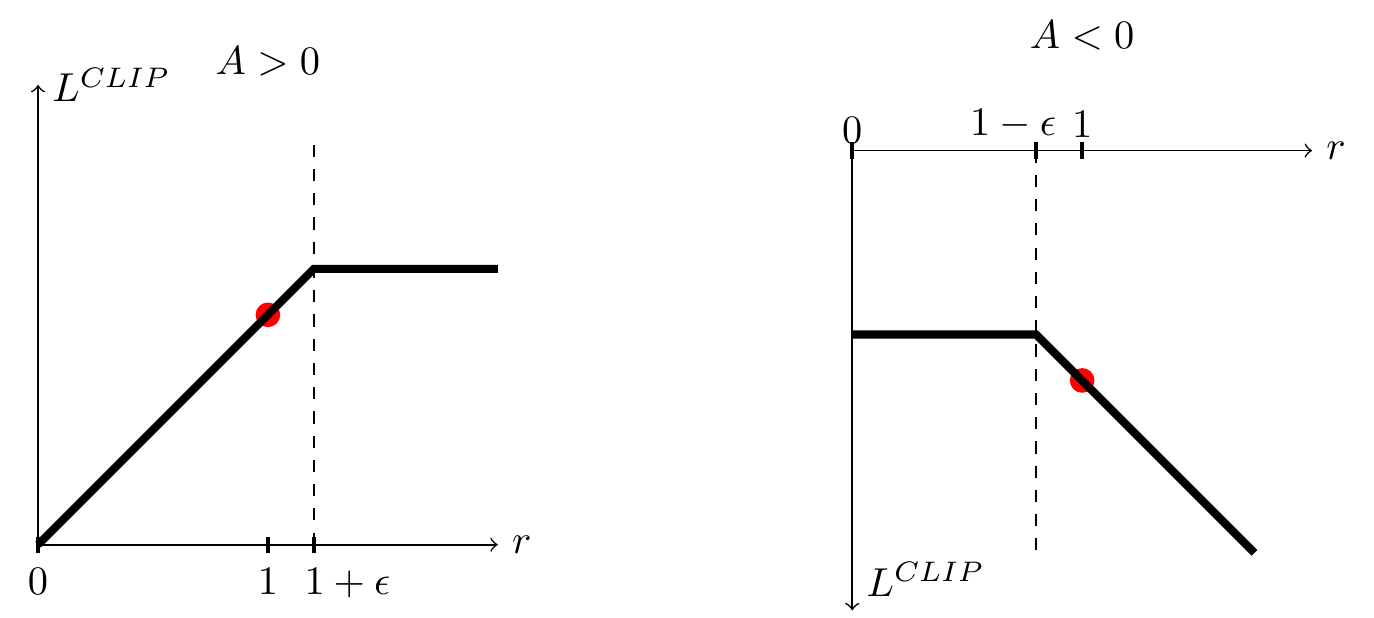
這張圖把剛才的五個樣本畫成曲線。左圖是優勢為正,紅點在 起步,往右走時目標線性增加,超過 就變平,再往右也拿不到更多;往左走(機率變低)則一路下降,沒有任何保護。右圖是優勢為負,方向相反,低於 之後變平。
在 附近, 和 的一階近似相同,所以第一步的梯度和沒有截斷時一樣。兩者只在參數離開 之後才分開。
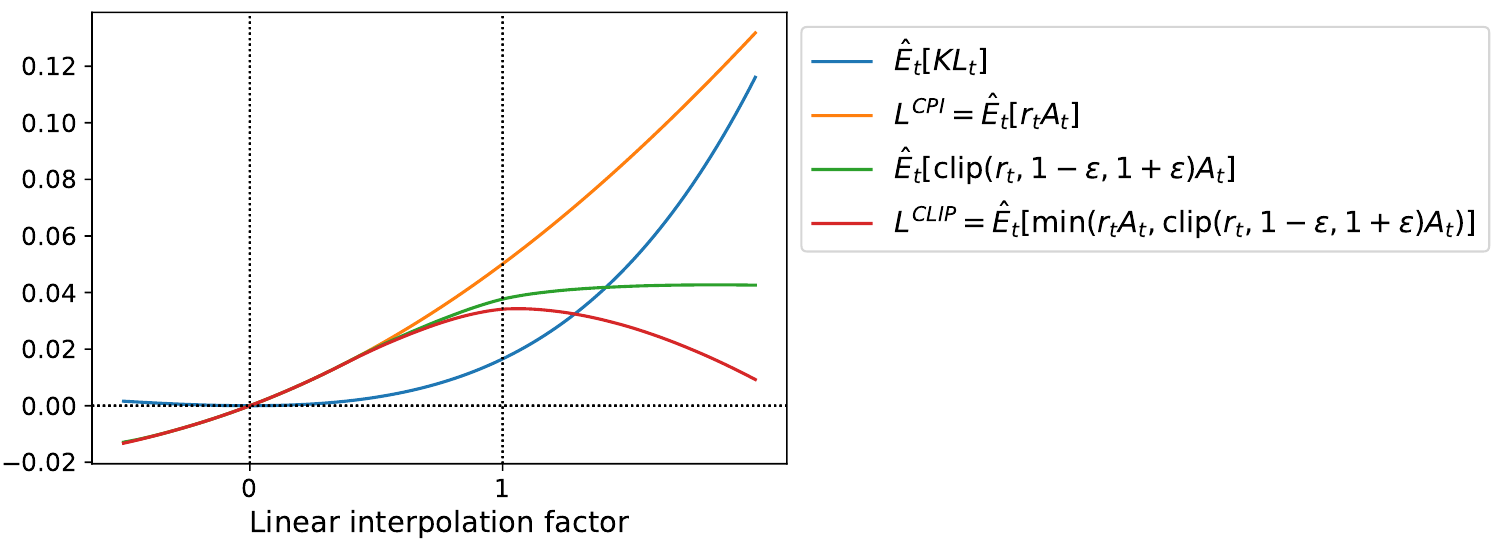
這張圖換個角度看同一件事。作者在 Hopper-v1 上做第一次 PPO 更新,然後把參數從舊值(橫軸 0)沿著更新方向內插到新值(橫軸 1),再往外延伸。橘線 一路往上,看起來走越遠越好;藍線的 KL 也一路增加。紅線 則在 1 附近達到最高點後下降,那裡的 KL 約 0.02。截斷目標自己就有一個「別再往前」的頂點,不需要額外的約束。
另一個選項:自適應的 KL 懲罰
作者也提出一個替代方案,作為重要的比較基準。目標函數是機率比乘優勢減掉 ,每次更新後量一次實際的平均 KL ,再調整 :
- :,懲罰太重,放鬆一點。
- :,跑太遠了,罰重一點。
1.5 和 2 是經驗值,作者說演算法對它們不太敏感, 的初始值也很快會被調整過來。偶爾會有某次更新的 KL 離目標很遠,但很少見。
完整的演算法
實際訓練時,策略網路常和價值網路共用參數,所以目標要合併策略項、價值函數誤差與熵獎勵:
是價值函數的平方誤差, 是熵,用來鼓勵探索。
優勢的估計用截斷版的 GAE(generalized advantage estimation):
是單步的時間差分誤差, 控制要往後看多遠; 時就退化成 A3C 用的有限長度估計。這裡的 是環境獎勵,別和前面的機率比 搞混,原論文兩個都用 。
整個流程是 Algorithm 1:
- 個平行的 actor,各用目前的策略 跑 步,算出每一步的優勢。
- 用這 筆資料,以大小 的小批次跑 個 epoch,最佳化上面的目標。
- ,回到第 1 步。
拿論文的 MuJoCo 設定算一下。每次迭代收集 步,小批次 64、跑 10 個 epoch,等於每批資料做 次梯度更新。一般的策略梯度法,同一批資料只做 1 次。Atari 的設定是 8 個 actor 各跑 128 步,共 1,024 步,小批次 256、3 個 epoch,每批資料做 12 次更新,截斷參數 ,並隨訓練線性遞減到 0。
(有趣的是,後來 InstructGPT 用 PPO 微調語言模型時,每批資料只跑了一個 epoch,PPO 最得意的「同一批多用幾次」反而沒用上。)
討論
哪一種代理目標最好
第一組實驗比較不同的代理目標(surrogate objective),每種都掃過超參數。測試環境是 7 個 MuJoCo 連續控制任務,每個訓練 100 萬步、跑 3 個隨機種子。分數取最後 100 回合的平均總獎勵,再把每個環境正規化成隨機策略 0 分、最好的結果 1 分,最後把 21 次結果平均成一個數字。策略是兩層各 64 單元的 MLP,不共用參數,也不加熵獎勵。
| 設定 | 平均正規化分數 |
|---|---|
| 不截斷、不懲罰 | -0.39 |
| 截斷, | 0.76 |
| 截斷, | 0.82 |
| 截斷, | 0.70 |
| 自適應 KL, | 0.68 / 0.74 / 0.71 |
| 固定 KL, | 0.62 / 0.71 / 0.72 / 0.69 |
整理自原論文 Table 1。
不截斷也不懲罰的版本是負分,主要因為 HalfCheetah 上的分數比隨機策略還差,正是前面說的破壞性大幅更新。截斷版以 最好;兩種 KL 懲罰的最佳設定落在 0.72 到 0.74,差距不大,但都低於截斷。作者也試過在對數空間做截斷,沒有更好。
和其他演算法比
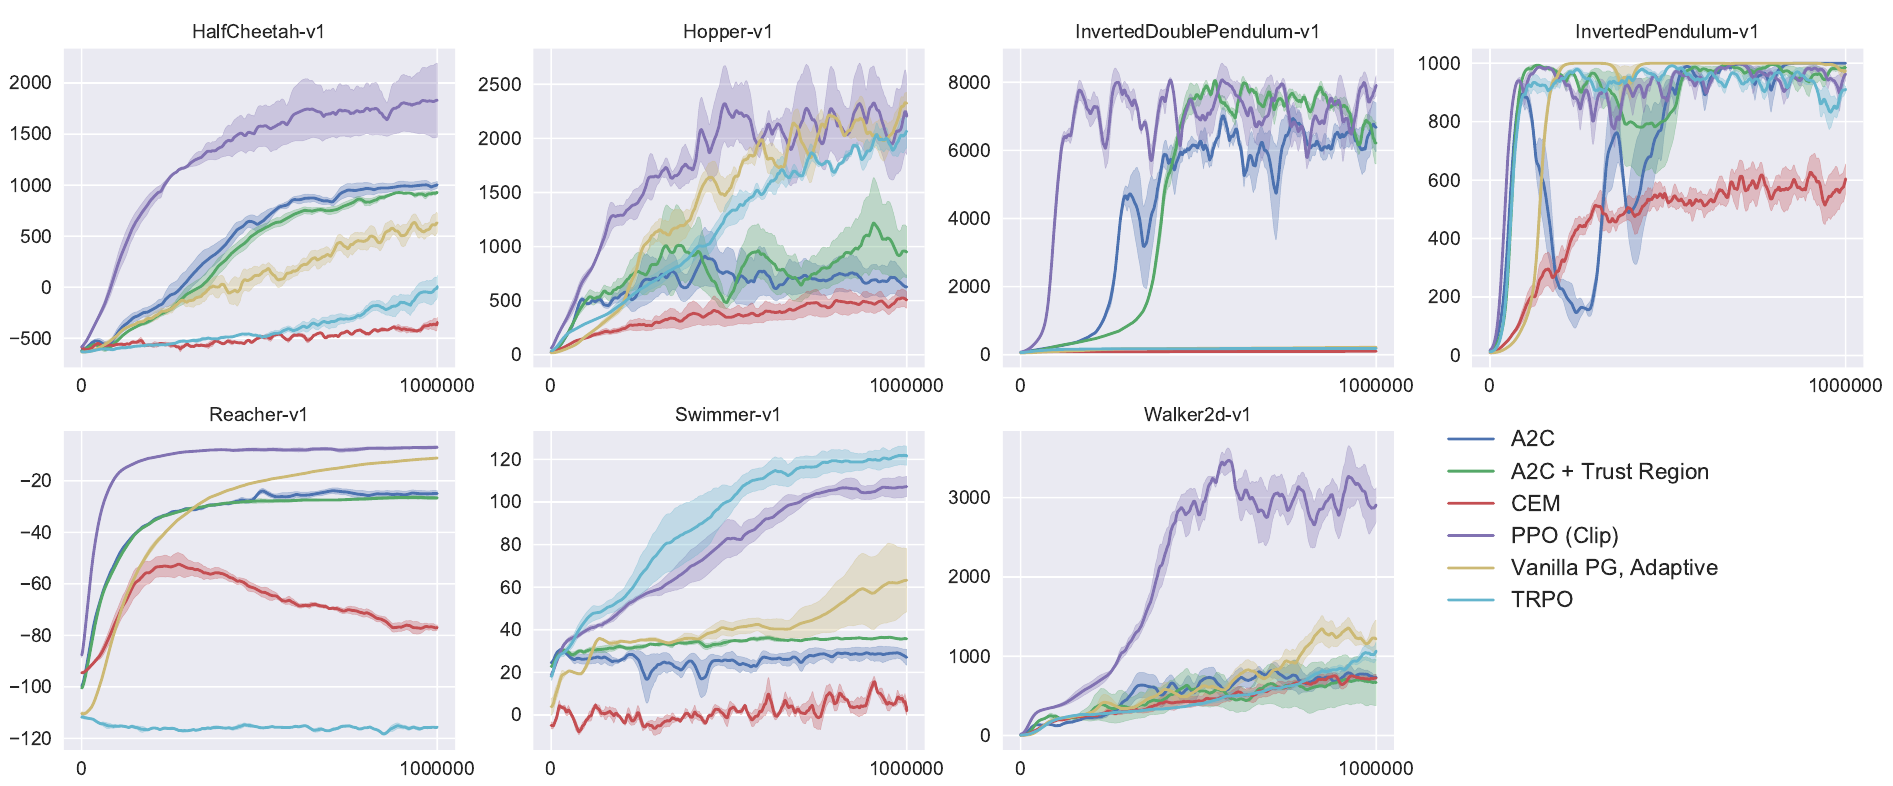
紫線是 PPO。比較對象包括調好的 TRPO、交叉熵法(CEM)、自適應步長的一般策略梯度、A2C,以及加上信賴域的 A2C。作者的結論是 PPO 在幾乎所有環境都勝出。差距最大的是 Walker2d,PPO 到 3,000 左右,其他方法都在 1,200 以下;HalfCheetah 也明顯領先。Swimmer 是例外,TRPO(淺藍線)最後略高於 PPO。
作者另外在 Roboschool 的 3D 人形機器人上展示 PPO,任務包括往前跑、追逐隨機移動的目標,以及一邊被方塊砸一邊從地上爬起來。這組實驗只有學習曲線與畫面,沒有和其他演算法比較。
Atari:學得快,最終分數各有勝負
Atari 的比較對象是 A2C 和 ACER,三者用同樣的網路架構,A2C 與 ACER 的超參數是針對這組遊戲調過的。49 款遊戲,每款 3 次實驗,用兩種指標各算一次每個演算法贏了幾款遊戲:
| 指標 | A2C | ACER | PPO | 平手 |
|---|---|---|---|---|
| 整個訓練期間的平均回合獎勵 | 1 | 18 | 30 | 0 |
| 最後 100 回合的平均獎勵 | 1 | 28 | 19 | 1 |
整理自原論文 Table 2。
第一個指標偏好學得快的方法,第二個偏好最終表現。PPO 在前者明顯領先,最終表現則是 ACER 贏得比較多。附錄的逐款分數兩邊都有極端例子。Enduro 上 A2C 和 ACER 都是 0 分,PPO 有 758;Kangaroo 是 45、50 對 9,929。反過來,Gopher 上 ACER 有 37,802,PPO 只有 2,933;DemonAttack 是 38,808 對 11,378。作者對 ACER 的評價是表現相近,但 PPO 簡單得多。
截斷真的在做事嗎
PPO 很快成了預設演算法,後續研究也開始追問它的效果從哪裡來。
MIT 的 Engstrom 等人在 2020 年的 Implementation Matters in Deep Policy Gradients 把焦點放在官方實作裡的一些「小細節」。例如價值函數的損失也做截斷、用折扣報酬的標準差縮放獎勵、正交初始化、Adam 學習率退火、觀測值正規化與截斷、全域梯度範數截斷到 0.5。論文本身沒有強調這些細節。Engstrom 等人的結論是,PPO 相對 TRPO 的累積獎勵優勢,大部分來自這些程式層級的最佳化。
他們還量了機率比。PPO 訓練過程中,最大的機率比會持續超過 ,截斷沒有把策略關在這個範圍內。回到剛才的程式就能理解。截斷只讓超出範圍的樣本梯度歸零,但參數是所有樣本共用的,其他樣本的梯度照樣會把參數往前推,順便把已經超出範圍的那個樣本推得更遠。第一個 epoch 開始時所有 ,那一步和沒有截斷完全一樣,步伐大小取決於目標函數的陡峭程度。
他們再做了一個 PPO-NoClip:保留這些程式細節,但拿掉截斷。在 Walker2d、Hopper、Humanoid 上,它的分數分別是 2,867、2,371、831,標準 PPO 是 3,292、2,513、806。Walker2d 上仍差了約 400 分,Hopper 的差距落在信賴區間附近,Humanoid 反而是沒有截斷的版本略高。保留截斷、拿掉程式細節的最小版本 PPO-M,三項都比 PPO-NoClip 低。作者的結論是,截斷的重要性常常不及這些程式細節。
另一份常被引用的整理是 Huang 等人 2022 年在 ICLR 部落格發表的 The 37 Implementation Details of Proximal Policy Optimization。他們逐行對照 OpenAI baselines 的實作,整理出 13 個核心細節,以及 Atari、連續控制、LSTM 等情境下的額外細節。例如優勢正規化是在每個小批次內做,不是整批;價值函數截斷這一項,Engstrom 等人找不到它有幫助的證據,另一份大規模研究甚至認為它有害。他們也提到,連原始實作本身跑出來的結果都不太一致。
這些研究沒有推翻 PPO,它在這些實驗裡仍是表現最好的設定之一。它們修正的是「為什麼有效」的說法。截斷目標讓多個 epoch 的更新比較安全,但要穩定重現論文的數字,那些沒寫進論文的程式細節同樣重要。
用在語言模型上
用在語言模型上時,每個 token 是一個動作,整段回答是一條軌跡。InstructGPT 在 PPO 之外,又加了一項對 SFT 模型的 KL 懲罰,避免模型為了討好獎勵模型而跑太遠。後來 DeepSeek 的 GRPO 拿掉了價值網路,改用同一題多個回答的分數互相比較來估計優勢,那個 clip 加 min 的寫法則沿用下來。
結論
PPO 的核心只有一行目標函數。clip 讓往對的方向走太遠的樣本不再加分,min 讓往錯的方向走的樣本照樣扣分,同一批資料就能放心多跑幾輪。
真的要自己寫的話,論文的公式只能帶你走一半。優勢正規化、獎勵縮放、價值函數截斷這些細節論文沒寫,成績卻很吃它們,照著那份 37 個細節的清單一條條對過去最省事。
這幾年大家一直在拆 PPO 的零件,DPO 拆掉了強化學習,GRPO 拆掉了價值網路。那個 clip,倒是一直留到了現在。