原始论文
Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- 发表版本
- ICLR 2025会议
- arXiv 首次提交
- arXiv:2408.03314
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformerstesttimecompute2024,
  title = {{Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters}},
  author = {Charlie Snell and Jaehoon Lee and Kelvin Xu and Aviral Kumar},
  year = {2024},
  eprint = {2408.03314},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.03314}
}
人遇到难题,会多想一下。语言模型能不能也这样,在回答之前多花一点计算,把答案做得更好?
这件事在 2024 年年中的证据很混乱。多数投票、best-of-N 这类做法确实有效;但也有研究指出,在数学推理这种复杂的任务上,让模型自己反思、修改答案,效果非常有限,甚至更差。测试时多花的计算到底值不值得、该怎么花,没有人系统性地比较过。
UC Berkeley 的 Snell 在 Google DeepMind 实习期间,和 Lee、Xu、Kumar 一起做了这件事。他们想回答两个问题:给定一份测试时的计算预算,怎么花最划算?以及,与其把模型做大,把同样的计算花在推理上,会不会更好?
定义问题
提议者与验证者
作者把各种推理时的做法,归成两个可以调整的方向:
- 改变提议的分布:让模型生成更好的答案。一种是用 STaR、ReSTEM 这类方法训练模型;另一种是在推理时让模型看着自己之前的答案,一次一次地修改。
- 用验证器挑选:生成很多答案,再用验证器挑。最基本的是 best-of-N,采样 N 个完整的答案,挑分数最高的;更进一步是用过程奖励模型(PRM)给每一步打分,在推理的过程中做树搜索。
什么叫「最划算」
作者把「测试时计算的最优分配策略」定义为:对一道题 、一个计算预算 ,选出让答对概率最高的那组设定 :
这里 可以是要不要用搜索、用哪种搜索、修改几次、并行采样几个。
每一题都单独优化不现实,作者用题目的难度来近似。难度是相对于模型本身定义的:每题采样 2,048 次,算出单次答对率,再把所有题目按分位数切成五等份,从简单到困难。在验证集上找出每个难度等级最好的策略,再套用到测试题上。
这样定义难度需要知道正确答案,作者称之为 oracle 难度。实际部署时不会有答案,所以另外还有一个「模型预测的难度」,改用验证器对同样 2,048 个答案的平均分数来分级。作者也承认,估计难度本身就要花不少计算,实验里没有把这部分算进去。
实验设置
- 数据:MATH,用 Lightman 等人划分的 12,000 题训练、500 题测试。
- 模型:PaLM 2-S*(Codey)。在 MATH 上有一定的成绩、但还没饱和,适合拿来研究。
- 微调:直接提示现成的模型修改答案或验证步骤,效果不好,所以两种能力都另外做了微调。作者预期未来的模型会在预训练时就具备这些能力。
解决问题
一、用 PRM 搜索
训练 PRM:作者一开始用 Lightman 等人公开的 PRM800K,却发现用它训练的 PRM 很容易被钻漏洞,连最简单的 best-of-N 都能找到骗过它的答案。他们推测是因为 PRM800K 的解答都是 GPT-4 写的,和 PaLM 2 的输出差别太大。
于是改用 Math-Shepherd 的做法,不需要人工标注:从解答的每一步往下,用模型续写几次,看能走到正确答案的比例,作为这一步的分数。这样训练出的 PRM,每一步的预测其实是「从这里开始,之后能答对的概率」。和只看最终答案的 ORM 相比,PRM 一直更好。
整合分数:一份解答的总分,Lightman 等人用的是各步分数的乘积;这里改用 PRM 在最后一步的预测,作者发现效果最好。多份解答之间,则用「best-of-N 加权」:把最终答案相同的解答的分数相加,选总分最高的答案。
只看最高分的那一份,可能被一个分数偏高的错误答案骗走;加权把票数和分数都考虑了进去。
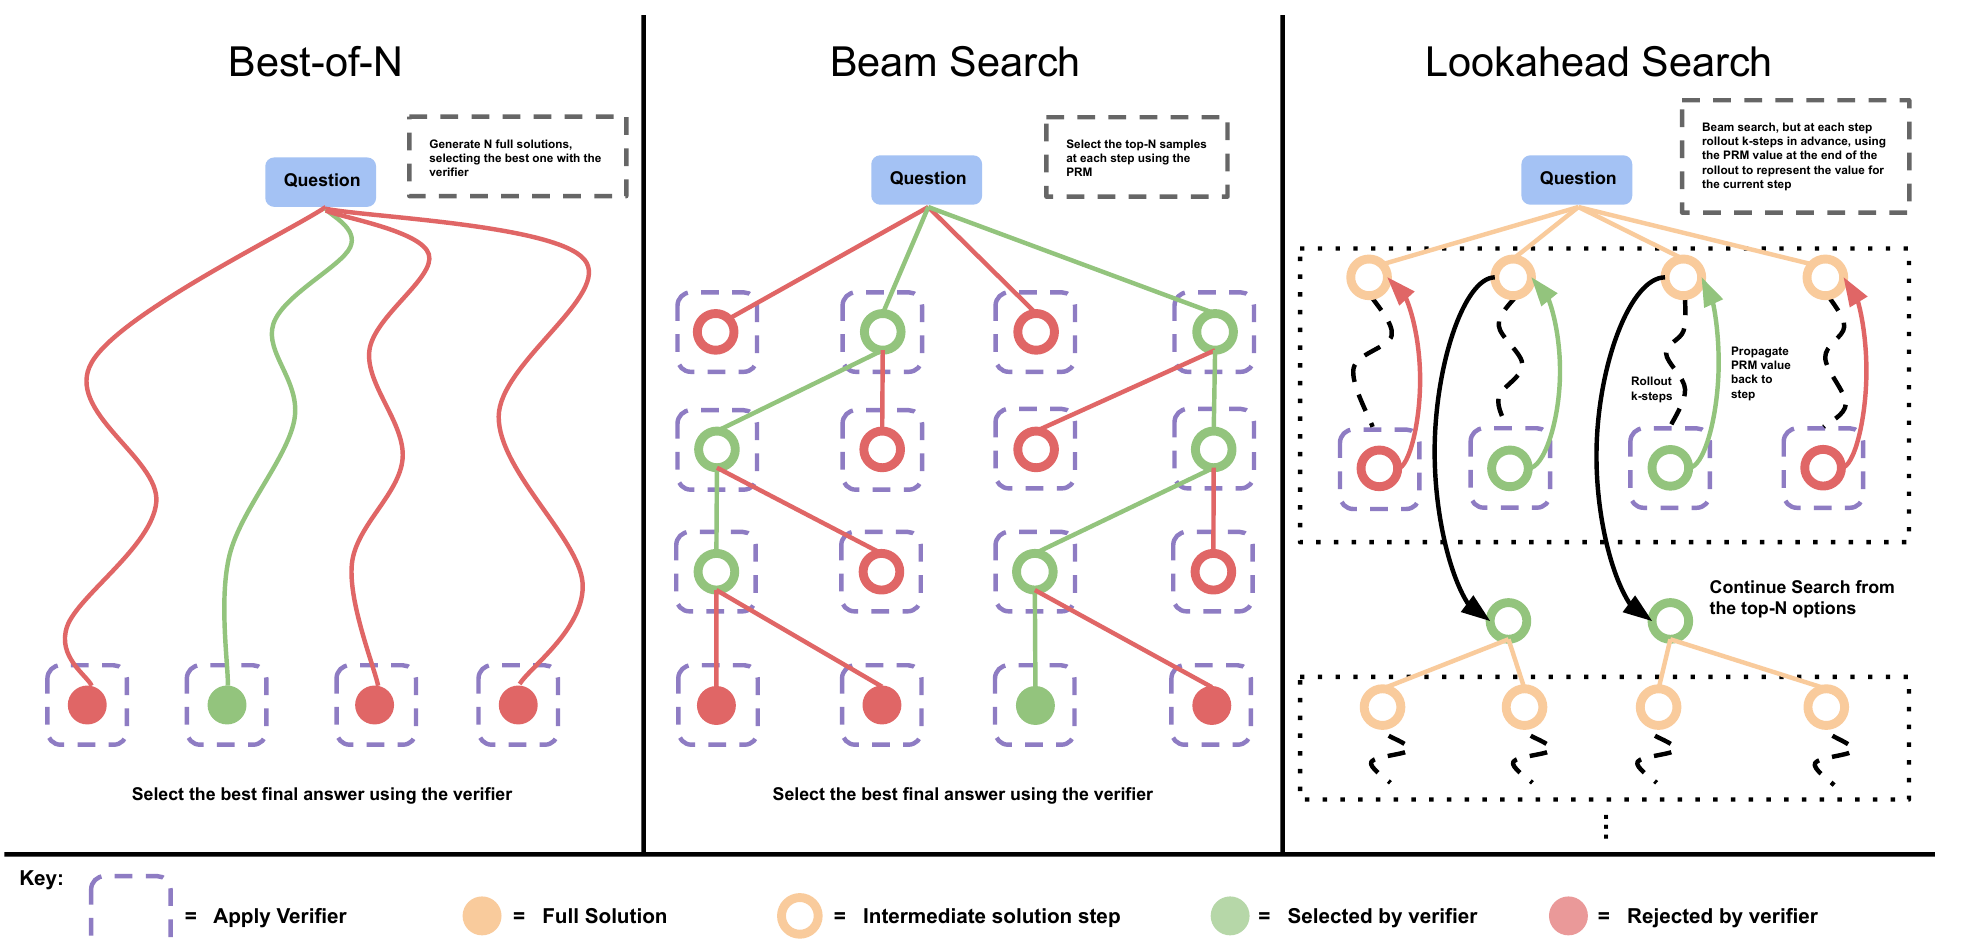
三种搜索方法:
- best-of-N 加权:独立采样 N 个解答,用上面的加权方式挑。
- 束搜索:维持 N 个候选、束宽 M。每一步先生成 N 个候选步骤,用 PRM 打分,留下最好的 N/M 个,每个再往下展开 M 个,重复到解答结束,最多 40 轮。
- 前瞻搜索:和束搜索一样,但评估每一步时,先用温度 0 往前推演最多 k 步,用推演终点的 PRM 分数代表这一步。这让价值估计更准,代价是更多的计算,成本按 个采样计。作者指出,这可以看成拿掉了随机探索的 MCTS,PRM 已经训练好了,推理时要的是利用而不是探索。
二、让模型修改自己的答案
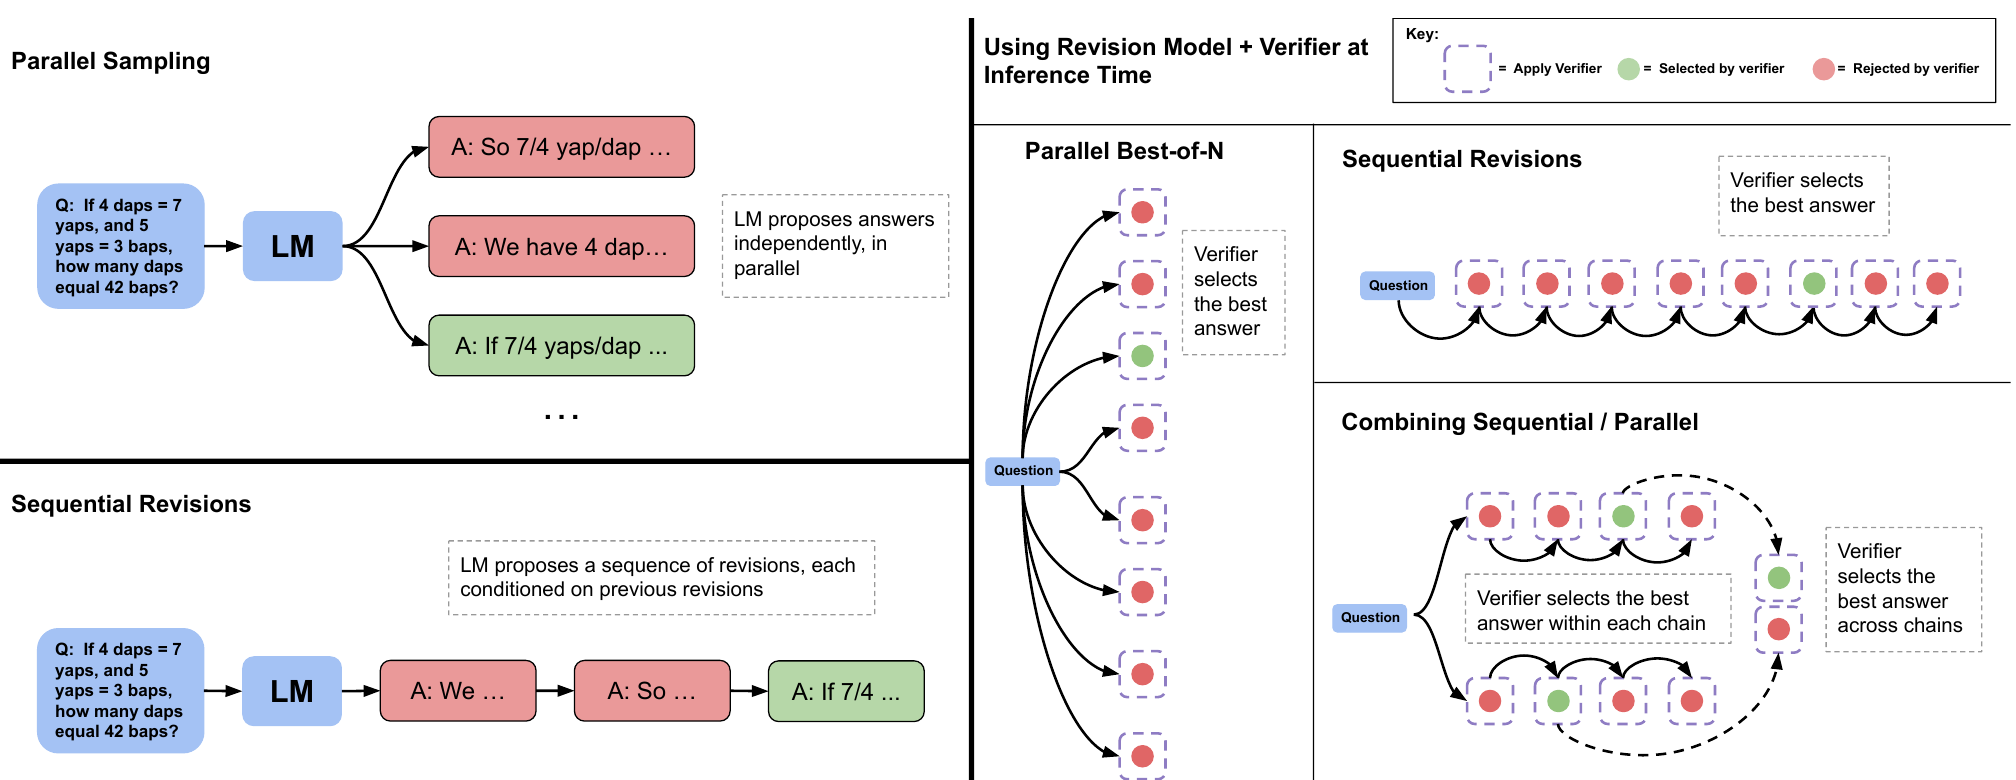
直接请现成的模型改正自己的错误,在推理题上大多没用,所以作者微调了一个专门修改答案的模型。
训练数据:理想的训练数据,是一串错误的答案,接着一个正确的答案,而且正确答案最好是从那些错误修改而来,而不是从头重写。逐轮生成多轮对话太贵,作者改成一次并行采样 64 个答案,再事后拼成多轮数据:每个正确答案前面,放 0 到 4 个(随机决定)错误答案。挑错误答案时,用字符级的编辑距离,优先选和正确答案比较接近的,让模型学到的是修改而不是重写。
推理阶段:模型只训练过前面最多 4 个答案的情况,推理时可以一直修改下去,只保留最近 4 个作为上下文。修改的次数越多,单次答对率逐步上升,超过 4 次之后也还在进步。
但有一个副作用。训练时,前面的答案全都是错的;推理时,前面可能已经有正确的答案,模型还是照样「修改」。大约 38% 的正确答案,在下一次修改后变成了错的。所以最后不能直接取最后一个答案,要用多数投票或验证器,从整条修改链里挑一个。
讨论
搜索:预算少时有用,题目太简单反而有害
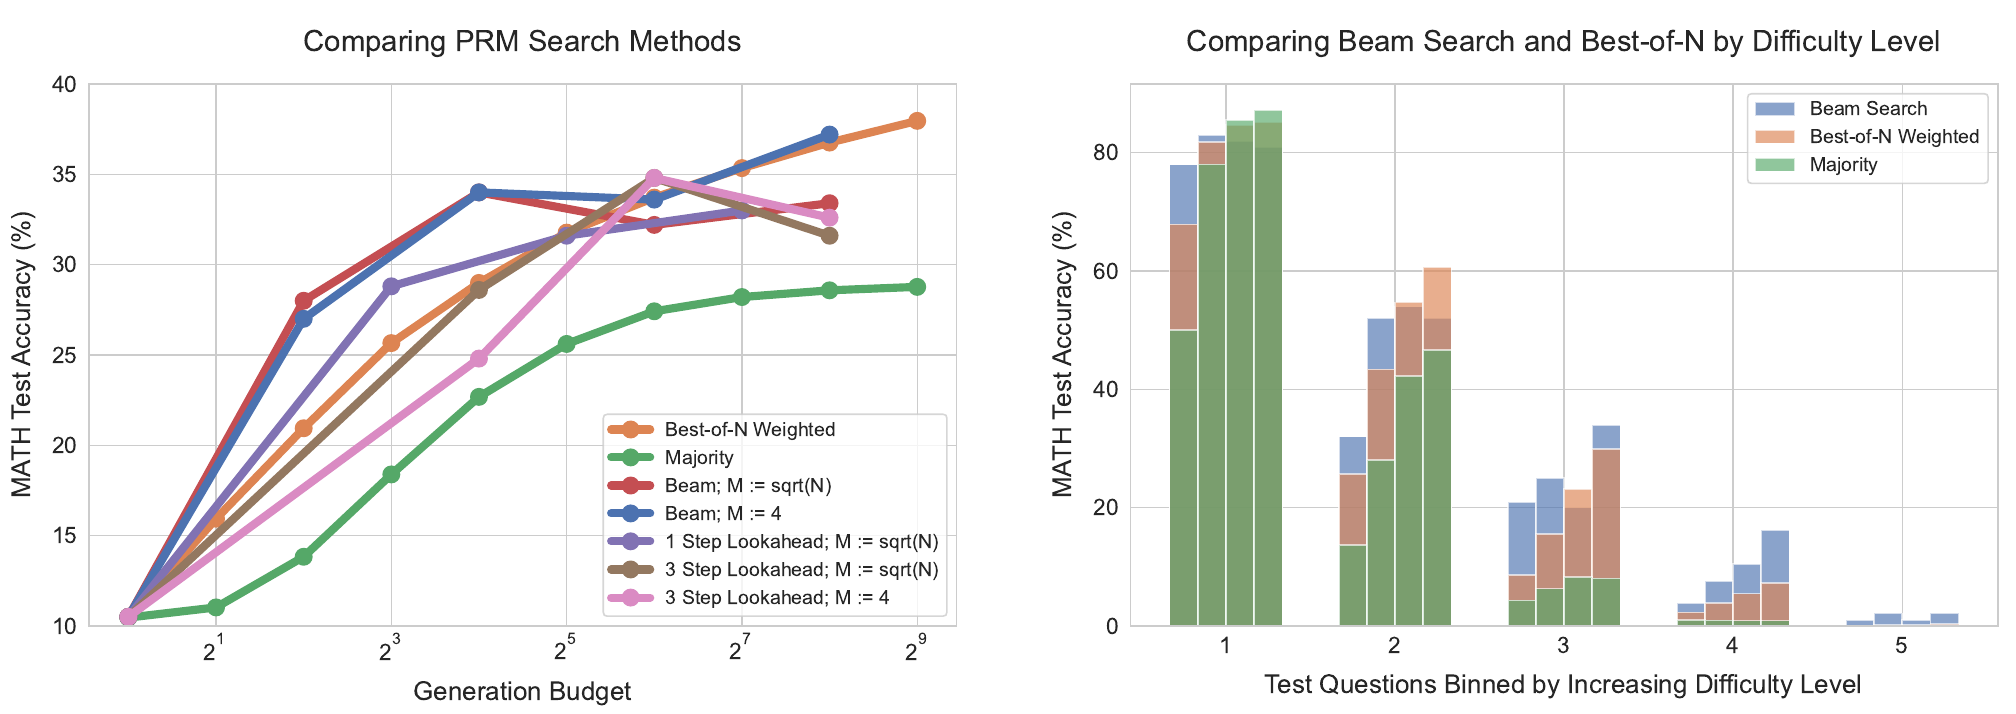
预算小的时候,束搜索明显胜过 best-of-N;预算一大,优势就消失了,束搜索常常还输给 best-of-N。前瞻搜索在相同预算下大多更差。
作者认为原因是 PRM 被钻了漏洞。搜索越强,越容易找到 PRM 打分很高、实际上没用的解答,例如在结尾重复一些没有信息量的步骤,或者短到只有一两步。最强的搜索方法,反而表现最差。
按难度拆开看,趋势完全不同:
- 简单的题目:模型本来就容易写出正确答案,验证器大多也判断正确。再用束搜索强力优化,只会放大验证器学到的错误特征,预算越多越差。
- 中等的题目:模型不太容易一次写对,搜索可以引导它找到正确答案,束搜索一直胜过 best-of-N。
- 最难的题目:什么方法都没有明显进步。
按难度选择最好的搜索方式,在预算较少时,用 16 次采样就能接近 best-of-N 用 64 次的成绩,也就是省下将近 4 倍的计算。
修改:简单题一路改下去,难题要多开几条路
在相同的采样数下,顺序修改略胜于并行采样。但两者擅长的不同:并行采样更像全局搜索,可以尝试完全不同的解法;顺序修改更像局部修正,适合方向已经大致对了的答案。
所以作者让一部分预算给并行、一部分给顺序,扫过不同的比例。在每个预算下都有一个最好的比例,而且这个比例和难度有关:简单的题目全部拿去顺序修改最好;难的题目,并行和顺序要取得平衡。
按难度选比例,可以用 64 次采样超过 best-of-N 用 256 次的成绩,同样是省下 4 倍。
测试时计算能不能取代把模型做大
最后一个问题:同样的 FLOPs,是拿去把模型做大,还是让小模型在推理时多算几次?
作者用常见的近似:预训练的计算量是 ,推理是 ,其中 是参数量。模型的参数放大 倍,预训练和推理的计算都变成 倍。如果改把这些计算给小模型做推理,推理量可以乘上:
能多算几倍,取决于推理的 token 数和预训练的 token 数之比 。和大约 14 倍大的模型()比较,作者试了 为 0.16、0.79、22 三种情况。推理的量很少时(例如自我改进的训练流程),省下的预训练计算很多,同样的 FLOPs 能让小模型的推理量多用约 258 倍;推理和预训练的量相当时约 63 倍;推理的量远大于预训练时(例如大规模上线服务),就只剩约 16 倍。
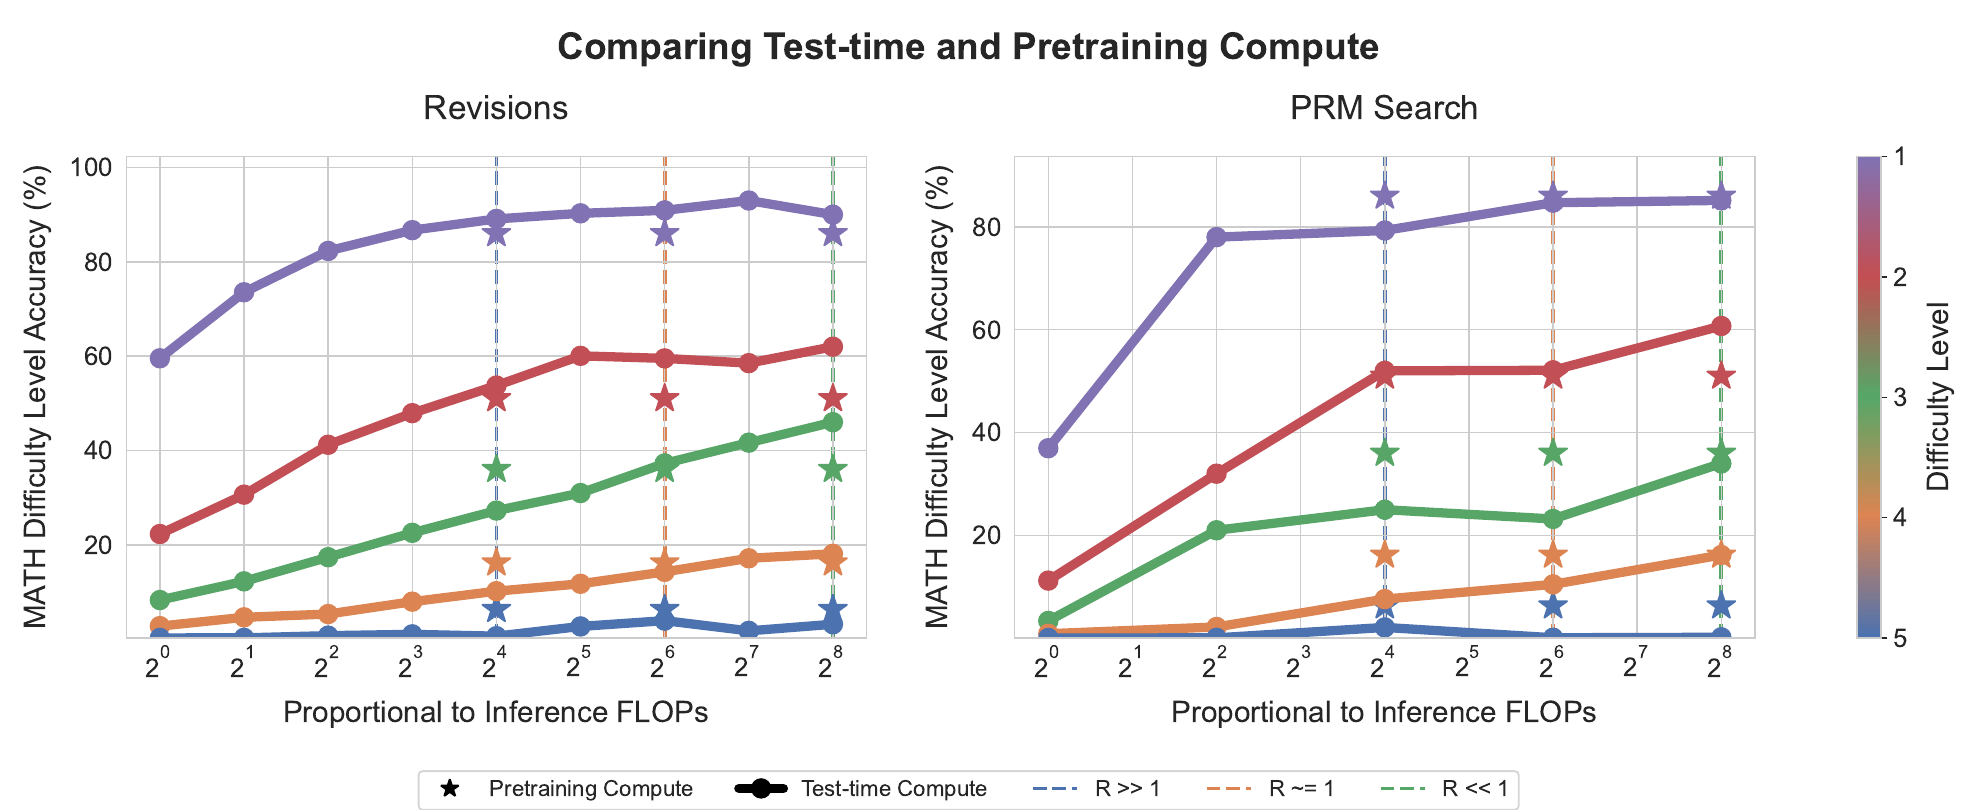
结论是两者不能一比一互换。简单和中等的题目,或推理需求不大的场景,把计算花在推理上,常常比把模型做大 14 倍更好;很难的题目,或推理需求很大的场景,还是把模型做大更有效。
限制
- 估计难度很贵:每题要采样 2,048 次才能分级,这部分计算没有算进实验里。作者建议未来让模型直接预测题目的难度,或在估计难度和解题之间动态切换。
- 最难的题目没有进步:不管是搜索还是修改,在最难的等级上都帮不上忙。
- 没有把方法组合起来:修改搭配了验证器,但没有和 PRM 的树搜索一起用。
- 只在一个设定上测:只有 MATH 和 PaLM 2-S*,而且修改和验证的能力都要另外微调。
作者也提到,未来可以把测试时多花计算得到的答案蒸馏回模型本身,形成一个持续自我改进的循环。
后来的事
这篇论文上 arXiv 一个月后,2024 年 9 月 12 日,OpenAI 发布了 o1。o1 用强化学习训练,在回答前写出很长的内部思维链;OpenAI 的文章写道,o1 的表现会随着训练时的计算(强化学习)和测试时的计算(思考的时间)稳定提升。这篇论文比较的「顺序修改」,在 o1 身上变成了同一条思维链里的自我检查和修正,不需要另外微调一个修改模型。
DeepSeek-R1 也走了类似的路,而且明确记录了 PRM 和 MCTS 在他们手上没有成功。
按难度分配测试时计算的想法,则被推到了更极端的地步。2025 年 2 月的 Can 1B LLM Surpass 405B LLM? 报告,用最优的测试时策略,1B 的模型在 MATH-500 上可以超过 405B 的模型,0.5B 的模型在 MATH-500 和 AIME24 上可以超过 GPT-4o;他们也同样发现,最好的策略取决于使用的模型、PRM 和题目的难度。
至于怎么用最少的训练,让模型自己在一条思维链里延长思考,可以看 s1。
结论
测试时计算怎么花,没有一种万能的做法。简单的题目,该让模型修改自己的答案,强力搜索反而会放大验证器的错误;中等的题目,搜索最有效;最难的题目,目前的方法都帮不上忙。按难度分配,最多可以省下 4 倍的计算。
和把模型做大 14 倍相比,在简单和中等的题目上,把同样的计算花在推理上常常更好,难题则还是要靠更大的模型。测试时计算和预训练计算,不能一比一地互换。
作者在引言里写道,这暗示了一个未来:预训练少花一点,推理多花一点。一个月后 o1 发布,测试时计算成了大家比拼的重点,只是走的路比这篇论文设想的还要直接,不靠外接的搜索和验证器,而是让模型自己学会多想一会儿。