原始论文
s1: Simple test-time scaling
- 发表版本
- EMNLP 2025会议
- arXiv 首次提交
- arXiv:2501.19393
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltunings12025,
  title = {{s1: Simple test-time scaling}},
  author = {Niklas Muennighoff and Zitong Yang and Weijia Shi and Xiang Lisa Li and Li Fei-Fei and Hannaneh Hajishirzi and Luke Zettlemoyer and Percy Liang and Emmanuel Candès and Tatsunori Hashimoto},
  year = {2025},
  eprint = {2501.19393},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.19393}
}
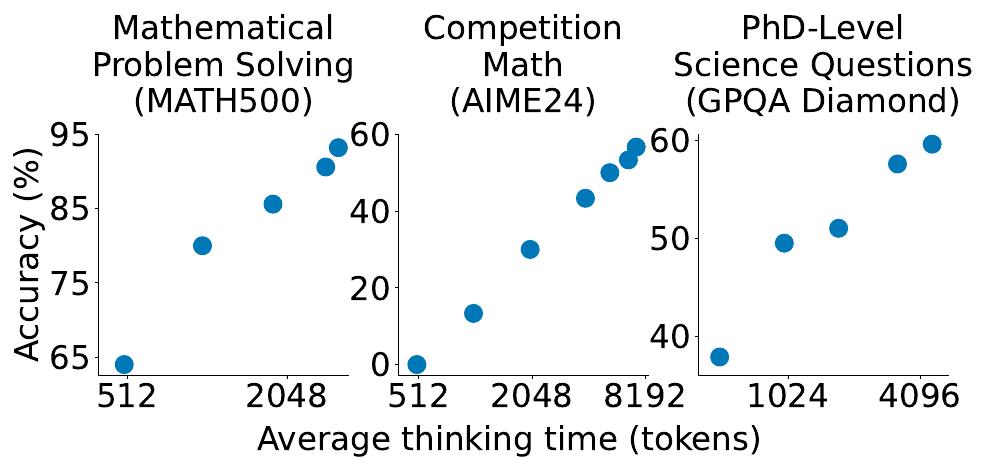
2024 年 9 月,OpenAI 发布 o1,展示了一条很漂亮的曲线:让模型想得越久,答得越准。但 OpenAI 没有公开做法,只说用了大规模的强化学习。
接下来的几个月,很多团队尝试复现。有人用蒙特卡洛树搜索,有人用多个智能体互相讨论;2025 年 1 月的 DeepSeek-R1,用了数百万条样本、好几个阶段的强化学习,追上了 o1 的成绩。可是在这么多复现里,没有人公开复现过那条「想得越久、答得越好」的曲线。
Stanford、华盛顿大学、AI2 等机构的 Muennighoff、Yang 等人问了一个很直接的问题:要同时做到那条曲线和强大的推理能力,最简单的做法是什么?他们的答案出乎意料地简单。1,000 条数据、在 16 张 H100 上微调 26 分钟,再加上一个「Wait」。
定义问题
测试时多花算力的方法,作者分成两类:
- 顺序:后面的计算建立在前面的结果上,例如写一段很长的推理。
- 并行:各自独立计算,最后汇总,例如多数投票。
作者把重点放在顺序的方法上,直觉上后面的计算可以利用前面的中间结果,推得更深,也能反复修正。
要比较各种方法,光看准确率不够,还要看能不能控制算力、算力增加时准确率有没有跟着上升。作者定义了三个指标。对一个方法,在同一个评测上用不同的算力 跑几次,得到准确率 :
控制度是实际用掉的思考 token 数有多大比例落在指定的范围内;扩展性是曲线的平均斜率,要是正的才有用;表现是能达到的最高准确率。
解决问题
s1K:挑出 1,000 题
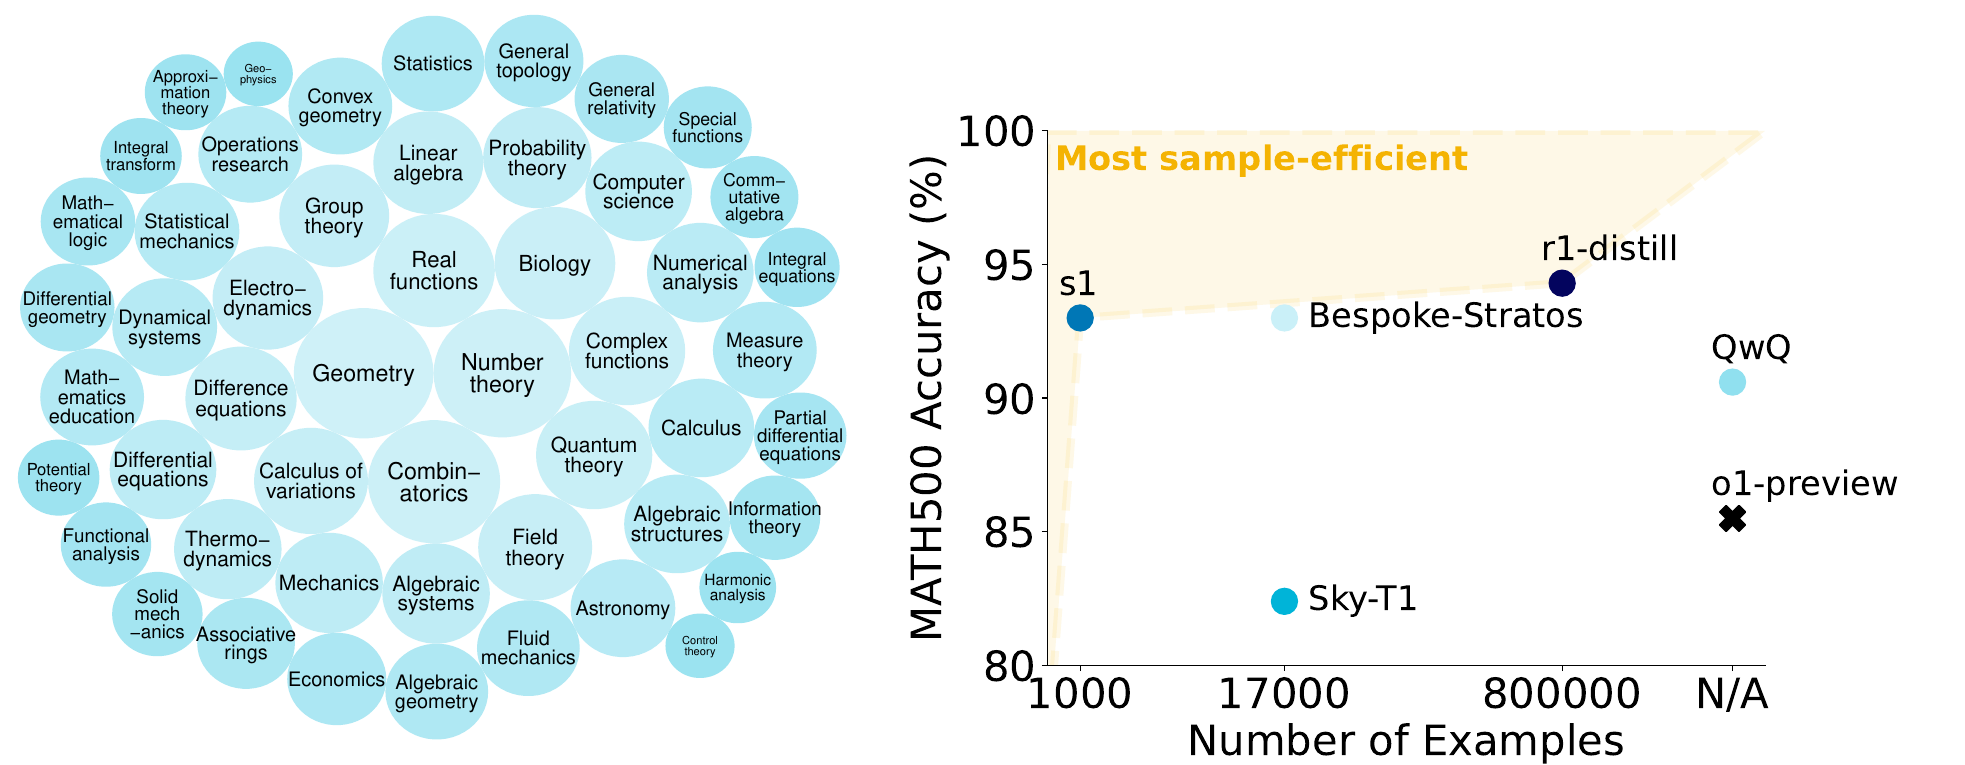
先收集 5.9 万题。来源有 16 个,最大的是 NuminaMATH 的 30,660 道数学题,另外有历届 AIME(1983 到 2021 年)、跨学科奥林匹克题目 OlympicArena(4,250 题)、竞赛数学 OmniMath(4,238 题)、SAT 和 LSAT 等标准化考试 AGIEval(2,385 题)。作者还自己做了两份:Stanford 统计系博士资格考试的概率题 182 题,以及量化交易面试常见的难题 23 题。
每一题都用 Google 的 Gemini 2.0 Flash Thinking 生成推理过程和解答,得到 59,029 组「题目、推理、解答」。和评测题目(MATH500、GPQA Diamond、AIME24)有连续 8 个词相同的数据都删掉,也去除了重复的题目。
接着用三个原则筛选:
- 质量:删掉 API 出错的,剩 54,116 题;再删掉格式有问题的,例如 ASCII 图、引用不存在的图片、题号错乱,剩 51,581 题。其中来自高质量数据集、不需要再筛的 384 题,直接收进最终名单。
- 难度:让 Qwen2.5-7B-Instruct 和 Qwen2.5-32B-Instruct 各做一次,由 Claude 3.5 Sonnet 对照标准答案评分。只要有一个模型答对,就当成太简单删掉,剩 24,496 题。另外也用推理过程的长度作为难度的指标,假设越难的题目需要想得越久。
- 多样性:请 Claude 3.5 Sonnet 按照美国数学学会的数学主题分类,把每一题分到一个领域。每次先随机挑一个领域,再从这个领域里挑一题,推理越长的越容易被挑中,重复到凑满 1,000 题,最后覆盖 50 个领域。
评分模型认为 s1K 里只有 53.6% 的推理过程是正确的。作者刻意保留了这些错误,他们要的是推理的过程,而不是完全正确的解答。
预算强制
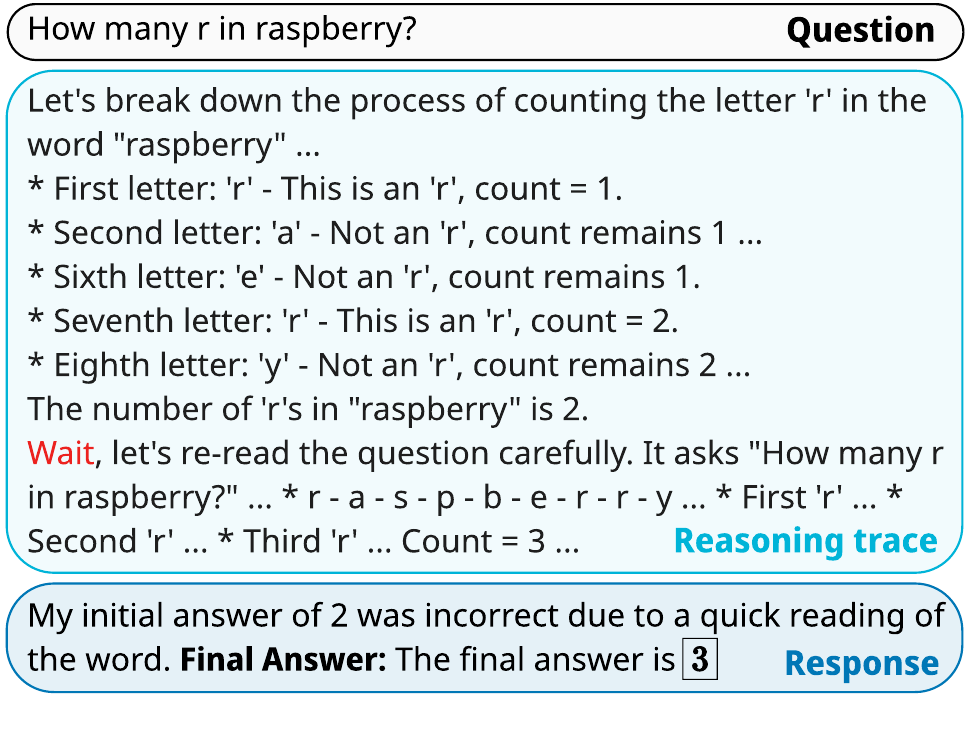
控制思考长度的方法,叫做预算强制(budget forcing),在解码时直接介入:
- 设上限:思考的 token 数超过上限,就直接接上结束思考的符号,必要时再加上「Final Answer:」,逼模型交出目前最好的答案。
- 设下限:模型想结束思考时,把结束符吞掉,改接上「Wait」,让它继续想。
上图就是一个例子。模型数了一遍,以为 raspberry 只有两个 r,想结束;被接上「Wait」之后,它重新读了一遍题目,找到了第三个 r。
接上「Wait」之后模型会写什么,取决于它从训练数据里学到了什么。s1K 的推理过程里充满了「等一下」「再检查一遍」这类句子,模型看到「Wait」,就会接着检查前面的推理。
作者也比较了几种别的控制方法:
- 在提示词里指定 token 数:告诉模型最多想多少个 token。
- 在提示词里指定步数:告诉模型最多想几步,每步大约 100 个 token。
- 在提示词里指定长短:两种提示词,分别让模型想短一点或想久一点。
- 拒绝采样:一直采样,直到某次的长度恰好落在预算内。
训练
基底模型是 Qwen2.5-32B-Instruct。思考的部分用 <|im_start|>think 开头,作答的部分用 <|im_start|>answer 开头。在 s1K 上训练 5 个 epoch,批大小 16,总共 315 步,学习率 ,前 5% 预热后用余弦衰减到 0;损失只算推理过程和解答,不算题目。
在 16 张 H100 上训练了 26 分钟,大约 7 个 GPU 小时。
讨论
想得越久,答得越好
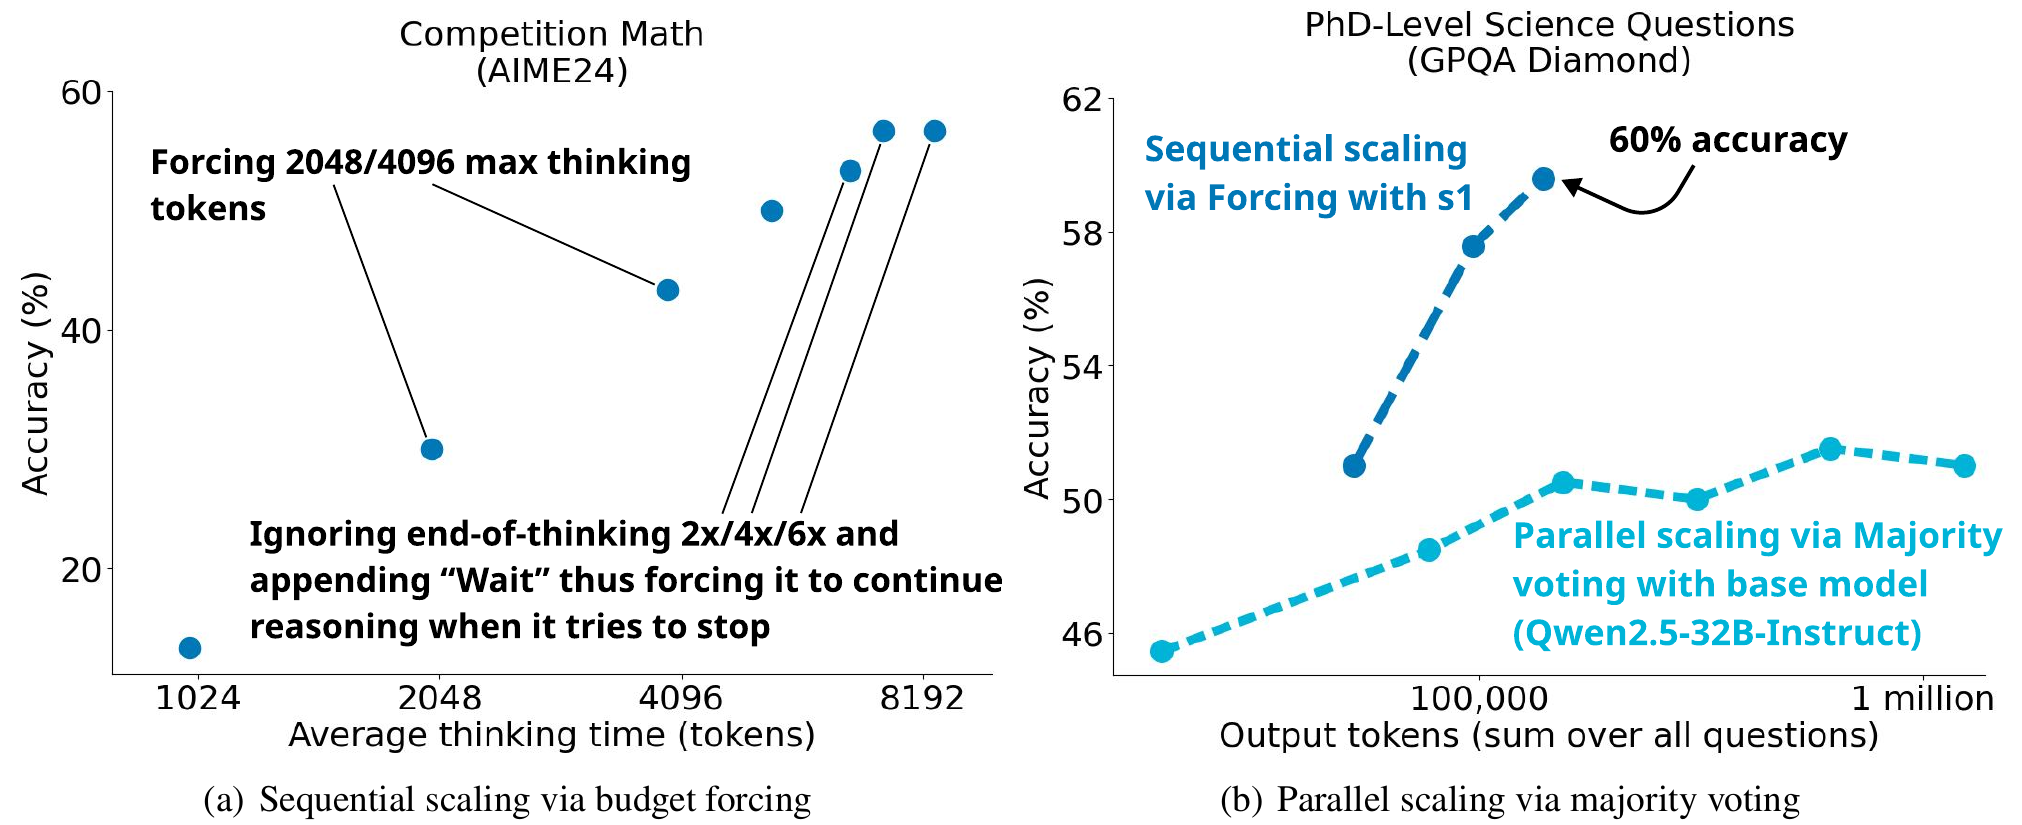
用预算强制拉长思考,AIME24 从不干预时的 50% 升到 56.7%。但接上「Wait」到第 6 次之后,曲线就平了;太频繁地吞掉结束符,模型会陷入重复的循环,而不是继续推理。
右图比较了两种扩展方式。基底模型 Qwen2.5-32B-Instruct 每题采样 64 次、温度 1,用 2 到 64 个答案做多数投票,准确率怎么也追不上 s1 用顺序扩展的成绩。作者认为这验证了一开始的直觉,顺序扩展比并行扩展有效。
成绩
| 模型 | 推理微调样本数 | AIME24 | MATH500 | GPQA |
|---|---|---|---|---|
| o1-preview | 未公开 | 44.6 | 85.5 | 73.3 |
| o1 | 未公开 | 74.4 | 94.8 | 77.3 |
| Gemini 2.0 Flash Thinking | 未公开 | 60.0 | - | - |
| Qwen2.5-32B-Instruct | - | 26.7 | 84.0 | 49.0 |
| DeepSeek-R1 | 远多于 80 万 | 79.8 | 97.3 | 71.5 |
| R1 蒸馏版(32B) | 80 万 | 72.6 | 94.3 | 62.1 |
| Bespoke-32B | 1.7 万 | 63.3 | 93.0 | 58.1 |
| s1(不用预算强制) | 1,000 | 50.0 | 92.6 | 56.6 |
| s1-32B | 1,000 | 56.7 | 93.0 | 59.6 |
整理自原论文 Table 1,节选部分行;单位为 %。
只多训练了 1,000 条数据,s1-32B 的 AIME24 就比基底模型高了 30 个百分点。在 AIME24 和 MATH500 上,它都超过了 o1-preview,摘要说的「最多高出 27%」,是 AIME24 上 56.7 对 44.6 的相对差距;不过在 GPQA 上,它还是比 o1-preview 低了十几个百分点。
同期发表的 R1 蒸馏版比 s1 强,但用了 800 倍的数据。s1 在 AIME24 上也接近它的老师 Gemini 2.0 Flash Thinking,说明蒸馏大体成功。
数据怎么挑,差别很大
| 数据 | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| 随机 1,000 题(只看质量) | 36.7 | 90.6 | 52.0 |
| 最多样的 1,000 题(只看多样性) | 26.7 | 91.2 | 54.6 |
| 推理最长的 1,000 题(只看难度) | 33.3 | 90.4 | 59.6 |
| 全部 5.9 万题 | 53.3 | 92.8 | 58.1 |
| s1K | 50.0 | 93.0 | 57.6 |
整理自原论文 Table 2;这张表的成绩都把思考上限设在约 3 万个 token,避免模型卡在循环里出不来。单位为 %。
只用一种原则挑题,AIME24 都掉了 13 到 23 个百分点。三个原则一起用的 s1K,和用全部 5.9 万题训练的模型差不多,而后者要花 394 个 GPU 小时,s1K 只要 7 个。
怎么控制思考长度
| 方法 | 控制度 | 扩展性 | 表现 |
|---|---|---|---|
| 预算强制 | 100% | 15 | 56.7 |
| 提示词里指定 token 数 | 40% | −24 | 40.0 |
| 提示词里指定 token 数 + 预算强制 | 100% | 13 | 40.0 |
| 提示词里指定步数 | 60% | 3 | 36.7 |
| 提示词里指定步数 + 预算强制 | 100% | 6 | 36.7 |
| 提示词里指定长短 | 50% | 25 | 36.7 |
| 拒绝采样 | 100% | −35 | 40.0 |
整理自原论文 Table 3;AIME24。
预算强制在三个指标上都表现不错,控制度 100%,扩展性是正的,准确率最高。其他方法各有问题:
- 指定 token 数:模型数不准自己写了多少个 token,就算专门训练过也一样,不加预算强制就控制不住。
- 指定步数:模型很会钻漏洞。要它少写几步,它就每步写长一点;要它多写几步,它就每步写短一点,总 token 数差不多。
- 指定长短:让模型想久一点,确实能让它多想,扩展性甚至最好,只是准确率不高。
- 拒绝采样:最出人意料。限制的长度越宽,准确率反而越低,扩展性是 −35。作者检查后发现,短的生成多半是模型一开始就走对了方向;长的生成往往是模型走错了,一直在回头、怀疑自己。只挑某个长度的答案,等于挑到了不同难度的状态。
至于接在后面的词,作者比较了几种:
| 结束思考时的处理 | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| 不延长 | 50.0 | 93.0 | 57.6 |
| 吞掉 2 次,什么都不接 | 50.0 | 90.2 | 55.1 |
| 吞掉 2 次,接「Alternatively」 | 50.0 | 92.2 | 59.6 |
| 吞掉 2 次,接「Hmm」 | 50.0 | 93.0 | 59.6 |
| 吞掉 2 次,接「Wait」 | 53.3 | 93.0 | 59.6 |
整理自原论文 Table 4;单位为 %。
只把结束符拿掉、什么都不接,反而更差。「Wait」整体最好,是唯一让 AIME24 进步的。
为什么 1,000 条就够
作者的假设是,推理的能力早就在模型里了。预训练用了数万亿个 token,其中本来就有大量的推理数据;1,000 条的微调只是把这个能力唤出来,再用预算强制在推理时放大。这和 LIMA 提出的「表面对齐假说」类似:LIMA 发现 1,000 条数据就足以让模型学会按用户的偏好回答。
限制
- 会趋平:预算强制延长到一定程度就不再进步,次数太多还会让模型陷入重复的循环。作者提出的改进方向包括轮流使用不同的词、搭配重复惩罚或提高温度。
- 上下文长度:思考再长,也不能超过模型的上下文窗口。在 AIME24 上要求模型想到 512 步时,30 题里有 12 题的输出超过了上下文长度,成绩因此大跌。
- 并行扩展可以补上:作者试了用过程奖励模型引导的树搜索 REBASE,再加上多数投票,扩展效果比单纯多数投票更好,在这组比较里也胜过顺序扩展,不过每一步都要多算一次奖励模型。
另外,s1K 的推理过程都是 Gemini 写的,模型大致只能学到老师的水平,这一点在下面的 s1.1 上看得更清楚。
后来的事
s1 发表 7 天后,作者发布了 s1.1。同样的 1,000 题,改用 DeepSeek-R1 重新生成推理过程,训练方法不变:
| 模型 | MATH500 | GPQA | AIME24 | AIME25 |
|---|---|---|---|---|
| s1(不用预算强制) | 92.6 | 56.6 | 50.0 | 26.7 |
| s1(接 4 次「Wait」) | 92.2 | 58.6 | 56.7 | 36.7 |
| s1.1(不用预算强制) | 94.4 | 60.6 | 56.7 | 50.0 |
| s1.1(接 2 次「Wait」) | 95.4 | 63.6 | 56.7 | 50.0 |
整理自原论文附录 Table 5,节选部分行;单位为 %。
只换了老师,s1.1 不用任何预算强制,就追上了 s1 用预算强制的最好成绩;在 2025 年的新题目 AIME25 上,从 26.7% 跳到 50.0%。作者也试过用 Claude 3.7 当老师,结果比 R1 差。有意思的是,s1.1 加上「Wait」之后,AIME 的成绩就不再进步了。
同一张表也列了几个新的对手。用 817 条数据微调的 LIMO,AIME24 是 56.3%,得到了和 s1 类似的结论。OpenAI 的 o3-mini 则直接把思考的力度做成了三个档位,low、medium、high 的 AIME24 分别是 56.3%、75.8%、83.8%,控制模型想多久,成了产品上的一个选项。
结论
s1 用 1,000 道精挑细选的题目,在 Qwen2.5-32B-Instruct 上微调 26 分钟,再用预算强制控制思考长度,公开复现了 o1 那条「想得越久、答得越好」的曲线。AIME24 从 50% 拉到 56.7%,在竞赛数学上超过了 o1-preview。
最有启发性的是那张数据的消融表。随机、最多样、最长,单用任何一个标准挑 1,000 题,都比三个一起用差得多;5.9 万题全部拿来训练,也只多一点点。数据少不是问题,挑得准才是重点。
至于那个「Wait」,它确实有用,但能延长的有限,换一个更好的老师带来的差别更大。真正让 s1 能想下去的,与其说是那个词,不如说是 Gemini 和后来的 R1 写在那 1,000 题里的推理习惯。