原始论文
STaR: Bootstrapping Reasoning With Reasoning
- 发表版本
- NeurIPS 2022会议
- arXiv 首次提交
- arXiv:2203.14465
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningstar2022,
  title = {{STaR: Bootstrapping Reasoning With Reasoning}},
  author = {Eric Zelikman and Yuhuai Wu and Jesse Mu and Noah D. Goodman},
  year = {2022},
  eprint = {2203.14465},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.14465}
}
先写推理再给答案,模型会答得更好,这件事在 2022 年初已经有不少证据。问题是,怎么让模型学会写推理?
当时有两条路。一条是准备一大批带推理过程的训练数据,拿去微调。这需要人一道题一道题地写,例如 CommonsenseQA 的人工解释数据集 CoS-E;或者用模板自动生成,但只有解法已知、能写成规则的题目才行。
另一条是思维链提示,在提示词里放几个带推理的示例,不用训练。这很便宜,但效果通常比不上用大量数据直接训练「只输出答案」的模型。以这篇用的 GPT-J 6B 为例,CommonsenseQA 上少样本思维链只有 36.6%,直接微调输出答案则是 60.0%。
Stanford 的 Zelikman 等人想走中间的路。只准备十来个带推理的示例,加上一大批只有答案、没有推理的题目,让模型自己写推理给自己学。
定义问题
手上有一个预训练模型 、一个只有题目和答案的数据集 ,以及一小组带推理的示例 ,大约 10 个。
目标是训练出一个先写推理 、再写答案 的模型,而且要比只输出答案的模型更准。
整个方法都假设,能推出正确答案的推理,质量比推出错误答案的推理好。这个假设不见得每次都成立,后面会再谈。
解决问题
自己写推理,只留答对的
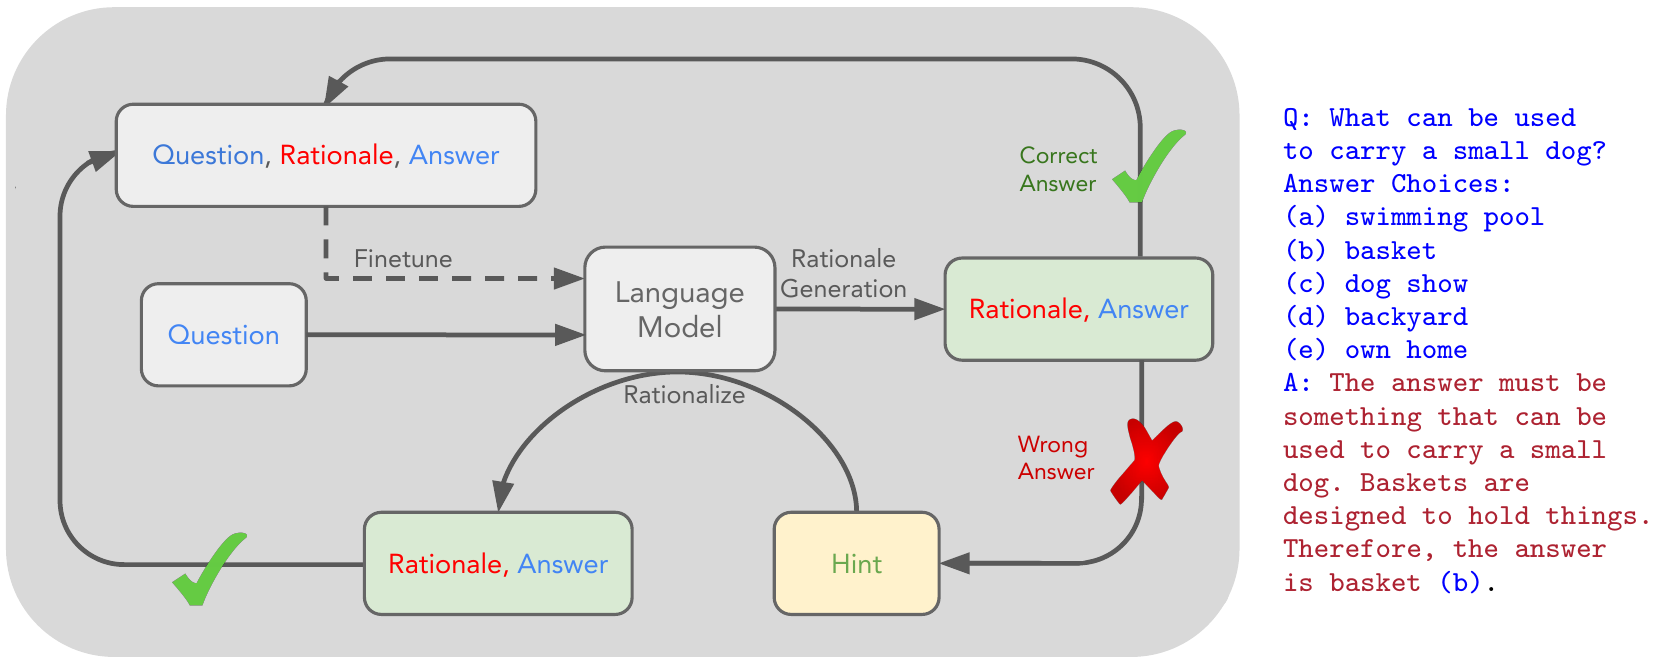
第一步很直接。把那十来个示例当作提示词,请模型对数据集里的每一道题写出推理和答案。答案和标准答案相同的,连同推理留下;答错的丢掉。
接着用留下的数据微调模型,再用微调后的模型对所有题目重新写一遍,筛选、微调,一直重复到成绩不再进步。
每一轮都从原来的预训练模型 开始微调,而不是接着上一轮的模型继续训练,以避免过拟合。第一轮只训练 40 步,之后每轮增加 20%,作者发现一开始训练得慢一点,最后的成绩会更好。
做不出来的题目,给它看答案
只留答对的题目,有一个明显的问题。模型做不出来的题目永远进不了训练数据,等它把会做的都学完,就再也学不到新东西了。
作者的办法叫 rationalization。对答错的题目,在提示词里直接告诉模型正确答案,请它写出推理:
Q: Where do you put your grapes just before checking out?
Answer Choices:
(a) mouth
(b) grocery cart (CORRECT)
(c) super market
(d) fruit basket
(e) fruit market
A: The answer should be the place where grocery items are placed before
checking out. Of the above choices, grocery cart makes the most sense for
holding grocery items. Therefore, the answer is grocery cart (b).
原论文 Figure 2 的提示词示例;「(CORRECT)」就是给模型的提示。
知道答案之后,往回推出一段说得通的理由就容易多了。接着,这段推理放进训练数据时,会把提示拿掉,训练的输入只有原来的题目,就好像是模型自己想出来的一样。
这样一来,原本做不出来的难题也能进入训练数据,数据量也跟着变多。
完整的算法是两层循环:
- 用当前的模型 对每道题写推理和答案。
- 答错的题目,加上正确答案作为提示,再写一次。
- 留下第一步答对的,以及第二步在提示下推出正确答案的。
- 从原来的 开始,用这些数据微调出 ,回到第一步。
这其实是强化学习
作者指出,STaR 可以看作强化学习的近似。把推理 当作隐变量,答对得 1 分、答错得 0 分,整个数据集的期望奖励和梯度是:
这是标准的策略梯度。答错的样本奖励是 0,梯度直接消失,相当于 STaR 的「只留答对的」;答对的样本,梯度就是普通的对数似然,相当于拿它做监督微调。
和真正的策略梯度相比,STaR 做了两个简化:用贪婪解码取代随机采样,降低方差,代价是探索得比较少;在同一批数据上做很多步梯度更新。rationalization 则可以看作从另一个分布 采样,也就是离策略(off-policy)的估计。
这段推导在当时只是顺带一提,后来却成了理解推理模型训练的一个方便角度。
实验设置
- 模型:GPT-J 6B,因为权重和微调代码都公开,而且够大,写得出有一定质量的推理。batch 是 8 条长度 1024 的序列,学习率 ,在一个 TPU v3 节点上训练和采样。
- 加法:两个 位数相加,按照 Nye 等人的 scratchpad 格式写出逐位相加的过程。先生成 5 万道题,每轮抽 1 万道;1 到 5 位数各有 10 个示例。
- CommonsenseQA:五选一的常识问答,训练集 9,741 道题。提示词用思维链论文的 10 道题,作者修正了其中一道题的错误答案,并让推理更明确地引用相关知识。
- GSM8K:小学数学应用题,训练集 7,473 道,测试集 1,319 道。
加法题的推理按照原论文 Figure 3 的格式,从个位开始逐位相加,C 是进位。以 624 + 259 为例:
<scratch>
6 2 4 + 2 5 9 , C: 0
2 + 5 , 3 C: 1
6 + 2 , 8 3 C: 0
, 8 8 3 C: 0
0 8 8 3
</scratch>
8 8 3
每一行是下一组要加的数位、目前累积的结果和进位。模型要学会自己写出从 <scratch> 到最后答案的全部内容;在 rationalization 时,正确答案会放在提示词的「Target:」后面。
这种格式的推理和答案绑得很紧,推理中间错一步,答案几乎一定错。这一点在后面很重要。
讨论
加法:一位一位往上爬
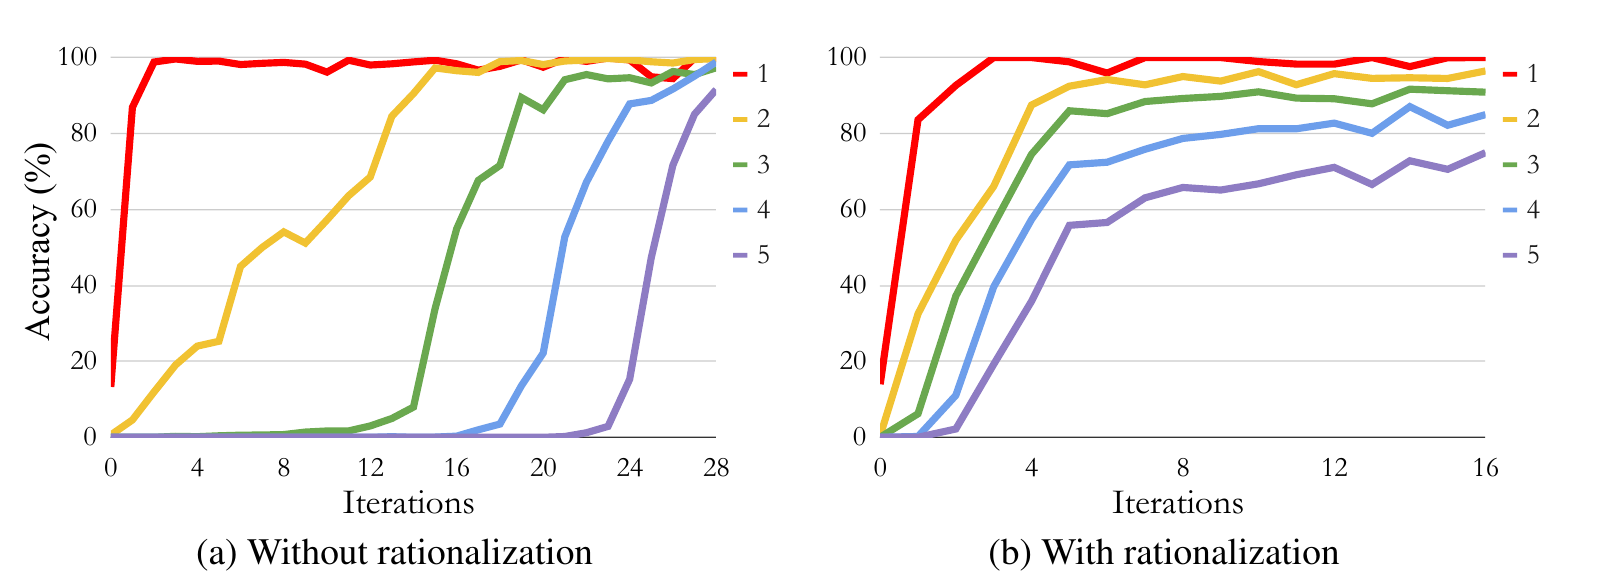
起点非常低。少样本提示时,GPT-J 做两位数加法的准确率不到 1%,位数更多时几乎是 0。
没有 rationalization 时(左图),进步是一级一级的。模型要先把 位数学好, 位数才开始有起色,5 位数要等到第 23 轮左右。这很合理,只有答对的题目能进训练数据,模型得先偶尔答对几道 位数的题,才有东西可学。
加上 rationalization 之后(右图),各种位数几乎一起进步,只是准确率不一样。第一轮微调后,两位数就从不到 1% 跳到 32%。因为有提示,很多题目在少样本时就能做出来,所以这组从 300 步开始训练,每轮加 20 步。
论文报告跑 16 轮之后,整体准确率是 89.5%。作为对照,不写推理、直接用 1 万道题训练 5,000 步的模型是 76.3%。
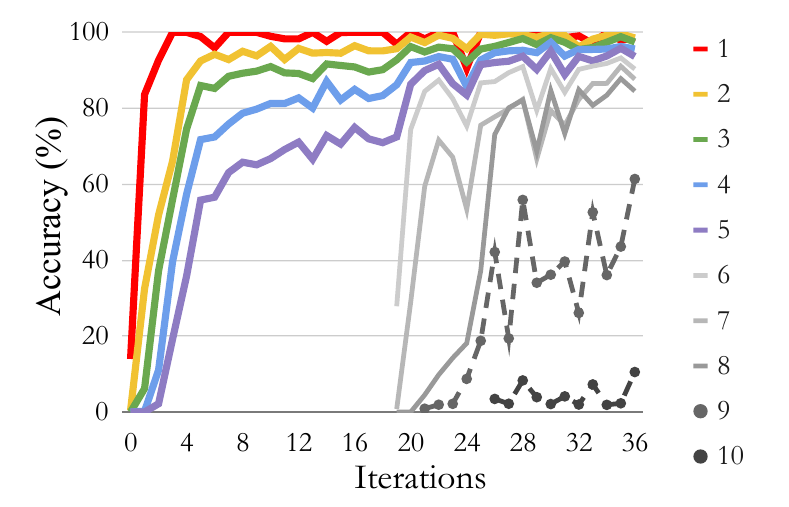
作者另外在第 20 轮左右加入更多位数的题目,总训练题数不变。原本的 1 到 5 位数反而进步得更快,而且从未在训练中出现过的 9、10 位数也能答对一部分。代价是训练变得不稳定,原因作者也说不清楚。
CommonsenseQA:6B 追上 175B
| 方法 | 准确率 | 用到的训练数据 |
|---|---|---|
| GPT-3 175B 直接微调输出答案 | 73.0 | 100% |
| GPT-J 少样本,直接回答 | 20.9 | 约 0 |
| GPT-J 少样本思维链 | 36.6 | 约 0 |
| LaMDA 137B 少样本思维链 | 55.6 | 约 0 |
| GPT-J 直接微调输出答案 | 60.0 | 100% |
| STaR(无 rationalization) | 68.8 | 69.7% |
| STaR(有 rationalization) | 72.5 | 86.7% |
整理自原论文 Table 1;准确率为验证集上的 %。最后一行的 86.7% 中,有 78.2% 来自自己答对的题目,8.5% 来自 rationalization。
这张表有几件事值得对照:
- 只用 GPT-J 自己写的推理,就比拿全部数据直接微调高 8.8 个百分点,而 STaR 只用到了七成的题目。
- 加上 rationalization 到 72.5%,和大了将近 30 倍的 GPT-3 微调结果 73.0% 只差 0.5。
- 小模型少样本思维链只有 36.6%,STaR 把它拉高了 35.9 个百分点,也超过了 LaMDA 137B 的少样本思维链。
五选一的题目瞎猜就有 20%,作者也提到,只靠语义相似度这类简单的启发式方法就能到 30% 左右。
另一个发现是,微调时把那几个少样本示例也放进训练序列,对成绩有明显帮助。没有 rationalization 时从 60.9% 到 68.8%,有 rationalization 时从 69.9% 到 72.5%。
推理的质量
推理写得好不好,在加法题上可以直接和标准过程比对,常识题就只能靠人看。作者随机挑了 50 道题,这些题目少样本思维链和 STaR 都答对了,再找来 CoS-E 里人写的解释。20 位众包工作者各看 10 道题,给三种推理排序。
结果 STaR 的推理排在少样本推理前面的概率高了 30%(),排在人写的解释前面的概率高了 74%()。作者特别说明,这个结果反映的是找人写出高质量的解释本来就很难,模型写推理的能力还没到人的水平。
不过,答案对了,推理也可能很空洞。附录列了好几种答案正确、推理却站不住的类型,最常见的是把题目换个说法,就当成理由:
Q: What might someone get from learning about science?
Answer Choices:
(a) headache
(b) see things differently
(c) increased knowledge
(d) accidents
(e) appreciation of nature
A: The answer must be something that someone would get from learning about
science. Learning about science would increase knowledge. Therefore, the
answer is increased knowledge (c).
原论文附录 A.1 的例子。
「学科学会增加知识,所以答案是增加知识」,这句话没有错,但也没有解释为什么不是「appreciation of nature」。其他类型还有循环论证、干脆不给理由,以及把题目里的人名当成真实人物,说出「James 从高处会感到兴奋」这种推理。
GSM8K:绝对分数很低,相对翻倍
| 方法 | 测试集准确率 | 用到的训练数据 |
|---|---|---|
| GPT-J 少样本,直接回答 | 3.0 | 约 0 |
| GPT-J 少样本思维链 | 3.1 | 约 0 |
| GPT-J 直接微调输出答案 | 5.8 | 100% |
| STaR(无 rationalization) | 10.1 | 25.0% |
| STaR(有 rationalization) | 10.7 | 28.7% |
整理自原论文 Table 2;单位为 %。
6B 的 GPT-J 做小学数学很吃力,STaR 也只到 10.7%,但比直接微调的 5.8% 多了将近一倍,而且只用了四分之一左右的题目。这里 rationalization 几乎没有帮助,用到的 28.7% 数据里,只有 0.5% 来自 rationalization。训练步数也得设上限,否则耗时太长,最后跑了 36 轮,再加上 10 轮 rationalization。
作者比对了模型和标准解答用的计算步数,一致的比例在 53% 到 57% 之间。不一致时,模型通常用的步数更少。有时是跳步,有时是找到了不同的解法,附录有一道题标准解答用了 7 步,模型略过多余的信息,一步就解完了。
为什么不多采样几次
要扩充训练数据,最直觉的做法是提高温度、多采样几次,总会有几次答对。作者试过,效果反而更差。
温度一高,「推理错了、答案却碰巧对了」的样本就变多,拿这种数据训练,模型学不到能泛化的东西。加法题特别明显,用高温采样学出来的 scratchpad 会慢慢变得毫无意义,模型就卡住了。温度 0.5 或 0.7 的版本,一律比不加 rationalization 的 STaR 还差。而且采样 10 次大约慢 10 倍,比 rationalization 贵得多。
「碰巧答对」的比例,和题型的猜中概率关系很大。假设模型的推理真正正确的比例是 ,推理错的时候仍有 的概率猜中答案,那么通过「答案正确」这道过滤的数据里,推理其实是错的比例是
多位数加法几乎不可能猜中, 接近 0,过滤很干净。五选一的 CommonsenseQA 若按随机猜测的 估算,一开始 时,留下来的数据约有 64% 是碰巧猜对的; 升到 0.6 时降到约 12%。是非题的 ,情况更糟。模型越来越强之后,比例会下降,但起步阶段的数据质量最差,偏偏又最关键。
局限
作者在结论和附录里提了这几点:
- 起点不能太弱:第一轮要成功,少样本的表现必须高于瞎猜,模型得本来就有一点推理能力。作者试过 GPT-2,连加法都启动不了。
- 猜中概率高的任务:是非题这类任务会留下很多烂推理,怎么过滤还没有答案。
- 偏差会被放大:STaR 放大的是「能答对」的推理,如果数据集里的偏见有助于答对,偏见也会被放大;rationalization 还会把模型原本不会主动给出的偏颇答案「拉」出来。
- 推理不一定忠实:模型可能先选好答案,再编一段理由,这种推理和模型实际的判断依据无关,而 STaR 没有办法检查这一点。
- 提示不一定好给:这里的提示就是正确答案,但在其他场景下,怎么给提示未必那么直接。
作者也提了一个延伸:用高温采样多个推理,对答案投票,把多数投票的答案当作标准答案,这样连没有答案的题目也能拿来训练。
后来的事
STaR 的循环后来被放大了好几次。2023 年 12 月,Google DeepMind 的 ReSTEM 把同样的做法放到 PaLM 2 上,在 MATH 和编程题 APPS 上做:采样、按答案对错过滤、微调,重复几轮,并从期望最大化(EM)的角度重新推导,结果胜过只用人写的数据微调。
作者自己在 2024 年 3 月提出了 Quiet-STaR,把「先想再说」搬进预训练:在普通网络文本上,让模型在每个 token 之后生成一小段内部推理,用它来预测后面的文字。在 OpenWebMath 和 C4 上继续预训练之后,Mistral 7B 在没有任务微调的情况下,GSM8K 从 5.9% 升到 10.9%,CommonsenseQA 从 36.3% 升到 47.2%。
那段策略梯度的推导,则在推理模型身上变成了真正的强化学习。DeepSeek-R1 的奖励就是「答案对不对」这类规则;它在强化学习之后收集监督微调数据时,每个提示词采样多个回答,只保留答对的,共收集了约 60 万条推理数据。这和 STaR 的筛选是同一件事,规模大了几个数量级。
结论
STaR 只用 10 个带推理的示例,加上一批只有答案的题目,让 GPT-J 6B 自己写出数千条推理来训练自己。在 CommonsenseQA 上拿到 72.5%,和大了将近 30 倍、直接微调的 GPT-3 只差 0.5 个百分点。
最巧妙的是 rationalization。做不出来的题目先告诉模型答案,让它倒推出理由,训练时再把答案藏起来;难题因此也能进入训练数据,加法题的各种位数可以一起进步,不用一级一级地等。
它的弱点也很清楚,筛选只看答案。答案容易猜中的题型,留下来的推理可能有一大半是凑出来的,而论文到最后也没解决这件事。后来的推理模型改用更大的模型、更多的采样和更严格的验证,把这个循环越转越大,最初那个问题仍然摆在那里。