原始论文
Let's Verify Step by Step
- 发表版本
- ICLR 2024会议
- arXiv 首次提交
- arXiv:2305.20050
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningletsverify2023,
  title = {{Let's Verify Step by Step}},
  author = {Hunter Lightman and Vineet Kosaraju and Yura Burda and Harri Edwards and Bowen Baker and Teddy Lee and Jan Leike and John Schulman and Ilya Sutskever and Karl Cobbe},
  year = {2023},
  eprint = {2305.20050},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.20050}
}
数学题的解答,常常是十几步推导连成一长串。其中一步算错,后面写得再漂亮,答案也是错的;更麻烦的是,有时候中间错了,答案却碰巧是对的。
要让模型更可靠,一个常见的做法是训练一个奖励模型,分辨解答的好坏。它可以拿来做强化学习,也可以在推理时从很多个候选里挑出最好的一个。不管哪一种用法,整个系统最多也就和奖励模型一样可靠。
奖励模型要怎么教?DeepMind 的 Uesato 等人在 2022 年比较过两种做法:只看最后答案对不对的结果监督,以及逐步检查每一步的过程监督。在小学数学 GSM8K 上,两者的最终表现差不多。
OpenAI 的 Lightman 等人重做了一次比较,这次用的是更强的模型(GPT-4)、多得多的人工标注,以及难得多的题目(MATH,高中竞赛水平)。结论不一样了。
定义问题
两种奖励模型的差别在训练信号:
- 结果监督奖励模型(ORM):学习预测一整份解答是对是错。标签可以自动生成,因为 MATH 的每一题都有能自动比对的最终答案。推理时,取模型在最后一个 token 上的预测作为解答的分数。
- 过程监督奖励模型(PRM):学习预测每一步是对是错。这没办法自动判断,得请人一步一步标。
ORM 的标签有一个天生的漏洞,推理错误、答案碰巧正确的解答会被标成对的。
这篇只研究奖励模型本身,不用它去强化学习生成解答的模型。评估方式是 best-of-N:固定一个生成解答的模型(generator),每题采样 N 份解答,让奖励模型挑出分数最高的那份,看答对的比例。奖励模型越可靠,就越常挑到正确的那份。
解决问题
两种规模的模型
大规模的模型全部从 GPT-4 的基底模型微调而来。这个基底模型只做过预测下一个 token 的预训练,没有经过 RLHF。目标是做出最好的 ORM 和 PRM。
小规模的模型结构类似 GPT-4,但预训练的计算量大约少 200 倍,用来做大规模时负担不起的对照实验。
所有模型都先在 MathMix 上多训练一轮,这是大约 15 亿个 token 的数学相关数据,能提升数学推理能力。
生成解答的模型也经过微调。作者用少样本提示让模型解 MATH 的训练题,留下答对的,用这些解答训练一个 epoch,目的只是让它学会一行一步的格式,方便切分步骤,而不是教它新技能。
一步一步标
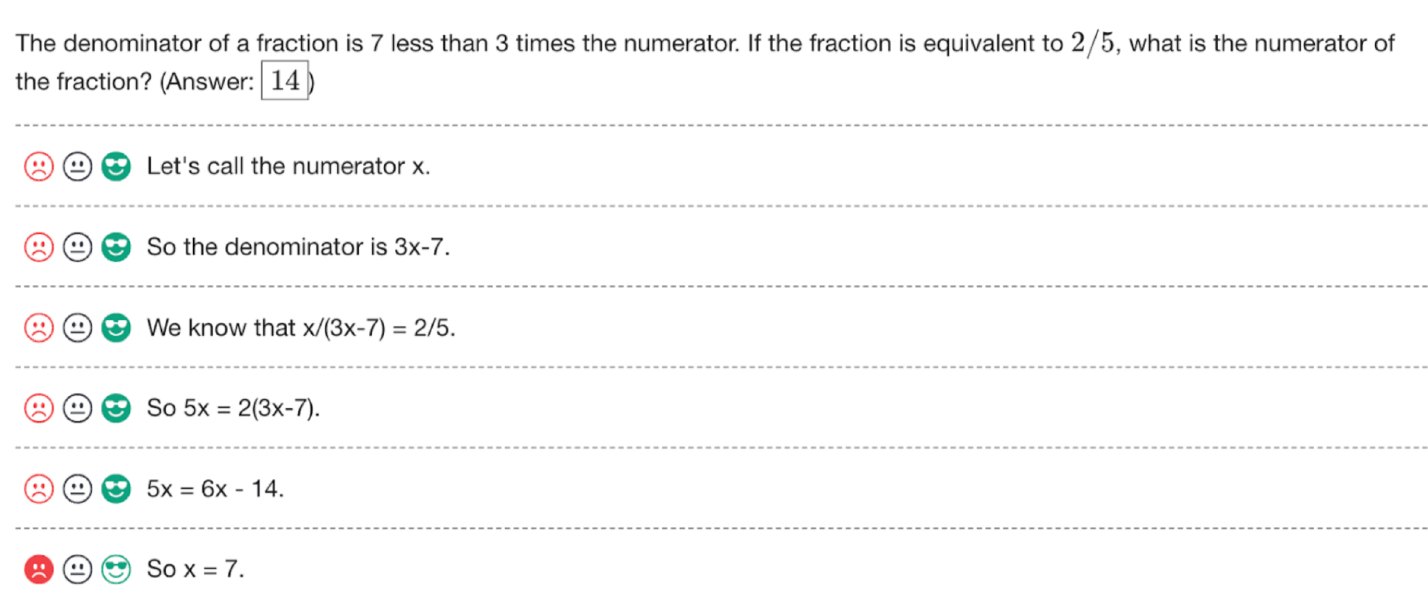
标注者看大规模 generator 写的解答,为每一步标上三种标签之一:
- 正面:这一步正确、合理,而且有往答案推进。
- 负面:这一步错误或不合理。
- 中性:模棱两可,例如有点误导,或者技术上正确但不是好的方向。
保留中性这个选项,是把怎么处理模糊情况的决定往后推,推理时可以把中性当成正面或负面。标注者会拿到正确的最终答案,但拿不到参考解法,避免他们只认同某一种解题方式。
最后整理成 PRM800K:80 万个步骤标签,来自 1.2 万道题的 7.5 万份解答。题目不够用,作者把 MATH 测试集的 4,500 题也拿去当训练题,评估只用剩下随机抽出的 500 题。附录确认了这 500 题的难度和科目分布,和整个测试集差不多。
挑哪些解答给人标
标注很贵,所以要挑信息量大的解答。一份明显写错的解答,标了也学不到多少东西。
作者的策略是挑「有说服力的错误答案」:目前最好的 PRM 给了高分,最终答案却是错的。既然答案错了,PRM 至少看错了其中一步,请人标出是哪一步,就是在补 PRM 的盲点。数据收集的过程中,PRM 会用最新的标注重新训练几次,再挑下一批。
PRM 怎么训练、怎么打分
PRM 在每一步的最后一个 token 之后,预测一个代表对错的 token,用一般语言模型的训练方式最大化这个 token 的对数似然,不需要特别的架构。推理时,对整份解答做一次前向计算,就能拿到每一步的分数。
一份解答的总分,定义为「每一步都正确」的概率,也就是各步正确概率的乘积。以标注界面上那一题为例,前五步都对,从 5x = 6x − 14 应该得到 x = 14,最后一步却写成 x = 7。只要有一步的概率很低,乘起来的总分就很低,而且 PRM 能指出错在哪一步。
乘积也有副作用,步骤越多,乘起来越小。十二步、每步 0.95 的解答,总分约 0.54,反而比两步、每步 0.8 的解答(0.64)低。作者在附录比较了四种打分方式(中性算正面或负面、取乘积或最小值),差距都很小:
| 中性步骤 | 乘积 | 最小值 |
|---|---|---|
| 算正面 | 78.2 | 77.6 |
| 算负面 | 77.4 | 77.8 |
整理自原论文附录 Table 4;数值为 best-of-1860 的答对比例(%)。
全文用的是表现最好的那一格:中性算正面,取乘积。作者也承认,乘积对步骤多的解答稍有不利。
只标到第一个错误为止
过程监督只标到第一个错误的步骤,后面不标。这样两种监督的比较更公平。
答对的解答,两种监督给的信息一样,每一步都是对的。答错的解答,两者都知道里面有错,过程监督还多知道错在哪一步。如果第一个错误之后还继续标,过程监督在信息量上就更占优势了。
这也让人工成本差不多。如果没有现成的最终答案可以比对,判断一份解答对不对,本来就等于找出它的第一个错误。MATH 的题目都有容易比对的答案,作者预期在更复杂的领域,这个条件不会一直成立。
讨论
大规模:PRM 明显胜出
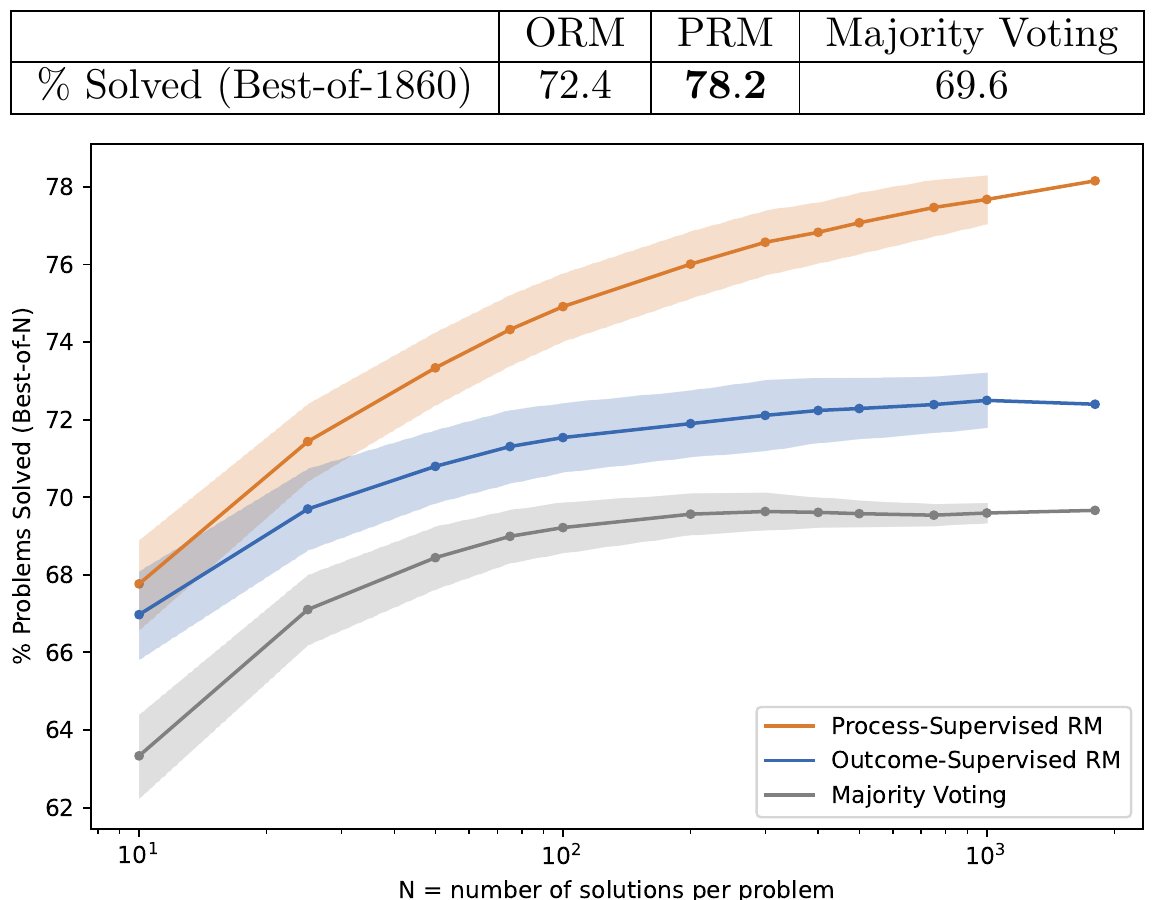
为了让 ORM 尽可能强,作者每题均匀采样 100 份解答来训练它,数据量比 PRM800K 大一个数量级,两份数据完全不重叠。
每题 1,860 份解答里挑一份,PRM 答对 78.2%,ORM 72.4%,多数投票 69.6%。ORM 只比多数投票好一点,PRM 则明显胜过两者,而且 N 越大,差距越大。要从大量候选里挑出正确的那份,PRM 最可靠。
作者也试过用奖励模型的分数给多数投票加权,希望兼得两者的好处,结果没有明显帮助。
小规模:把干扰因素拆开
大规模的结果有两个干扰因素。第一,两者的训练数据不同:PRM 的数据是主动挑过的,偏向错误答案,而且小了一个数量级。第二,用最终答案判断对错,会把「推理错、答案对」的解答标成正确,拖累 ORM,这该不该算在结果监督头上,见仁见智。
真人标注太贵,没办法拿来做这些对照。作者改用大规模的 PRM(以下称 PRMlarge)当标注者,为小规模的模型生成标签,用便宜的方式模拟大量的数据收集。
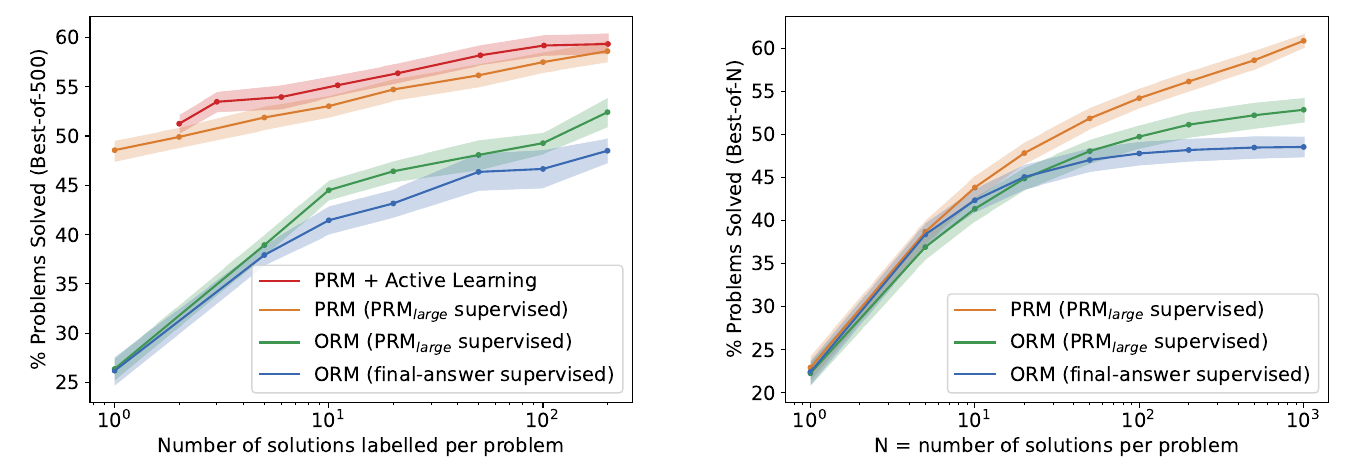
每题采样 1 到 200 份解答,同一份数据给三种监督:PRMlarge 逐步标注的过程监督、PRMlarge 只判断整份对错的结果监督、用最终答案比对的结果监督。三组模型唯一的差别,就是监督的方式。
不管数据多少,过程监督都明显胜过两种结果监督。两种结果监督之间,用 PRMlarge 判断的比用最终答案比对的好,因为它能把「推理错、答案对」的解答判成错的。
作者认为用 PRMlarge 判断的那组是更合适的对照。在不容易出现这种假阳性的领域,结果监督会更像它;MATH 的假阳性问题,可能被放大了。
主动学习:先用每题 1 份解答训练一个小 PRM,请它为每题 1,000 份解答打分。接着每题挑 N 份,其中 80% 是它评分最高的错误答案,20% 是剩下评分最高的解答(不论对错),再交给 PRMlarge 标注。比较两条拟合线的斜率,这种主动学习的数据效率大约是均匀挑选的 2.6 倍。
每题挑到 200 份时,表现略低于趋势线。作者的解释是 200 份已经占了 1,000 份候选的五分之一,可选的多样性不够。他们也试过在收集过程中反复重新训练挑选用的 PRM,却出现了无法诊断的不稳定,结果没有更好。
没见过的新题目
MATH 的题目在网上流传很广,可能出现在预训练数据里。作者另外找了最新的 AP 物理、AP 微积分、AP 化学、AMC10 和 AMC12 考题,这些都是在预训练数据收集完之后才公开的。每题采样 100 份解答:
| 考试 | ORM | PRM | 多数投票 | 题数 |
|---|---|---|---|---|
| AP 微积分 | 68.9% | 86.7% | 80.0% | 45 |
| AP 化学 | 68.9% | 80.0% | 71.7% | 60 |
| AP 物理 | 77.8% | 86.7% | 82.2% | 45 |
| AMC10/12 | 49.1% | 53.2% | 32.8% | 84 |
| 合计 | 63.8% | 72.9% | 61.3% | 234 |
整理自原论文 Table 1。
结果和 MATH 上一致,PRM 胜过 ORM 和多数投票。在 AMC 这类难题上,多数投票只有 32.8%,PRM 是 53.2%。
为什么过程监督更好
作者的解释是信用分配。结果监督只告诉模型「这份解答错了」,模型得自己猜错在哪里;题目越难,模型写的解答几乎都有错,「错了」这个标签带来的信息就越少。过程监督直接告诉模型前面几步是对的、错在哪一步,信号丰富得多。
作者也从对齐的角度做了讨论。过程监督奖励的是人认可的推理过程,而不是只看结果,更容易解读,也更不容易让模型学会钻奖励的漏洞。安全的做法常常要牺牲一点性能,这被称为对齐税(alignment tax);在这里,更安全的过程监督反而效果更好,作者称之为负的对齐税。他们也提醒,这个结论能不能推广到数学以外,目前还不知道。
限制
- 测试集污染:作者用字符串匹配,把 MATH 的题目从 MathMix 里删掉,但网上可能有难以察觉的改写版本,无法保证完全干净。他们检查了模型的解答,没有看到明显背答案的迹象;就算有少量污染,也应该对所有方法有类似的影响,相对的比较大致不受影响。PRM 常常能挑出 generator 自己只有个位数百分比概率写对的正确解答,也说明了这一点。
- 只研究奖励模型:没有用 PRM 去做强化学习、训练 generator,作者把这留给后续研究。
- 人工成本:PRM800K 有 80 万个步骤标签,靠的是大量的人工标注,而且只在数学上做过。
后来的事
那 500 道测试题,后来被整理成 MATH-500,成了推理模型最常见的评测之一。DeepSeek-R1 在 MATH-500 上的 pass@1 是 97.3%。
人工标注太贵的问题,很快有人找到了替代方案。2023 年 12 月的 Math-Shepherd 不请人标注,而是从每一步往下让模型多写几份完整的解答,看有多少能走到正确答案,用这个比例作为这一步的质量。它的作者和 DeepSeekMath 的作者有重叠。
PRM 也成了推理时搜索的主要工具,用来在每一步给候选打分、决定往哪里展开。不过 DeepSeek-R1 在「失败的尝试」里也记录了 PRM 的三个问题:一般的推理任务很难明确定义每一步;中间步骤的对错,自动标注不够准,人工标注又难以扩大规模;把模型当成奖励,在大规模强化学习中容易被钻漏洞。最后他们用的是只看答案对错的规则奖励。
结论
在 MATH 这种难题上,逐步标注的过程监督训练出的奖励模型,明显比只看答案的结果监督可靠。从 1,860 份解答里挑一份,PRM 答对 78.2%,ORM 72.4%,多数投票 69.6%;小规模的对照实验也确认,在同样的数据上,过程监督一路领先。
代价是 80 万个人工标签。主动学习能省下一些,挑「让 PRM 看走眼的错误解答」来标,效率大约高 2.6 倍,但终究要有人一步一步看过。
这篇最后留下最多痕迹的,可能是两样附带的东西:PRM800K 这份数据,以及那 500 道测试题。前者被拿去训练了无数的奖励模型,后者成了 MATH-500,至今还出现在每一份推理模型的成绩单上。