原始论文
Focusing on Tracks for Online Multi-Object Tracking
- 发表版本
- CVPR 2025会议
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@inproceedings{multiobjecttrackingtracktrack2025,
  title = {{Focusing on Tracks for Online Multi-Object Tracking}},
  author = {Kyujin Shim and Kangwook Ko and Yujin Yang and Changick Kim},
  year = {2025},
  booktitle = {CVPR},
  url = {https://doi.org/10.1109/CVPR52734.2025.01091},
  doi = {10.1109/CVPR52734.2025.01091}
}
匈牙利算法是跟踪器里最常见的组件。给一张轨迹对检测的代价矩阵,它找出总代价最小的一对一配对,从 SORT 开始,几乎每个先检测再关联的跟踪器都用它。
这个算法原本是为指派问题设计的,像是把工人分配到工作上,让总代价最低。每个工人配到哪份工作都可以,重要的是整体加起来最划算。
KAIST 的 Kyujin Shim、Changick Kim 等人认为,跟踪不是这种问题。轨迹和检测框代表的是同一批人,每条轨迹在这一帧都有一个正确的检测框。追求总代价最小,有时候会为了整体省一点点,把两个人的身份对调。
定义问题
差 0.01,换了身份
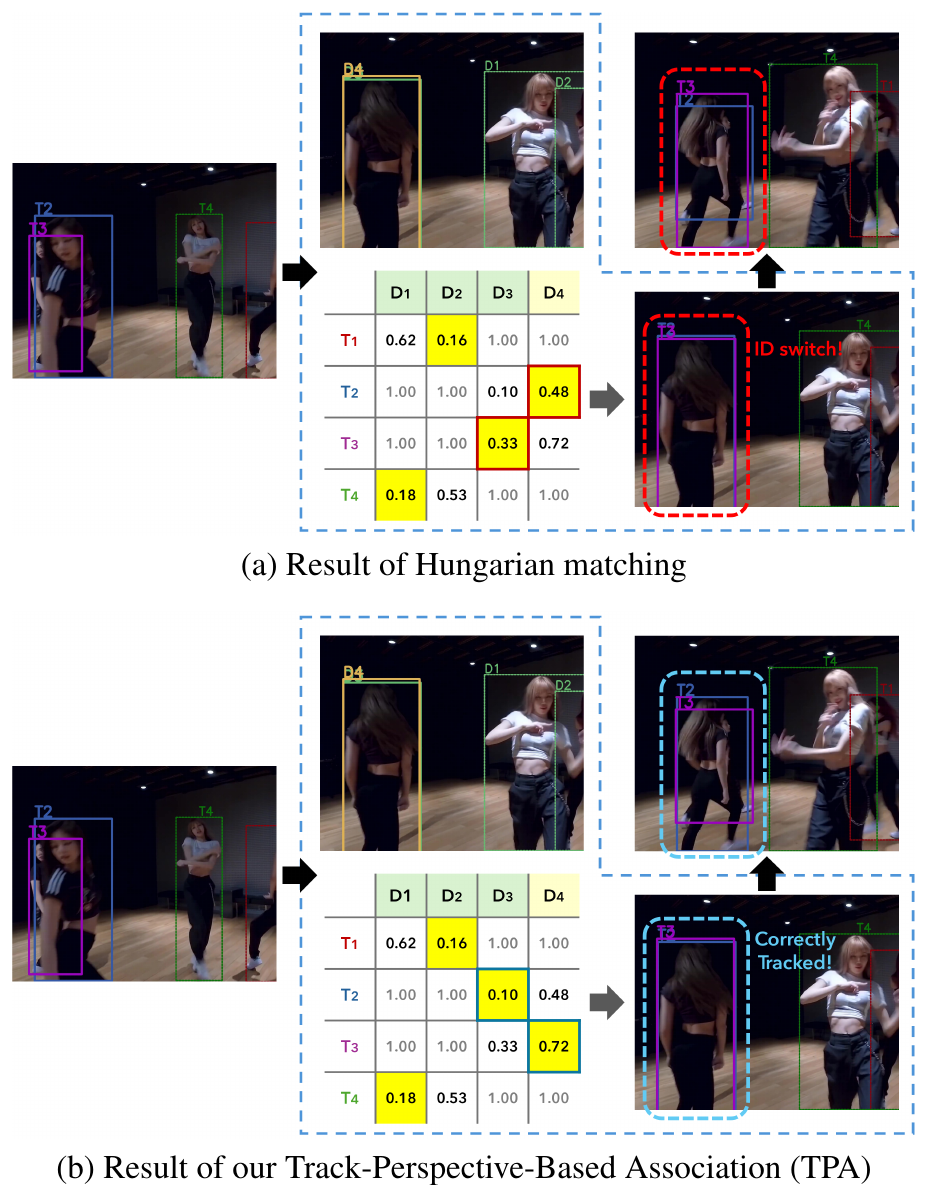
T1 配 D2(0.16)、T4 配 D1(0.18)没有争议,问题在 T2、T3 和 D3、D4 这四格:
| 配法 | T2 | T3 | 四对总代价 |
|---|---|---|---|
| 匈牙利算法 | D4:0.48 | D3:0.33 | 1.15 |
| TPA | D3:0.10 | D4:0.72 | 1.16 |
数字取自原论文 Figure 2,总代价为本文计算。
两种配法的总代价只差 0.01。匈牙利算法选了总和小的那个,可是在这个配法里,T2 明明和 D3 的距离只有 0.10,是整张表最小的一格,却被分去配 0.48 的 D4。
D3 最像 T2,T2 也最像 D3,两边互相看对了眼,这一对几乎不可能错。为了整体少 0.01,硬把它拆开,结果就是身份对调。
低分框排在后面
另一个问题来自 ByteTrack 以来的多阶段匹配。高分框先和轨迹配对,配剩的轨迹才轮到低分框。
可是被遮挡的人,检测分数常常偏低。对某条轨迹来说,最合适的框可能正是一个低分框,但它在第一轮就被某个不太合适的高分框抢走了。
更极端的是被 NMS 删掉的框。两个人重叠得很严重时,NMS 会把其中一个人的框当成重复删掉。图中的 D4 就是这样的框,它的分数很高,只是和别人重叠太多。大部分跟踪器根本不会再看它一眼。
解决问题
TrackTrack 有两个策略:配对时的 TPA(track-perspective-based association),和建立新轨迹时的 TAI(track-aware initialization)。整个方法不需要额外训练。
TPA:所有框一起,互相看对眼才配
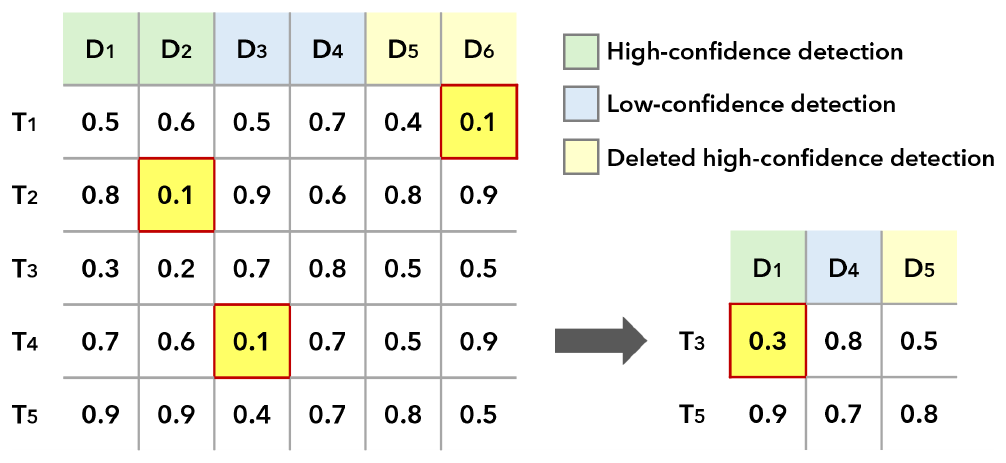
TPA 先把三种框放进同一个代价矩阵:NMS 后的高分框、NMS 后的低分框,以及被 NMS 删掉的高分框。后两种的代价各加一个惩罚,让它们在条件相同时排在高分框后面,但不会完全没机会。
代价本身沿用 Hybrid-SORT 的组合:框的重叠、外观特征的余弦距离、检测置信度,以及运动方向的角度差。
接着反复找出所有「互为最小」的配对,也就是这格在自己那一行是最小、在自己那一列也是最小,而且低于阈值。找到的配对全部确定,把它们的行和列拿掉,在剩下的矩阵里再找一次。每多一轮,阈值就收紧一点。
用图中的矩阵走一遍:
- 第一轮。 T1 那一行最小的是 D6(0.1),D6 那一列最小的也是 T1,配上。T2–D2、T4–D3 同理。T3 那一行最小的是 D2(0.2),但 D2 那一列最小的是 T2(0.1),T3 这一轮没配到。
- 第二轮。 剩下 T3、T5 和 D1、D4、D5。T3 那一行最小的是 D1(0.3),D1 那一列 T3 也比 T5 的 0.9 小,配上。
这个过程有点像相亲。两个人都觉得对方是现场最好的选择,就先凑成一对;条件比较不明确的,等确定的配完了,再从剩下的人里挑。
最确定的配对先处理,就不会像匈牙利算法那样,为了照顾整体,把最确定的那一对拆掉。
TAI:新轨迹不要和旧轨迹撞在一起
配完之后,剩下的高分框通常会被当成新出现的人,建立新轨迹。问题是,有些剩下的框其实是已有轨迹的重复检测,或是被挡住的人身上多出来的框。这些框一旦建成新轨迹,就是一堆短命的假轨迹。
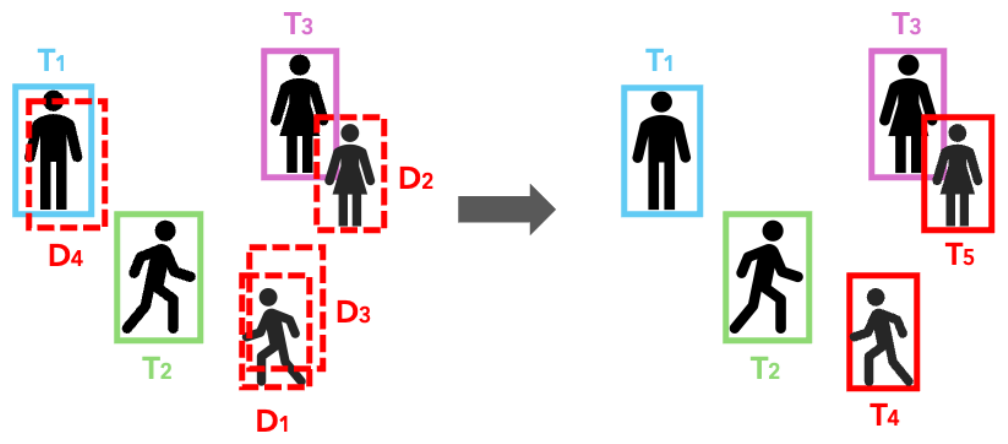
TAI 的做法是,把已经配上的轨迹的位置,当成置信度为 1、不能被删掉的框,和剩下的高分框一起再做一次 NMS。和现有轨迹重叠太多的框、和更高分的框重叠太多的框,都会被删掉。剩下的才建成新轨迹。
这次 NMS 的阈值可以根据场景调整:调低,只有很确定的新物体才会被建立;调高,拥挤的场景里比较不会漏掉真的新来的人。
整体流程
每一帧先用 YOLOX-X 检测,NSA 卡尔曼滤波预测轨迹位置,再用 TPA 配对。剩下的高分框,再和「出生不到三帧」的新轨迹配一次,这些新轨迹常常是反光之类的噪声,作者不让它们和已确认的轨迹抢框。最后用 TAI 决定哪些框可以建立新轨迹。
讨论
测试集
| 数据集 | TrackTrack HOTA | 在线方法次高 | 离线方法最高 |
|---|---|---|---|
| MOT17 | 67.1 | 66.4(ImprAsso) | 67.1(CoNo-Link) |
| MOT20 | 65.7 | 65.0(AdapTrack) | 65.9(CoNo-Link) |
| DanceTrack | 66.5 | 65.7(Hybrid-SORT-ReID) | 63.8(CoNo-Link) |
MOT17 整理自原论文 Table 1,MOT20 整理自原论文 Table 2,DanceTrack 整理自原论文 Table 3,均为测试集。
三个数据集上,TrackTrack 都是在线方法里的第一,而且和需要看整段视频的离线方法相比,也在伯仲之间。离线的 SUSHI 在 MOT17 是 66.5、DanceTrack 是 63.3,都比 TrackTrack 低。MOT17 的 IDF1 是 83.1,AssA 68.2,关联相关的指标进步最明显。
作者特别强调「在每个数据集都好」。很多方法在 MOT17 很强,到了 DanceTrack 就掉下来,反过来也一样;TrackTrack 在三个数据集都排在前面。
这里要注意的是,检测器用 CrowdHuman 和 WiderPerson 这两个额外的行人数据集一起训练。同期不用额外数据的 SambaMOTR 在 DanceTrack 上的 HOTA 是 67.2,不在这篇的比较表里。
消融
| 设置 | MOT17 HOTA | MOT17 AssA | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|
| 基线 | 67.3 | 69.6 | 61.9 | 47.7 |
| +TPA | 68.5 | 72.0 | 62.9 | 49.1 |
| +TAI | 67.4 | 69.6 | 62.6 | 48.7 |
| 两者 | 69.1 | 72.7 | 63.3 | 49.7 |
整理自原论文 Table 4,验证集。
基线是常见的做法:匈牙利算法、多阶段匹配、分数超过阈值就建新轨迹。TPA 的贡献比 TAI 大,在 MOT17 上 AssA 多了 2.4。
TPA 其实包含三个改动,作者也分别拆开来看:
- 互为最小 vs. 匈牙利算法。 其他条件不变,只换指派方式,MOT17 的 HOTA 从 68.1 到 69.1,DanceTrack 从 61.6 到 63.3。
- 一次配 vs. 分阶段配。 MOT17 的 HOTA 从 68.3 到 69.1;DanceTrack 只多 0.1,AssA 反而少了 0.1。分阶段在 DanceTrack 上影响不大。
- 用不用被 NMS 删掉的框。 用了之后,MOT17 的 HOTA 从 68.6 到 69.1,DanceTrack 从 62.1 到 63.3。
作者也分析了遮挡的影响。把遮挡严重度定义成「IoU 超过 0.6 的重叠数」除以「IoU 超过 0.1 的重叠数」,在五段 MOT17、MOT20 视频上,遮挡越严重,TrackTrack 比基线进步得越多。被遮挡的时候,最合适的框最可能是低分框或被删掉的框,也最可能被匈牙利算法拆散,TPA 正是为这种情况设计的。
速度
TPA 每一轮都要扫整个矩阵,听起来会比匈牙利算法慢。实际测起来反而快一点。不计后处理,MOT17 上从 155.4 FPS 变成 161.5 FPS,DanceTrack 从 394.8 变成 408.4。作者提到 TPA 只是用纯 Python 写的,匈牙利算法则用了高度优化的库,还有加速的空间。论文说明测量时排除了后处理;YOLOX-X 本身跑不到这个速度,这组数字反映的是关联步骤本身。
结论
TrackTrack 改的是怎么把轨迹和检测框配起来,这是跟踪器里最不起眼的一个环节。
匈牙利算法追求总代价最小,TPA 追求的是每条轨迹都配到它最合适的框。两者大部分时候结果一样,差别出现在遮挡的时候:总代价差 0.01 的两种配法,一种让两个人换了身份,一种没有。再加上把低分框、被 NMS 删掉的框都放进来一起比,被挡住的人就比较有机会被找回来。
两个策略都不需要训练,可以直接替换现有跟踪器的关联步骤。TrackTrack 靠着它们,让一个逐帧处理的在线跟踪器,在三个数据集上和看整段视频的离线方法并驾齐驱。