原始論文
Focusing on Tracks for Online Multi-Object Tracking
- 發表版本
- CVPR 2025會議
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@inproceedings{multiobjecttrackingtracktrack2025,
  title = {{Focusing on Tracks for Online Multi-Object Tracking}},
  author = {Kyujin Shim and Kangwook Ko and Yujin Yang and Changick Kim},
  year = {2025},
  booktitle = {CVPR},
  url = {https://doi.org/10.1109/CVPR52734.2025.01091},
  doi = {10.1109/CVPR52734.2025.01091}
}
匈牙利演算法是追蹤器裡最常見的元件。給一張軌跡對偵測的成本矩陣,它找出總成本最小的一對一配對,從 SORT 開始,幾乎每個先偵測再關聯的追蹤器都用它。
這個演算法原本是為指派問題設計的,像是把工人分配到工作上,讓總成本最低。每個工人配到哪份工作都可以,重要的是整體加起來最划算。
KAIST 的 Kyujin Shim、Changick Kim 等人認為,追蹤不是這種問題。軌跡和偵測框代表的是同一批人,每條軌跡在這一幀都有一個正確的偵測框。追求總成本最小,有時候會為了整體省一點點,把兩個人的身分對調。
定義問題
差 0.01,換了身分
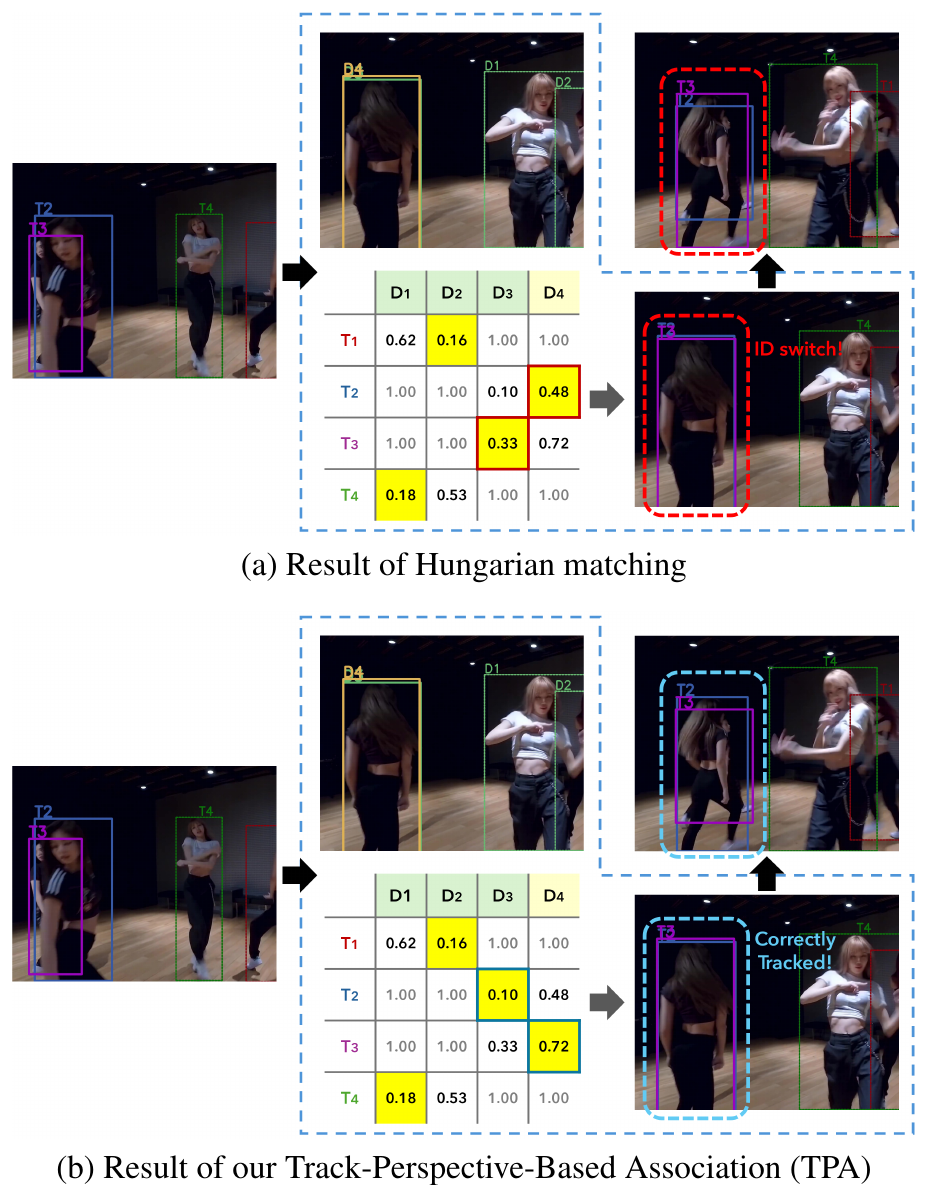
T1 配 D2(0.16)、T4 配 D1(0.18)沒有爭議,問題在 T2、T3 和 D3、D4 這四格:
| 配法 | T2 | T3 | 四對總成本 |
|---|---|---|---|
| 匈牙利演算法 | D4:0.48 | D3:0.33 | 1.15 |
| TPA | D3:0.10 | D4:0.72 | 1.16 |
數字取自原論文 Figure 2,總成本為本文計算。
兩種配法的總成本只差 0.01。匈牙利演算法選了總和小的那個,可是在這個配法裡,T2 明明和 D3 的距離只有 0.10,是整張表最小的一格,卻被分去配 0.48 的 D4。
D3 最像 T2,T2 也最像 D3,兩邊互相看對了眼,這一對幾乎不可能錯。為了整體少 0.01,硬把它拆開,結果就是身分對調。
低分框排在後面
另一個問題來自 ByteTrack 以來的多階段匹配。高分框先和軌跡配對,配剩的軌跡才輪到低分框。
可是被遮擋的人,偵測分數常常偏低。對某條軌跡來說,最合適的框可能正是一個低分框,但它在第一輪就被某個不太合適的高分框搶走了。
更極端的是被 NMS 刪掉的框。兩個人重疊得很嚴重時,NMS 會把其中一個人的框當成重複刪掉。圖中的 D4 就是這樣的框,它的分數很高,只是和別人重疊太多。大部分追蹤器根本不會再看它一眼。
解決問題
TrackTrack 有兩個策略:配對時的 TPA(track-perspective-based association),和建立新軌跡時的 TAI(track-aware initialization)。整個方法不需要額外訓練。
TPA:所有框一起,互相看對眼才配
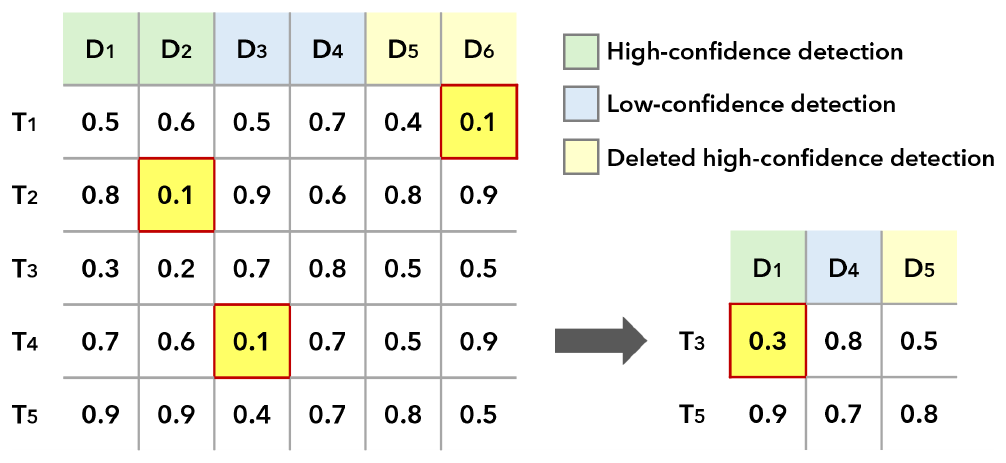
TPA 先把三種框放進同一個成本矩陣:NMS 後的高分框、NMS 後的低分框,以及被 NMS 刪掉的高分框。後兩種的成本各加一個懲罰,讓它們在條件相同時排在高分框後面,但不會完全沒機會。
成本本身沿用 Hybrid-SORT 的組合:框的重疊、外觀特徵的餘弦距離、偵測信心,以及運動方向的角度差。
接著反覆找出所有「互為最小」的配對,也就是這格在自己那一列是最小、在自己那一欄也是最小,而且低於門檻。找到的配對全部確定,把它們的列和欄拿掉,在剩下的矩陣裡再找一次。每多一輪,門檻就收緊一點。
用圖中的矩陣走一遍:
- 第一輪。 T1 那一列最小的是 D6(0.1),D6 那一欄最小的也是 T1,配上。T2–D2、T4–D3 同理。T3 那一列最小的是 D2(0.2),但 D2 那一欄最小的是 T2(0.1),T3 這一輪沒配到。
- 第二輪。 剩下 T3、T5 和 D1、D4、D5。T3 那一列最小的是 D1(0.3),D1 那一欄 T3 也比 T5 的 0.9 小,配上。
這個過程有點像相親。兩個人都覺得對方是現場最好的選擇,就先湊成一對;條件比較不明確的,等確定的配完了,再從剩下的人裡挑。
最確定的配對先處理,就不會像匈牙利演算法那樣,為了照顧整體,把最確定的那一對拆掉。
TAI:新軌跡不要和舊軌跡撞在一起
配完之後,剩下的高分框通常會被當成新出現的人,建立新軌跡。問題是,有些剩下的框其實是已有軌跡的重複偵測,或是被擋住的人身上多出來的框。這些框一旦建成新軌跡,就是一堆短命的假軌跡。
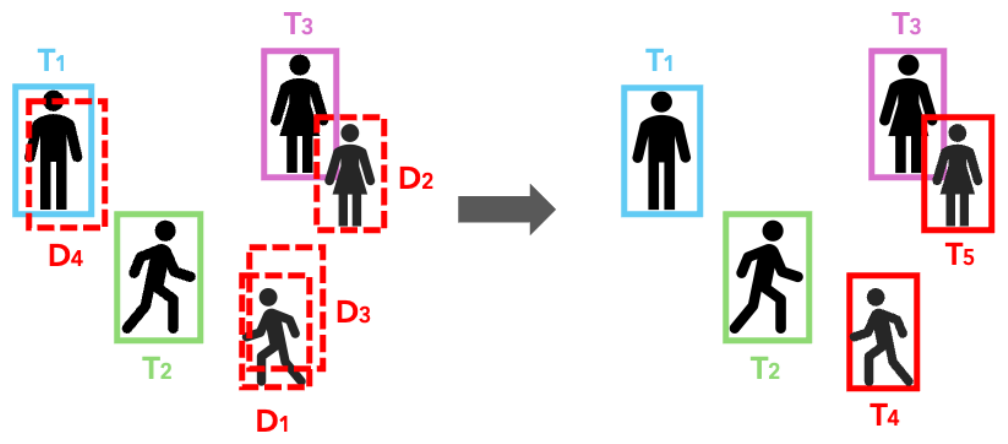
TAI 的做法是,把已經配上的軌跡的位置,當成信心為 1、不能被刪掉的框,和剩下的高分框一起再做一次 NMS。和現有軌跡重疊太多的框、和更高分的框重疊太多的框,都會被刪掉。剩下的才建成新軌跡。
這次 NMS 的門檻可以依場景調整:調低,只有很確定的新物體才會被建立;調高,擁擠的場景裡比較不會漏掉真的新來的人。
整體流程
每一幀先用 YOLOX-X 偵測,NSA 卡爾曼濾波預測軌跡位置,再用 TPA 配對。剩下的高分框,再和「出生不到三幀」的新軌跡配一次,這些新軌跡常常是反光之類的雜訊,作者不讓它們和已確認的軌跡搶框。最後用 TAI 決定哪些框可以建立新軌跡。
討論
測試集
| 資料集 | TrackTrack HOTA | 線上方法次高 | 離線方法最高 |
|---|---|---|---|
| MOT17 | 67.1 | 66.4(ImprAsso) | 67.1(CoNo-Link) |
| MOT20 | 65.7 | 65.0(AdapTrack) | 65.9(CoNo-Link) |
| DanceTrack | 66.5 | 65.7(Hybrid-SORT-ReID) | 63.8(CoNo-Link) |
MOT17 整理自原論文 Table 1,MOT20 整理自原論文 Table 2,DanceTrack 整理自原論文 Table 3,皆為測試集。
三個資料集,TrackTrack 在線上方法裡都是第一,而且和需要看整段影片的離線方法相比,也在伯仲之間。離線的 SUSHI 在 MOT17 是 66.5、DanceTrack 是 63.3,都比 TrackTrack 低。MOT17 的 IDF1 是 83.1,AssA 68.2,關聯相關的指標進步最明顯。
作者特別強調「在每個資料集都好」。很多方法在 MOT17 很強,到了 DanceTrack 就掉下來,反過來也一樣;TrackTrack 在三個資料集都排在前面。
這裡要注意的是,偵測器用 CrowdHuman 和 WiderPerson 這兩個額外的行人資料集一起訓練。同期不用額外資料的 SambaMOTR 在 DanceTrack 上的 HOTA 是 67.2,不在這篇的比較表裡。
消融
| 設定 | MOT17 HOTA | MOT17 AssA | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|
| 基準 | 67.3 | 69.6 | 61.9 | 47.7 |
| +TPA | 68.5 | 72.0 | 62.9 | 49.1 |
| +TAI | 67.4 | 69.6 | 62.6 | 48.7 |
| 兩者 | 69.1 | 72.7 | 63.3 | 49.7 |
整理自原論文 Table 4,驗證集。
基準是常見的做法:匈牙利演算法、多階段匹配、分數超過門檻就建新軌跡。TPA 的貢獻比 TAI 大,在 MOT17 上 AssA 多了 2.4。
TPA 其實包含三個改動,作者也分別拆開來看:
- 互為最小 vs. 匈牙利演算法。 其他條件不變,只換指派方式,MOT17 的 HOTA 從 68.1 到 69.1,DanceTrack 從 61.6 到 63.3。
- 一次配 vs. 分階段配。 MOT17 的 HOTA 從 68.3 到 69.1;DanceTrack 只多 0.1,AssA 反而少了 0.1。分階段在 DanceTrack 上影響不大。
- 用不用被 NMS 刪掉的框。 用了之後,MOT17 的 HOTA 從 68.6 到 69.1,DanceTrack 從 62.1 到 63.3。
作者也分析了遮擋的影響。把遮擋嚴重度定義成「IoU 超過 0.6 的重疊數」除以「IoU 超過 0.1 的重疊數」,在五段 MOT17、MOT20 影片上,遮擋越嚴重,TrackTrack 比基準進步得越多。被遮擋的時候,最合適的框最可能是低分框或被刪掉的框,也最可能被匈牙利演算法拆散,TPA 正是為這種情況設計的。
速度
TPA 每一輪都要掃整個矩陣,聽起來會比匈牙利演算法慢。實際量起來反而快一點。不計後處理,MOT17 上從 155.4 FPS 變成 161.5 FPS,DanceTrack 從 394.8 變成 408.4。作者提到 TPA 只是用純 Python 寫的,匈牙利演算法則用了高度最佳化的函式庫,還有加速的空間。論文說明量測時排除了後處理;YOLOX-X 本身跑不到這個速度,這組數字反映的是關聯步驟本身。
結論
TrackTrack 改的是怎麼把軌跡和偵測框配起來,這是追蹤器裡最不起眼的一個環節。
匈牙利演算法追求總成本最小,TPA 追求的是每條軌跡都配到它最合適的框。兩者大部分時候結果一樣,差別出現在遮擋的時候:總成本差 0.01 的兩種配法,一種讓兩個人換了身分,一種沒有。再加上把低分框、被 NMS 刪掉的框都放進來一起比,被擋住的人就比較有機會被找回來。
兩個策略都不需要訓練,可以直接替換現有追蹤器的關聯步驟。TrackTrack 靠著它們,讓一個逐幀處理的線上追蹤器,在三個資料集上和看整段影片的離線方法並駕齊驅。