原始论文
ByteTrack: Multi-Object Tracking by Associating Every Detection Box
- 发表版本
- ECCV 2022会议
- arXiv 首次提交
- arXiv:2110.06864
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingbytetrack2021,
  title = {{ByteTrack: Multi-Object Tracking by Associating Every Detection Box}},
  author = {Yifu Zhang and Peize Sun and Yi Jiang and Dongdong Yu and Fucheng Weng and Zehuan Yuan and Ping Luo and Wenyu Liu and Xinggang Wang},
  year = {2021},
  eprint = {2110.06864},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06864}
}
这篇论文的引言,开头引了一句黑格尔:「凡是合理的都是现实的,凡是现实的都是合理的。」
跟踪论文引哲学家,不太常见。作者想说的是,检测器给出的低分框,有些其实是真的。
从 SORT 开始,几乎所有的跟踪器都有一个习惯,先把检测分数低于某个阈值的框丢掉,只拿高分框去匹配。理由很合理,低分框里有很多背景和误报,留着只会干扰跟踪。
可是一个人被别人挡住一半时,检测器的分数也会掉下来。把这些框丢掉,这个人的轨迹就断了。
FairMOT 的第一作者张一夫,这次和华中科技大学、香港大学、字节跳动的团队一起,把注意力从网络架构移到了这个阈值上。
定义问题
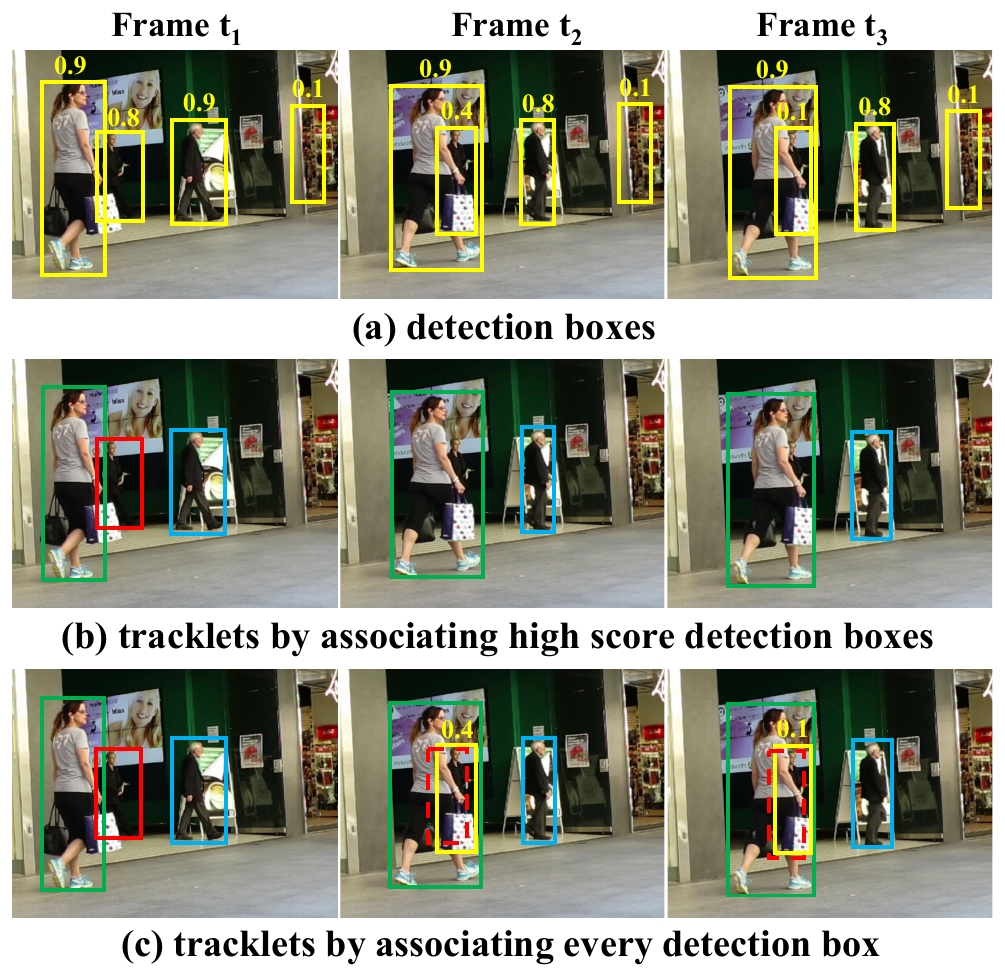
我们先看 (a) 这一排。第一帧有四个框,其中三个人的分数都在 0.8 以上,最右边那个 0.1 的框是背景。
到了第二帧,左边的女子走到中间那个人前面,把他挡住了一部分,他的分数从 0.8 掉到 0.4;第三帧挡得更多,分数只剩 0.1。
(b) 是一般的做法,只用分数高于 0.5 的框去匹配。被挡住的那个人在第二帧就失去了观测,红色轨迹跟着消失;等他从女子身后走出来,就会被当成一个新的人。
那全部留下来呢?最右边那个 0.1 的背景框也会被留下来,变成一条假的轨迹。
这就是检测阈值的两难。阈值高,漏掉被遮挡的人;阈值低,引入背景误报。作者指出,很少有方法真正处理这个两难。
他们注意到的线索,是和已有轨迹的相似度。被挡住的那个人,虽然分数很低,但他的框和卡尔曼滤波预测的红色轨迹位置高度重叠;最右边的背景框,附近没有任何轨迹。只要拿低分框去和「上一轮没匹配上的轨迹」比对,就能把真实物体捞回来,同时把背景过滤掉。
(c) 就是这样做的结果。
解决问题
作者把这个关联方法命名为 BYTE。名字来自计算机里的字节,每一个检测框都是轨迹的一个基本单位,就像字节是程序的基本单位。
整个流程只有两次关联:
准备: 用检测分数阈值 把这一帧的检测框分成两组,高分框 和低分框 。用卡尔曼滤波预测每条轨迹在这一帧的位置。
第一次关联: 拿高分框和所有轨迹匹配,包括暂时丢失的轨迹。相似度可以用预测框和检测框的 IoU,也可以用 re-ID 特征的距离,用匈牙利算法求解。没匹配上的高分框记为 ,没匹配上的轨迹记为 。
第二次关联: 拿低分框和 匹配,相似度只用 IoU。这一步结束后,仍然没匹配上的低分框直接丢掉,当作背景。
收尾: 两次都没匹配上的轨迹移到丢失集合,保留 30 帧,期间如果在第一次关联中被匹配上,就恢复原本的 ID;超过 30 帧才删除。第一次关联中没匹配上的高分框,则开启新的轨迹。丢失中的轨迹不输出。
为什么第二次关联只用 IoU?低分框之所以低分,通常是因为严重遮挡或运动模糊,这时候的外观特征不可靠。位置反而比较可靠:被挡住的人不会在一帧内跑太远。
BYTE 和检测器无关,也不限定第一次关联用什么相似度,可以接到任何跟踪器的后面。
作者再把 BYTE 接上当时很强的检测器 YOLOX,命名为 ByteTrack。在 MOT17、MOT20 这些行人数据集上,ByteTrack 两次关联都只用 IoU,没有任何 re-ID 特征。
讨论
ByteTrack 的检测器是 YOLOX-X,在 COCO 预训练后,用 MOT17、CrowdHuman、CityPersons、ETHZ 一起训练 80 个 epoch,输入尺寸 ,8 张 V100 约 12 小时。速度以 V100、FP16、批大小 1 测量。
消融实验把 MOT17 训练集每段视频切成前后两半,前半训练、后半验证,训练数据另外加上 CrowdHuman。
和其他关联方法比
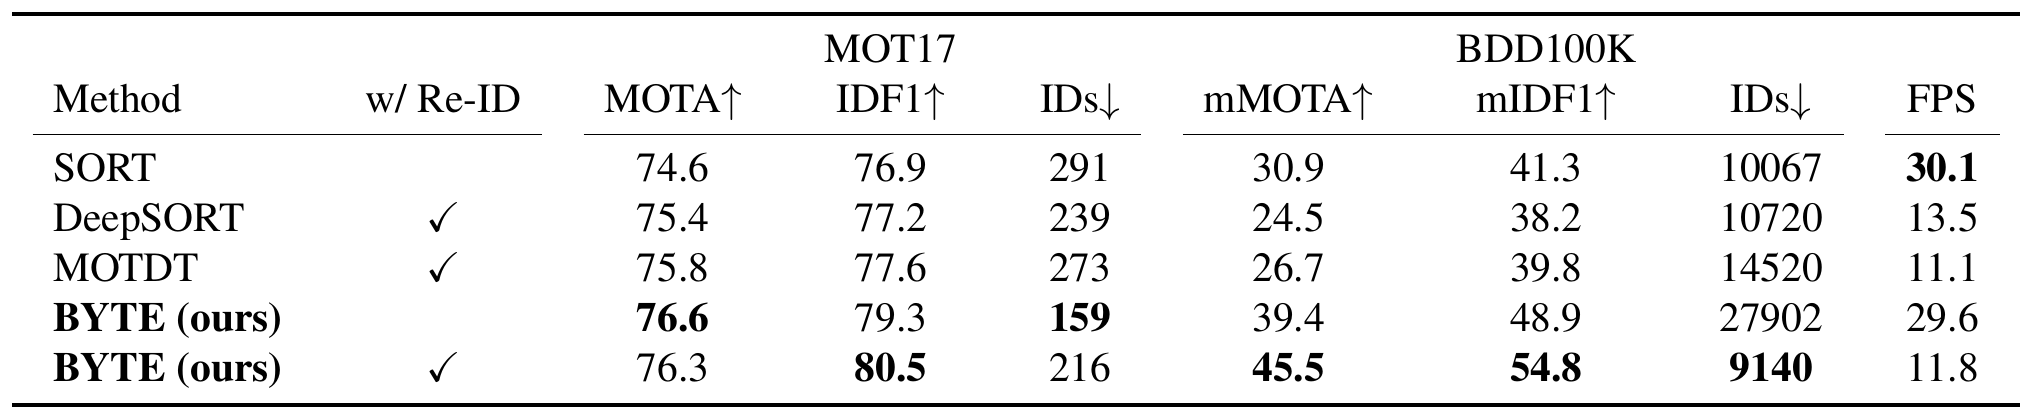
这张表的检测器都一样,差别只在关联方法。
SORT 可以看成 BYTE 的基线,两者都只用卡尔曼滤波和 IoU,差别只在有没有第二次关联。BYTE 把 MOTA 从 74.6 提升到 76.6,IDF1 从 76.9 提升到 79.3,ID 切换从 291 降到 159,速度几乎不变(30.1 对 29.6 FPS)。这就是低分框的价值。
更让作者意外的是 DeepSORT。它多了 re-ID 模型,但 MOTA、IDF1 和 ID 切换都输给只用 IoU 的 BYTE,速度也只有一半不到。作者的解读是,检测框够准的时候,简单的卡尔曼滤波就能做好长距离的关联;遇到严重遮挡,re-ID 特征反而容易出错,运动模型比较可靠。
BYTE 加上 re-ID 之后,IDF1 升到 80.5,但 MOTA 略降、ID 切换增加。
BDD100K 的情况则不同。这是车载视频,相机移动大、标注帧率低,卡尔曼滤波在这里会失效,所以作者在 BDD100K 上不用卡尔曼滤波。只用 IoU 的 BYTE 虽然比 SORT 高出很多(39.4 对 30.9),ID 切换却高达 27902;加上 re-ID 后 mMOTA 升到 45.5,ID 切换降到 9140。
作者也比较了两次关联该用什么相似度。在 MOT17 上,第一次用 IoU 或 re-ID 都可以,IoU 的 MOTA 和 ID 切换比较好,re-ID 的 IDF1 比较高;在 BDD100K 上,第一次关联用 re-ID 好得多。但两个数据集的第二次关联都是 IoU 比较好,用 IoU 比用 re-ID 大约多 1 分 MOTA。这支持了低分框的外观特征不可靠的判断。
对阈值不再那么敏感
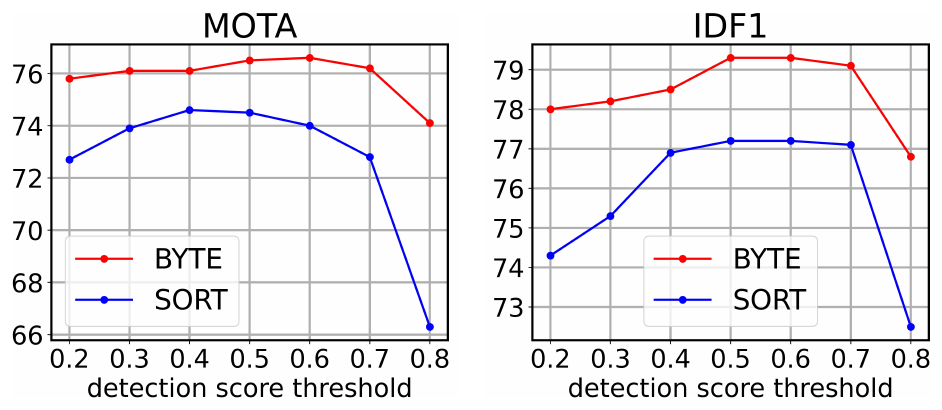
检测阈值通常是跟踪器最敏感、最需要仔细调的超参数。作者把阈值从 0.2 调到 0.8。SORT 的 MOTA 在阈值变高后快速下滑,从 0.4 时的约 74.5 掉到 0.8 时的约 66;BYTE 则相对平稳。
道理很直接。BYTE 的第二次关联会把低于阈值的框捞回来,阈值调高,被丢掉的框其实还有第二次机会。
作者也统计了低分框里的真阳性与误报。在所有分数介于下限和阈值之间的框中,有些视频(例如 MOT17-02)误报远多于真阳性;但 BYTE 从中捞回来的框,真阳性明显多于误报。和已有轨迹的相似度确实是一个有效的筛子。
接到别人的跟踪器上
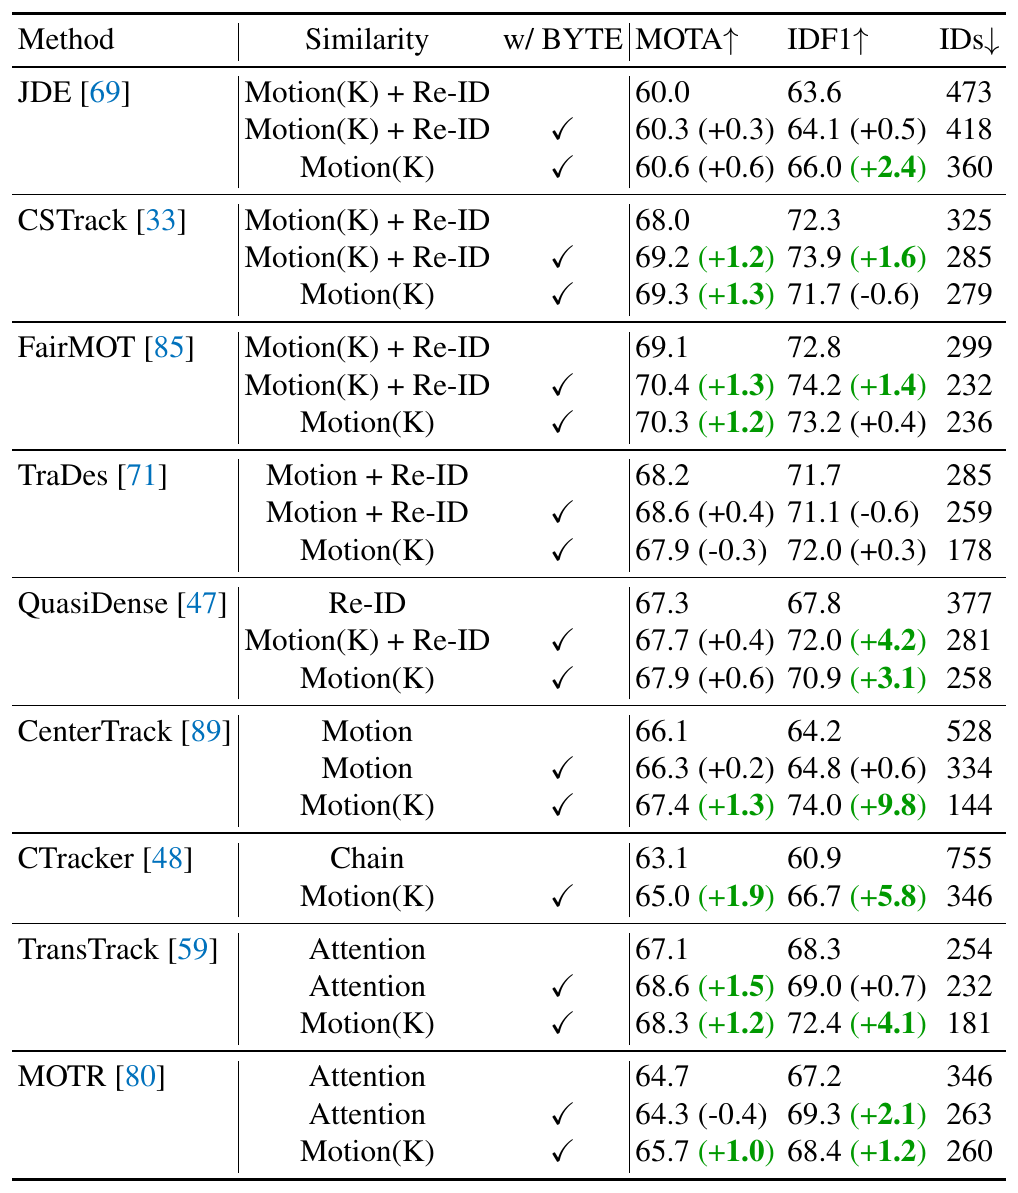
这是全篇最有说服力的一张表。作者把 BYTE 套到九个各式各样的跟踪器上:JDE、CSTrack、FairMOT、TraDeS 这类运动加 re-ID 的方法;只用 re-ID 的 QDTrack;用学习式运动的 CenterTrack;链式结构的 Chained-Tracker;用注意力传递框的 TransTrack 和 MOTR。
套用的方式有两种:
- 插入模式: 原本的关联照做,结束后把没匹配上的轨迹拿去和低分框做一次 IoU 匹配。
- 替换模式: 只拿该跟踪器的检测框,关联全部换成 BYTE。
几乎每一个跟踪器、每一项指标都有进步。最明显的是 CenterTrack,替换模式下 MOTA 多 1.3、IDF1 多 9.8,ID 切换从 528 降到 144。CenterTrack 原本只靠位移反推做局部匹配,被挡住的人一断就换 ID,BYTE 的丢失轨迹保留机制正好补上了这一块。
不过也不是全面进步。TraDeS 在替换模式下 MOTA 少了 0.3;MOTR 在插入模式下 MOTA 少了 0.4,IDF1 则多了 2.1。这张表比较的是同一个检测器下关联方法的差异,BYTE 的贡献主要在 IDF1 和 ID 切换。
排行榜
| 基准 | MOTA | IDF1 | HOTA | ID 切换 | FPS |
|---|---|---|---|---|---|
| MOT17 | 80.3 | 77.3 | 63.1 | 2196 | 29.6 |
| MOT20 | 77.8 | 75.2 | 61.3 | 1223 | 17.5 |
整理自原论文 Table 4、Table 5 的 ByteTrack 行。
MOT17 测试集上,ByteTrack 比当时第二名的 ReMOT 高出 3.3 MOTA、5.3 IDF1、3.4 HOTA,速度也是全表最快。作者特别提到,ByteTrack 的训练数据约 2.9 万张图像,比许多方法用的 7.3 万张少。
MOT20 平均每张测试图像有 170 个人,拥挤得多。论文写道,ByteTrack 把 MOTA 从 68.6 提升到 77.8,ID 切换从 4209 降到 1223,少了 71%。在 HiEve 上,MOTA 61.7、IDF1 63.1;在 BDD100K 测试集上,mMOTA 从 35.5 提升到 40.1。四个基准都排第一。
这里要分清楚两件事。ByteTrack 在排行榜上的大幅领先,有相当一部分来自 YOLOX-X 这个强检测器;BYTE 本身在同一个检测器下的贡献,要看前面那两组消融:和 SORT 比是 MOTA 多 2 分、IDF1 多 2.4 分,套到其他跟踪器上则是 MOTA 约 1 到 2 分、IDF1 最多将近 10 分。附录另外用 YOLOX 的小模型比较,BYTE 在每一种检测器大小下都赢过 DeepSORT,在最小的 YOLOX-Nano 上 MOTA 高了 3 分。
后来
ByteTrack 很快成了工程上的默认选项。Ultralytics 的跟踪模块提供 ByteTrack 和 BoT-SORT 两种跟踪器,并把 ByteTrack 定位成最快、最简单的基线;OC-SORT 和 BoT-SORT 都直接沿用 ByteTrack 的 YOLOX 权重来比较,等于把它当成了新一代的 SORT。
它的弱点也很早就被看见了。DanceTrack 论文报告的 ByteTrack HOTA 只有 47.7,AssA 32.1。舞者穿着相似、动作非线性,卡尔曼滤波加 IoU 的匹配顶不住,MOTR 和 OC-SORT 都在这个数据集上赢过它。只靠位置把人接起来,在人走直线的时候很好用,在人转圈的时候就不够了。
结论
被阈值丢掉的低分框,拿去和上一轮没匹配上的轨迹再匹配一次,只用 IoU。ByteTrack 的方法就这一个改动,SORT 的 ID 切换少了将近一半,九个不同的跟踪器套上去几乎都进步,配上 YOLOX 之后在四个基准拿下第一。
下次调跟踪器的检测阈值调到心烦时,可以先试试 BYTE。它让阈值从一刀切的生死线,变成只决定「谁先匹配」。
黑格尔大概没想过,自己有一天会在跟踪论文里替低分框背书。