原始论文
Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification
- 发表版本
- ICIP 2023会议
- arXiv 首次提交
- arXiv:2302.11813
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingdeepocsort2023,
  title = {{Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification}},
  author = {Gerard Maggiolino and Adnan Ahmad and Jinkun Cao and Kris Kitani},
  year = {2023},
  eprint = {2302.11813},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.11813}
}
2022 年前后,靠运动关联的跟踪器又火了起来。
检测器越来越强,ByteTrack 只用卡尔曼滤波和 IoU,就在 MOT17 上打败了一堆学习外观特征的方法。OC-SORT 修正了卡尔曼滤波在遮挡后误差累积的问题,在 DanceTrack 这种外观难以区分、动作又很复杂的场景,也比各种 re-ID 方法好。
但外观线索并不是没用,只是不好用。BoT-SORT、StrongSORT 也把外观加回来了,做法却都很简单。轨迹的外观特征用固定权重的指数移动平均更新,外观距离再用固定权重和运动代价相加。
卡内基梅隆大学的 Gerard Maggiolino、Adnan Ahmad,与 OC-SORT 的作者 Jinkun Cao、Kris Kitani,想把外观加进 OC-SORT,让外观特征在不可靠的时候少用、可靠的时候多用。
因为是在 OC-SORT 上加深度外观特征,所以叫 Deep OC-SORT。作者特别说明,这不是照着 DeepSORT 对 SORT 做的那套再做一次。
定义问题
从框里提取出来的外观特征,就算 re-ID 模型很强,还是有很多噪声:人被挡住一半、动作太快造成模糊、旁边刚好有人穿得很像。
以往的做法有两个地方是写死的:
- 更新权重固定。 指数移动平均的权重 是常数,不管这一帧的检测质量如何,新特征都以同样的比例混进轨迹的外观模型。一个被挡住一半的框,照样会污染轨迹的外观。
- 融合权重固定。 外观代价以固定比例加到运动代价上。一个检测和某条轨迹长得特别像、和其他轨迹都不像,跟一个检测和好几条轨迹都差不多像,两者的外观代价分量是一样的。
作者要让这两个权重都能随情况调整。另外,OC-SORT 非常依赖检测的位置,镜头一动,位置就跟着乱,所以再加上相机运动补偿。
解决问题
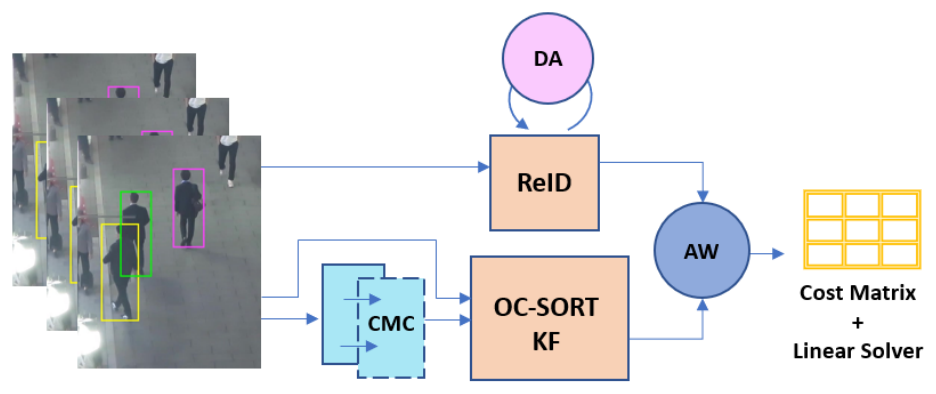
Deep OC-SORT 沿用 OC-SORT 的整个流程,包括以观测为中心的动量(OCM)、以观测为中心的找回(OCR)和在线平滑(OOS),以及最后的匈牙利算法。新增三个模块:相机运动补偿(CMC)、动态外观(DA)、自适应加权(AW)。
相机运动补偿
相机运动补偿用 OpenCV 的 VidStab 模块估计相邻两帧之间的相似变换,先提取特征点、算光流,再用 RANSAC 求出一个缩放旋转矩阵 和平移 。
BoT-SORT 也做了相机运动补偿,但只修正卡尔曼滤波的状态。OC-SORT 还有好几个地方直接用到过去的观测框,这些也都得一起修正:
- OOS: 物体重新出现时,OC-SORT 会从最后一次观测线性插值出一条虚拟轨迹,重新更新卡尔曼滤波。最后一次观测的框中心,先经过 修正,再开始插值。
- OCM: OC-SORT 用最近 个框算出运动方向。这些框的左上、右下角点,每一帧都经过 修正。
- OCR: 用最后一次看到的框找回丢失的轨迹,这个框的位置也每一帧修正。
卡尔曼滤波的状态是 ,中心位置、面积、长宽比,以及前三者的速度。修正方式是
只修正中心位置和中心速度,以及它们的协方差。理论上也可以把变换的缩放套到面积上、把旋转近似成长宽比的变化,但旋转后的外接框不是线性关系,要有物体的掩码才算得准。作者发现 OCM 和 OCR 对这种近似还算耐受,卡尔曼滤波就敏感得多,所以只修正中心。修正在卡尔曼滤波的预测步之前进行。
动态外观
一般的指数移动平均是
是这一帧匹配上的检测的外观特征。作者把固定的 换成随检测置信度变动的 :
是检测置信度, 是过滤噪声检测用的置信度阈值,。
想法很直接,检测置信度低,通常说明物体被挡住或图像模糊,这时提取出来的外观特征也不可信。
- 当 ,刚好在阈值上,,新特征完全被忽略。
- 当 ,,新特征以最大比例加入。
- 中间的置信度,线性插值。
本来就是跟踪器的参数, 就是原本固定的 。动态外观没有引入新的超参数,计算量也几乎为零。
自适应加权
外观代价矩阵 大小是 , 条轨迹、 个检测,每格是轨迹和检测的余弦相似度。一般的做法是和 IoU 矩阵以固定权重 相加:。
作者的观察是,外观匹配可不可信,要看它有没有「区分度」。一个真正的外观匹配,最高分和第二高分之间会有明显的差距。如果一条轨迹和好几个检测都差不多像,外观就不该有太大的发言权。
对第 条轨迹,区分度定义为这一行的最高分 减第二高分 ,并设一个上限 :
对第 个检测,用同样的方式计算那一列的 。两者平均,就是这一格的额外权重:
最后的代价矩阵是
作者刻意只看前两名,而不是用 KL 散度之类的分布指标。排在后面的那些低分彼此差多少,和这一次匹配可不可信无关。
实现
检测器沿用 ByteTrack 等方法的 YOLOX,re-ID 模型是 fast-reid 里的 SBS50。
MOT17 和 MOT20 上,、。DanceTrack 上则是 、,作者的说明是,在那里外观比 IoU 更有帮助。
讨论
每个模块的贡献
| 设置 | MOT17 HOTA | MOT17 IDF1 | MOT20 HOTA | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|---|
| OC-SORT | 68.13 | 79.52 | 58.35 | 53.07 | 35.93 |
| +CMC | 69.66 | 82.44 | 58.33 | 53.57 | 36.68 |
| +外观 | 68.59 | 80.18 | 59.10 | 58.03 | 42.37 |
| +外观+DA | 68.65 | 80.45 | 59.16 | 58.36 | 43.00 |
| +外观+DA+CMC | 69.80 | 82.56 | 59.35 | 58.46 | 43.33 |
| 全部(再+AW) | 70.20 | 82.78 | 59.45 | 58.53 | 43.41 |
整理自原论文 Table 3,三个数据集的验证集;「外观」指以固定权重 EMA 更新的外观特征。MOT20 的 IDF1 依次为 74.77、74.63、75.71、75.87、76.11、76.30。
相机运动补偿 单独加上去,MOT17 的 IDF1 多了将近 3 分,DanceTrack 也有小幅提升;MOT20 则没有提升,因为 MOT20 的视频都是固定镜头。
外观特征 是 DanceTrack 上最大的一步。光是加上固定 EMA 的外观,HOTA 就从 53.07 跳到 58.03,AssA 多了 6 分多。
动态外观 和 自适应加权 的提升都不大,但在三个数据集、所有指标上都是正的。
外观在 DanceTrack 上到底有没有用
这个结果和 DanceTrack 论文的发现很不一样。DanceTrack 的作者在固定 YOLOX 检测、只比较关联方法时,DeepSORT 比 SORT 差,加上外观反而变糟;用真实框做的 oracle 实验也一样,加了外观,所有指标都下降。
Jinkun Cao 是两篇论文共同的作者。在 OC-SORT 的基础上,外观反而成了 DanceTrack 上提升最多的组件。
两篇的设置差很多,re-ID 模型不同,运动模型也不同。DanceTrack 论文里的 DeepSORT,是在 SORT 那套容易在遮挡后失准的运动模型上,用外观当作主要的匹配依据;Deep OC-SORT 则是把外观当作 IoU 之外的辅助代价,加在一个本来就很稳的运动跟踪器上。舞者长得很像,但并不是完全一样,只要用的方式对,外观还是有信息可以榨。
测试集
| 数据集 | 方法 | HOTA | MOTA | IDF1 | ID 切换 | AssA |
|---|---|---|---|---|---|---|
| MOT17 | OC-SORT | 63.2 | 78.0 | 77.5 | 1,950 | 63.2 |
| MOT17 | StrongSORT++(离线) | 64.4 | 79.6 | 79.5 | 1,194 | 64.4 |
| MOT17 | Deep OC-SORT | 64.9 | 79.4 | 80.6 | 1,023 | 65.9 |
| MOT20 | OC-SORT | 62.1 | 75.5 | 75.9 | 913 | 62.0 |
| MOT20 | StrongSORT++(离线) | 62.6 | 73.8 | 77.0 | 770 | 64.0 |
| MOT20 | Deep OC-SORT | 63.9 | 75.6 | 79.2 | 779 | 65.7 |
整理自原论文 Table 1,MOT17 与 MOT20 测试集。
MOT17 上,Deep OC-SORT 的 HOTA 64.9,在当时的排行榜上排第二;MOT20 上 63.9,排第一。和 OC-SORT 比,ID 切换在 MOT17 上几乎少了一半。
StrongSORT++ 用了离线的后处理(AFLink、GSI),Deep OC-SORT 是纯在线的方法,关联准确度 AssA 仍然比它高。
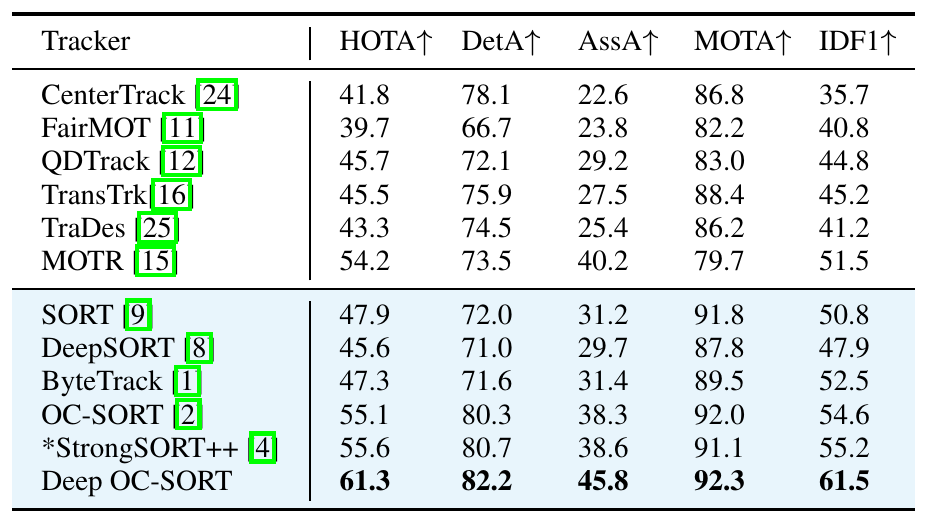
DanceTrack 上,使用同样 YOLOX 检测的方法里,Deep OC-SORT 的 HOTA 61.3,比 OC-SORT 高 6.2 分,AssA 从 38.3 升到 45.8。DeepSORT 比 SORT 差、Deep OC-SORT 比 OC-SORT 好,这两组对照放在同一张表上,正好说明了外观加法的差别。
作者宣称这是已发表方法中的最佳结果。不过三个月前上传 arXiv 的 MOTRv2,已经在 DanceTrack 上报告了高得多的成绩,只是当时还没正式发表,也不在这张表里。
局限
这是一篇 4 页的会议短文,分析的深度有限。
三个新模块都是手工设计的规则,外观权重 和上限 在不同数据集上要分开调,DanceTrack 的设置和 MOT17 差很多。论文也没有报告速度。多了一个 re-ID 模型,每个检测都要提取一次特征,比纯运动的 OC-SORT 慢是一定的。
结论
Deep OC-SORT 在 OC-SORT 上加回了外观,但加得很节制。检测置信度低的时候不更新外观,外观没有区分度的时候不放大外观的权重,镜头动了就把所有用到的旧框一起修正。
每个模块都很小,加起来却在三个数据集上都有稳定的提升。
DanceTrack 的论文告诉大家,舞者撞衫,外观没用。一年多后,同一位作者在 DanceTrack 上把外观权重调得比 MOT17 还高。