原始论文
Unifying Short and Long-Term Tracking with Graph Hierarchies
- 发表版本
- CVPR 2023会议
- arXiv 首次提交
- arXiv:2212.03038
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingsushi2022,
  title = {{Unifying Short and Long-Term Tracking with Graph Hierarchies}},
  author = {Orcun Cetintas and Guillem Brasó and Laura Leal-Taixé},
  year = {2022},
  eprint = {2212.03038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.03038}
}
跟踪一段长视频,其实是在解一整串时间尺度不同的问题。
相邻两帧之间,人几乎没动,看位置就配得起来。被挡住半秒再出现,要靠运动模型推一下。被挡了十几秒才重新走出来,位置早就对不上了,只能靠外观把他认回来。
当时表现最好的跟踪器,多半是把好几种方法接在一起,短期用卡尔曼滤波或 Tracktor,长期再挂一个 ReID 模块。图神经网络的方法也有同样的情况,MPNTrack 一次只处理 15 帧,公开检测也要先经过 Tracktor 处理。
慕尼黑工业大学的 Guillem Brasó 和 Laura Leal-Taixé 正是 MPNTrack 的作者,这次和 Orcun Cetintas 一起,想知道能不能用同一个模型,从相邻两帧一路处理到相隔五百帧。
定义问题
作者用四张示意图,比较了当时常见的跟踪器。
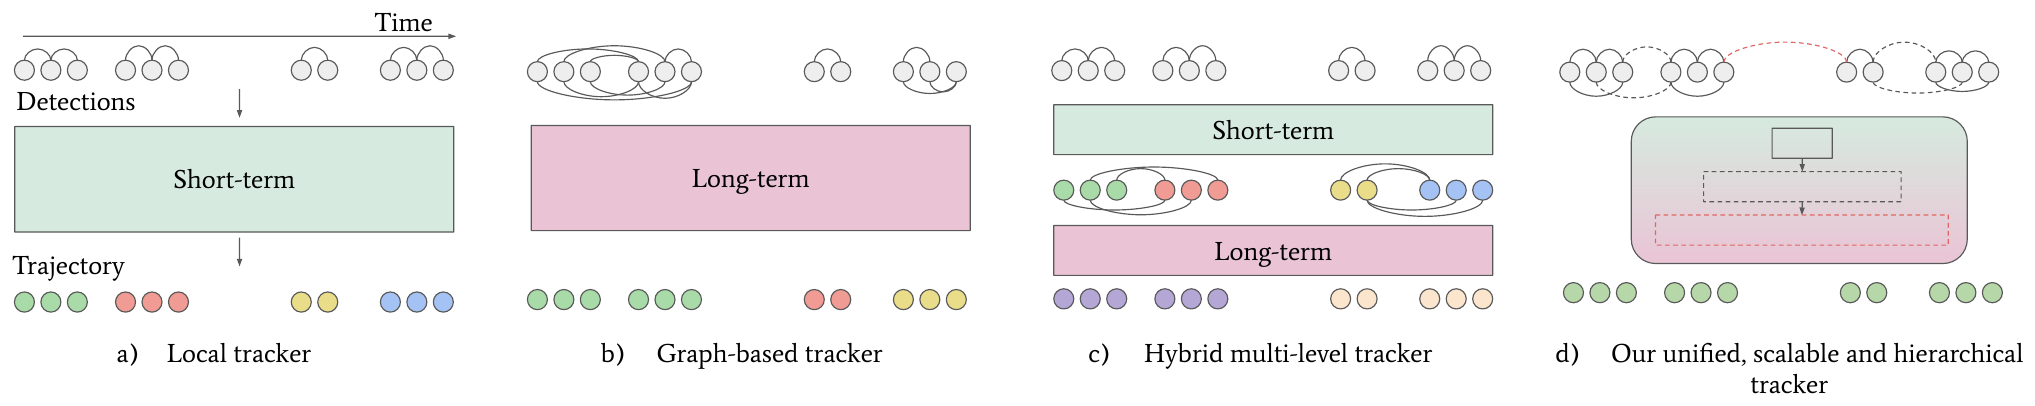
作者认为 (c) 这种混合做法有两个问题。
第一个是规模。 用图处理关联,边代表「两个检测属于同一人」的假设。要让相隔 帧的检测也能连起来,就得在所有帧之间连边,边的数量随检测数平方增长。
更麻烦的是标签。每个检测最多只有两条正确的边,一条连到过去,一条连到未来。 个检测,正确的边顶多 条,全部的边却可以多达 条。检测一多,正确边的比例趋近于零,网络几乎只看得到负样本。
第二个是通用性。 每个时间尺度用哪种线索,是工程师事先决定好的。可是不同数据集需要的线索不一样。DanceTrack 里大家穿得一模一样,帧率又高,看位置和运动比看外观可靠;BDD 是行车视角,镜头晃得厉害,反而只有外观靠得住。每换一种场景,就要重新调一次组合。
解决问题
一层一层往上叠
SUSHI 的做法,是把一段长片段递归地切成小时间窗口,每一层只在窗口内连边。
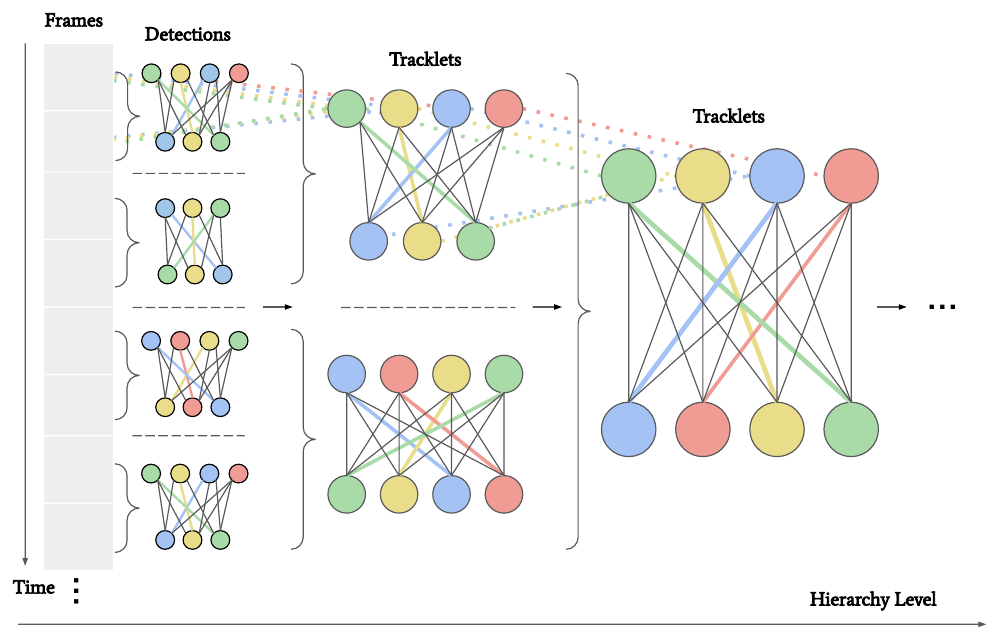
第一层,每个窗口只有两帧,把相邻两帧的检测连起来,得到长度为 2 的 tracklet。第二层的窗口有四帧,节点变成上一层的 tracklet,再把它们合并成更长的。第 层的窗口覆盖 帧,九层下来,一个窗口就是 512 帧。在 MOT17 上,大约是 17 到 36 秒。
每往上一层,节点就少一些,边却可以跨越更长的时间。
用一个例子数边
用一个理想化的例子,看看层级能省下多少边。
一段 512 帧的片段,每帧都有 20 个人,每个人都被检测到,每一层也都合并正确。先不做任何剪枝。
- 单一大图。 每两帧之间有 条边。512 帧里任取两帧,有 130,816 种组合,总共 52,326,400 条边。
- 九层层级。 每个窗口由两个子窗口组成,各有 20 条 tracklet,两边之间只有 400 条候选边。九层的窗口数是 ,总共 204,400 条边。
两种做法最后要选出的正确边一样多,都是 条:每个人 512 个检测,串成一条路径需要 511 条边。
| 做法 | 边数 | 正确边比例 |
|---|---|---|
| 单一大图 | 52,326,400 | 0.02% |
| 九层层级 | 204,400 | 5% |
本文整理的算例。
边少了 256 倍,正确边的比例则从万分之二拉到百分之五。前者决定放不放得进 GPU,后者决定网络学不学得起来。
实际的模型还会再剪一次边,每个节点只连最近的 10 个邻居。单一大图要靠很大的邻居数才不会剪掉正确边,在小图里 10 个就够了。
每一层都是同一块
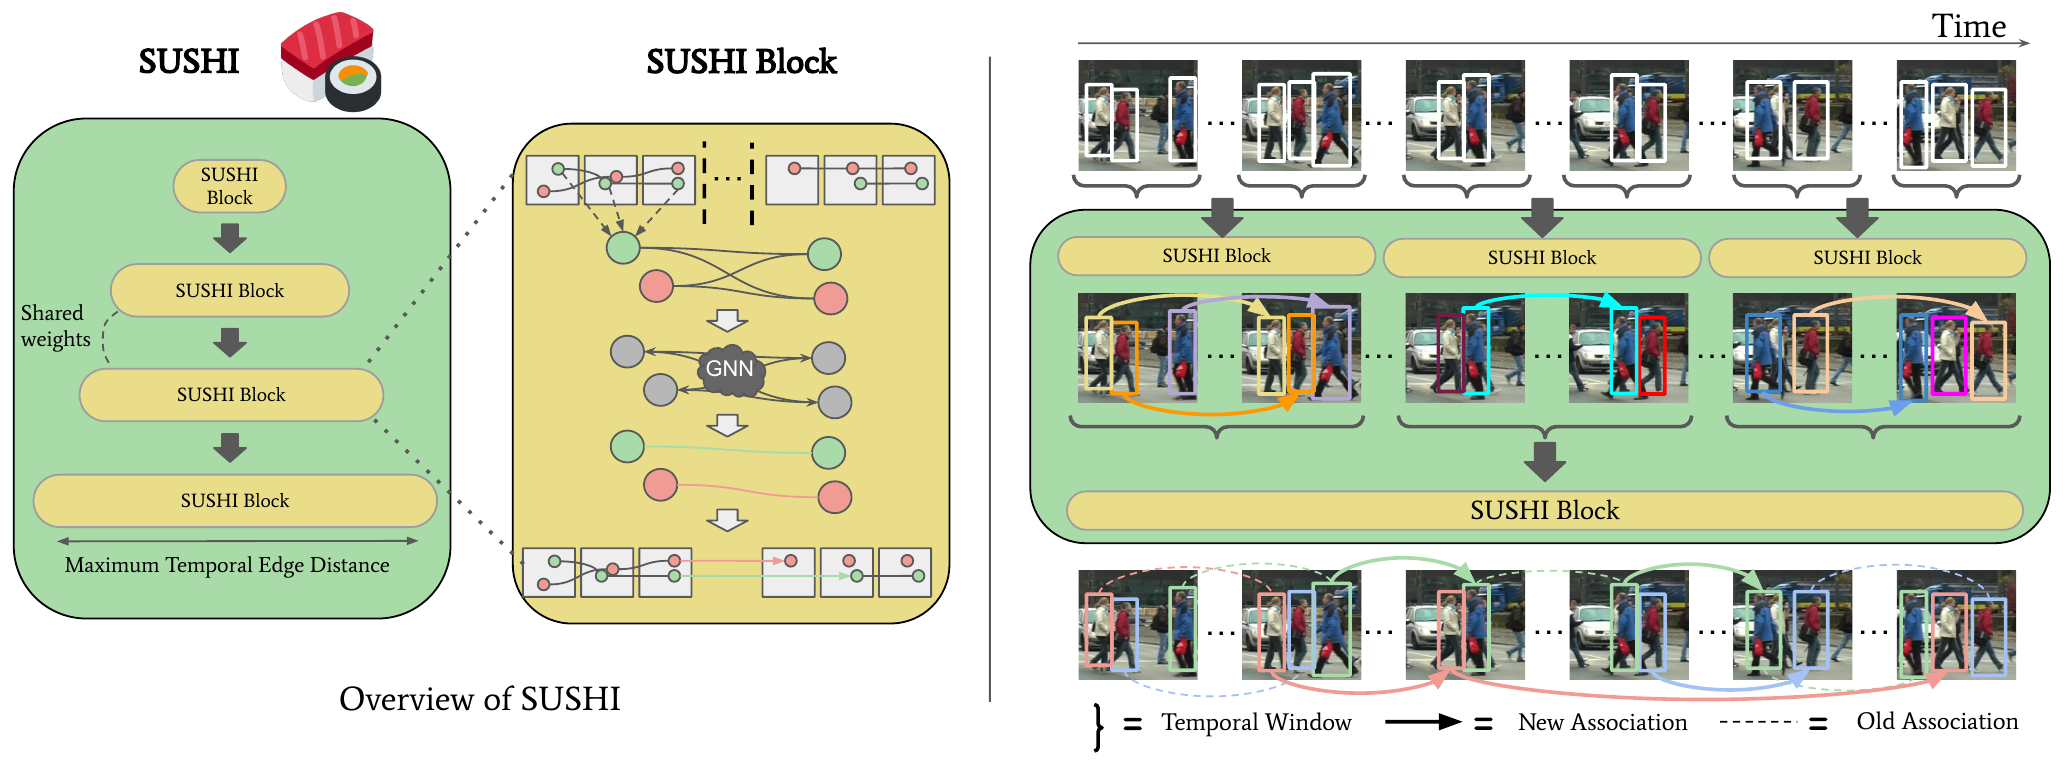
每一层叫做一个 SUSHI block,里面做的事和 MPNTrack 一样:
- 把上一层的 tracklet 当作节点,在窗口内不同时间的 tracklet 之间连边。
- 用 MPNTrack 的时间感知消息传递,让节点和边交换几轮信息。节点分别汇总来自过去和来自未来的边。
- 用一个小 MLP 判断每条边连的是不是同一个人。
- 用线性规划把分数取整,确保每个节点最多只有一条往前、一条往后的边,再把连起来的 tracklet 合并。
边的初始特征有四种。位置、大小和时间距离,取两条 tracklet 在时间上最接近的那两个检测来算。外观用 tracklet 里所有检测的 ReID 特征平均,比单一检测稳定。
第四种是运动,这是 MPNTrack 没有的。单一检测没有速度,tracklet 有。把前一条 tracklet 的最后位置往后推、后一条的第一个位置往前推,推到两者中间的时间点,再算两个推算框的 GIoU。从两端往中间推,每一边需要预测的时间都只有一半。
九层共享一组权重
这篇最关键的设计,是九个 SUSHI block 不只架构相同,连权重也共享。
不同层看到的数据差很多。第一层的两个节点只差一帧,第九层可能差了几百帧。为了让模型知道自己在哪一层,作者为每一层学一个 level embedding,加在边的初始嵌入上。
共享权重让九层的数据都拿来训练同一个网络,样本多了好几倍;收敛更快,参数也更少。整个模型除去 ReID 网络,只有大约 22K 个参数。
更重要的是,哪个时间尺度该看哪种线索,不再由人决定。同一个网络看到位置差很多、时间隔很远的边,自己学会了改看外观。
训练时,上层的输入是下层的输出。下层还没学好的时候,上层拿到的 tracklet 是错的。所以作者从第一层开始,每 500 次迭代解冻一层,九层都解冻后再一起训练。每一层各算一个 focal loss,再加总起来。
推理时,用 512 帧的滑动窗口,每次重叠 256 帧,重叠区里共享越多检测的轨迹就视为同一条,用二分图匹配接起来。给定检测的情况下,MOT17 上跑 21 fps。
讨论
一层换成同一个网络
消融在 MOT17 训练集上做三折交叉验证。作者比较了四个时间范围,以 IDF1 为主:
| 范围 | 混合做法 | IDF1 | SUSHI | IDF1 |
|---|---|---|---|---|
| 25 帧 | Tracktor | 65.6 | — | — |
| 75 帧 | MPNTrack++ | 73.2 | 2 层 | 73.5 |
| 150 帧 | MPNTrack++ | 73.4 | 3 层 | 74.8 |
| 512 帧 | MPNTrack++ | 73.7 | 9 层 | 77.6 |
整理自原论文 Table 1,MOT17 训练集三折交叉验证。
MPNTrack++ 是 MPNTrack 加上 SUSHI 的运动特征,短期仍交给 Tracktor。混合做法从 75 帧拉到 512 帧,IDF1 只多了 0.5;SUSHI 则一路从 73.5 升到 77.6。
混合做法的长期那一段始终是一张图。时间拉长,图就变大,前面说的标签不平衡也跟着变严重。
片段长度和层数
| 片段长度 | 1 层 | 3 层 | 5 层 | 7 层 | 9 层 |
|---|---|---|---|---|---|
| 8 帧 | 64.1 | 65.9 | — | — | — |
| 32 帧 | 64.2 | 70.0 | 71.3 | — | — |
| 128 帧 | 61.9 | 75.1 | 75.6 | 75.8 | — |
| 512 帧 | — | 76.2 | 76.8 | 77.1 | 77.6 |
整理自原论文 Figure 4(b),MOT17 训练集,IDF1。
只用一层的时候,片段超过 32 帧反而变差:128 帧时掉到 61.9。图太大、负样本太多,网络学不动。只要加层,片段越长越好。九层、512 帧的 77.6,比单层最好的 64.2 高了 13.4。
每一层在看什么
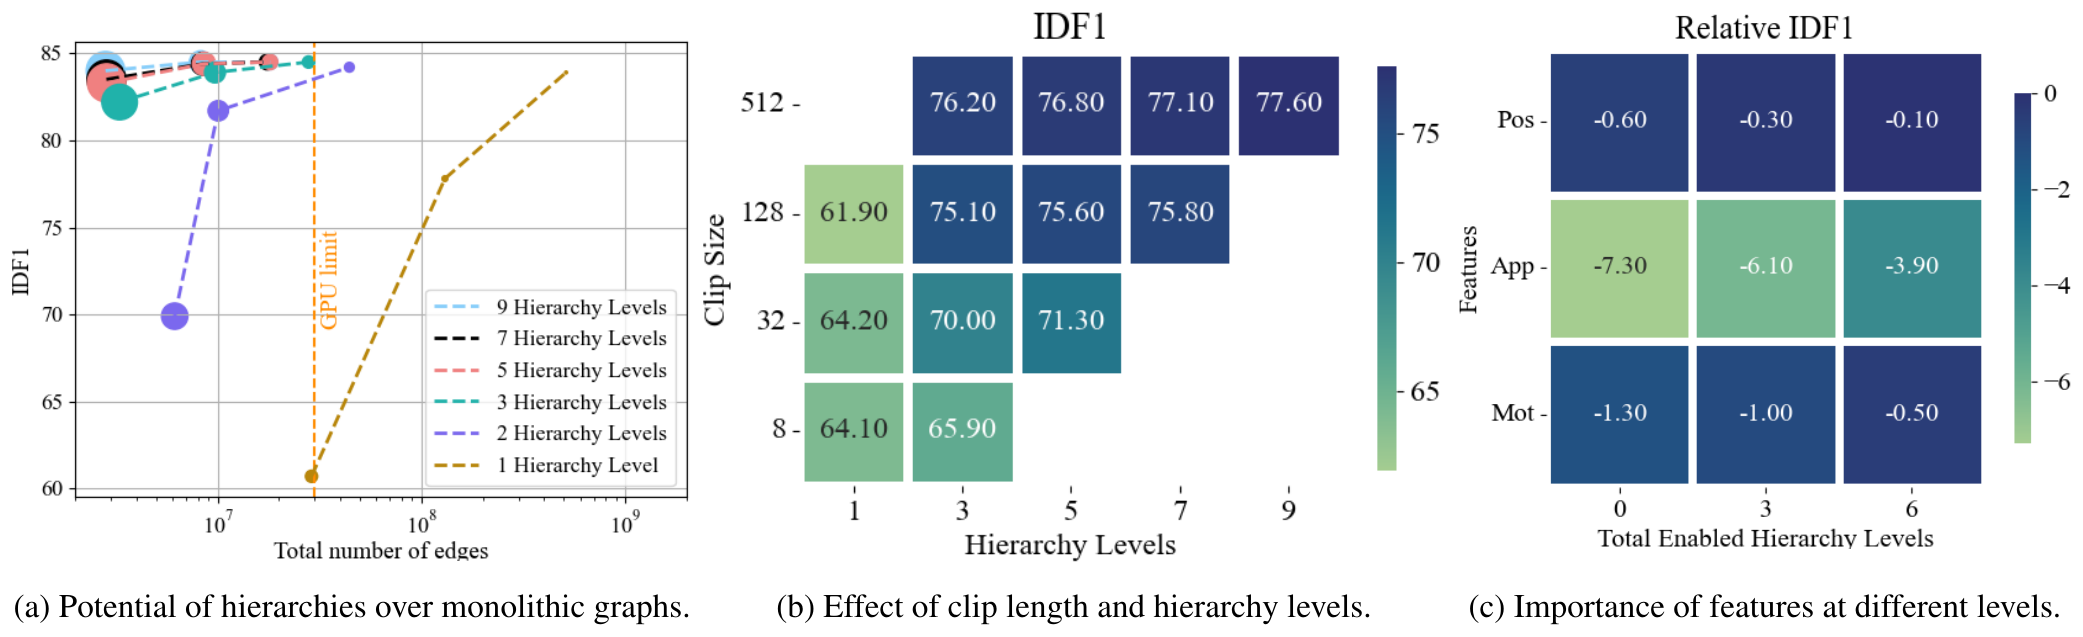
(c) 检查的是,同一个网络在不同层,会不会倚重不同的线索。
- 外观最重要,而且主要用在高层。 全部关掉,IDF1 少 7.3。只在第 7 到 9 层关掉,就少 3.9;只在第 1 到 3 层保留,比全部关掉只补回 1.2。
- 运动在各层的影响差不多。 全部关掉少 1.3,影响温和。
- 位置只对低层有用。 全部关掉也只少 0.6,而且在前三层保留就补回一半。
相邻帧看位置,隔得远了看长相,这和直觉一致。区别在于,这是网络自己从数据中学到的,没有人替它写规则。
四个数据集
| 数据集 | 对手 | IDF1 | HOTA | SUSHI IDF1 | HOTA |
|---|---|---|---|---|---|
| MOT17 公开 | MPNTrack | 61.7 | 49.0 | 71.5 | 54.6 |
| MOT17 私有 | ByteTrack | 77.3 | 63.1 | 83.1 | 66.5 |
| MOT20 私有 | ByteTrack | 75.2 | 61.3 | 79.8 | 64.3 |
| DanceTrack | ByteTrack | 53.9 | 47.7 | 63.4 | 63.3 |
整理自原论文 Table 2–4,测试集。
MOT17 公开检测的设置下,SUSHI 用的就是 MPNTrack 的网络,IDF1 却高了 9.8,差别只在层级。用 ByteTrack 的 YOLOX 检测时,IDF1 高 5.8,ID 切换从 2,196 降到 1,149,少了将近一半。
DanceTrack 的进步最多,HOTA 从 ByteTrack 的 47.7 跳到 63.3,也高于原论文表中 HOTA 最高的 MOTR 和 QDTrack(都是 54.2)。ByteTrack 在 MOT17、MOT20 上都很强,到了 DanceTrack 就落后了;SUSHI 在三个数据集上都领先。在行车视角的 BDD 上,SUSHI 直接把同一套 GNN 套到八个类别,测试集的 mIDF1 从 55.8 提升到 60.0。
MOTA 的情况不同。MOT20 上,SUSHI 的 MOTA 是 74.3,低于 ByteTrack 的 77.8。SUSHI 改进的是关联,检测的漏检和误报它管不到。
局限
SUSHI 是离线方法,要拿到一整段 512 帧的片段才能开始处理,没办法用在需要实时输出的系统上。21 fps 也是在检测已经算好之后的速度。
ReID 网络是现成的,没有针对跟踪数据微调,SUSHI 的改进全部来自关联这一侧。在公开检测的设置下,它也和其他图方法一样,先用 Tracktor 精修检测框,这一步本身就是一个短期跟踪器。
结论
SUSHI 没有发明新的图网络,每一层都是 MPNTrack。它把一张又大又稀疏的图,换成九张小图叠起来。边少了两个数量级,正确边的比例也从万分之二拉回百分之五,网络终于学得动了。
共享权重则把「哪个时间尺度看哪种线索」交还给数据。同一个网络在低层看位置,在高层看外观,没有人替它规定。
九层、512 帧,在 MOT17 上大约是半分钟。比这更久的遮挡,就要看滑动窗口之间的拼接接不接得上了。