原始论文
DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion
- 发表版本
- CVPR 2022会议
- arXiv 首次提交
- arXiv:2111.14690
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingdancetrack2021,
  title = {{DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion}},
  author = {Peize Sun and Jinkun Cao and Yi Jiang and Zehuan Yuan and Song Bai and Kris Kitani and Ping Luo},
  year = {2021},
  eprint = {2111.14690},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2111.14690}
}
到了 2021 年,多目标跟踪的主流做法大致固定了:先检测,再用 re-ID 特征把每一帧的框接起来。JDE、FairMOT 在检测网络上加嵌入分支,QDTrack 用准密集的对比学习把外观特征练得更强,TrackFormer、MOTR 这些 Transformer 方法,靠的也是查询里带着的外观信息。
香港大学、卡内基梅隆大学和字节跳动的研究者,包括 Peize Sun、Jinkun Cao、Kris Kitani、Ping Luo 等人,对这个趋势提出了疑问。外观特征之所以这么好用,会不会只是因为数据集太配合?
MOT17 里的行人穿着各不相同,走路的方向和速度也很规律,几乎是直线运动。在这样的数据上,靠长相认人,或用线性的运动模型预测位置,都很容易成功。但换一个场景,比如一群穿着相同制服的舞者,在舞台上快速走位、互相交错,这些方法还撑得住吗?
有意思的是,作者里的 Peize Sun、Yi Jiang、Zehuan Yuan、Ping Luo,一个多月前才和其他人一起发表了 ByteTrack,一个只靠运动和 IoU 就在 MOT17 上拿到极高分的跟踪器。
定义问题
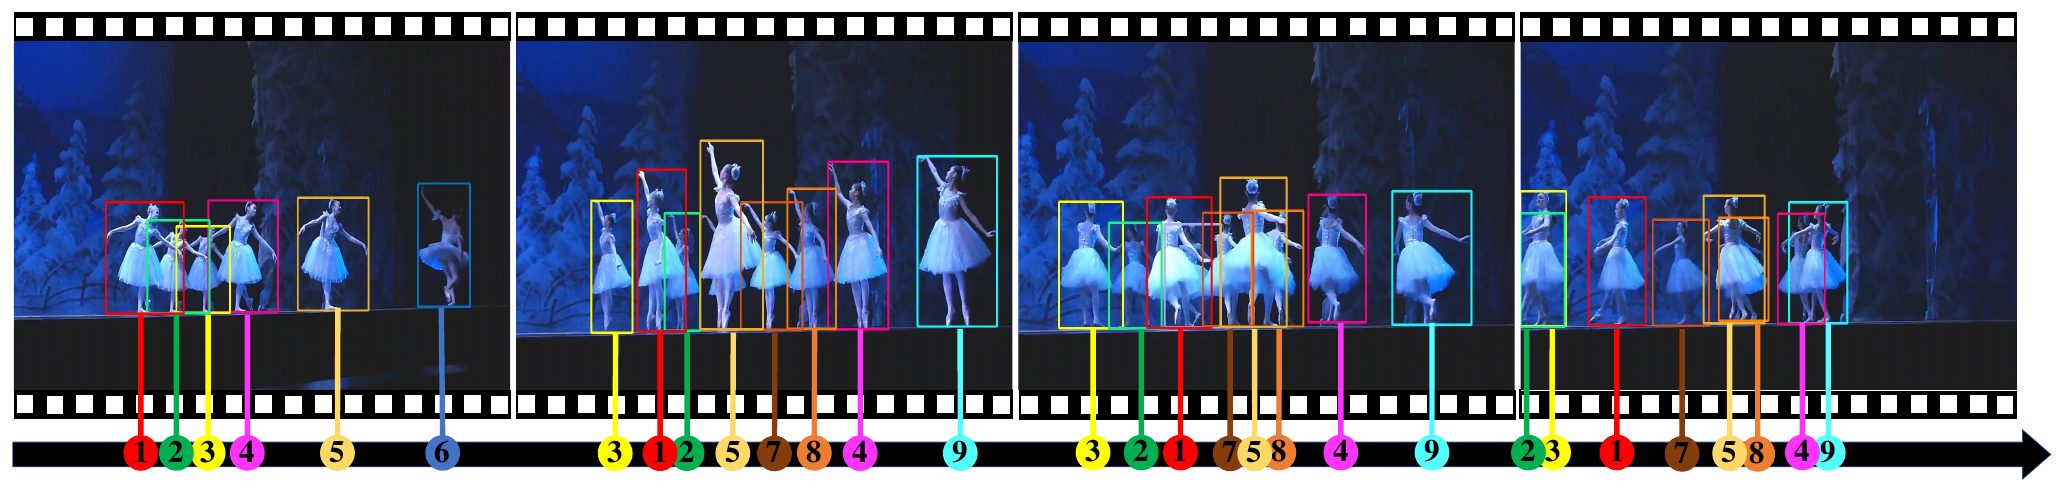
作者认为,现有数据集的偏差有两个:
- 外观太好分。 大多数物体长得各不相同,re-ID 模型很容易就能区分。
- 运动太规律。 行人和车辆的移动大多接近匀速直线,简单的线性运动模型就够用。
在这种数据上发展出来的跟踪器,自然越来越依赖外观比对,其他线索很少被认真考虑。
这里要注意一点。增加拥挤程度,并不能解决这个问题。MOT20 的人群非常密集,但行人移动很规律,彼此的相对位置和遮挡区域几乎不变,这样的「拥挤」对外观比对根本构不成障碍。作者要的是另一种困难:物体在较大范围内移动,遮挡的区域一直在变,彼此还会交错换位。
解决问题
收集与标注
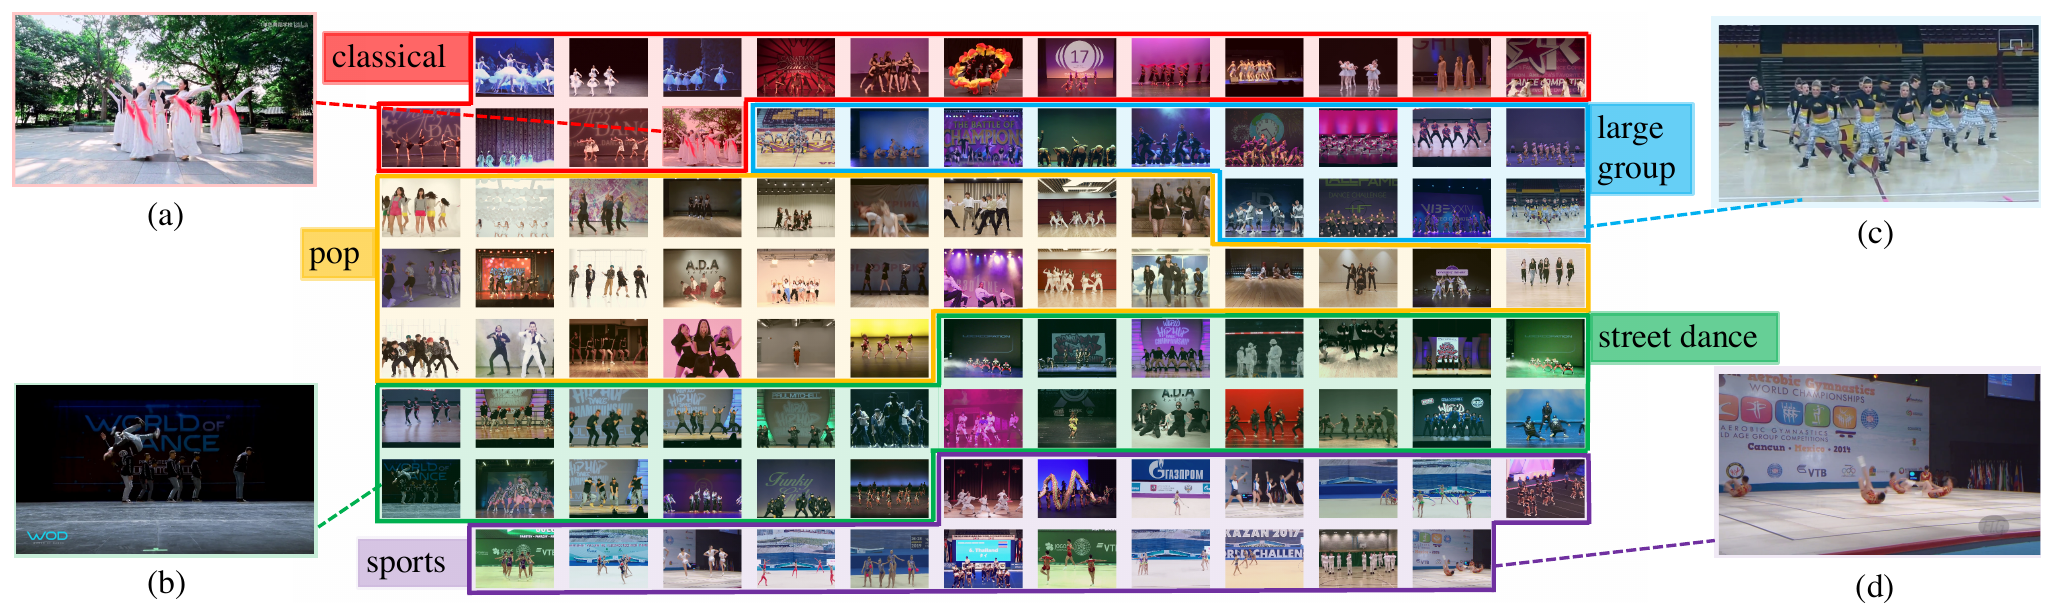
团体舞刚好同时具备这两种困难。舞者常常穿着相似甚至完全相同的服装,又会大范围走位、做出各种姿势、频繁交错。
作者用「街舞」「嘻哈舞」「啦啦队」「艺术体操」等关键词,从网上收集公开的视频,总共 100 段。类型包括街舞、流行舞、芭蕾和探戈等古典舞、大型团体舞,还有体操、中国功夫、啦啦队等体育场景。大部分是室内,也有户外、光线昏暗和镜头很远的例子,人最多的一段有 40 人。
标注只有框和身份,规则是:
- 部分被遮挡的人,标出完整的全身框。
- 完全被遮挡的人不标;之后重新出现时,沿用原本的身份。
标注工具会把上一帧的框自动带到下一帧,标注员只需要修正。标完之后,再由另一组人检查,有错就退回重标。
100 段视频分成训练 40 段、验证 25 段、测试 35 段,切分时让平均长度、平均框数、场景和动作多样性在三者之间大致相同。测试集的标注不公开,留给竞赛使用。
| MOT17 | MOT20 | DanceTrack | |
|---|---|---|---|
| 视频数 | 14 | 8 | 100 |
| 每段平均轨迹数 | 96 | 432 | 9 |
| 总轨迹数 | 1,342 | 3,456 | 990 |
| 平均长度(秒) | 35.4 | 66.8 | 52.9 |
| 总长度(秒) | 463 | 535 | 5,292 |
| 总图像数 | 11,235 | 13,410 | 105,855 |
整理自原论文 Table 1。
视频数和图像数都是 MOT 数据集的十倍左右。但每段平均只有 9 条轨迹,比 MOT17 少得多。DanceTrack 的难处不在人多,而在每个人都长得很像、又动得很乱。
用数字说明有多难
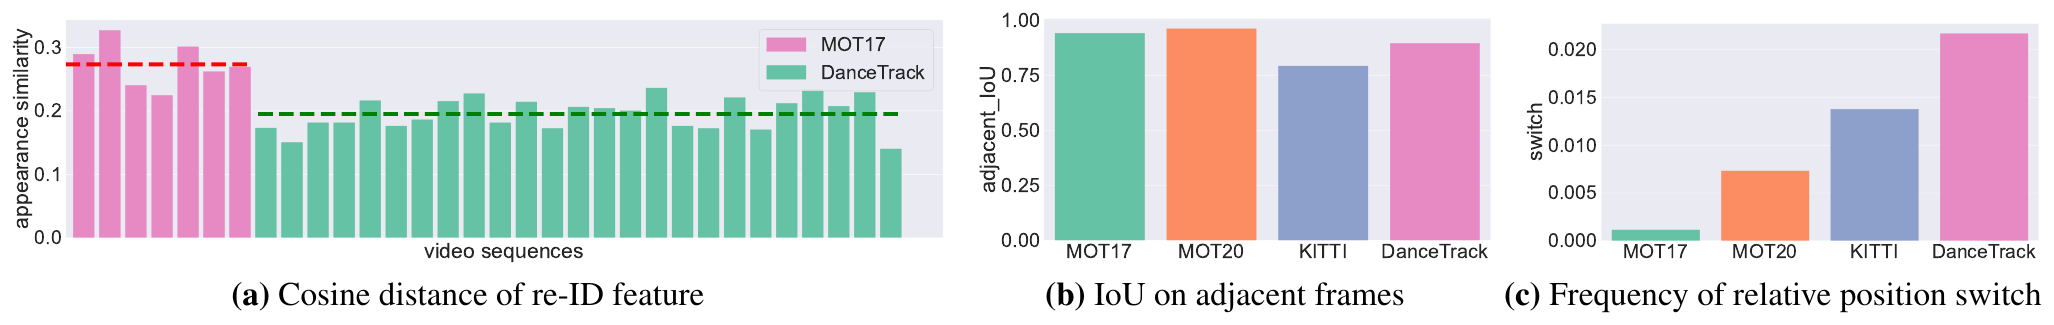
作者用三个统计量,把这两种困难量化。
外观相似度。 用预训练的 re-ID 模型提取每个人的特征,计算同一帧里所有人两两之间的余弦距离,再对整段视频求平均。DanceTrack 的平均距离明显比 MOT17 小,也就是不同人的外观更接近。
相邻帧的 IoU。 同一个人在相邻两帧的框 IoU,再对所有人、所有帧求平均。IoU 低说明移动快或帧率低。DanceTrack 和 MOT 数据集差不多,表示这个数据集的困难并不是来自不合理的高速移动。
相对位置交换的频率。 两个框有重叠的人,在相邻两帧之间,左右或上下的相对位置交换了,就记一次。匀速移动的物体很少换位,非线性的运动才会频繁交错。DanceTrack 在这一项远高于 MOT17 和 MOT20,甚至比镜头一直在动的驾驶数据集 KITTI 还高。
后两项合起来看,DanceTrack 的人每一帧移动得并不多,但轨迹却一直在交错。这正是线性运动模型最容易出错的情况。
评估指标
DanceTrack 以 HOTA 作为主要指标。关联能力看 AssA 和 IDF1,检测质量看 DetA 和 MOTA。作者的理由是,MOTA 太偏重检测,HOTA 才能把检测和关联分开来看。
讨论
给了真实框,还跟得好吗
| 关联方式 | MOT17 HOTA | DanceTrack HOTA | DanceTrack AssA | DanceTrack IDF1 |
|---|---|---|---|---|
| IoU | 98.1 | 72.8 | 53.6 | 63.5 |
| IoU + 运动 | 96.4 | 69.4 | 54.8 | 71.3 |
| 外观 + IoU + 运动 | 95.0 | 59.7 | 43.2 | 60.5 |
| 外观 | 93.3 | 68.0 | 47.4 | 58.7 |
整理自原论文 Table 2,两个数据集的验证集;检测框直接使用真实框。
作者先做了一个 oracle 实验,检测框直接给真实框,只比较关联方法。
在 MOT17 上,只用 IoU 匹配,HOTA 就有 98.1,几乎完美。也就是说,只要检测够准,MOT17 的关联几乎不是问题。
在 DanceTrack 上,同样是真实框,IoU 匹配的 HOTA 只剩 72.8,AssA 53.6。检测已经完美,瓶颈完全落在关联上。
最后两行加入了外观特征,所有指标都变差了;「外观 + IoU + 运动」的 HOTA 甚至比只用 IoU 低了 13 分。在每个人都长得一样的场景里,外观不但帮不上忙,还会把关联带偏。
现有跟踪器的表现
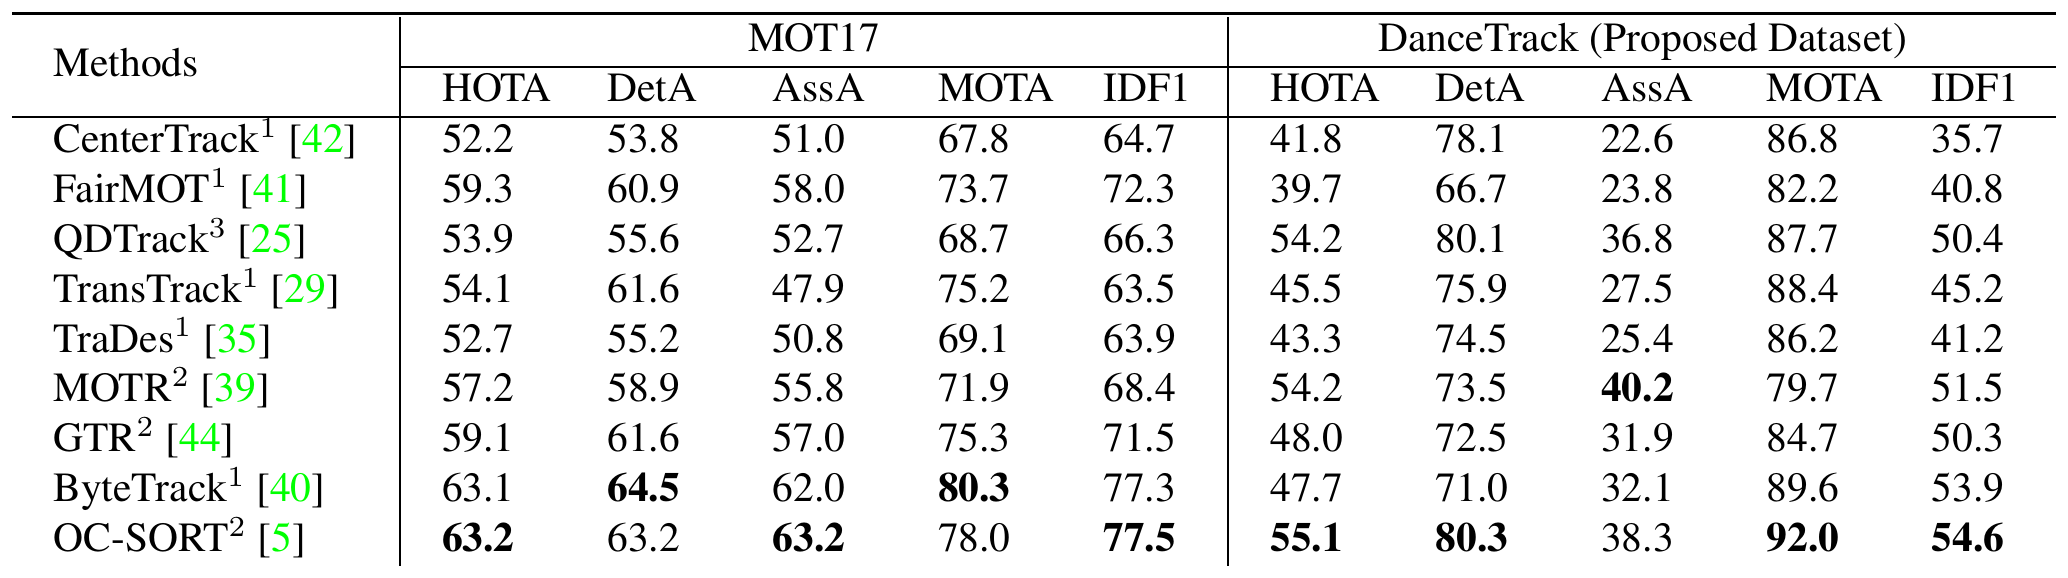
作者把当时的主流跟踪器都在 DanceTrack 上重新训练、测试。
所有方法在 DanceTrack 上的 HOTA、AssA、IDF1 都大幅下降。ByteTrack 在 MOT17 是 63.1,到了 DanceTrack 只剩 47.7;FairMOT 从 59.3 掉到 39.7。
但检测指标反而变好了。所有方法在 DanceTrack 上的 MOTA 和 DetA 都比在 MOT17 上高,MOTA 普遍在 80 到 90 之间。舞台上的人好检测,只是认不出谁是谁。
这张表在论文的几个版本之间更新过。第三版把 QDTrack 的检测器换成 YOLOX,用 ByteTrack 的数据增强和阈值重新训练,外观学习的部分则完全没变,结果 HOTA 54.2,比 ByteTrack 还高。MOTR 的 AssA 40.2 是全表最高,DetA 73.5 却比多数方法低,关联强、检测弱,这个组合后来成了 MOTRv2 的出发点。
关联方法与运动模型
为了单独比较关联,作者固定用 YOLOX 检测,只换关联方法:
| 关联方法 | HOTA | DetA | AssA | MOTA | IDF1 |
|---|---|---|---|---|---|
| IoU | 44.7 | 79.6 | 25.3 | 87.3 | 36.8 |
| SORT | 47.8 | 74.0 | 31.0 | 88.2 | 48.3 |
| DeepSORT | 45.8 | 70.9 | 29.7 | 87.1 | 46.8 |
| MOTDT | 39.2 | 68.8 | 22.5 | 84.3 | 39.6 |
| BYTE | 47.1 | 70.5 | 31.5 | 88.2 | 51.9 |
| OC-SORT | 52.1 | 79.8 | 35.3 | 87.3 | 51.6 |
整理自原论文 Table 4,DanceTrack 验证集,检测器为 YOLOX。
从这张表可以看到三件事。
- DeepSORT 比 SORT 差。 DeepSORT 就是 SORT 加上外观比对,结果 HOTA 从 47.8 降到 45.8。外观在这里是负贡献。
- MOTDT 最差。 MOTDT 用跟踪结果帮忙补检测,但 DanceTrack 的检测本来就很好,这个设计反而让检测和关联都变差了。
- OC-SORT 最好。 它是纯运动的方法,专门针对非线性运动改进卡尔曼滤波,HOTA 52.1,AssA 35.3 也是最高。
另一张表比较运动模型。完全不用运动、只用 IoU 时 HOTA 44.7;加上卡尔曼滤波 47.8;换成 LSTM 学出来的运动模型 51.6。在外观不可靠的时候,运动模型的潜力很大。
加入更多信息
既然检测不是问题,作者试着给模型更多框以外的信息。DanceTrack 只有框的标注,所以他们用 CenterNet 加 BYTE 关联,搭配其他数据集一起训练:
- 分割掩码: 加入 COCO 的掩码一起训练,HOTA 从 36.9 升到 38.1;关联时再用上掩码,到 39.2。
- 人体姿态: 加入 COCO 的姿态一起训练,HOTA 升到 40.6;关联时用上姿态,到 41.0。提升比掩码更多。被遮住大半的时候,框不可靠,关键点反而比较稳。
- 深度: 加入 KITTI 的深度一起训练,HOTA 反而掉到 34.4。KITTI 主要是车,和舞台差太多。不过以混合训练的模型为基线,关联时用上深度,IDF1 还是多了 1.7。
作者的结论是,比框更精细的表示(掩码、姿态)有帮助,深度信息也有潜力,运动建模很重要。
局限
作者自己点出两个局限。这篇只提出数据集,没有提出能大幅领先的新算法,把问题留给后续研究。另外,数据集只有框的标注,没有姿态或掩码,想做更精细的研究,得借用其他数据集。
后来
DanceTrack 很快就成了检验关联能力的标准基准。
几个月后,同为作者的 Jinkun Cao 和 Kris Kitani 发表了 OC-SORT,专门处理非线性运动和遮挡。再往后的 MOTRv2、Deep OC-SORT,也都把 DanceTrack 当成主要的比较舞台。
结论
DanceTrack 没有提出新的跟踪器,而是找了一个让现有方法都很难受的场景:大家穿一样的衣服,跳来跳去。
在这个场景里,检测几乎不是问题,关联才是。外观特征常常帮倒忙,线性运动模型也跟不上舞步。
以往谈到跟踪的难度,最常想到的是「拥挤」。DanceTrack 的每段视频平均只有 9 个人,却比 MOT20 那几百人的人潮更难跟。