原始論文
Unifying Short and Long-Term Tracking with Graph Hierarchies
- 發表版本
- CVPR 2023會議
- arXiv 首次提交
- arXiv:2212.03038
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingsushi2022,
  title = {{Unifying Short and Long-Term Tracking with Graph Hierarchies}},
  author = {Orcun Cetintas and Guillem Brasó and Laura Leal-Taixé},
  year = {2022},
  eprint = {2212.03038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.03038}
}
追蹤一段長影片,其實是在解一整串時間尺度不同的問題。
相鄰兩幀之間,人幾乎沒動,看位置就配得起來。被擋住半秒再出現,要靠運動模型推一下。被擋了十幾秒才重新走出來,位置早就對不上,只能靠外觀把他認回來。
當時表現最好的追蹤器,多半是把好幾種方法接在一起,短期用卡爾曼濾波或 Tracktor,長期再掛一個 ReID 模組。圖神經網路的方法也有同樣的情況,MPNTrack 一次只處理 15 幀,公用偵測也要先經過 Tracktor 處理。
慕尼黑工業大學的 Guillem Brasó 和 Laura Leal-Taixé 正是 MPNTrack 的作者,這次和 Orcun Cetintas 一起,想知道能不能用同一個模型,從相鄰兩幀一路處理到相隔五百幀。
定義問題
作者用四張示意圖,比較了當時常見的追蹤器。
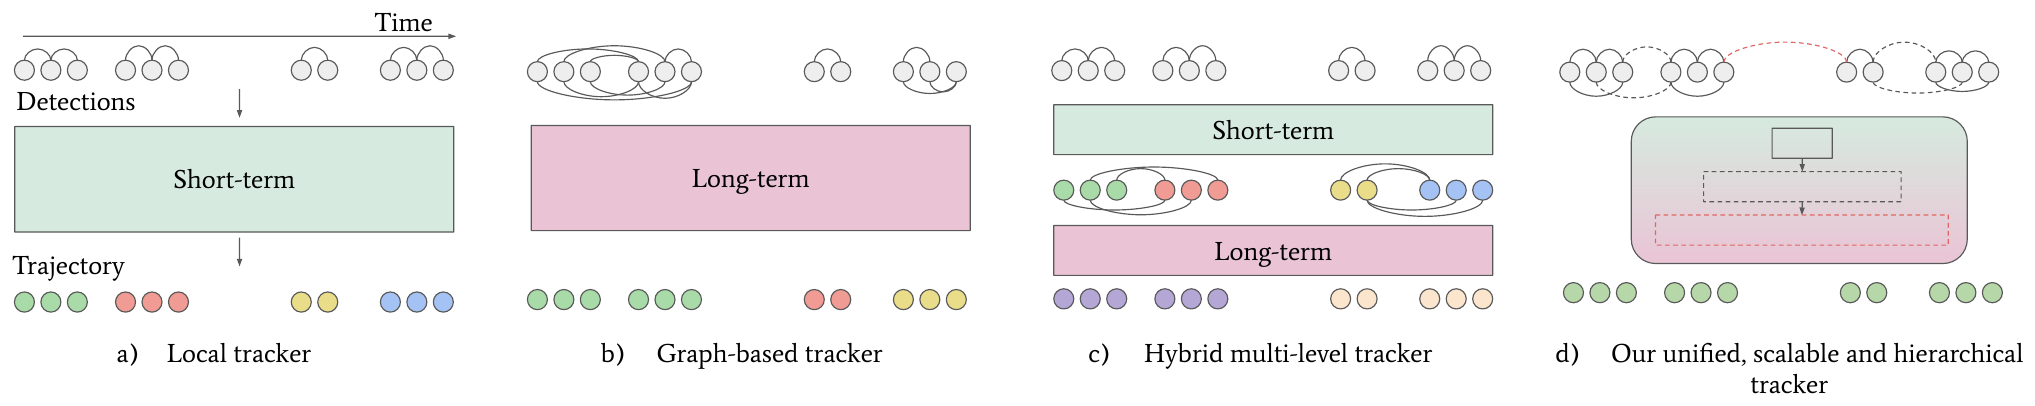
作者認為 (c) 這種混合做法有兩個問題。
第一個是規模。 用圖處理關聯,邊是「兩個偵測屬於同一人」的假設。要讓相隔 幀的偵測也能連起來,就得在所有幀之間連邊,邊的數量隨偵測數平方增長。
更麻煩的是標籤。每個偵測最多只有兩條正確的邊,一條連到過去,一條連到未來。 個偵測,正確的邊頂多 條,全部的邊卻可以到 條。偵測一多,正確邊的比例趨近於零,網路幾乎只看得到負樣本。
第二個是通用性。 每個時間尺度用哪種線索,是工程師先決定好的。可是不同資料集需要的線索不一樣。DanceTrack 裡大家穿得一模一樣、幀率又高,看位置和運動比看外觀可靠;BDD 是行車視角,鏡頭晃得厲害,反而只有外觀靠得住。每換一種場景,就要重新調一次組合。
解決問題
一層一層往上疊
SUSHI 的做法,是把一段長片段遞迴地切成小時間窗,每一層只在窗內連邊。
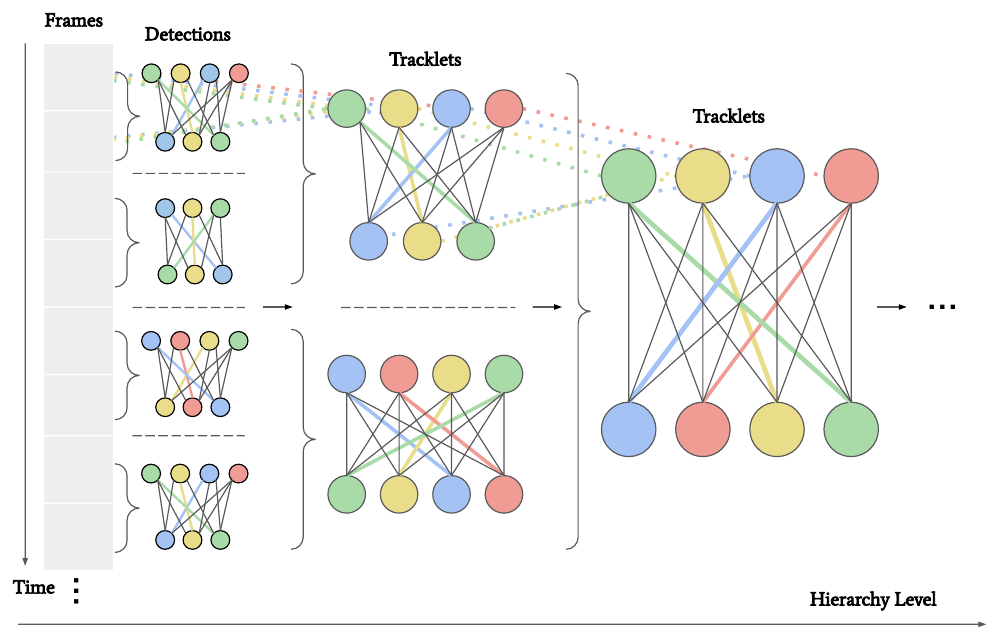
第一層,每個窗只有兩幀,把相鄰兩幀的偵測連起來,得到長度 2 的 tracklet。第二層的窗有四幀,節點變成上一層的 tracklet,再把它們合併成更長的。第 層的窗涵蓋 幀,九層下來,一個窗就是 512 幀。在 MOT17 上,大約是 17 到 36 秒。
每往上一層,節點就少一些,邊卻可以跨越更長的時間。
用一個例子數邊
用一個理想化的例子,看看階層省下多少邊。
一段 512 幀的片段,每幀都有 20 個人,每個人都被偵測到,每一層也都合併正確。先不做任何剪枝。
- 單一大圖。 每兩幀之間有 條邊。512 幀裡任取兩幀,有 130,816 種組合,總共 52,326,400 條邊。
- 九層階層。 每個窗由兩個子窗組成,各有 20 條 tracklet,兩邊之間只有 400 條候選邊。九層的窗數是 ,總共 204,400 條邊。
兩種做法最後要選出的正確邊一樣多,都是 條:每個人 512 個偵測,串成一條路徑需要 511 條邊。
| 做法 | 邊數 | 正確邊比例 |
|---|---|---|
| 單一大圖 | 52,326,400 | 0.02% |
| 九層階層 | 204,400 | 5% |
本文整理的算例。
邊少了 256 倍,正確邊的比例則從萬分之二拉到百分之五。前者決定放不放得進 GPU,後者決定網路學不學得起來。
實際的模型還會再剪一次邊,每個節點只連最近的 10 個鄰居。單一大圖要靠很大的鄰居數才不會剪掉正確邊,在小圖裡 10 個就夠了。
每一層都是同一塊
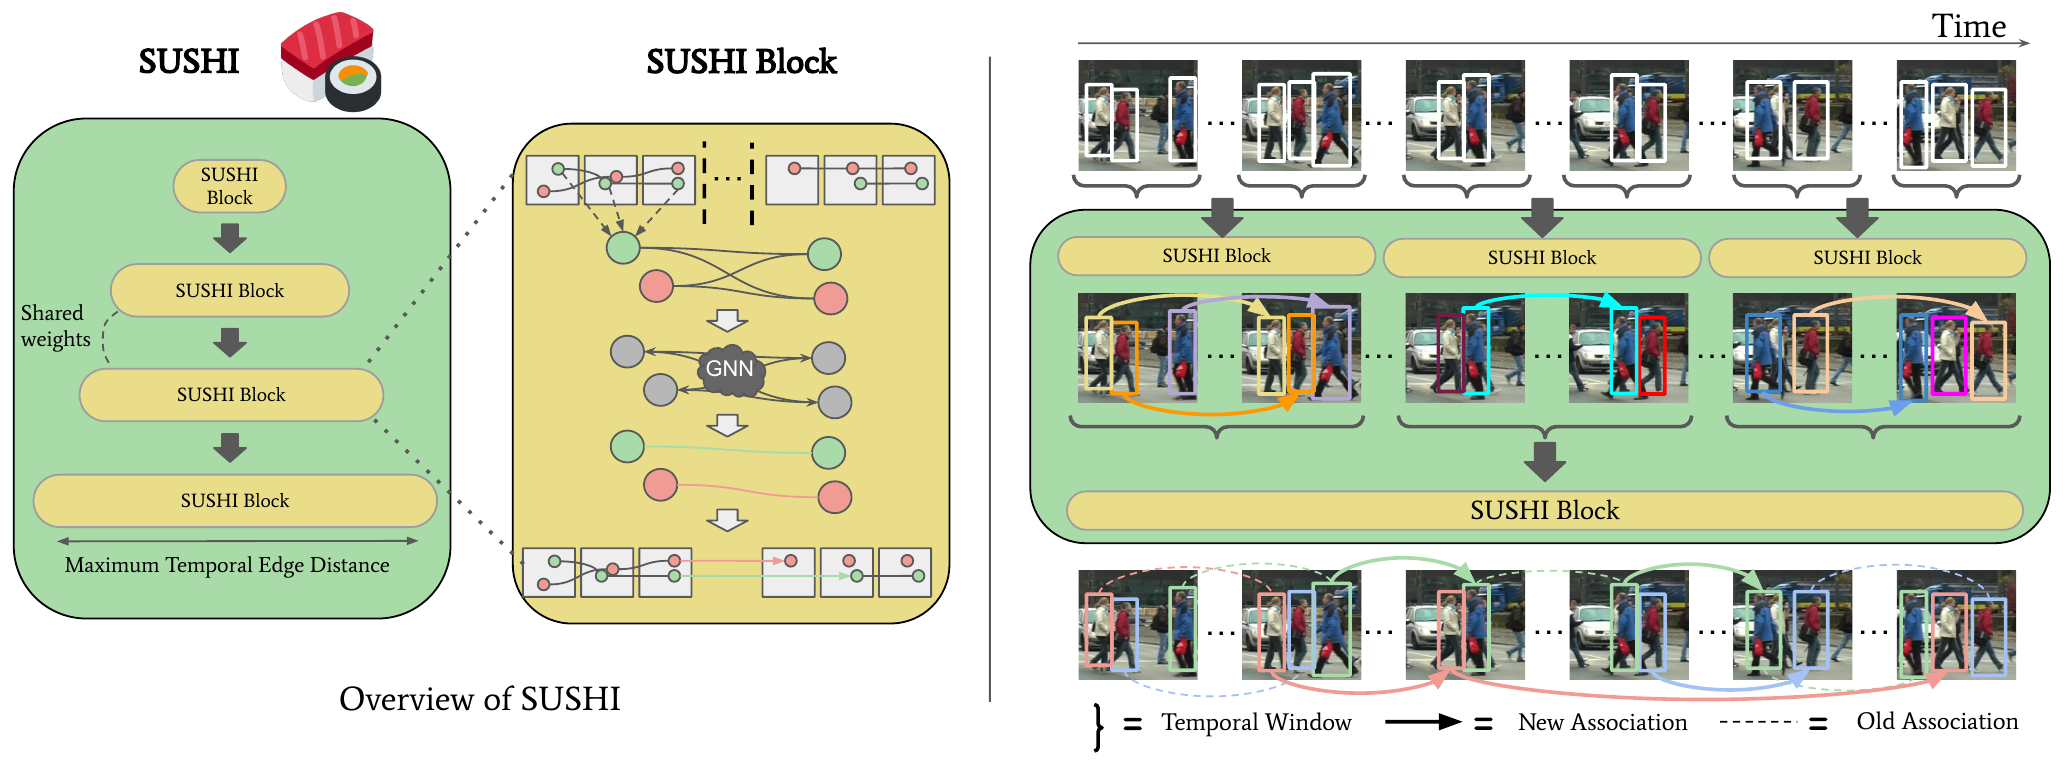
每一層叫做一個 SUSHI block,裡面做的事和 MPNTrack 一樣:
- 把上一層的 tracklet 當作節點,窗內不同時間的 tracklet 之間連邊。
- 用 MPNTrack 的時間感知訊息傳遞,讓節點和邊交換資訊幾輪。節點分別彙整來自過去和來自未來的邊。
- 用一個小 MLP 判斷每條邊是不是同一個人。
- 用線性規劃把分數取整,確保每個節點最多只有一條往前、一條往後的邊,再把連起來的 tracklet 合併。
邊的初始特徵有四種。位置、大小和時間距離,取兩條 tracklet 在時間上最接近的那兩個偵測來算。外觀用 tracklet 裡所有偵測的 ReID 特徵平均,比單一偵測穩定。
第四種是運動,這是 MPNTrack 沒有的。單一偵測沒有速度,tracklet 有。把前一條 tracklet 的最後位置往後推、後一條的第一個位置往前推,推到兩者中間的時間點,再算兩個推估框的 GIoU。從兩端往中間推,每一邊需要預測的時間都只有一半。
九層共用一組權重
這篇最關鍵的設計,是九個 SUSHI block 不只架構相同,連權重也共用。
不同層看到的資料差很多。第一層的兩個節點只差一幀,第九層可能差了幾百幀。為了讓模型知道自己在哪一層,作者為每一層學一個 level embedding,加在邊的初始嵌入上。
共用權重讓九層的資料都拿來訓練同一個網路,樣本多了好幾倍;收斂更快,參數也更少。整個模型扣掉 ReID 網路,只有大約 22K 個參數。
更重要的是,哪個時間尺度該看哪種線索,不再由人決定。同一個網路看到位置差很多、時間差很遠的邊,自己學會改看外觀。
訓練時,上層的輸入是下層的輸出。下層還沒學好的時候,上層拿到的 tracklet 是錯的。所以作者從第一層開始,每 500 次迭代解凍一層,九層都解凍後再一起訓練。每一層各算一個 focal loss,加總起來。
推論時,用 512 幀的滑動窗、每次重疊 256 幀,重疊區裡共用越多偵測的軌跡就視為同一條,用二部匹配接起來。給定偵測的情況下,MOT17 上跑 21 fps。
討論
一層換成同一個網路
消融在 MOT17 訓練集上做三折交叉驗證。作者比較了四個時間範圍,以 IDF1 為主:
| 範圍 | 混合做法 | IDF1 | SUSHI | IDF1 |
|---|---|---|---|---|
| 25 幀 | Tracktor | 65.6 | — | — |
| 75 幀 | MPNTrack++ | 73.2 | 2 層 | 73.5 |
| 150 幀 | MPNTrack++ | 73.4 | 3 層 | 74.8 |
| 512 幀 | MPNTrack++ | 73.7 | 9 層 | 77.6 |
整理自原論文 Table 1,MOT17 訓練集三折交叉驗證。
MPNTrack++ 是 MPNTrack 加上 SUSHI 的運動特徵,短期仍交給 Tracktor。混合做法從 75 幀拉到 512 幀,IDF1 只多了 0.5;SUSHI 則一路從 73.5 升到 77.6。
混合做法的長期那一段始終是一張圖。時間拉長,圖就變大,前面說的標籤不平衡也跟著變嚴重。
片段長度和層數
| 片段長度 | 1 層 | 3 層 | 5 層 | 7 層 | 9 層 |
|---|---|---|---|---|---|
| 8 幀 | 64.1 | 65.9 | — | — | — |
| 32 幀 | 64.2 | 70.0 | 71.3 | — | — |
| 128 幀 | 61.9 | 75.1 | 75.6 | 75.8 | — |
| 512 幀 | — | 76.2 | 76.8 | 77.1 | 77.6 |
整理自原論文 Figure 4(b),MOT17 訓練集,IDF1。
只用一層的時候,片段超過 32 幀反而變差:128 幀時掉到 61.9。圖太大、負樣本太多,網路學不動。只要加層,片段越長越好。九層、512 幀的 77.6,比單層最好的 64.2 高了 13.4。
每一層在看什麼
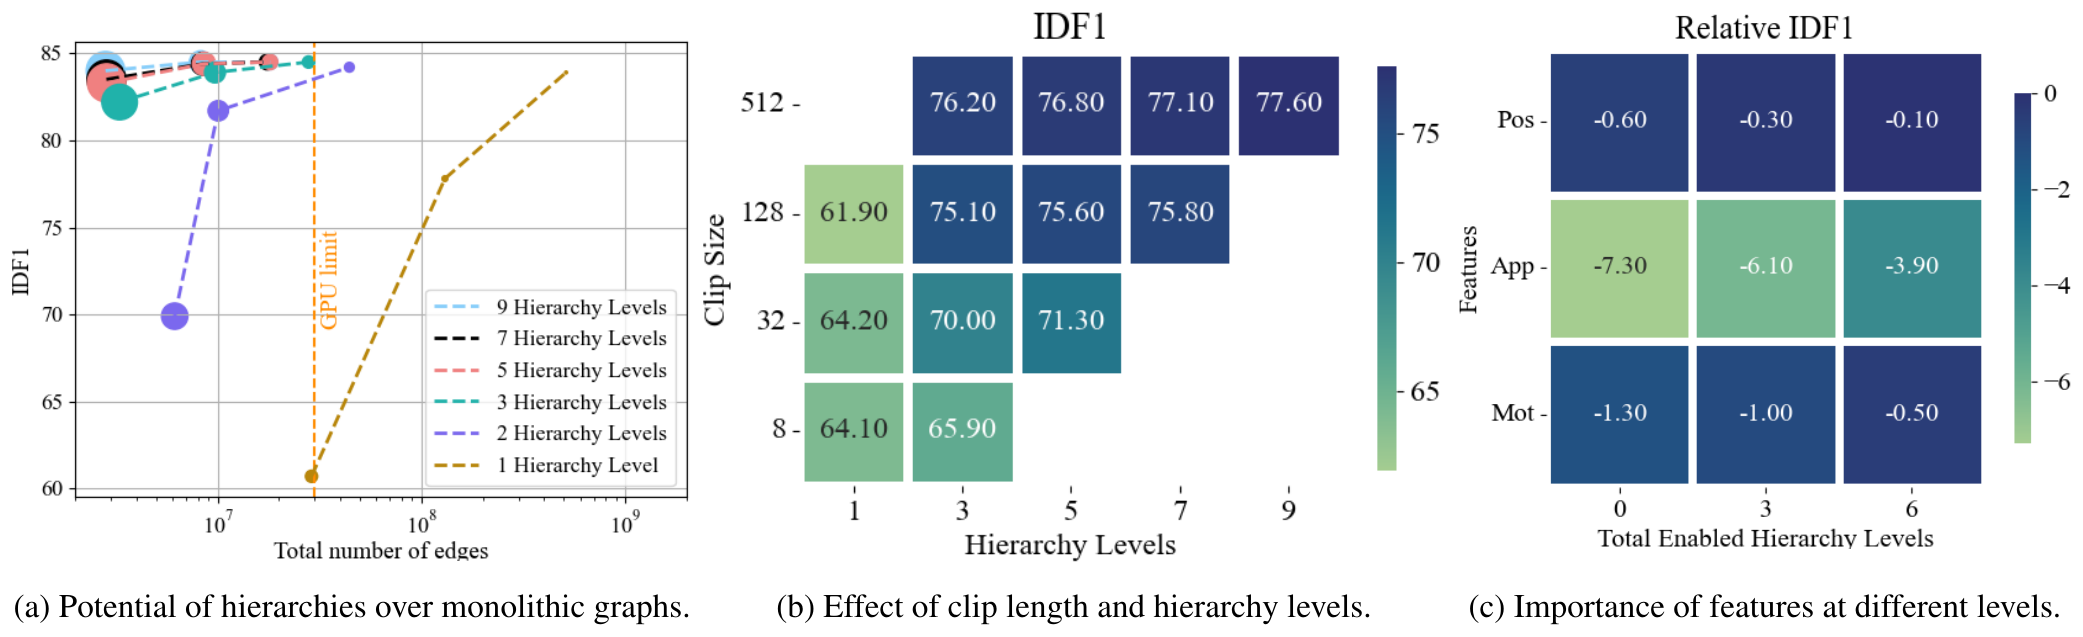
(c) 檢查的是,同一個網路在不同層,會不會倚重不同的線索。
- 外觀最重要,而且主要用在高層。 全部關掉,IDF1 少 7.3。只在第 7 到 9 層關掉,就少 3.9;只在第 1 到 3 層保留,比全部關掉只補回 1.2。
- 運動在各層的影響差不多。 全部關掉少 1.3,影響溫和。
- 位置只對低層有用。 全部關掉也只少 0.6,而且在前三層保留就補回一半。
相鄰幀看位置,隔得遠了看長相,這和直覺一致。差別在於,這是網路自己從資料學到的,沒有人替它寫規則。
四個資料集
| 資料集 | 對手 | IDF1 | HOTA | SUSHI IDF1 | HOTA |
|---|---|---|---|---|---|
| MOT17 公用 | MPNTrack | 61.7 | 49.0 | 71.5 | 54.6 |
| MOT17 自備 | ByteTrack | 77.3 | 63.1 | 83.1 | 66.5 |
| MOT20 自備 | ByteTrack | 75.2 | 61.3 | 79.8 | 64.3 |
| DanceTrack | ByteTrack | 53.9 | 47.7 | 63.4 | 63.3 |
整理自原論文 Table 2–4,測試集。
MOT17 公用偵測的設定下,SUSHI 用的就是 MPNTrack 的網路,IDF1 卻高了 9.8,差別只在階層。用 ByteTrack 的 YOLOX 偵測時,IDF1 高 5.8,ID 切換從 2,196 降到 1,149,少了將近一半。
DanceTrack 的進步最多,HOTA 從 ByteTrack 的 47.7 跳到 63.3,也高於原論文表中 HOTA 最高的 MOTR 和 QDTrack(都是 54.2)。ByteTrack 在 MOT17、MOT20 都很強,到了 DanceTrack 就落後;SUSHI 在三個資料集都領先。行車視角的 BDD 上,SUSHI 直接把同一套 GNN 套到八個類別,測試集的 mIDF1 從 55.8 提升到 60.0。
MOTA 的情況不同。MOT20 上,SUSHI 的 MOTA 是 74.3,低於 ByteTrack 的 77.8。SUSHI 改進的是關聯,偵測的漏抓和誤報它管不到。
限制
SUSHI 是離線方法,要拿到一整段 512 幀的片段才能開始處理,沒辦法用在需要即時輸出的系統上。21 fps 也是在偵測已經算好之後的速度。
ReID 網路是現成的,沒有針對追蹤資料微調,SUSHI 的改進全部來自關聯這一側。公用偵測的設定下,它也和其他圖方法一樣,先用 Tracktor 精修偵測框,這一步本身就是一個短期追蹤器。
結論
SUSHI 沒有發明新的圖網路,每一層都是 MPNTrack。它把一張又大又稀疏的圖,換成九張小圖疊起來。邊少了兩個數量級,正確邊的比例也從萬分之二拉回百分之五,網路終於學得動。
共用權重則把「哪個時間尺度看哪種線索」交還給資料。同一個網路在低層看位置,在高層看外觀,沒有人替它規定。
九層、512 幀,在 MOT17 上大約是半分鐘。比這更久的遮擋,就要看滑動窗之間的縫接接不接得上了。