原始论文
Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking
- 发表版本
- CVPR 2021会议
- arXiv 首次提交
- arXiv:2103.16178
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackinggmtracker2021,
  title = {{Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking}},
  author = {Jiawei He and Zehao Huang and Naiyan Wang and Zhaoxiang Zhang},
  year = {2021},
  eprint = {2103.16178},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2103.16178}
}
从 SORT 到 DeepSORT,大部分在线跟踪器都是把上一帧的轨迹和这一帧的检测排成一张二分图,算出每一对的相似度,交给匈牙利算法匹配。
这张二分图只有一种边,就是「轨迹 和检测 有多像」。同一帧里的两个检测彼此是什么关系、两条轨迹原本谁在谁的左边,全都不在考虑之内。
中国科学院自动化所的 Jiawei He、Zhaoxiang Zhang 和图森(TuSimple)的 Zehao Huang、Naiyan Wang 认为,这些关系才是遮挡时最可靠的线索。行人常常结伴走,一个人被挡住、外观看不清楚的时候,我们还是可以从「他原本走在谁旁边」把他认回来。
定义问题
作者整理了当时数据关联的三个问题:
- 忽略了同一帧之内的上下文。 不管是两帧之间的二分图匹配,还是跨多帧的最小费用流,都只在乎「跨帧」的匹配,没有把同一帧里物体彼此的关系用上。
- 端到端的方法只靠网络去拟合。 有些方法直接让网络输出匹配结果,却没有用上组合优化这几十年积累的工具。
- 优化方法的特征是另外训练的。 用图优化做关联的方法,特征通常来自一个独立训练的网络,训练时的目标和推理时的匹配方式并不一致。
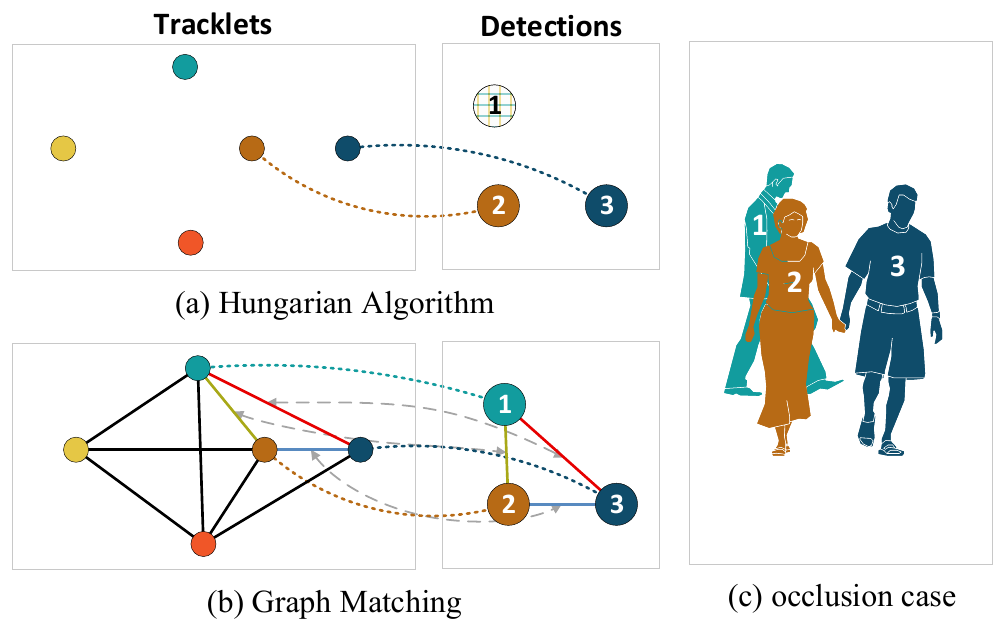
看右边的 (c)。1 号被 2 号挡住了一大半,提取出来的外观特征多半不可靠。(a) 的匈牙利算法只看「这个检测长得像哪条轨迹」,1 号就配不上了。(b) 还多看检测 1、2、3 之间的相对位置,它和轨迹之间的相对位置对得上,于是 1 号被认了回来。
作者把这种「边对边」的关系称为二阶相似度。要把它用进关联,匹配问题就不再是二分图匹配,而是一般的图匹配。
解决问题
从二分图匹配到图匹配
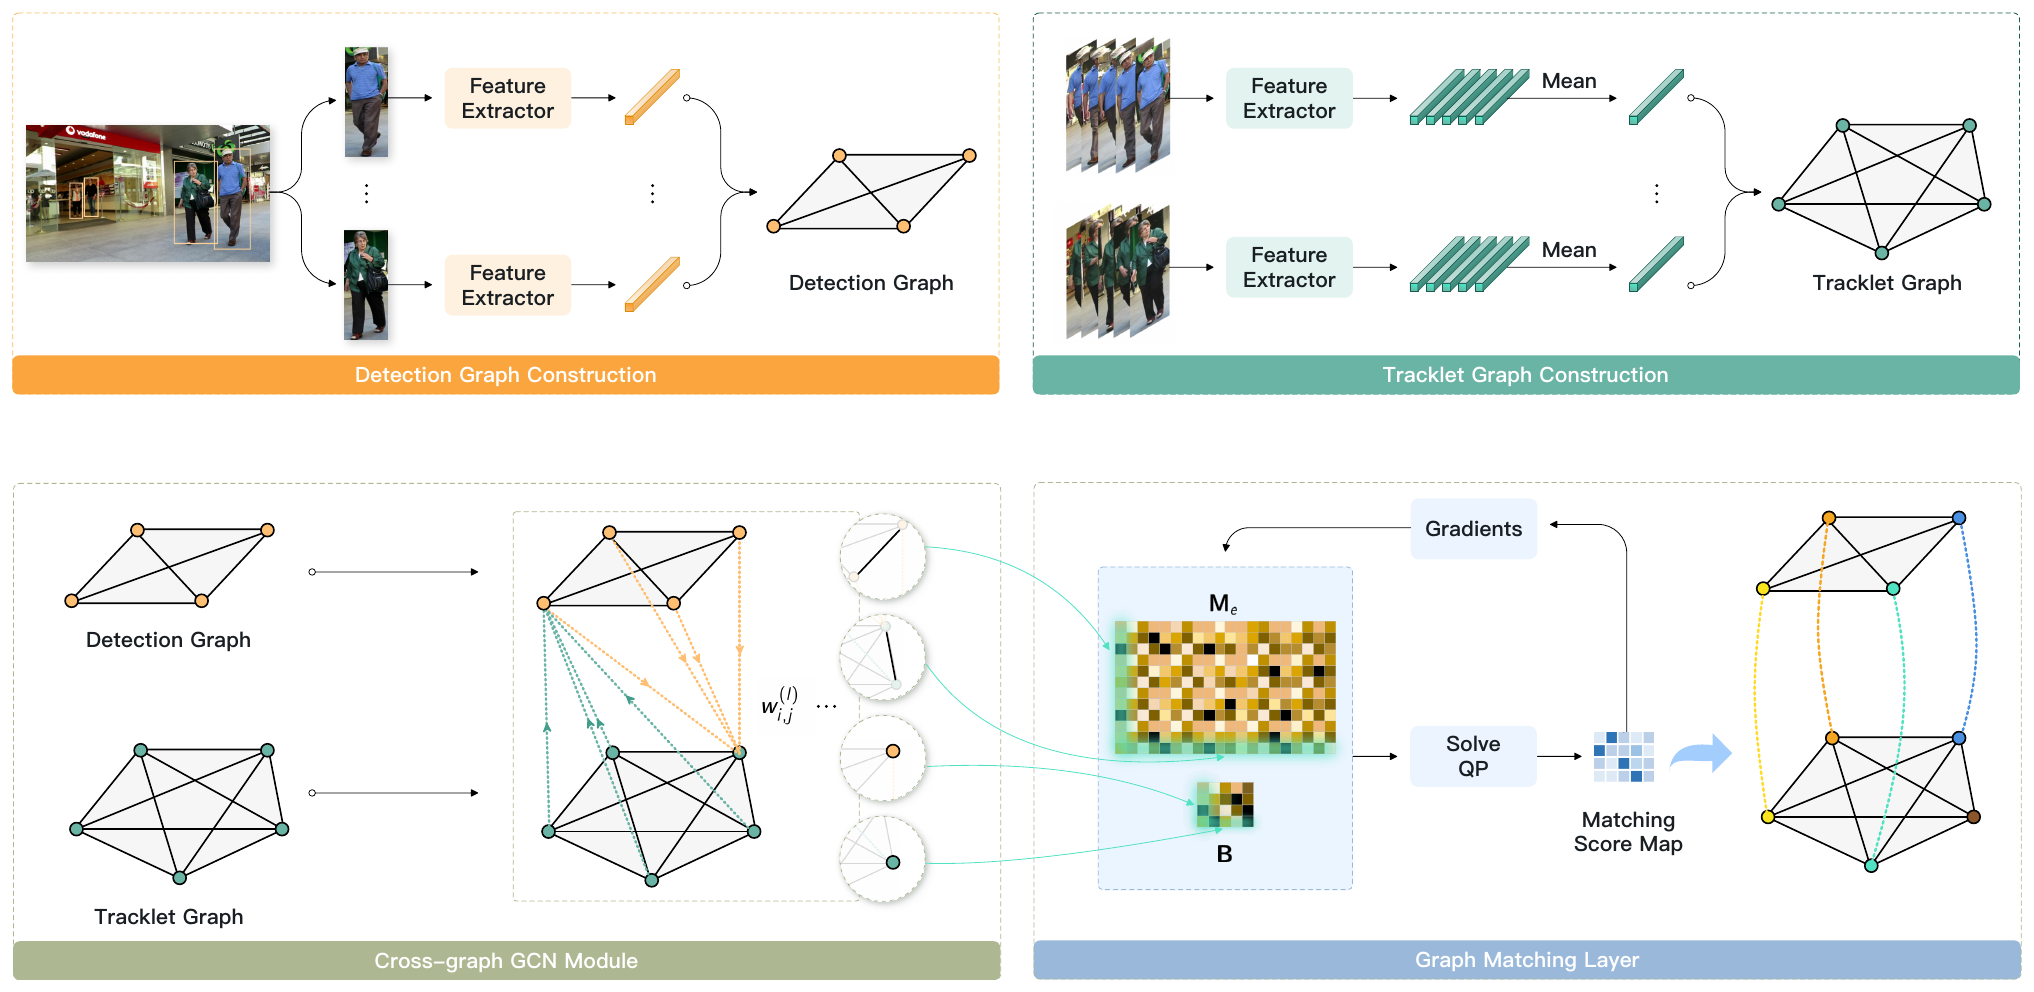
每一帧,作者建两张图。检测图 的顶点是这一帧的检测,轨迹图 的顶点是当前的轨迹,两张都是完全图,任意两个顶点之间都有边。
图匹配要找一组对应 ,让配上的顶点彼此相似,配上的边也彼此相似。写成数学,是一个二次分配问题:
、 是两张图的边权重, 是顶点之间的相似度。第一项要求配上的边权重相近,第二项要求配上的顶点相似。
只看第二项,就是一般的匈牙利算法。第一项是新加的部分。
一个双胞胎的例子
我们用一个极端的例子,看看第一项有什么用。
两条轨迹 、, 一直走在 的左边。这一帧出现两个检测 、,但两个人是双胞胎,穿得一模一样,外观相似度全部是 0.5。
只看顶点,两种配法的分数一样:
| 配法 | 顶点分数 |
|---|---|
| –、– | 0.5 + 0.5 = 1.0 |
| –、– | 0.5 + 0.5 = 1.0 |
匈牙利算法只能随便挑一个。
现在加上边。GMTracker 的边特征,是把两端顶点的特征拼接起来,所以边有方向, 和 是不同的边。假设检测 在 的左边,边 和 的相似度是 0.9,和 只有 0.2;反方向同理。
| 配法 | 顶点分数 | 边分数 | 合计 |
|---|---|---|---|
| –、– | 1.0 | 0.9 + 0.9 | 2.8 |
| –、– | 1.0 | 0.2 + 0.2 | 1.4 |
本文整理的算例。
光看长相分不出来的两个人,看他们和身边的人站在哪里,就分得出来。
松弛成可微的二次规划
问题是,二次分配问题是 NP-hard,没有匈牙利算法那样的多项式解法,更没办法放进神经网络里反向传播。
作者做了两步:
- 松弛。 把只能是 0 或 1 的置换矩阵,放宽成每行、每列加起来都为 1 的「双随机矩阵」。这是置换矩阵最紧的凸松弛,问题于是变成一个凸二次规划。
- 把边权重换成边特征。 原本每条边只有一个权重,现在每条边是一个向量。边和边之间的相似度,用两个边特征的余弦相似度表示,组成一个边对边的相似度矩阵 ,再展开成二次项的矩阵 。
最后要解的是:
是把匹配矩阵拉平后的向量, 是顶点相似度。约束条件是每个检测的匹配分数加起来等于 1,每条轨迹加起来不超过 1,因为有些轨迹在这一帧消失了。
一个二次规划的最优解,可以用 KKT 条件和隐函数定理,对输入求出梯度。作者参考 OptNet 的做法,把整个图匹配做成一层可微的网络。训练时让梯度穿过这一层,回传到特征上;推理时只需要前向求解。
这解决了前面的第三个问题。特征是为了让图匹配配得对而训练的,训练和推理用的是同一套匹配方式。
跨图的图卷积
顶点的特征来自一个预训练的 ReID 网络,后面接两层可训练的全连接层。轨迹的特征,是它所有检测特征的平均。
在送进图匹配之前,作者先用一层跨图的图卷积增强特征。检测图上的每个顶点,从轨迹图的所有顶点收集消息,权重是外观和位置的相似度:
轨迹的框 由匀速卡尔曼滤波预测。镜头在动的视频,预测的位置不可靠,就只用外观相似度。
收集到的消息 ,经过归一化后加回原本的特征,再过一个 MLP:
轨迹图的顶点也用同样的方式更新。和 MPNTrack 一样,消息只在两张图之间传递,同一张图内部不传。最后,每条边的特征是两端顶点特征拼接后再做 l2 归一化。
训练与推理
训练用加权的二元交叉熵,正样本的权重是 ,用来平衡一个检测只有一条正确轨迹、却有很多条错误轨迹的不平衡。二次规划的解比较平滑,计算损失前先用温度很低()的 softmax 把分数拉开。
推理时,松弛后的解不一定是 0 或 1,作者用贪心的方式取整,每个检测配给分数最高的轨迹。轨迹的建立和删除则沿用 DeepSORT:外观太不像、离所有轨迹太远(卡尔曼滤波的马氏距离超过阈值)、或和所有轨迹都不重叠的检测,先不参与匹配;这些检测之后再用 IoU 和匈牙利算法,和没配上的轨迹补配一次。另外加上 ECC 做相机运动补偿。轨迹 100 帧没更新才删除。
讨论
每个组件的贡献
消融在 MOT17 训练集上做三折交叉验证,以 DeepSORT 的匈牙利匹配为基准:
| 设置 | IDF1 | MOTA | ID 切换 |
|---|---|---|---|
| DeepSORT 基准 | 68.1 | 62.1 | 1,135 |
| +图匹配 | 70.0 | 62.3 | 1,128 |
| 完整 GMTracker | 71.5 | 62.3 | 1,017 |
| 完美关联 | 77.2 | 62.6 | 14 |
整理自原论文 Table 1 与附录 Table A,MOT17 验证集,不含插值。
- 图匹配本身贡献最多。 只把匈牙利算法换成图匹配,IDF1 就多了 1.9。训练过的外观特征和图卷积再加约 0.6,加入位置信息再加约 1.0。
- MOTA 几乎不动。 从 62.1 到 62.3,因为 GMTracker 处理的是关联,检测没有变。这也是作者以 IDF1 为主要指标的原因。
- 离完美还有距离。 附录里,作者用真值做完美关联,IDF1 是 77.2。GMTracker 补上了基准和完美之间大约三分之一的差距。
图匹配层一定要一起训练才有用。训练和推理都不用它,IDF1 是 69.5;只在推理时加上它,是 70.2;训练和推理都用,才到 71.5。
能跟踪多久
| 轨迹保留帧数 | 30 | 50 | 80 | 100 | 150 |
|---|---|---|---|---|---|
| 匈牙利算法 | 67.2 | 67.9 | 68.1 | 68.1 | 67.3 |
| 图匹配 | 68.0 | 69.3 | 69.7 | 70.0 | 70.0 |
整理自原论文 Table 4,MOT17 验证集,IDF1。
保留越久,候选的轨迹就越多,匈牙利算法在 150 帧时反而掉了 0.8,因为候选一多就容易配错。图匹配则一路持平或上升,作者据此认为,GMTracker 可以把消失了大约 5 秒的轨迹配回来。
候选多的时候,光比外观容易认错人;把相对关系也放进来,错误的组合就比较难凑得起来。
和其他方法比
在 MOT17 测试集上,使用经 Tracktor 精修的公开检测,在线的 GMTracker IDF1 是 63.8、MOTA 56.2,高于当时其他在线方法;换成 CenterTrack 的检测,IDF1 是 66.9。加上线性插值和离线方法比,IDF1 是 65.9,高于 MPNTrack 的 61.7 和 LifT 的 65.6;用 CenterTrack 检测再加插值,IDF1 68.7、MOTA 65.0。
这里的比较要注意检测的条件。MOTA 主要受检测影响,所以同样是 GMTracker,换一组检测,MOTA 就从 56.2 跳到 61.5。
代价
这篇论文没有报告速度。二次规划的变量个数是检测数乘以轨迹数,边对边的相似度矩阵又比它大上许多;作者在推理时改用 CVXPY 只做前向求解。拥挤的场景里每一帧都要解一次二次规划,计算成本是使用前要先评估的地方。
后来的期刊扩展版把同一套可学习的图匹配,用到图像特征点匹配和点云配准上,标题也改成了「数据关联的实用范式」。
结论
GMTracker 把在线跟踪的匹配,从只看顶点的二分图匹配,换成同时看顶点和边的图匹配。一个人被挡住、外观不可靠的时候,他和周围其他人的相对关系,还能把他认回来。为了让这件事能放进神经网络,作者把二次分配问题松弛成凸二次规划,再用 KKT 条件求梯度,让特征为了匹配而学。
这篇和 MPNTrack 都把物体之间的关系当成关联的线索,不只是两两比对。MPNTrack 让图网络直接预测哪些边该连,GMTracker 则保留了优化求解,只让网络学特征。
同样出自 MPNTrack 团队的 SUSHI,后来把图网络的做法推到了长时间的跟踪。