原始论文
Learning a Neural Solver for Multiple Object Tracking
- 发表版本
- CVPR 2020会议
- arXiv 首次提交
- arXiv:1912.07515
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmpntrack2019,
  title = {{Learning a Neural Solver for Multiple Object Tracking}},
  author = {Guillem Brasó and Laura Leal-Taixé},
  year = {2019},
  eprint = {1912.07515},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.07515}
}
离线跟踪有一个很漂亮的老想法,把整段视频的检测结果画成一张图。
每个检测是一个节点,不同帧的两个检测之间连一条边。如果两个检测属于同一条轨迹、而且在时间上前后相邻,这条边就是「激活」的。跟踪就变成一个图划分问题,找出哪些边该激活。
这套框架的标准做法分成两步。先给每条边算一个代价,表示两个检测是同一个人的可能性;再把代价丢进优化求解器,找出整体最好的划分。
到了 2019 年,这个方向的研究大致分成两派。一派把功夫花在图的形式上,设计越来越复杂的优化,纳入高阶关系,但代价大多还是手工设计的。另一派用孪生网络之类的深度模型学出更好的边代价,再交给简单的求解器,但代价只看两两匹配,看不到整个场景。
慕尼黑工业大学的 Guillem Brasó 和 Laura Leal-Taixé 觉得两条路都只走了一半。Leal-Taixé 是 MOT16 和 Tracktor 的作者之一。这次两人想试试看,能不能让网络连「解题」这一步也一起学。
定义问题
把跟踪写成网络流
作者从经典的最小费用流(min-cost flow)出发,做了一点简化。
给定一段视频的所有检测 ,每个检测 包含框内的图像、框的坐标和时间戳。建一张无向图,每个检测是一个节点,任何两个不同帧的检测之间都连一条边。允许跨帧连线,就能把中间漏检的轨迹接回来。
每条边 有一个二值变量 。如果两个节点属于同一条轨迹、而且是轨迹上相邻的两个检测,,否则为 0。
轨迹之间不能共用节点,所以 要满足两个约束。每个节点往过去最多连一条激活的边:
往未来也最多一条:
这是网络流守恒约束的简化版。
传统做法会给每条边一个代价 ,求解
在上面两组约束下,这个问题可以在多项式时间内求出最优解。
直接预测答案
既然最后要的是 ,作者干脆不学代价,直接学 。
每条边是一个二分类问题,标签就是 。这样整个跟踪问题变成一个可以端到端训练的任务,特征和「解法」都在同一个网络里学。
剩下的问题是,一个只看两个节点的分类器,学不到「这个人已经被别人连走了」这种全局的信息。要让每条边的判断考虑到整张图,作者用的是消息传递网络(Message Passing Network, MPN)。
解决问题
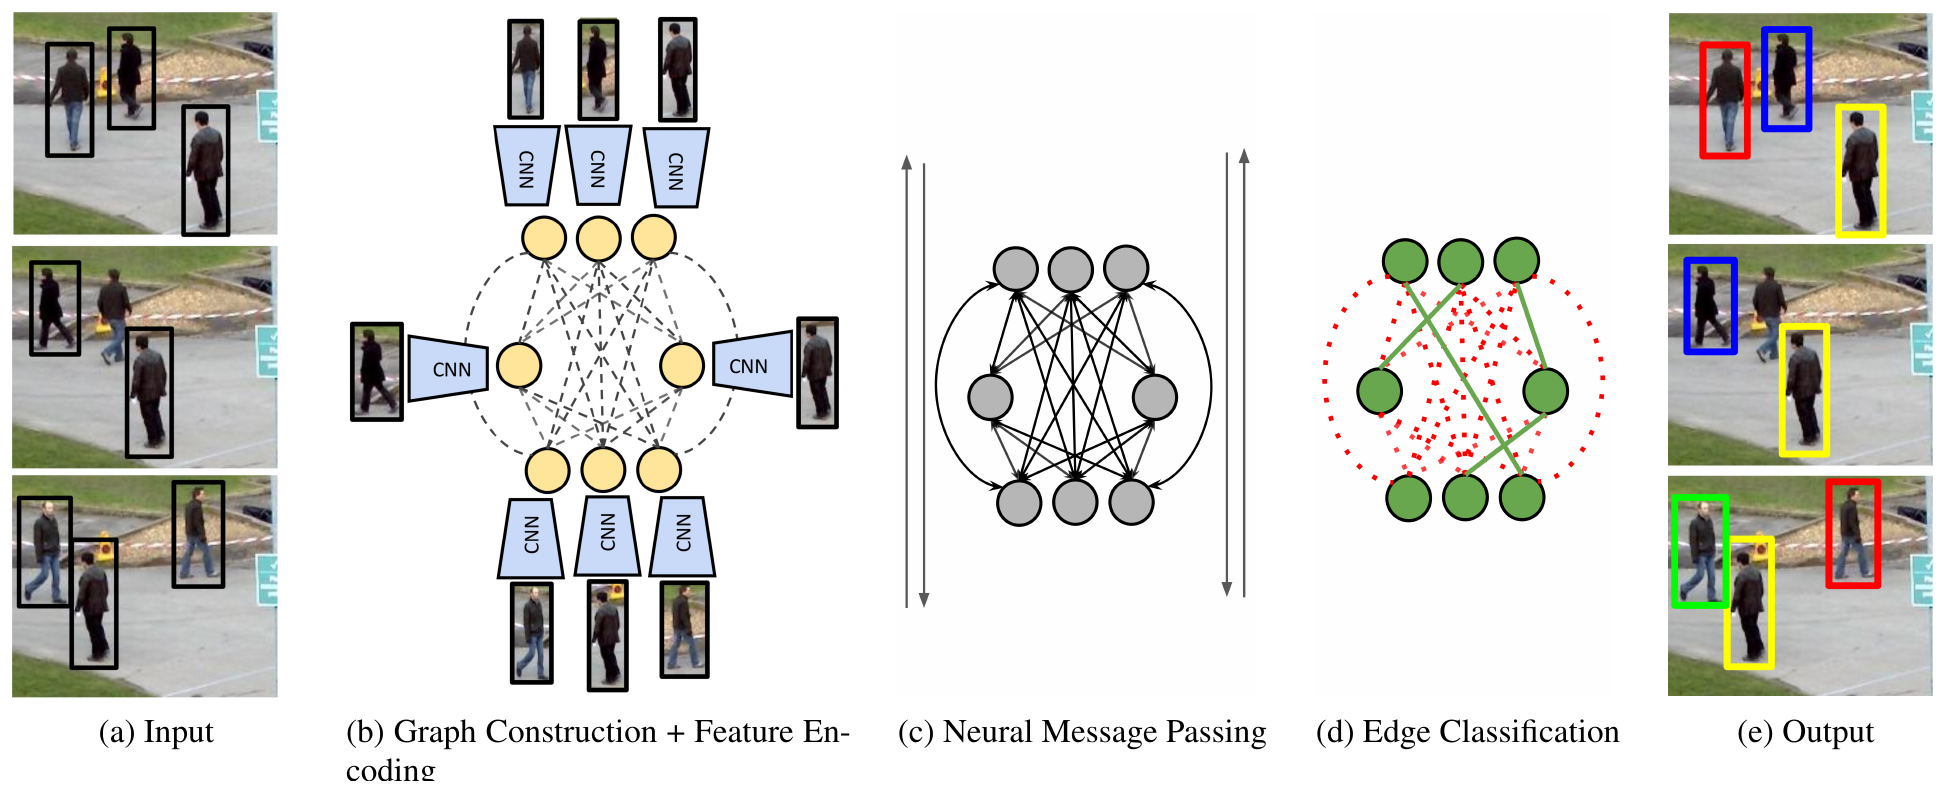
整个流程分成建图、编码特征、消息传递、边分类四步。
初始特征
节点的初始嵌入来自外观。作者用 ImageNet 预训练的 ResNet-50,在 Market-1501、CUHK03、DukeMTMC 三个行人重识别数据集上训练,得到 256 维的 re-ID 特征;之后再接三层全连接,把节点嵌入压到 32 维。
边的初始嵌入来自几何关系。对两个不同帧的检测框 和 ,先算出相对位置和相对大小:
位移除以两个框的平均高度,远近不同的人就可以用同一个尺度比较。再接上两者的时间差 ,以及两个 re-ID 特征的欧氏距离,一起送进一个 MLP,得到边的初始嵌入。
消息传递
一般的消息传递网络,每一步分两个更新。先用两端节点更新边:
再用相连的边更新节点。每条边各产生一条消息,把所有消息求和(或取平均、最大值),得到新的节点嵌入。
这样反复 次之后,每个节点和边都带着距离 以内的信息,作用类似 CNN 的感受野。原本只看两个框的边分类,现在能看到「这两个节点周围还有哪些候选」。
时间感知的节点更新
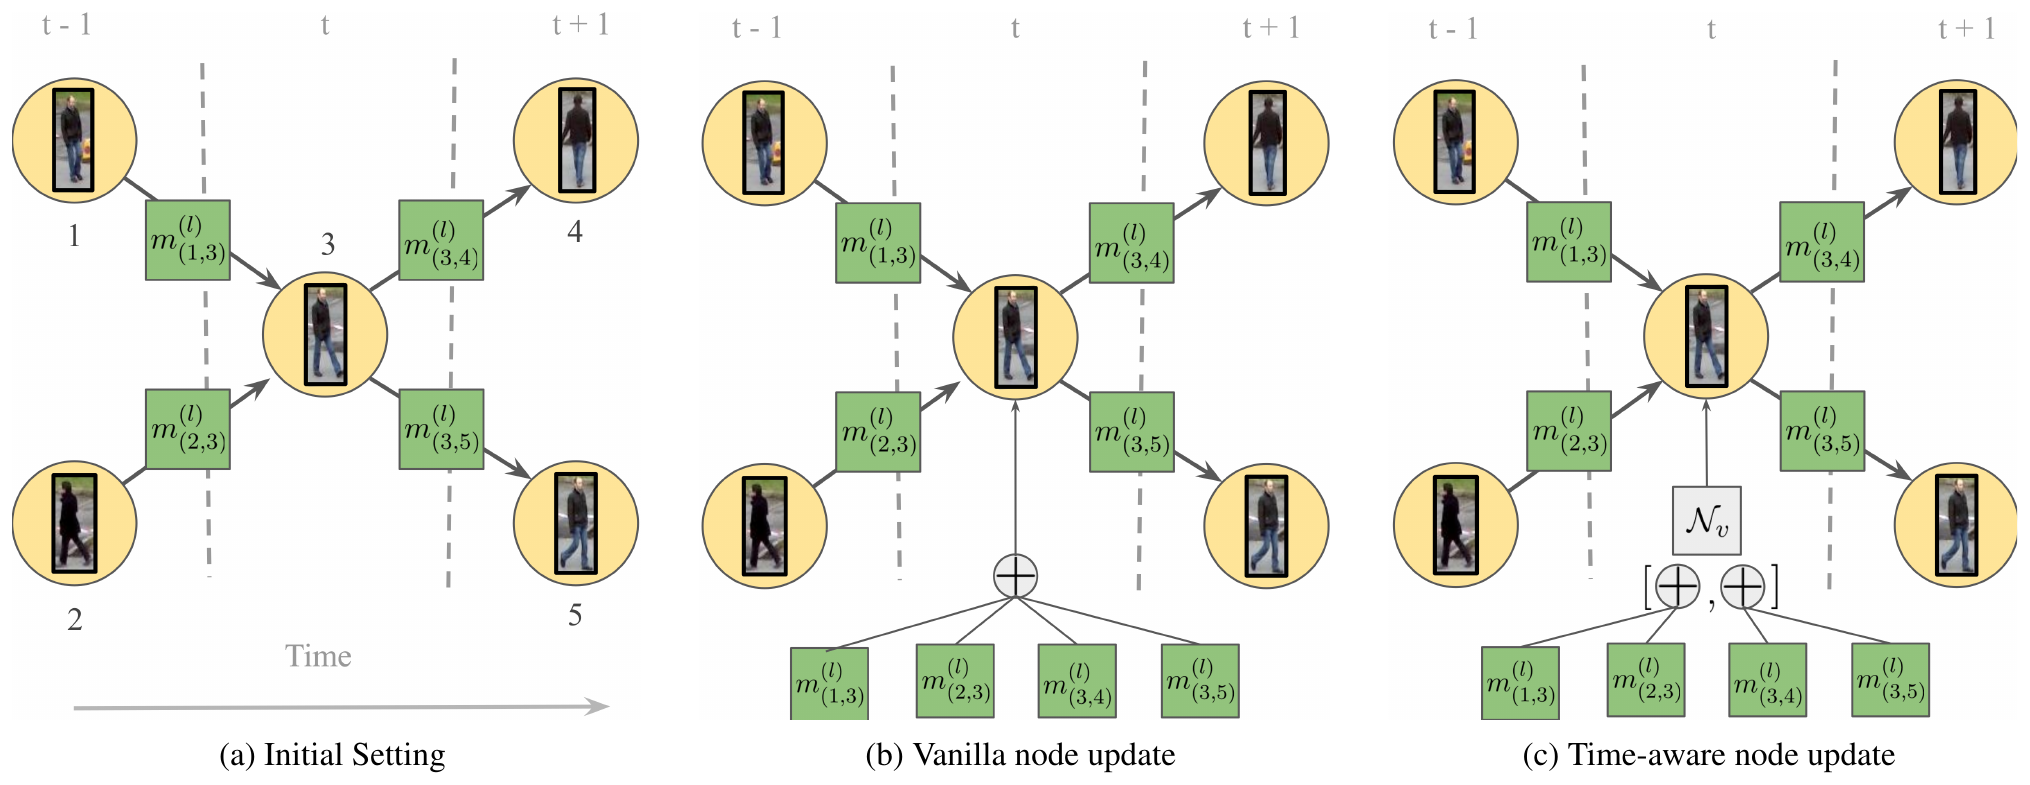
这篇在架构上最主要的改动,是节点更新。
回头看网络流的约束,每个节点往过去最多连一条、往未来最多连一条。但一般的节点更新把所有邻居的消息混在一起求和,加完之后,节点根本分不出哪些消息来自过去、哪些来自未来,也就很难判断约束有没有被违反。
作者把 MOT 图的时间结构直接写进更新规则。对节点 ,过去和未来的邻居用两个不同的 MLP 计算消息。过去的邻居 用的是
未来的邻居则用 。两边分别求和得到 和 ,拼接后送进最后一个 MLP:
公式里的 是初始嵌入,一路接到每一步,让网络传了很多次之后也不会忘记原本的特征。边的更新也同样接上了初始的边特征。
训练与推理
边分类器是一个输出单个 sigmoid 值的 MLP。从第 步到最后一步 ,每一步的边嵌入都拿来预测,一起算加权的二元交叉熵:
其中每条边在第 步的损失是
激活的边远比未激活的少,正样本另外乘上权重 。
推理时,直接把最后一步的预测值当成 的答案,以 0.5 为阈值二值化。网络没有被强制满足网络流的约束,所以阈值化之后可能出现一个节点连出两条边的情况。作者准备了两种修正方式,一是贪心地只保留分数最高的那一条,二是用线性规划求精确的最优舍入。实际上违反约束的边很少,两种方法几乎没差别,贪心法的 IDF1 只低 0.2。
实现细节
这里有几个实际跑起来时很重要的设置:
- CNN 冻结。 作者发现连 ResNet 一起训练,效果没有明显提升,计算量却大很多,所以卷积层全部冻结,只训练后面的 MLP。
- 滑动窗口。 视频切成 15 帧一段的图,相邻两段重叠 14 帧;重叠的边取各段预测的平均。静态镜头以每秒 6 帧采样,移动镜头每秒 9 帧,所以每张图只涵盖大约一秒半到两秒多的视频。
- 剪枝。 不同帧的节点全连会让边数爆炸,所以只有在两个节点互为 re-ID 特征最近的前 50 名时,才连边。
- 用 Tracktor 预处理。 公开检测先跑一次 Tracktor,丢掉它给的 ID,只拿修正后的框当作输入。Tracktor 的框比较准,也会在相邻帧补上一些漏掉的检测。输出轨迹中间缺的帧,先拿 Tracktor 的轨迹补,剩下的再用插值补齐。
最后一点值得注意。MPNTrack 自己的网络每秒能跑 35 帧,但前面的 Tracktor 只有每秒 8 帧,整个系统平均是每秒 6.5 帧。
讨论
消融实验都在 MOT17 训练集上,以三折交叉验证进行。
时间感知的更新
| 节点更新 | MOTA ↑ | IDF1 ↑ | ID 切换 ↓ | 约束满足率 ↑ |
|---|---|---|---|---|
| 普通 | 63.0 | 67.3 | 1,022 | 82.1% |
| 时间感知 | 64.0 | 70.0 | 602 | 98.8% |
整理自原论文 Table 1。约束满足率是阈值 0.5 下,网络流守恒约束被满足的平均比例。
把过去和未来分开,IDF1 多了将近 3 分,ID 切换从 1,022 降到 602。
更有意思的是最后一列。普通的 MPN 直接二值化后,只有 82.1% 的约束被满足;时间感知的版本是 98.8%。网络几乎自己学会了「每个人往前往后各只能连一个」这条规则,不需要外加的求解器去强制。
传几步
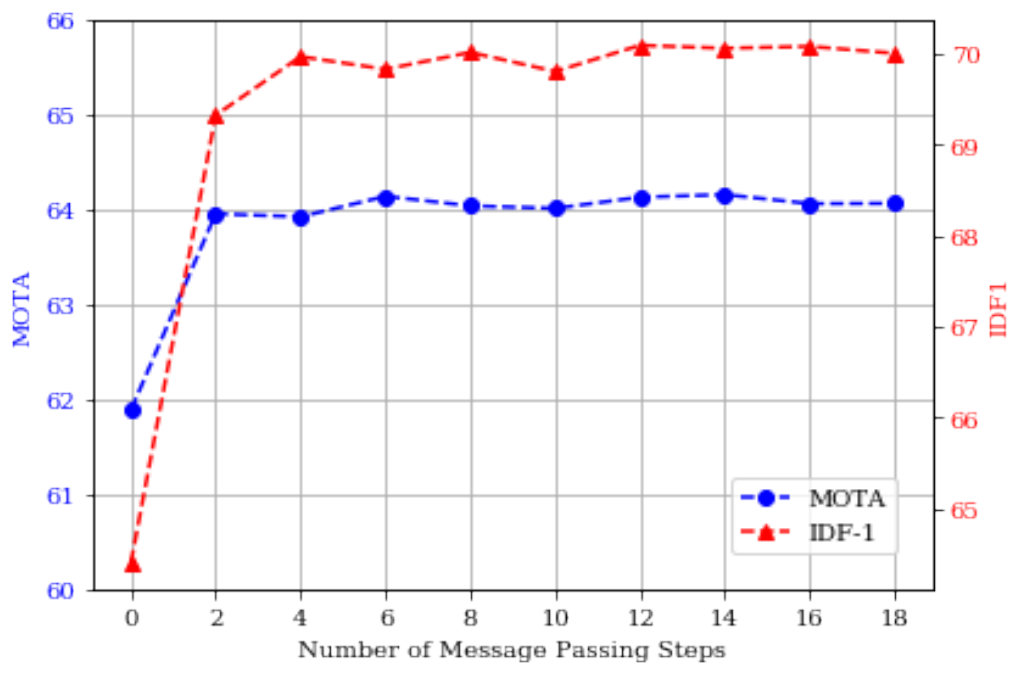
0 步就是不传消息,只用初始的边嵌入做二分类,相当于传统「学两两代价」的做法。
从 0 步到 2 步,MOTA 和 IDF1 都大幅跳升,这是从两两关系进入高阶关系的那一步。之后上升趋势大约在 6 步停住,12 步之后就没有再改善。最终设置用 。
特征来源
| 边特征 | MOTA ↑ | IDF1 ↑ | FP ↓ | ID 切换 ↓ |
|---|---|---|---|---|
| 只有时间差 | 58.8 | 52.6 | 13,127 | 2,962 |
| 时间差 + 位置 | 63.6 | 68.7 | 6,308 | 895 |
| 时间差 + 位置 + 外观 | 64.0 | 70.0 | 6,169 | 602 |
整理自原论文 Table 2。
这张表有点出人意料。加上相对位置之后,IDF1 从 52.6 跳到 68.7,是最大的一步;外观特征再加上去,IDF1 只多 1.3。但外观把 ID 切换从 895 再压到 602,还是值得保留。
在这个框架下,位置比外观重要得多。论文没有进一步分析原因,一个可能的解释是,节点本身已经带着外观嵌入,消息传递时边也拿得到,边上再放一个外观距离,信息有一部分是重复的。
和其他方法比
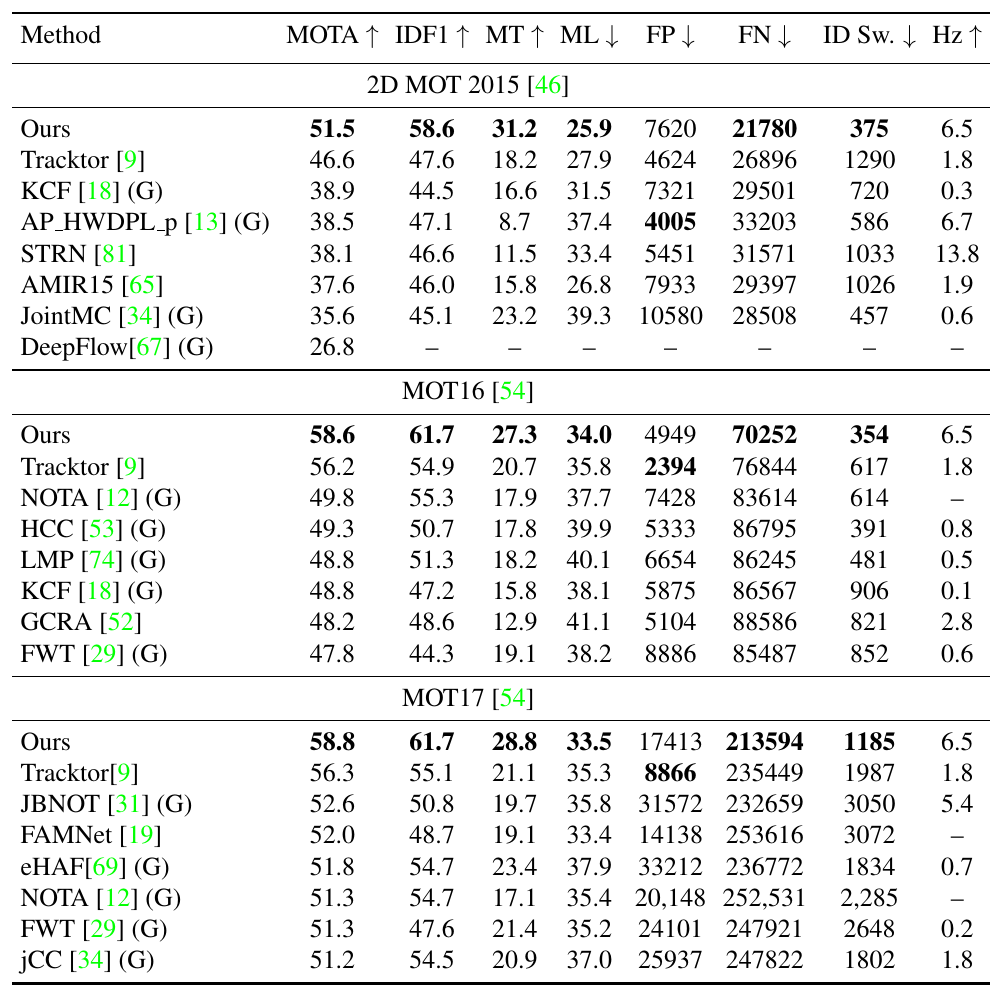
三个基准都使用公开检测。MPNTrack 在三个数据集上都是第一,IDF1 比此前最好的结果分别高出 11、6.4、6.6 分。和其他图划分方法比,它不但准得多,还比其中一些快上一个数量级,例如 JointMC 只有 0.6 Hz。
但 Tracktor 的预处理在这里帮了不少忙。附录里,作者另外报告了不用 Tracktor、改用 Faster R-CNN 的回归头修正公开检测的版本:
| 数据集 | MOTA(有 Tracktor) | MOTA(无) | IDF1(有 Tracktor) | IDF1(无) |
|---|---|---|---|---|
| MOT15 | 51.5 | 46.6 | 58.6 | 53.8 |
| MOT16 | 58.6 | 54.3 | 61.7 | 56.8 |
| MOT17 | 58.8 | 56.0 | 61.7 | 58.4 |
整理自原论文附录 Table 7。
拿掉 Tracktor,MOTA 掉了 2.8 到 4.9 分,IDF1 掉了 3.3 到 4.9 分。但即使如此,它还是赢过表上其他的图方法,而那些方法有不少用了没做非极大值抑制的原始检测、低层图像特征或层次化的设计,拿到的信息比它多。
局限
MPNTrack 是离线方法,每张图要看到未来的帧才能做决定,没法直接搬到实时系统上。
时间窗口也很短。一张图只涵盖两秒左右,被长时间遮挡的人,就算走回画面,也不在同一张图里,接不回来。边数随节点数平方增长,窗口要拉长,剪枝就得更狠。
同一个实验室后来在 2023 年的 SUSHI 里把图叠成多层,下层处理短时间的连接,上层把短轨迹再接成长轨迹,处理的就是这个窗口太短的问题。
结论
在这篇之前,学习在多目标跟踪里主要用来学特征和代价,真正决定轨迹的还是传统的优化求解器。MPNTrack 把网络流的二值变量直接当成分类标签,用消息传递让每条边看见整张图,让网络自己学出接近可行的解。
时间感知的更新是个不起眼的小改动,只是把过去和未来分开求和,却让网络几乎自己学会了守恒约束。
论文标题说要学一个求解器,网络也确实学到了 98.8%。剩下那 1.2%,最后还是得交给舍入规则收尾,一个贪心循环就够了。