原始论文
Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2609.00924
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingplanet2026,
  title = {{Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking}},
  author = {Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2026},
  eprint = {2609.00924},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.00924}
}
摄像机把立体的世界拍成平面的画面。前后站着的两个人,在画面上叠在一起;一个人朝镜头走来,在画面上只是框变大了一点。深度、前后、真正的移动方向,都在投影时被压扁了。
跟踪器看到的,也只有这个平面。不论是比外观、比框的重叠,还是预测框的移动,全部在图像平面上进行,也就一并继承了这些歧义。
这一两年,VGGT、Depth Anything 3 这类几何基础模型,已经能从一段普通视频直接估出整个场景的立体结构和相机参数。SUSHI、NOOUGAT 的作者群(Orcun Cetintas、Guillem Brasó、Tim Meinhardt、Laura Leal-Taixé)想试试看,把这些估出来的 3D 信息放进跟踪器,会不会让它看得更清楚。
定义问题
把 3D 信息用在跟踪上,其实早有人做过。有的方法估计行人的可见程度来推理遮挡,有的把轨迹转到世界坐标,有的用 3D 人体模型。也有方法在卡尔曼滤波里加入深度约束,或在鸟瞰图上预测轨迹。
作者指出,这些做法里的 3D 信息要么绑定特定类别,例如只适用于行人;要么在物体表示已经形成之后,才在关联阶段作为额外的规则或代价项加进去。跟踪器内部的物体表示,仍然只有 2D。
另一个问题是时间。基于查询的端到端跟踪方法,训练时通常只看 2 到 10 帧,推理时能回头看的范围也有限;PLANET 所依据的 MOTIP,可以看过去 30 帧,在一般的视频里只有一两秒。被挡得更久的人,就超出了它的记忆。
PLANET 要做的,是让 3D 信息在查询形成的时候就进来,并让这些信息在更长的时间范围内都用得上。
解决问题
先把数据集变成 3D
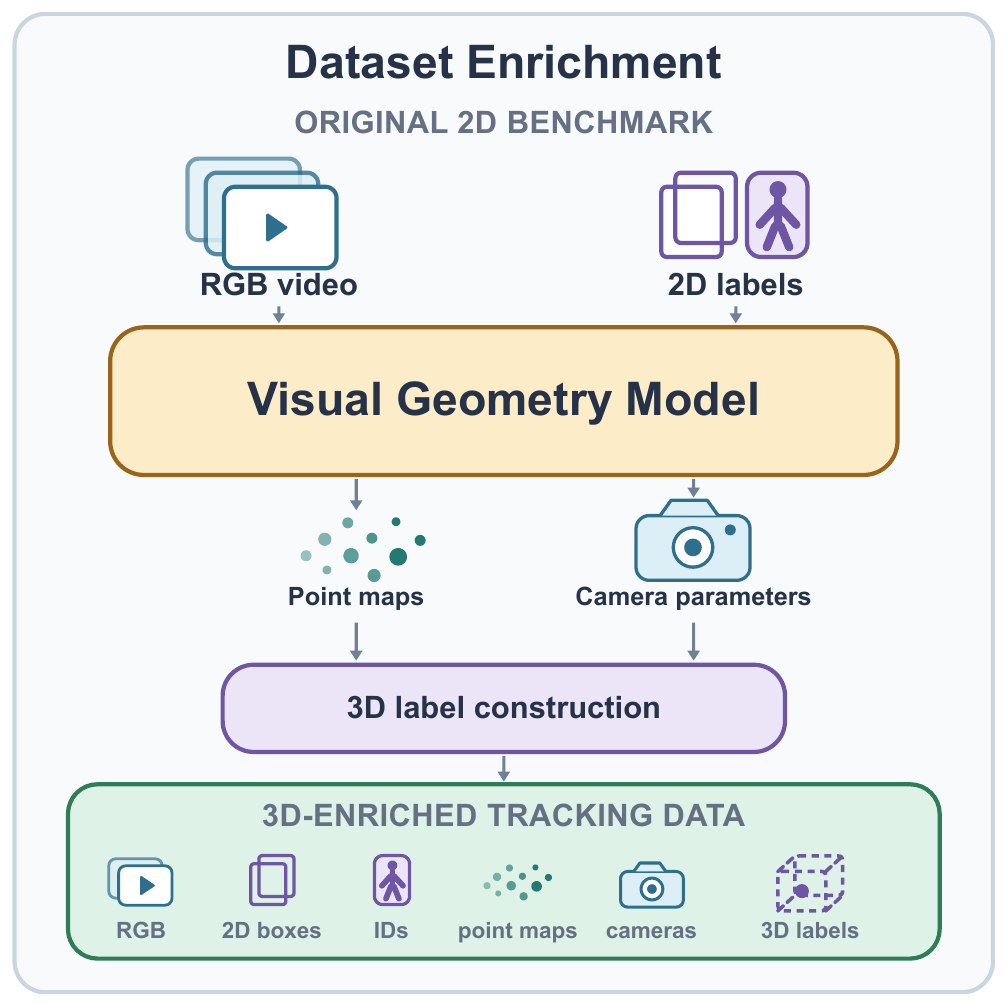
DanceTrack、SportsMOT、BFT 这些数据集,都只有 2D 的框。第一步是把它们变成 3D。
作者用 Depth Anything 3 的长序列版本处理整段视频:以彼此重叠的时间窗估计深度和相机参数,再用回环闭合限制长时间累积的漂移。估出来的深度和相机参数反投影之后,每一帧的每个像素都对应到世界坐标里的一个点,这叫做点云图。
点云图是整个场景的,还不知道哪些点属于哪个人。作者为每个标注的 2D 框,取框内点云的平均位置,作为这个物体的 3D 中心:
- 完全没被挡住的框,直接采用。
- 被挡住的框,框内混着前景和背景,作者综合前后帧的深度、这一帧的深度和框在画面上的位置,保守地判断哪一部分才是这个物体。
- 沿着同一条轨迹检查前后是否一致。还是拿不准的,就标成无效,不拿来训练。
这些 3D 中心只有位置,没有物体的大小和朝向,是估计出来的「伪标签」。
让查询在形成时就看到 3D
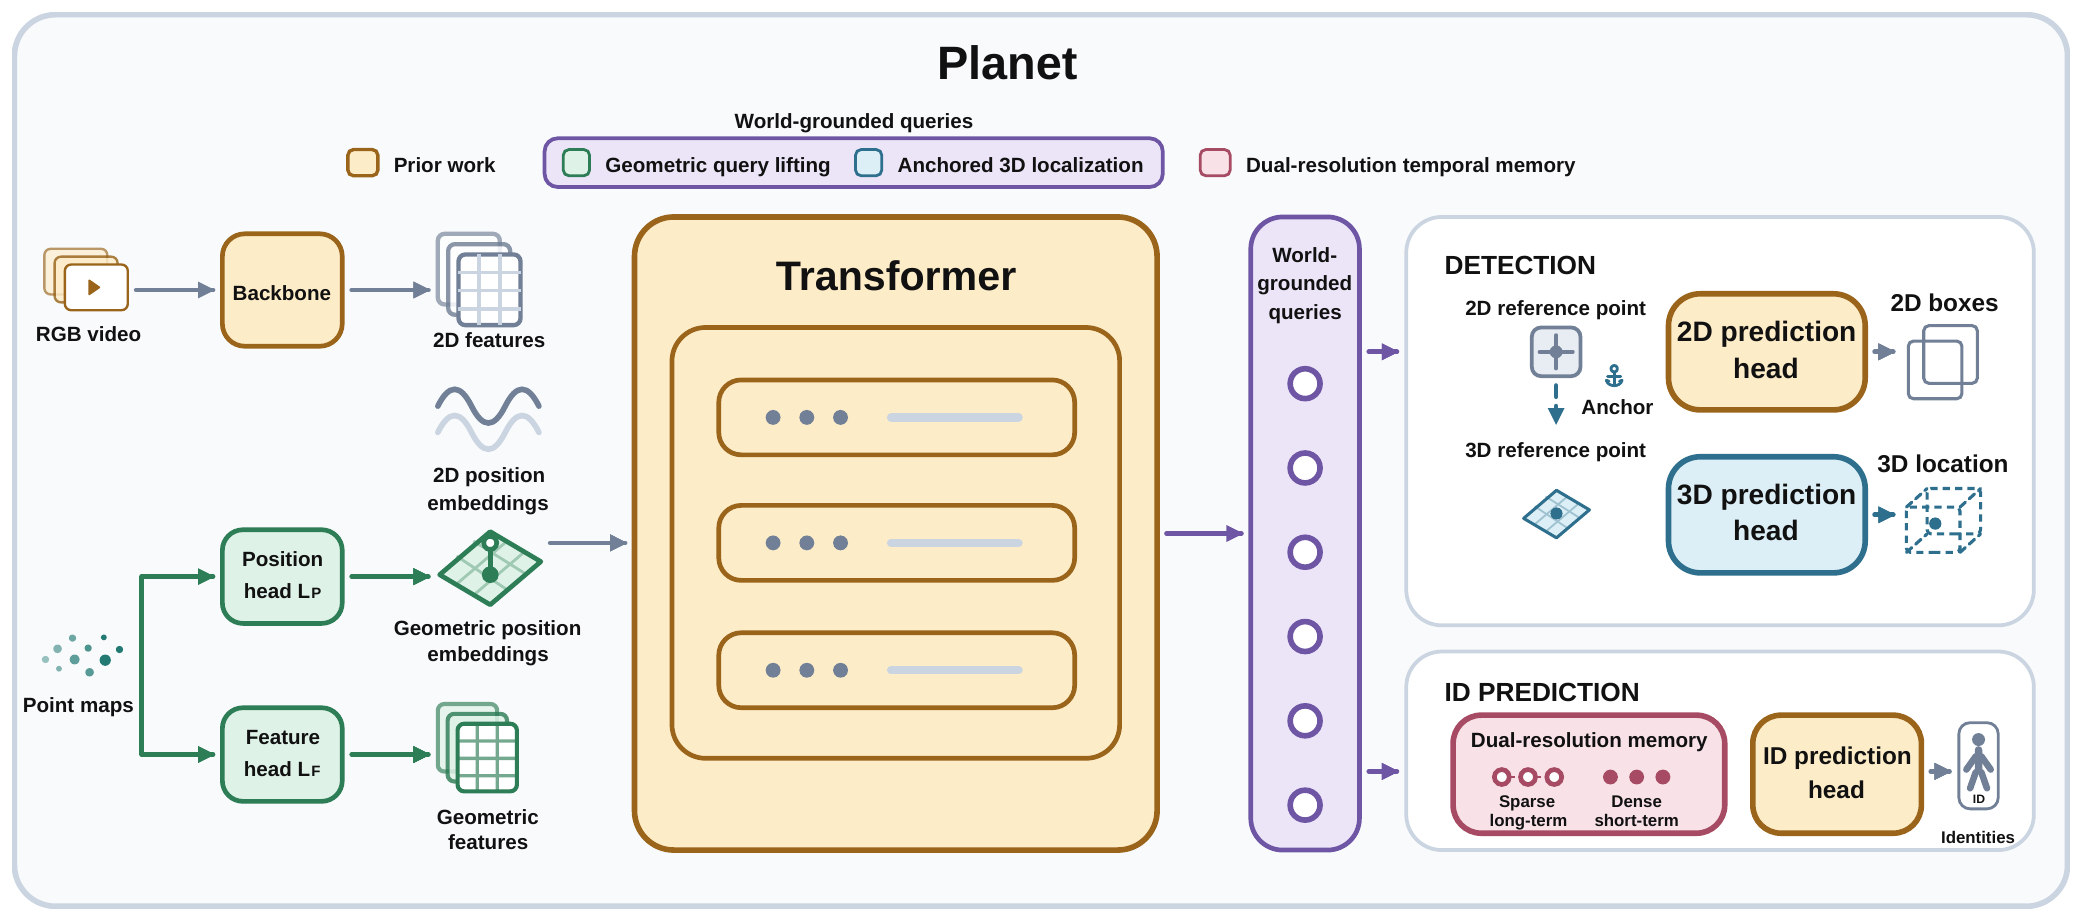
PLANET 建立在 MOTIP 上。MOTIP 的特点是检测和身份预测共用同一组查询:每个查询既要输出框,也要预测这个框属于哪个 ID。所以只要让查询包含 3D 信息,检测和关联两边都受益。
作者用两个做法把 3D 带进查询。
几何查询提升。 点云图经过两个可学习的小网络。一个生成几何特征,直接加到骨干网络的图像特征上;另一个生成几何位置嵌入,和原本的 2D 位置编码拼接后再融合。Transformer 在更新查询时,看到的特征和位置都带有场景的立体结构。
锚定的 3D 定位。 Deformable DETR 的每个查询都有一个 2D 参考点,用来引导框的预测。作者把这个 2D 参考点,通过点云图提升成对应的 3D 参考点,再让一个小的 3D 预测头从查询预测一个残差,修正出物体的 3D 中心。这个预测用前面建立的 3D 伪标签监督,是一个辅助任务。
辅助任务的目的,是逼查询把物体在立体空间中的位置记在自己身上。两个人在画面上重叠,但一个在前、一个在后,它们的查询就应该带着不同的 3D 位置。
为什么要「锚定」在 2D 参考点上,而不是另外学一个独立的 3D 参考点?因为骨干网络和检测器已经在大量 2D 数据上学到很好的定位能力。从 2D 参考点出发,3D 定位只需要学一个修正量,不必从头学起。
双分辨率记忆:用同样的槽位看更远
3D 信息能帮忙认回被挡住的人,前提是跟踪器还记得这个人。PLANET 的第三个设计,是在不增加记忆容量的情况下,拉长能回头看的时间。
做法是把记忆分成两半。一半留给最近的连续几帧,保留短时间内的细节;另一半留给更早的历史,每隔几帧才取一帧。训练时也随机改变采样的间隔,让模型习惯看到间隔不一的过去。
论文没有给出具体的容量和间隔,只说可见范围从 MOTIP 的 30 帧延长到大约 200 帧。我们用一组假设的数字感受一下:
| 做法 | 记忆槽位 | 最近的连续帧 | 更早的采样 | 能看到多远 |
|---|---|---|---|---|
| 全部连续 | 30 | 30 | — | 30 帧 |
| 双分辨率 | 30 | 15 | 15 个,每 12 帧取 1 个 | 15 + 15 × 12 = 195 帧 |
本文整理的算例;容量 30 与 MOTIP 的 30 帧相同,采样间隔 12 为假设值。
记忆里存的是检测器最后输出的查询,已经带有 3D 信息,所以这段延长的记忆也一并保存了立体的线索。这个改动不需要额外的训练时间。
讨论
每个设计的贡献
| 设置 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| MOTIP 基线 | 63.0 | 53.2 | 75.0 | 66.6 |
| +几何查询提升 | 64.0 | 54.3 | 75.9 | 67.6 |
| +锚定的 3D 定位 | 64.4 | 54.9 | 76.1 | 67.8 |
| +双分辨率记忆 | 65.6 | 56.9 | 76.1 | 70.3 |
整理自原论文 Table 1;每个设置训练 5 次取平均。
几何查询提升让检测和关联都进步,DetA 和 AssA 各多了约 1 分。锚定的 3D 定位主要帮关联,AssA 多 0.6、DetA 只多 0.2。双分辨率记忆则完全作用在关联上,DetA 没动,AssA 多了 2 分,IDF1 多了 2.5。
作者还检查了记忆和 3D 的相互作用。同样加上双分辨率记忆,只有 2D 的模型 IDF1 多 1.5;有 3D 的模型多 2.5。立体的线索比较稳定,记得越久越有用。
3D 要怎么放进去
| 做法 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTIP 基线 | 63.0 | 53.2 | 66.6 |
| 直接融合 Depth Anything 3 的特征 | 63.1 | 53.1 | 66.6 |
| 世界锚定查询 | 64.4 | 54.9 | 67.8 |
整理自原论文 Table 4。
最直觉的做法,是把 3D 基础模型的特征直接接进跟踪器。结果几乎没有帮助,HOTA 只多 0.1,AssA 和 IDF1 没有进步。那些特征是为了估计几何而训练的,跟踪器不知道该怎么用。
另一组对照在 3D 定位上。同样的 3D 监督,如果让 3D 预测头用一个独立学出来的 3D 参考点,HOTA 反而从 64.0 掉到 63.8;锚定在 2D 参考点上,才升到 64.4。
3D 信息本身有用,但要让它在查询形成时有明确的位置、在训练目标里有明确的任务,跟踪器才用得上。
三个数据集
| 数据集 | MOTIP | PLANET | AssA:MOTIP → PLANET |
|---|---|---|---|
| DanceTrack | 69.6 | 72.1 | 60.4 → 63.9 |
| SportsMOT | 72.6 | 73.7 | 63.2 → 63.2 |
| BFT | 70.5 | 72.6 | 71.8 → 73.9 |
HOTA;DanceTrack 整理自原论文 Table 5,SportsMOT 整理自原论文 Table 6,BFT 整理自原论文 Table 7,均为测试集。
三个数据集都是第一,而且每个数据集只用它自己的训练数据,没有用 CrowdHuman 这类额外数据。比较表里有些方法用了额外数据。
DanceTrack 上进步最多,关联的 AssA 多了 3.5,IDF1 从 74.7 到 78.0。舞者穿得一样、不停交错,正是平面上最容易混淆的场景。SportsMOT 上,AssA 和 MOTIP 一样是 63.2,进步全在检测:DetA 从 83.5 到 86.0,MOTA 从 92.4 到 95.2。
同一群作者一年前的 NOOUGAT,在 DanceTrack 上离线版本的 HOTA 是 68.4,不在这篇的比较表里。两者走的路线不同:NOOUGAT 用现成的检测器、专注于学关联;PLANET 是端到端的,检测和关联一起受益于 3D。
还没交代的事
这是一篇刚上 arXiv 的论文,还没有正式发表,代码和 3D 化的数据集都说要等论文被接收后才发布。
论文没有局限性的章节,有几件事读者可能会想知道。推理时,PLANET 需要每一帧的点云图,也就是要先跑一次 Depth Anything 3。论文报告的速度是 FP32 每秒 12 帧、FP16 每秒 20 帧,和 MOTIP 相当,但没有说明是否包含这一步的时间。3D 伪标签的质量也取决于几何模型,论文说明了如何过滤不确定的标签,但没有评估这些标签有多准。另外,消融实验用的是哪个数据集的哪个划分,论文也没有明说。
结论
既然现在可以从普通视频估出场景的立体结构,PLANET 就试着把它放进跟踪器里。
做法上有三个重点。先把现有的 2D 数据集提升成 3D,得到点云图和每个框的 3D 中心。再让 3D 信息在查询形成时就进来,并用一个锚定在 2D 参考点上的辅助任务,逼查询记住物体的立体位置。最后用双分辨率记忆,在同样的容量下把能回头看的时间拉长到大约 200 帧。
消融里最有意思的一组对照,是直接接上 3D 基础模型的特征几乎没用。3D 信息要放在跟踪器真正会用到的地方,才能发挥作用。