原始論文
Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2609.00924
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingplanet2026,
  title = {{Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking}},
  author = {Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2026},
  eprint = {2609.00924},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.00924}
}
攝影機把立體的世界拍成平面的畫面。前後站著的兩個人,在畫面上疊在一起;一個人朝鏡頭走來,在畫面上只是框變大了一點。深度、前後、真正的移動方向,都在投影時被壓扁了。
追蹤器看到的,也只有這個平面。不論是比外觀、比框的重疊,還是預測框的移動,全部在影像平面上進行,也就一併繼承了這些歧義。
這一兩年,VGGT、Depth Anything 3 這類幾何基礎模型,已經能從一段普通影片直接估出整個場景的立體結構和相機參數。SUSHI、NOOUGAT 的作者群(Orcun Cetintas、Guillem Brasó、Tim Meinhardt、Laura Leal-Taixé)想試試看,把這些估出來的 3D 資訊放進追蹤器,會不會讓它看得更清楚。
定義問題
把 3D 資訊用在追蹤,其實早有人做過。有的方法估計行人的可見程度來推理遮擋,有的把軌跡轉到世界座標,有的用 3D 人體模型。也有方法在卡爾曼濾波裡加入深度約束,或在鳥瞰圖上預測軌跡。
作者指出,這些做法裡的 3D 資訊要嘛綁定特定類別,例如只適用於行人;要嘛在物體表示已經形成之後,才在關聯階段當作額外的規則或成本加進去。追蹤器內部的物體表示,仍然只有 2D。
另一個問題是時間。用查詢追蹤的端到端方法,訓練時通常只看 2 到 10 幀,推論時能回頭看的範圍也有限;PLANET 所依據的 MOTIP,可以看過去 30 幀,在一般的影片裡只有一兩秒。被擋得更久的人,就超出了它的記憶。
PLANET 要做的,是讓 3D 資訊在查詢形成的時候就進來,並讓這些資訊在更長的時間範圍內都用得上。
解決問題
先把資料集變成 3D
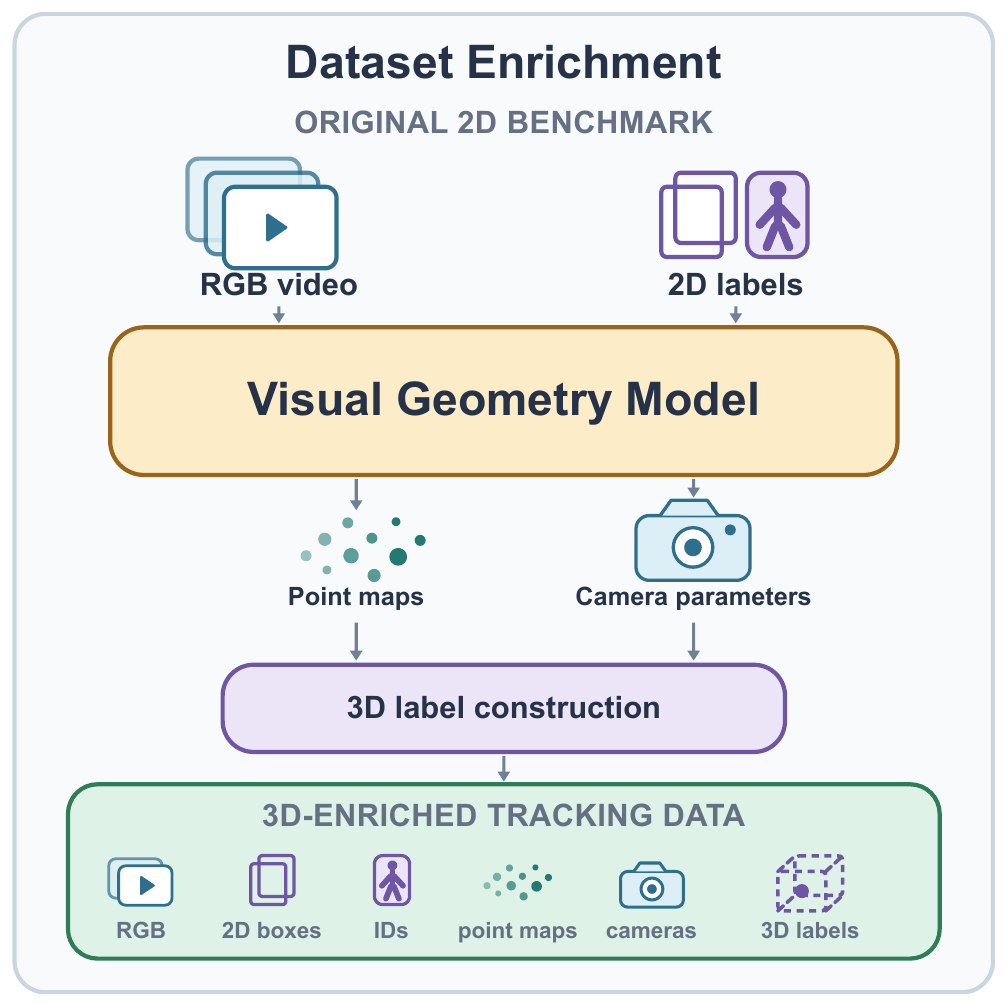
DanceTrack、SportsMOT、BFT 這些資料集,都只有 2D 的框。第一步是把它們變成 3D。
作者用 Depth Anything 3 的長序列版本處理整段影片:以彼此重疊的時間窗估計深度和相機參數,再用迴圈閉合限制長時間累積的漂移。估出來的深度和相機參數反投影之後,每一幀的每個像素都對應到世界座標裡的一個點,這叫做點雲圖。
點雲圖是整個場景的,還不知道哪些點屬於哪個人。作者為每個標註的 2D 框,取框內點雲的平均位置,當作這個物體的 3D 中心:
- 完全沒被擋住的框,直接採用。
- 被擋住的框,框內混著前景和背景,作者綜合前後幀的深度、這一幀的深度和框在畫面上的位置,保守地判斷哪一部分才是這個物體。
- 沿著同一條軌跡檢查前後是否一致。還是拿不準的,就標成無效,不拿來訓練。
這些 3D 中心只有位置,沒有物體的大小和朝向,是估計出來的「偽標籤」。
讓查詢在形成時就看到 3D
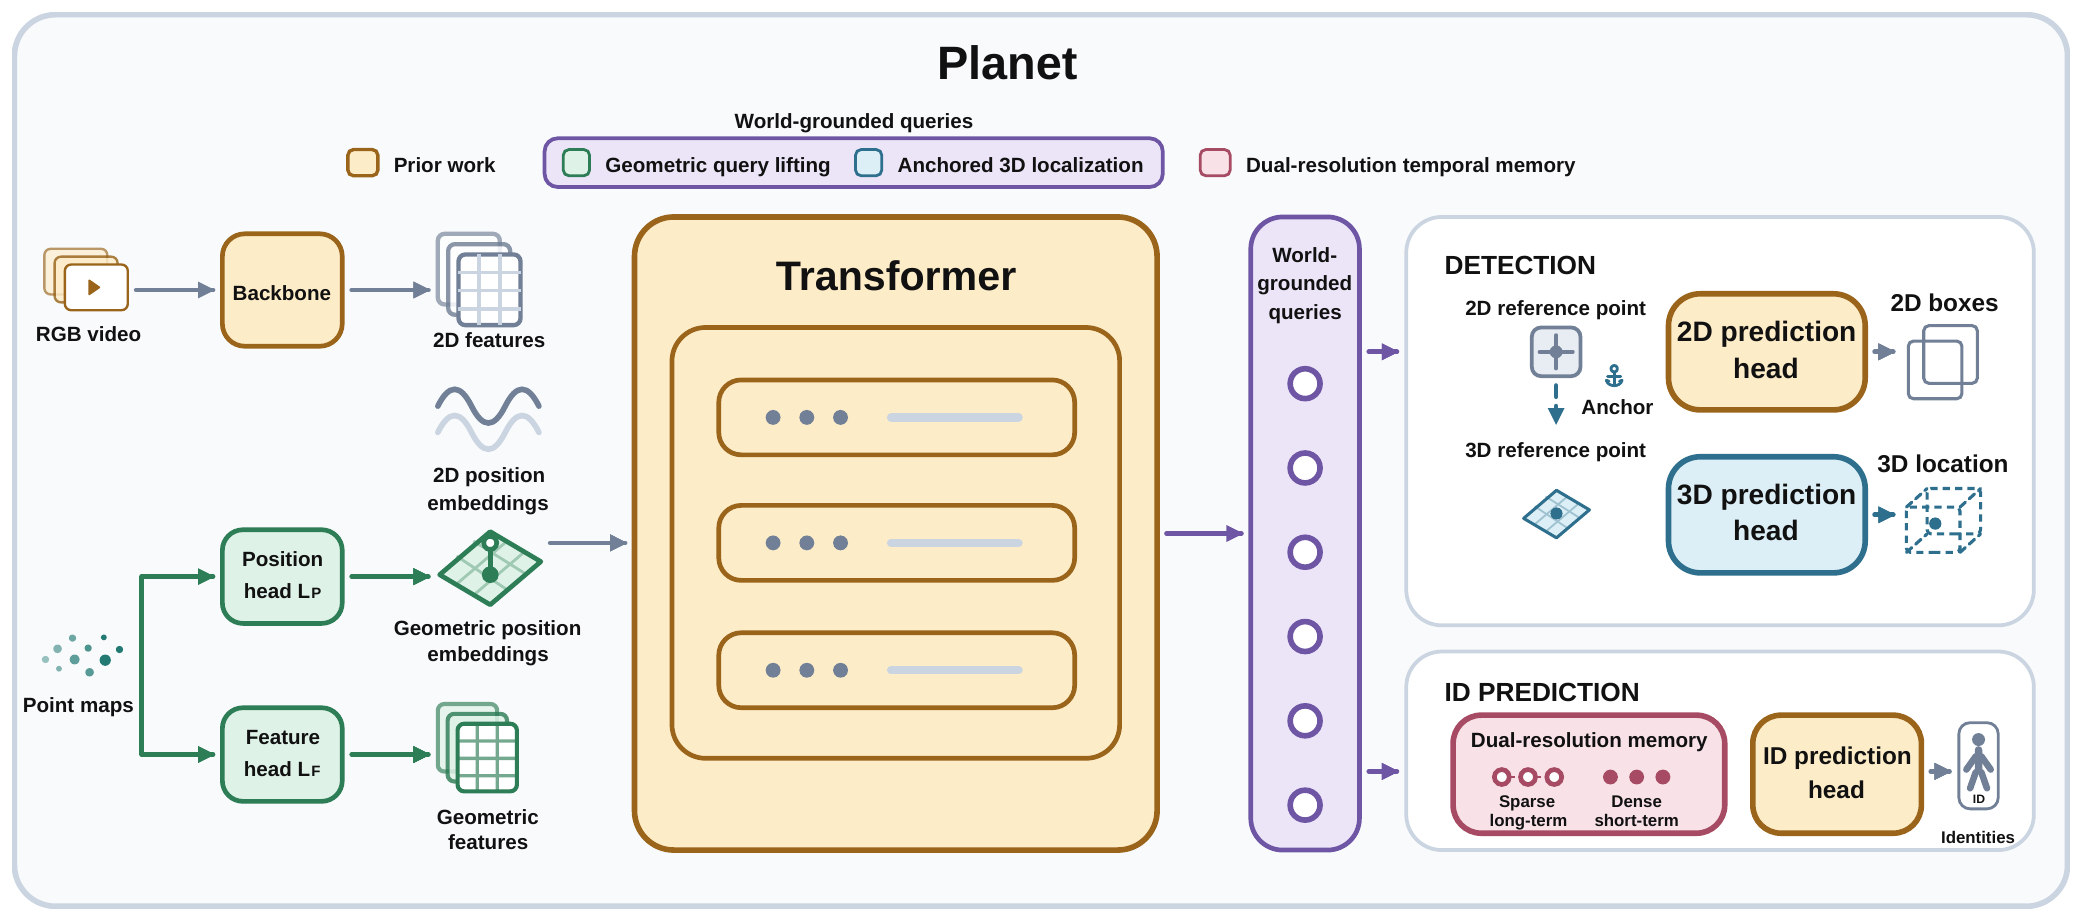
PLANET 建立在 MOTIP 上。MOTIP 的特點是偵測和身分預測共用同一組查詢:每個查詢既要輸出框,也要預測這個框屬於哪個 ID。所以只要讓查詢包含 3D 資訊,偵測和關聯兩邊都受益。
作者用兩個做法把 3D 帶進查詢。
幾何查詢提升。 點雲圖經過兩個可學的小網路。一個產生幾何特徵,直接加到骨幹網路的影像特徵上;另一個產生幾何位置嵌入,和原本的 2D 位置編碼串接後再融合。Transformer 在更新查詢時,看到的特徵和位置都帶有場景的立體結構。
錨定的 3D 定位。 Deformable DETR 的每個查詢都有一個 2D 參考點,用來引導框的預測。作者把這個 2D 參考點,透過點雲圖提升成對應的 3D 參考點,再讓一個小的 3D 預測頭從查詢預測一個殘差,修正出物體的 3D 中心。這個預測用前面建立的 3D 偽標籤監督,是一個輔助任務。
輔助任務的目的,是逼查詢把物體在立體空間中的位置記在自己身上。兩個人在畫面上重疊,但一個在前、一個在後,它們的查詢就應該帶著不同的 3D 位置。
為什麼要「錨定」在 2D 參考點上,而不是另外學一個獨立的 3D 參考點?因為骨幹網路和偵測器已經在大量 2D 資料上學到很好的定位能力。從 2D 參考點出發,3D 定位只需要學一個修正量,不必從頭學起。
雙解析度記憶:用同樣的位子看更遠
3D 資訊能幫忙認回被擋住的人,前提是追蹤器還記得這個人。PLANET 的第三個設計,是在不增加記憶容量的情況下,拉長能回頭看的時間。
做法是把記憶分成兩半。一半留給最近的連續幾幀,保留短時間內的細節;另一半留給更早的歷史,每隔幾幀才取一幀。訓練時也隨機改變取樣的間隔,讓模型習慣看到間隔不一的過去。
論文沒有給出具體的容量和間隔,只說可見範圍從 MOTIP 的 30 幀延長到大約 200 幀。我們用一組假設的數字感受一下:
| 做法 | 記憶位子 | 最近的連續幀 | 更早的取樣 | 能看到多遠 |
|---|---|---|---|---|
| 全部連續 | 30 | 30 | — | 30 幀 |
| 雙解析度 | 30 | 15 | 15 個,每 12 幀取 1 個 | 15 + 15 × 12 = 195 幀 |
本文整理的算例;容量 30 與 MOTIP 的 30 幀相同,取樣間隔 12 為假設值。
記憶裡存的是偵測器最後輸出的查詢,已經帶有 3D 資訊,所以這段延長的記憶也一併保存了立體的線索。這個改動不需要額外的訓練時間。
討論
每個設計的貢獻
| 設定 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| MOTIP 基準 | 63.0 | 53.2 | 75.0 | 66.6 |
| +幾何查詢提升 | 64.0 | 54.3 | 75.9 | 67.6 |
| +錨定的 3D 定位 | 64.4 | 54.9 | 76.1 | 67.8 |
| +雙解析度記憶 | 65.6 | 56.9 | 76.1 | 70.3 |
整理自原論文 Table 1;每個設定訓練 5 次取平均。
幾何查詢提升讓偵測和關聯都進步,DetA 和 AssA 各多了約 1 分。錨定的 3D 定位主要幫關聯,AssA 多 0.6、DetA 只多 0.2。雙解析度記憶則完全作用在關聯上,DetA 沒動,AssA 多了 2 分,IDF1 多了 2.5。
作者還檢查了記憶和 3D 的交互作用。同樣加上雙解析度記憶,只有 2D 的模型 IDF1 多 1.5;有 3D 的模型多 2.5。立體的線索比較穩定,記得越久越有用。
3D 要怎麼放進去
| 做法 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTIP 基準 | 63.0 | 53.2 | 66.6 |
| 直接融合 Depth Anything 3 的特徵 | 63.1 | 53.1 | 66.6 |
| 世界錨定查詢 | 64.4 | 54.9 | 67.8 |
整理自原論文 Table 4。
最直覺的做法,是把 3D 基礎模型的特徵直接接進追蹤器。結果幾乎沒有幫助,HOTA 只多 0.1,AssA 和 IDF1 沒有進步。那些特徵是為了估計幾何而訓練的,追蹤器不知道該怎麼用。
另一組對照在 3D 定位上。同樣的 3D 監督,如果讓 3D 預測頭用一個獨立學出來的 3D 參考點,HOTA 反而從 64.0 掉到 63.8;錨定在 2D 參考點上,才升到 64.4。
3D 資訊本身有用,但要讓它在查詢形成時有明確的位置、在訓練目標裡有明確的任務,追蹤器才用得上。
三個資料集
| 資料集 | MOTIP | PLANET | AssA:MOTIP → PLANET |
|---|---|---|---|
| DanceTrack | 69.6 | 72.1 | 60.4 → 63.9 |
| SportsMOT | 72.6 | 73.7 | 63.2 → 63.2 |
| BFT | 70.5 | 72.6 | 71.8 → 73.9 |
HOTA;DanceTrack 整理自原論文 Table 5,SportsMOT 整理自原論文 Table 6,BFT 整理自原論文 Table 7,皆為測試集。
三個資料集都是第一,而且每個資料集只用它自己的訓練資料,沒有用 CrowdHuman 這類額外資料。比較表裡有些方法用了額外資料。
DanceTrack 上進步最多,關聯的 AssA 多了 3.5,IDF1 從 74.7 到 78.0。舞者穿得一樣、不停交錯,正是平面上最容易混淆的場景。SportsMOT 上,AssA 和 MOTIP 一樣是 63.2,進步全在偵測:DetA 從 83.5 到 86.0,MOTA 從 92.4 到 95.2。
同一群作者一年前的 NOOUGAT,在 DanceTrack 上離線版本的 HOTA 是 68.4,不在這篇的比較表裡。兩者走的路線不同:NOOUGAT 用現成的偵測器、專注在學關聯;PLANET 是端到端的,偵測和關聯一起受益於 3D。
還沒交代的事
這是一篇剛上 arXiv 的論文,還沒有發表處,程式和 3D 化的資料集都說要等論文被接受後才釋出。
論文沒有限制的章節,有幾件事讀者可能會想知道。推論時,PLANET 需要每一幀的點雲圖,也就是要先跑一次 Depth Anything 3。論文報告的速度是 FP32 每秒 12 幀、FP16 每秒 20 幀,和 MOTIP 相當,但沒有說明是否包含這一步的時間。3D 偽標籤的品質也取決於幾何模型,論文說明了如何過濾不確定的標籤,但沒有評估這些標籤有多準。另外,消融實驗用的是哪個資料集的哪個切分,論文也沒有明講。
結論
既然現在可以從普通影片估出場景的立體結構,PLANET 就試著把它放進追蹤器裡。
做法上有三個重點。先把現有的 2D 資料集提升成 3D,得到點雲圖和每個框的 3D 中心。再讓 3D 資訊在查詢形成時就進來,並用一個錨定在 2D 參考點上的輔助任務,逼查詢記住物體的立體位置。最後用雙解析度記憶,在同樣的容量下把能回頭看的時間拉長到大約 200 幀。
消融裡最有意思的一組對照,是直接接上 3D 基礎模型的特徵幾乎沒用。3D 資訊要放在追蹤器真正會用到的地方,才能發揮作用。