原始论文
NOOUGAT: Towards Unified Online and Offline Multi-Object Tracking
- arXiv 首次提交
- arXiv:2509.02111
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingnoougat2025,
  title = {{NOOUGAT: Towards Unified Online and Offline Multi-Object Tracking}},
  author = {Benjamin Missaoui and Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2025},
  eprint = {2509.02111},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02111}
}
跟踪器向来分成两派。在线跟踪器一帧一帧处理,只能看过去,自动驾驶、安防监控都需要这种;离线跟踪器可以看整段视频,前后对照,适合标注数据、事后分析比赛。
两派的方法也长得完全不一样。在线这边是 SORT、ByteTrack 这一路,关联靠人写的规则:先配高分框、再配低分框,外观和运动各给多少权重。离线那边则是 MPNTrack、SUSHI 这类图神经网络,关联是学出来的,成绩也好,但只能处理固定长度的片段。
可是实际的应用,延迟需求不是只有「马上」和「不限」两种。远程手术可以等两百毫秒,航拍无人机一秒只拍一两张,可以累积好几十帧再一起处理。
这篇的作者群包括 SUSHI 的三位作者和 TrackFormer 的一作 Tim Meinhardt,一作是 Benjamin Missaoui,论文上的单位都是 NVIDIA。他们想做一个跟踪器,愿意等多久都可以:等一帧就是在线跟踪,等两百多帧就是离线跟踪,中间任何长度都行。名字取作 NOOUGAT,念起来就是牛轧糖。
定义问题
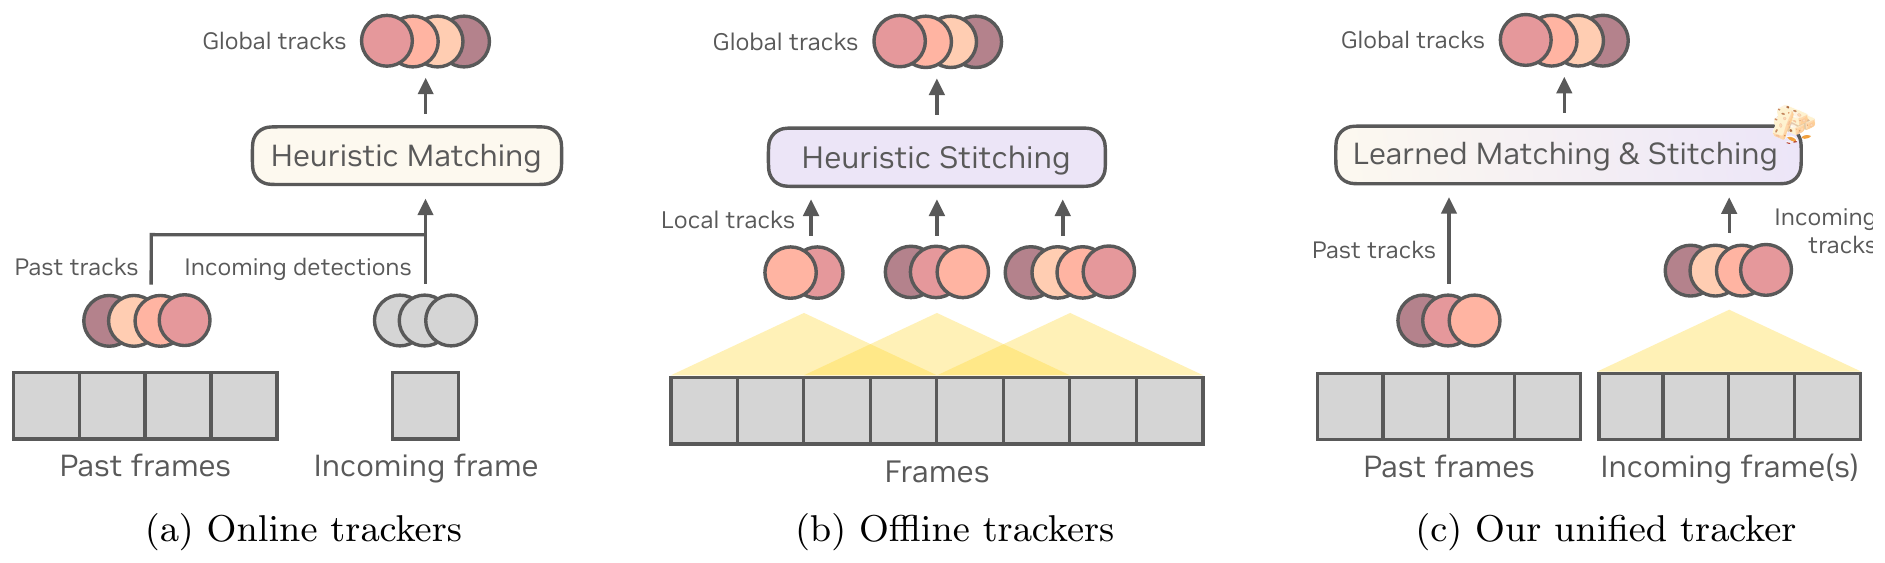
作者指出两派各自的毛病。
在线跟踪器的关联靠规则,规则的参数要按数据集调。HybridSORT 的外观权重,在 DanceTrack 是 4.0,在 MOT17 是 1.3,在 MOT20 是 4.6,还会随检测置信度再变。这些规则也很难处理长时间的遮挡,大部分方法一条轨迹断掉 30 帧就放弃了。
离线跟踪器的图网络很强,但它假设一段视频可以一次处理完。视频太长时,只好切成彼此重叠的片段,各自处理后,在重叠区用匈牙利算法或线性规划缝起来。这一步又回到了规则,而且重叠的部分要算好几次。
算一下就知道重复有多少。一段 1,024 帧的视频:
| 方法 | 每段长度 | 每次前移 | 段数 | 总共处理的帧数 |
|---|---|---|---|---|
| MPNTrack | 15 | 1 | 1,010 | 15,150 |
| SUSHI | 512 | 256 | 3 | 1,536 |
| NOOUGAT | 256 | 256 | 4 | 1,024 |
本文整理的算例;MPNTrack 和 SUSHI 的设置取自论文第 4.1 节。
MPNTrack 每一帧几乎要算 15 次,SUSHI 算 1.5 次,NOOUGAT 每帧只算一次。
解决问题
切成不重叠的段,一段一段接上去
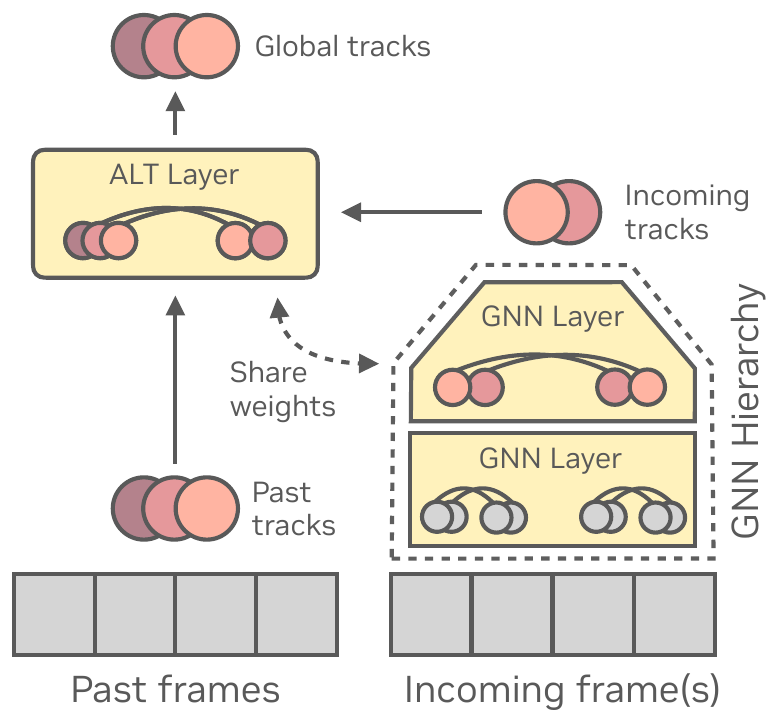
NOOUGAT 把视频切成彼此不重叠、每段 帧的子片段。每一段先用 SUSHI 那一套 GNN 层级处理,得到这一段内部的 tracklet。
接着,一个新的 ALT 层(autoregressive long-term tracking)把「到目前为止的轨迹」和「新来这一段的 tracklet」接起来:
接完的结果,再和下一段接,一路滚下去。
ALT 本身也是一层图网络。过去的每条轨迹是一个节点,新来的每条 tracklet 也是一个节点,每条过去的轨迹连到最近的 10 条新 tracklet。和 SUSHI 的每一层一样,网络判断每条边是不是同一个人,再取整成配对。
缝合这件事,从人写的规则换成了学出来的图网络。ALT 还和 GNN 层级共享权重,作者发现这让训练快了一倍多,大约 4 万次迭代就收敛,原本要 9 万次。
一个参数,从在线到离线
是 NOOUGAT 最重要的参数。
时,每段只有一帧,GNN 层级派不上用场,ALT 直接把过去的轨迹和这一帧的检测接起来,这就是一个逐帧的在线跟踪器。这时作者还把图限制成二分图:只有过去的轨迹和新来的检测之间有边,过去已经做的决定不能再改,符合在线跟踪的规矩。
越大,每一段里的 GNN 层级能看的时间越长,判断越有把握,代价是要等更多帧才能输出。离线设置用的是 ,而且允许修正过去的关联。
以 30 FPS 的视频来说,每多等一帧,延迟就多 33 毫秒。作者对照了几种应用:
| 应用 | 可接受的延迟 | 对应的 |
|---|---|---|
| 自动驾驶 | 100 毫秒以内 | 1–2 |
| 安防监控 | 约 125 毫秒 | 3–4 |
| 远程手术 | 200 毫秒最佳,300 毫秒上限 | 6–9 |
| 航拍跟踪 | 拍摄本身只有 1–2 FPS | 15–30 |
| 标注、体育分析 | 不限 | 任意 |
整理自原论文第 5.4 节。
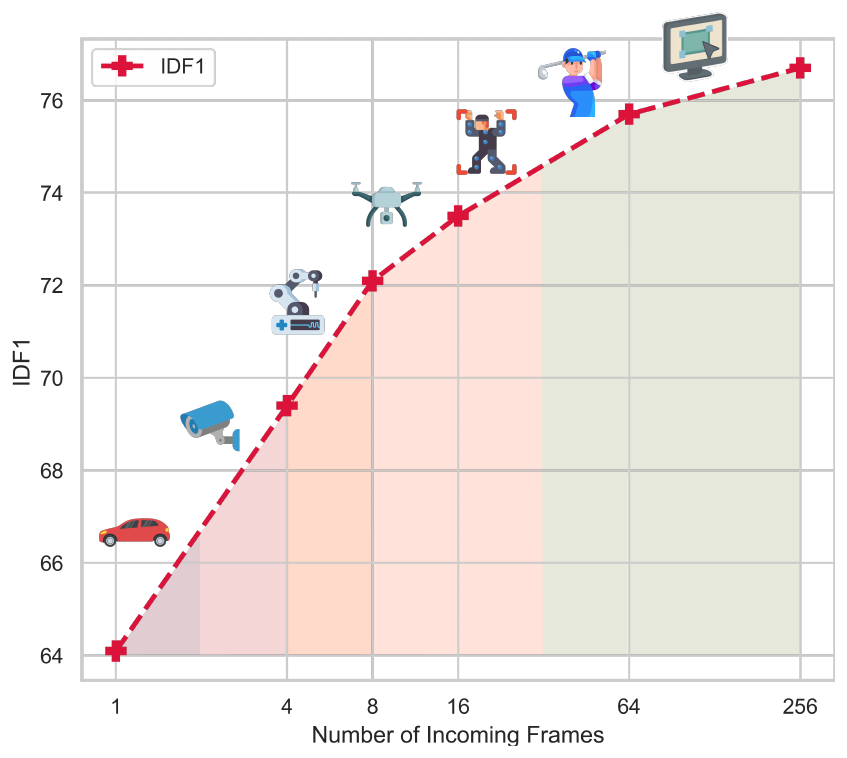
同一个模型架构,愿意多等一点,就换到多一点准确度。 从 1 到 8,IDF1 涨了大约 8 分,之后涨势趋缓,到 256 帧约 77。
特征和训练
输入特征沿用 SUSHI 的几何、运动和外观,另外加了两样在线跟踪器常用的东西。一是 OC-SORT 的速度方向一致性,原本是比较一条轨迹和一个检测框,作者扩展成比较两条 tracklet:前一条最后 12 个框的行进方向,和后一条前 12 个框反推回去的方向,夹角越小越可能是同一个人。二是检测置信度,放进节点的初始特征。
训练 ALT 的难处在于,推理时它要处理的「过去轨迹」千变万化,有长有短、有断有续。作者训练时随机截取一段过去的真值轨迹当输入,长度和起点都随机,再随机删掉一些轨迹和框;过去和新来之间还故意空几帧,模拟短暂的遮挡。
讨论
测试集
| 数据集 | 在线最强对手 | 对手 AssA | 在线 AssA | 离线 AssA |
|---|---|---|---|---|
| DanceTrack | Hybrid-SORT | 52.6 | 54.9 | 58.7 |
| SportsMOT | DiffMOT | 65.1 | 74.3 | 83.0 |
| MOT17 | DiffMOT | 64.6 | 65.3 | 68.5 |
| MOT20 | BoT-SORT | 62.9 | 67.5 | 70.7 |
DanceTrack 整理自原论文 Table 1,SportsMOT 整理自原论文 Table 2,MOT17 整理自原论文 Table 3,MOT20 整理自原论文 Table 4;均为测试集,对手取表中与 NOOUGAT 使用同一组检测、在线方法里 AssA 最高者。
比较的对象都用 ByteTrack 的 YOLOX 检测。在线版本在四个数据集的关联分数都是最高的,离线版本再往上加 3 到 9 分。SportsMOT 的进步最大,球员常常跑出画面又回来,这正是长时间关联最能发挥的地方。
离线版本在 MOT17、MOT20 的 HOTA 并不一定最高。MOT17 上 CoNo-Link 的 HOTA 是 67.1,NOOUGAT 是 66.9;作者的解释是 CoNo-Link 的检测比较强,MOTA 高了 2 分,NOOUGAT 赢在 AssA 和 IDF1。
学出来的比规则好多少
作者做了两个直接的对照。
- 配对。 在线设置下,把 ALT 换成匈牙利算法,代价用 HybridSORT 的权重组合外观、运动和速度方向,还在附近做了网格搜索。DanceTrack 验证集上,HOTA 从 64.6 掉到 62.1,IDF1 从 69.0 掉到 65.8。
- 缝合。 离线设置下,用和 NOOUGAT 相同的特征和 ReID 重新训练 SUSHI,保留它重叠片段加匈牙利缝合的做法。SUSHI 的 IDF1 是 72.0,NOOUGAT 是 76.6。
第二个对照特别有说服力,因为两者的图网络几乎一样,差别只在缝合是规则还是学出来的。
断了多久还接得回来
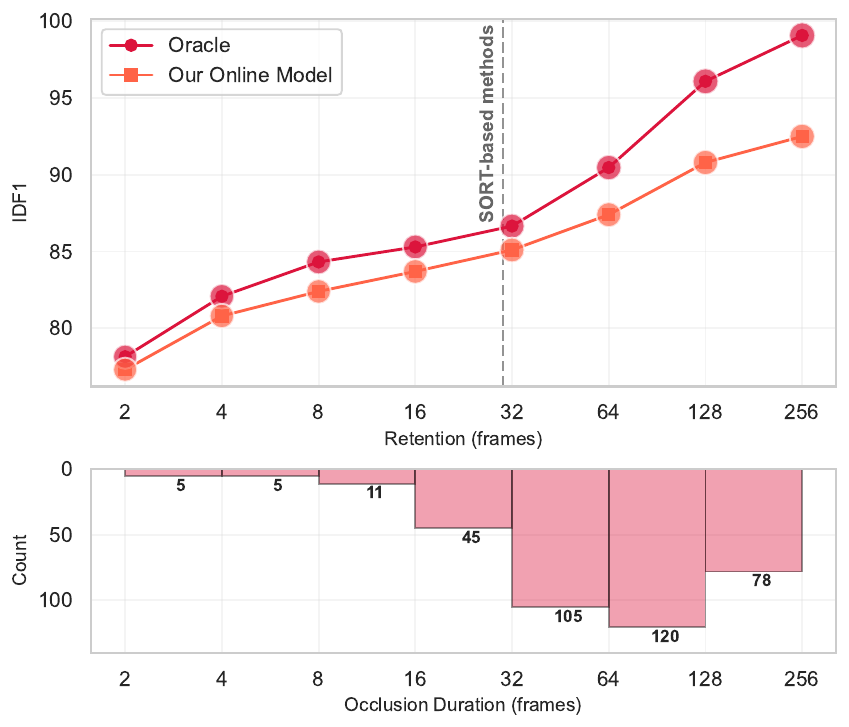
SportsMOT 里,长于 30 帧的遮挡才是大头。下半部的分布里,超过 32 帧的遮挡加起来有 303 次,比短于 32 帧的 66 次多得多。
SORT 系的跟踪器通常 30 帧就把轨迹丢掉。NOOUGAT 让轨迹保留得越久,IDF1 就越高,保留 256 帧时约 92。中间没有任何专门为长期遮挡设计的规则,全靠 ALT 自己学。
特征各自的作用
只给几何特征,HOTA 是 59.1;只给外观,反而只有 57.9;几何加运动 60.4;全部都给 64.6。DanceTrack 的舞者穿得一样,外观单独用不太可靠,但和其他线索合起来,又能帮忙解决模棱两可的情况。
速度和规模
在 V100 上、检测和 ReID 都事先算好的情况下,在线版本只有 12 FPS,离线版本反而有 340 FPS。原因是在线版本每一帧都要建一张新图,建图就占了将近一半的时间;离线版本一段 256 帧只要建 8 张图。作者也承认在线的实现还有很大的优化空间。论文另外估了理想条件下的速度(oracle runtime), 时已经到 37 FPS。
在最拥挤的 MOT20-05(1,154 个人、61 万个检测框)上,离线版本仍有 74 FPS。在 DanceTrack 验证集上,在线和离线()版本的显存占用都不到 6 GB。
在线模型可训练的参数只有 2.7 万个,MeMOTR 有 5,100 万个。NOOUGAT 只负责关联,检测交给现成的检测器,所以在 MOT17 这种训练数据很少的数据集上也不吃亏。
换到其他领域
作者另外在三个数据集上测试。蜜蜂跟踪的 BEE24,视频最长五千帧,NOOUGAT 的 HOTA 比次佳方法高 4.5。航拍车辆的 VETRA 一秒只有一帧,相邻两帧之间车子移动很远,NOOUGAT 比 BoT-SORT 高了 17.2 HOTA,但仍落后专门为这个数据集设计、用了车速和车辆大小先验的 Deep SR-SORT(82.2 对 68.0)。
在 MOT17 的公开检测上,优势则小了很多,离线版本的 IDF1 是 72.1,SUSHI 是 71.5。作者推测检测框噪声太多时,ALT 比较难学。
结论
NOOUGAT 做的事,是把 SUSHI 那套离线的图网络,改造成可以接受任意延迟的跟踪器。视频切成不重叠的段,每段用图网络处理,段与段之间再用另一层图网络接起来。原本离线方法里的缝合、在线方法里的配对,都换成了学出来的关联。
它的价值在于只要调 ,就能在延迟和准确度之间选一个点。等一帧,它是一个关联分数领先的在线跟踪器;等两百多帧,它是一个离线跟踪器;中间的每一个 ,也都是同一个模型。