原始论文
Multiple Object Tracking as ID Prediction
- 发表版本
- CVPR 2025会议
- arXiv 首次提交
- arXiv:2403.16848
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmotip2024,
  title = {{Multiple Object Tracking as ID Prediction}},
  author = {Ruopeng Gao and Ji Qi and Limin Wang},
  year = {2024},
  eprint = {2403.16848},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.16848}
}
读到这里,我们已经看过两大类跟踪器。
一类是先检测、再关联。检测交给专门的检测器,关联则靠人设计的规则:卡尔曼滤波预测位置,IoU 或外观距离算代价,匈牙利算法做匹配,再加上一堆阈值。这些规则在行人身上很好用,但每遇到一种新情境,就要有人分析、修改、重新调参。从 SORT 到 Deep OC-SORT,再到 C-BIoU、UCMCTrack,走的都是这条路。
另一类是端到端的 MOTR 系列,用一个轨迹查询在帧与帧之间传递,检测和跟踪一起在解码器里完成。关联不再靠人写规则,但两种查询挤在同一个解码器里会互相干扰,检测常常因此吃亏。MOTRv2 干脆把检测交还给 YOLOX。
南京大学的 Ruopeng Gao、王利民,和中国移动(苏州)软件技术公司的 Ji Qi 想知道,能不能保留「先检测、再关联」的分工,同时把关联整个交给模型去学。
他们的答案是 MOTIP。这是 Ruopeng Gao 继 MeMOTR 之后的下一篇,方法简单得出乎意料。
定义问题
关联看起来很像分类问题。训练数据里,每一条轨迹都有一个 ID,给定一个检测框,判断它属于哪一条轨迹,不就是预测它的 ID 吗?
问题出在推理。测试视频里出现的都是没见过的人,ID 也是新的,模型不可能把一个人分类到训练时从没出现过的类别。
所以像 FairMOT 这种方法,训练时虽然用分类损失来学外观特征,推理时却得换一套做法:把特征拿出来算余弦相似度,再用人写的规则匹配。训练和推理,做的其实是两件事。
作者认为,卡住的地方在于,跟踪的 ID 和一般分类的标签,本质上不一样。
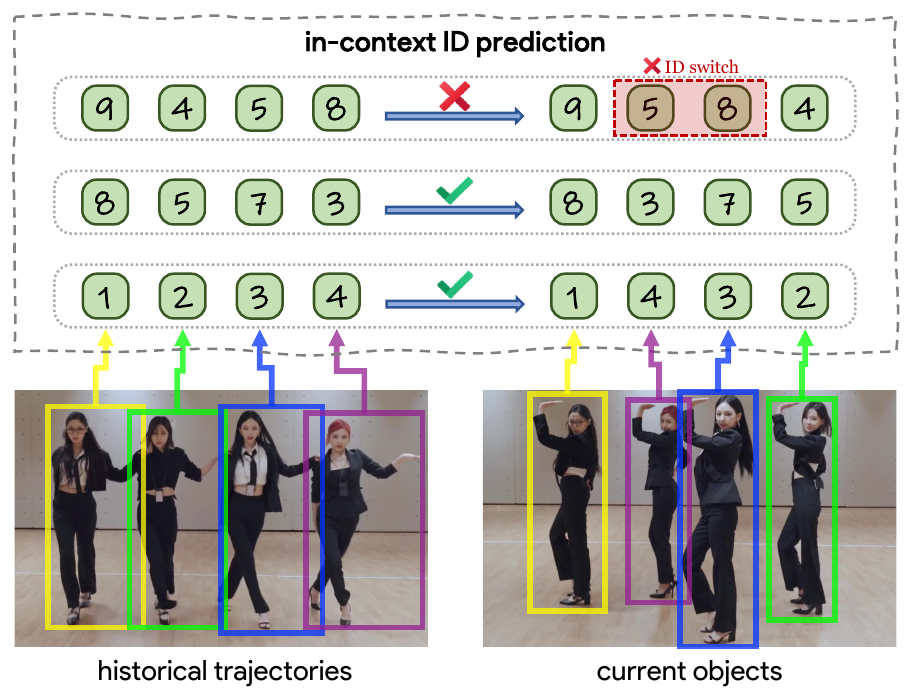
一般分类里的「猫」就是猫,标签有语义。跟踪的 ID 没有。真值文件里写着 1、2、3、4 的四个人,换成 8、5、7、3 也完全可以,只要每个人从头到尾都用同一个号码。ID 只是一张号码牌,代表「这几个框是同一个人」,号码本身是多少并不重要。
解决问题
上下文 ID 预测
既然号码本身不重要,就让模型看着「历史轨迹上挂的号码牌」,去预测新检测该拿哪一张。
具体来说,对过去的每一条轨迹 ,随机发给它一个号码 ,。新的一帧进来,如果某个检测属于第 条轨迹,正确答案就是 。
号码是发给轨迹的提示,所以作者称之为上下文 ID 预测(in-context ID prediction)。这样一来,不管测试时遇到多少新面孔,要预测的永远是 1 到 之间的号码,都在训练过的范围里。号码怎么发都可以,只要预测和历史一致就算对,Figure 1 的三行说的就是这件事。
三个组件
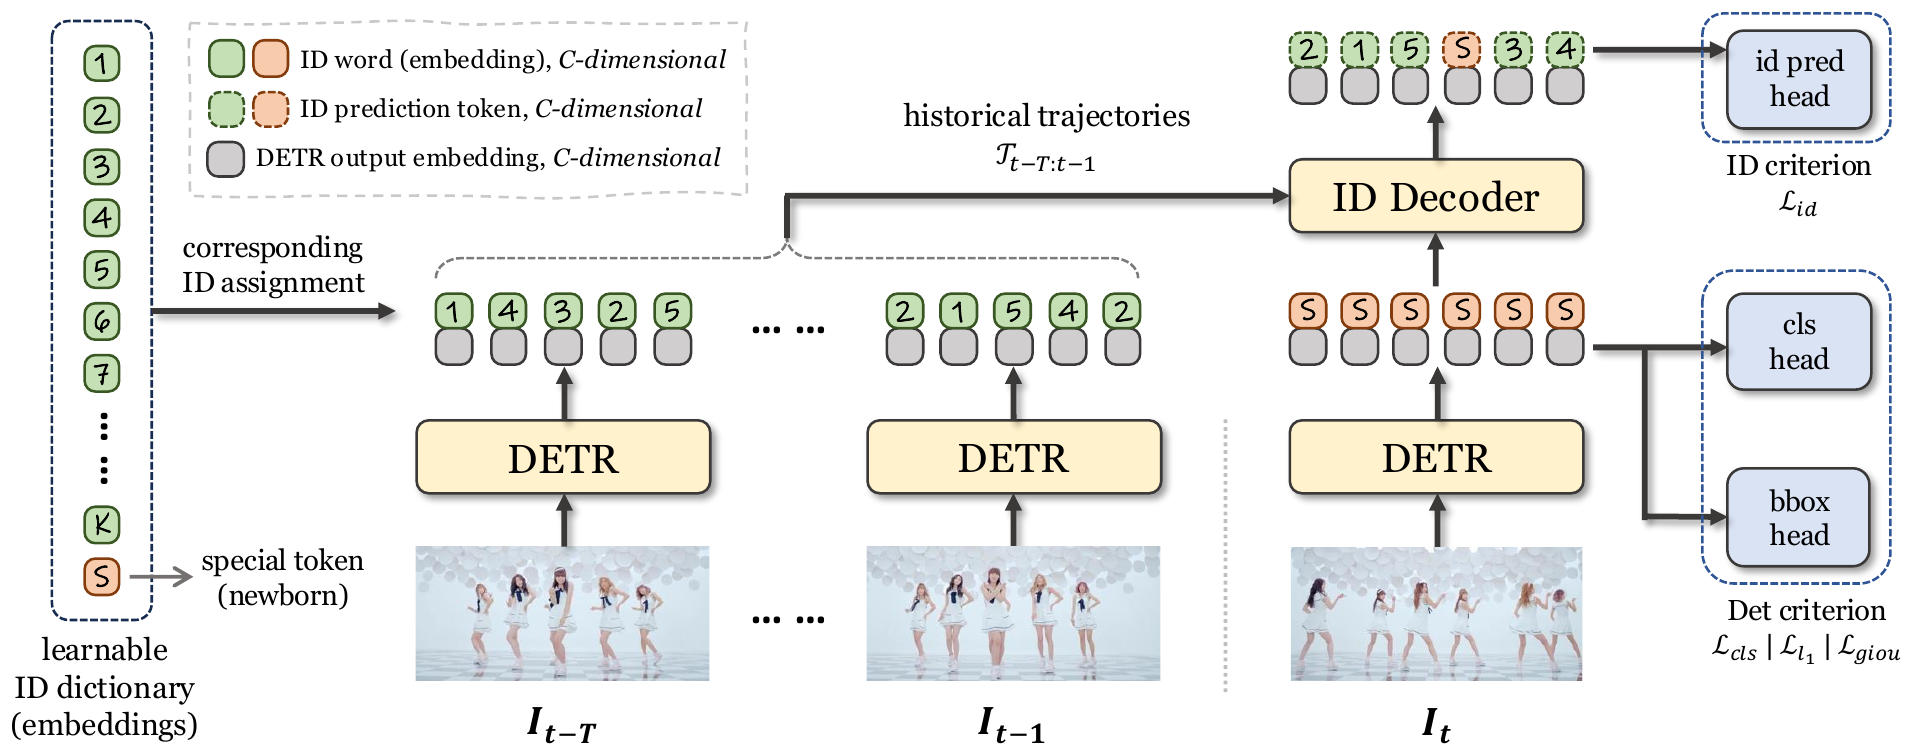
整个架构只有三个组件。
DETR 检测器。 用以 ResNet-50 为骨干网络的 Deformable DETR。它的好处是解码器的输出嵌入本身就可以当作物体的特征,不需要另外裁剪框、做 RoI 池化。每个物体得到一个 256 维的特征 。
ID 字典。 一组 个可学习的 256 维嵌入:
前 个代表普通号码,最后一个 代表「新物体」。作者没有用 one-hot 编码,理由是它不利于训练,而且号码的上限会被向量维度绑死。默认 ,只要不少于一帧里最多的物体数就行。
ID 解码器。 一个标准的 Transformer 解码器,自注意力和交叉注意力交错排列,最后接一个线性分类头,输出 类的概率。
一个物体怎么变成一个 token
我们沿着一条轨迹走一遍。
一条已经在跟踪的轨迹,被发了号码 。它过去 帧里的每一个框,都有一个 DETR 特征 。把特征和号码的嵌入直接拼接起来:
每个 token 都是 512 维,前半是「长什么样子」,后半是「挂着几号」。这条轨迹在过去 帧的所有 token,组成它的历史。 在 DanceTrack 上是 29 帧,SportsMOT 上是 59 帧。
当前这一帧的检测,还不知道是谁,所以统一接上新物体的符号:
接着,当前的检测当作查询、所有历史 token 当作键和值,送进 ID 解码器。解码器里的交叉注意力,让每个检测去历史里找「长得最像的那串 token 挂着几号」;自注意力则让同一帧的检测彼此交换信息,避免两个长得很像的人抢同一个号码。最后分类头输出每个检测属于每个号码的概率。
如果检测属于第 条轨迹,答案是 ;如果是新出现的人,答案是新物体那一类。关联就这样变成了一个 类的分类问题,可以直接用交叉熵训练,和 DETR 的检测损失加在一起:
四个权重分别是 2、5、2、1。
推理:号码牌怎么发、怎么收
推理时的流程很直接:
- 号码从 1 到 依次发给轨迹,彼此不重复。轨迹结束了,它的号码就收回来给新轨迹用。所以视频再长、出现的人再多,只要同一时间在跟踪的轨迹不超过 条就行。
- DETR 的输出先用置信度 0.3 过滤。
- 剩下的检测送进 ID 解码器,各自挑概率最高、而且超过 0.2 的号码。
- 同一帧里如果两个检测挑了同一个号码,只留置信度比较高的那个。
- 没拿到号码、检测置信度又超过 0.6 的,当作新物体,发一张新的号码牌。
默认不用匈牙利算法。作者认为,更复杂的分配策略也许能再提升一点,但他们想验证的是模型本身的能力。
作者也统计过,大多数情况下号码的使用率不到 40%。真遇到极度拥挤的场景,把 调大即可,就像 DETR 默认用 300 个查询一样。
训练时,故意制造错误
训练时,历史轨迹是用真值建起来的,每一条都干干净净。推理时却不是这样。人会被挡住,模型也会发错号码,错误还会写进之后的历史。
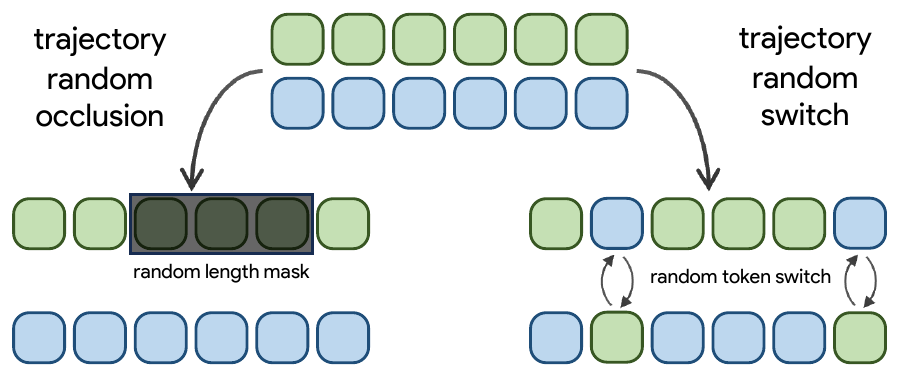
为了让模型习惯不完美的历史,作者加了两种轨迹增强:
- 随机遮挡: 以概率 把一条轨迹中间的一段 token 拿掉,模拟人被挡住。
- 随机交换: 以概率 把同一帧里两条轨迹的号码互换,模拟模型把相似的人配错。
两者都设为 0.5。
另外,因为检测和关联是分开的两个模块,训练可以并行。每次取一段 帧的片段,每一帧的 DETR 可以同时做前向计算,ID 解码器则用注意力掩码确保看不到未来;只有其中 4 帧的 DETR 需要反向传播。作者用 8 张 RTX 4090,在 DanceTrack 上训练不到一天。
讨论
作者刻意让比较的条件一致,主要结果都用 Deformable DETR 加 ResNet-50,而且不用额外的检测数据集。他们认为,把 CrowdHuman 这类静态图片平移成假视频来训练,对端到端、特别是需要长时间建模的方法并不好。
DanceTrack
| 方法 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| DiffMOT | 62.3 | 82.5 | 47.2 | 63.0 |
| MeMOTR | 63.4 | 77.0 | 52.3 | 65.5 |
| CO-MOT | 65.3 | 80.1 | 53.5 | 66.5 |
| MOTIP | 69.6 | 80.4 | 60.4 | 74.7 |
| MOTRv2(额外数据) | 69.9 | 83.0 | 59.0 | 71.7 |
| MOTIP(额外数据) | 72.0 | 81.8 | 63.5 | 76.8 |
整理自原论文 Table 1,DanceTrack 测试集。
MOTIP 不用额外数据就拿到 69.6,比同样用 Deformable DETR 的 CO-MOT 高 4.3 分,AssA 高 6.9 分,IDF1 更是高出 8 分以上。用了额外数据的版本则到 72.0,超过 MOTRv2。
表上 MeMOTR 的 63.4,是它换成标准 Deformable DETR 的版本;MeMOTR 论文主表用 DAB-Deformable-DETR 报告的是 68.5。即使和 68.5 比,MOTIP 还是高出一截,但两者的检测框架并不相同。
SportsMOT 与鸟群
在 SportsMOT 上,只用训练集,MOTIP 的 HOTA 是 72.6、AssA 63.2,高于同样条件的 OC-SORT(68.1)和 MeMOTR 的 Deformable DETR 版本(68.8),也高于用了额外数据的 DiffMOT(72.1)。
不过,SportsMOT 上表现最好的是 Deep-EIoU 那一派的做法:它用 YOLOX 在训练集加验证集上训练检测器,再加上 ReID 模型,HOTA 是 77.2。两者的训练数据和检测器都不同,不能直接比,但也提醒我们,在体育场景里,一个强的检测器加上简单的规则,仍然很有竞争力。
作者另外测了一个鸟类跟踪数据集 BFT,有 22 种鸟、106 段视频。鸟在三维空间里飞,动作比地面上的人更不规则,彼此也没有衣服可以分辨。MOTIP 的 HOTA 是 70.5,OC-SORT 是 66.8,ByteTrack 是 62.5。
自注意力和匈牙利算法
消融在 DanceTrack 的验证集上做:
| 自注意力 | 匈牙利 | 轨迹增强 | HOTA | AssA |
|---|---|---|---|---|
| 57.7 | 43.9 | |||
| ✓ | 59.7 | 47.2 | ||
| ✓ | 59.5 | 47.2 | ||
| ✓ | ✓ | 59.9 | 47.9 | |
| ✓ | ✓ | 62.2 | 51.5 | |
| ✓ | ✓ | ✓ | 62.2 | 51.8 |
整理自原论文 Table 4,DanceTrack 验证集。
- 没有自注意力时,匈牙利算法有用。 从 57.7 升到 59.7。没有自注意力,每个检测各自挑号码,彼此不知道对方挑了什么,需要一个全局的分配来避免冲突。
- 有了自注意力,匈牙利算法就几乎没用了。 只多 0.4 分,加上轨迹增强后更是完全一样。作者的解释是,自注意力让同一帧的检测在解码时就互相交换了身份信息,模型自己学会了做全局的分配。
- 轨迹增强加了 2.7 分。 从 59.5 到 62.2,是这张表上最大的一步。
轨迹增强的比例也要拿捏。只加随机遮挡时,0.5 最好(60.7),遮到 1.0 反而降到 58.6;在遮挡 0.5 的基础上加随机交换,0.5 最好(62.2),0.8 就掉到 59.8。
和 ReID 比
MOTIP 也是用物体特征来跟踪,看起来很像一种 ReID 方法。作者把它和两种常见的 ReID 训练方式比较,一种是 FairMOT 的分类式,一种是对比学习式,推理时都用余弦相似度。
在冻结 DETR、只训练关联部分的设置下,FairMOT 式的 HOTA 只有 29.4,对比学习式是 41.0,MOTIP 的 ID 预测是 55.4。全部参数一起训练时,ReID 方法即使加上匈牙利算法、再加一个和 ID 解码器结构相同的轨迹强化模块,最好也只有 54.5,MOTIP 是 59.5。
同样的特征,换成「看着上下文预测号码」的训练方式,差了 5 分以上。作者认为,ReID 方法用人写的规则整合历史信息、各自计算相似度,限制了模型的灵活性;MOTIP 则让模型自己决定怎么看历史轨迹。
局限
在 MOT17 上,MOTIP 的 HOTA 是 59.3,在端到端方法中和 CO-MOT(60.1)、MOTRv3(60.2)差不多,但明显落后于 ByteTrack(63.1)这类启发式方法。作者的解释是,MOT17 只有 7 段训练视频,对需要从数据中学习的方法来说太少;而启发式方法已经针对行人的线性运动打磨了将近十年。
速度方面,在一张 RTX A5000 上,MOTIP 用 FP32 是每秒 12.7 帧,和 MOTR 的 13.1 差不多;改用 FP16 可以到 22.8 帧。
作者也说明,这个设计刻意保持简单,目的是验证「把跟踪当成 ID 预测」这个想法可行,还有很多空间可以加上运动、深度等其他线索。
结论
MOTIP 把多目标跟踪的关联,改写成一个上下文 ID 预测问题。号码随机发给历史轨迹,模型只要看着这些号码,预测新检测该拿哪一张。整个模型只有 DETR、一本 ID 字典和一个标准的 Transformer 解码器,没有卡尔曼滤波,没有代价矩阵,连匈牙利算法都不需要,却在 DanceTrack、SportsMOT 和鸟类跟踪上都超过了先前的方法。
消融里最有意思的,是匈牙利算法的失效。这个从 SORT 开始就一直在的组件,在 MOTIP 里被一层自注意力取代了。
回头看,评估指标其实早就是这样看待 ID 的。CLEAR MOT 一帧一帧地建立对应,IDF1 在整段视频上把真实身份和计算身份一对一匹配,它们都不在乎跟踪器给的是 3 号还是 87 号,只在乎同一个人有没有一直拿着同一张号码牌。MOTIP 只是让模型也用同样的方式理解 ID。