原始论文
Towards Real-Time Multi-Object Tracking
- 发表版本
- ECCV 2020会议
- arXiv 首次提交
- arXiv:1909.12605
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingjde2019,
  title = {{Towards Real-Time Multi-Object Tracking}},
  author = {Zhongdao Wang and Liang Zheng and Yixuan Liu and Yali Li and Shengjin Wang},
  year = {2019},
  eprint = {1909.12605},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1909.12605}
}
DeepSORT、POI、MOTDT 这一代跟踪器,做法都差不多。先跑一个检测器,再把每个检测框裁剪下来,送进另一个 re-ID 网络提取外观特征。
两个网络各跑一次,时间就是两者相加。画面里人越多,要跑的 re-ID 就越多,整个系统就越慢。
很多论文都说自己是「实时跟踪」,但仔细一看,计时常常只算关联那一步,检测器和 re-ID 的时间没算进去。关联是实时的,整个跟踪系统却不是。
清华大学的 Zhongdao Wang 与澳大利亚国立大学的 Liang Zheng 等人想做一个真正实时的系统。他们让检测器顺便把人认出来,同一个网络、一次前向传播,同时输出检测框和每个框的外观特征。他们把这种做法叫做 JDE(Joint Detection and Embedding)。
定义问题
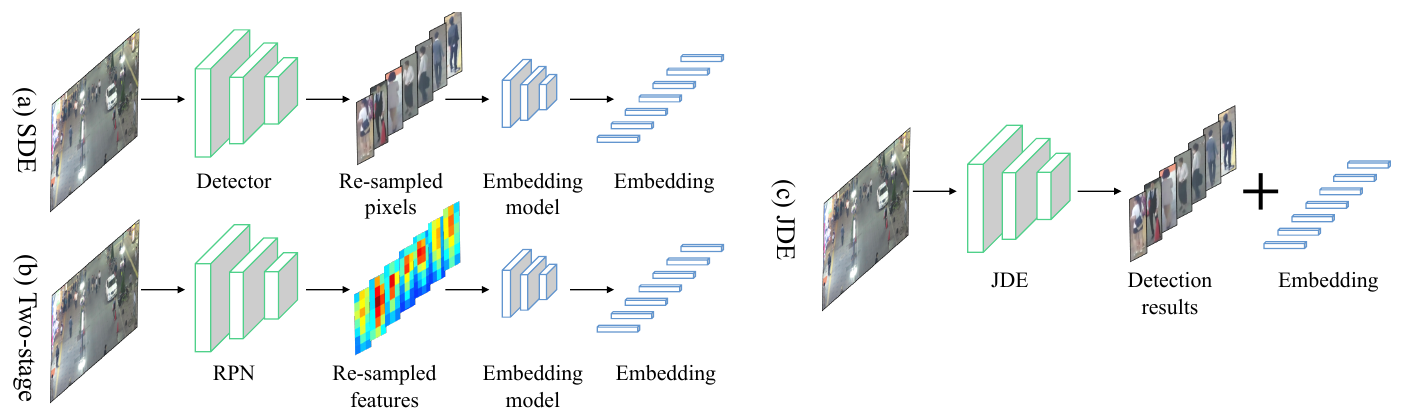
作者把当时的做法分成三类:
- (a) 分离检测与嵌入(Separate Detection and Embedding, SDE): DeepSORT、POI 都属于这类。检测器和 re-ID 模型完全独立,re-ID 的计算量和人数成正比。
- (b) 两阶段模型: 在 Faster R-CNN 上把第二阶段改成学外观特征。第一阶段的 RPN 照样输出框,第二阶段从特征图上取出每个框的特征,改用度量学习训练。这样能共享一部分计算,但两阶段的设计本身就慢,通常不到每秒 10 帧,而且第二阶段的时间一样会随人数增加。
- (c) JDE: 在单阶段检测器上直接多加一个输出,一次前向传播就得到框和特征。
要做到 (c),就得让两个目标差别很大的任务,在同一个网络里一起学好。作者从训练数据、网络架构、损失函数、多任务的权重、评估方式五个方面逐一处理。
解决问题
网络架构
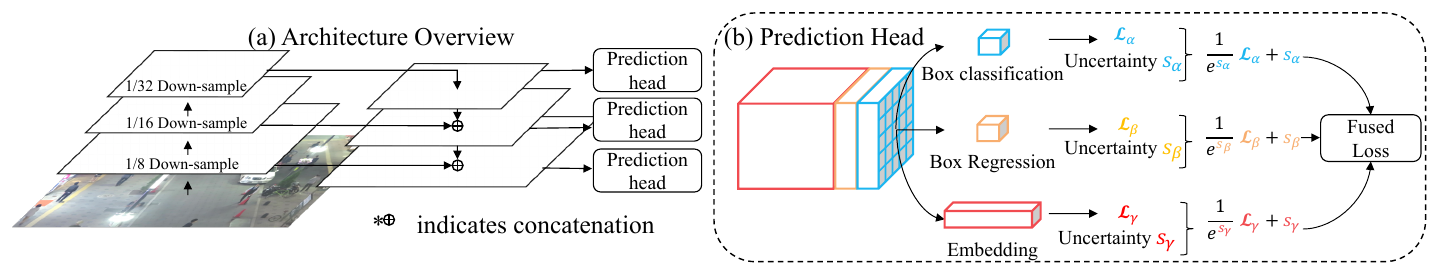
骨干是 YOLOv3 用的 DarkNet-53,接上特征金字塔网络(FPN),在三个尺度上做预测,分别是输入的 1/32、1/16、1/8。行人远近大小差很多,多尺度预测对检测有帮助。
每个尺度接一个预测头,输出一张大小为 的密集预测图。 是这个尺度的锚框数, 是嵌入特征的维度。这张图分成三份:
- 框分类: ,每个锚框是前景还是背景。
- 框回归: ,每个锚框的四个修正量。
- 嵌入图: ,每个位置一个 维的外观特征。
我们拿默认的输入 算一下形状。三个尺度的特征图分别是 、、。论文没有写出 的值,FairMOT 的实验里 JDE 用的是 512 维。每个尺度 ,所以每个预测头的输出通道数是 ,最细的那一层就是一个 的张量。
一个锚框如果被判定为前景,就到嵌入图上同一个位置,取出那里的 512 维向量,当作这个框的外观特征。检测和外观特征是一起算出来的,画面里多一个人,计算量也几乎不变。
检测分支:为行人调整锚框
检测分支大体和 RPN 一样,但做了两处修改:
- 锚框专为行人设计。 所有锚框的宽高比都是 1:3,总共 12 种大小,每个尺度分到 4 种,宽度从 一路到 像素。
- 前景与背景的阈值。 和真实框 IoU 大于 0.5 算前景,这和一般的目标检测相同;但 IoU 小于 0.4(而不是一般的 0.3)就算背景。作者发现,这样能有效压低严重遮挡时的误报。
分类用交叉熵,框回归用 smooth-L1。
嵌入分支:用分类取代三元组
嵌入要学的是一个空间,让同一个人的特征靠在一起、不同人的特征彼此远离。最直觉的做法是三元组损失(triplet loss),MOTDT 就是这样训练的。但三元组的组合太多,采样很难,训练也不太稳定,收敛慢。
作者比较了三种损失:
- 三元组损失: 在一个小批量里,挖出所有负样本和最难的正样本。
- 三元组损失的平滑上界: 一种更稳定、收敛更快的变体。
- 交叉熵: 把训练集里每一个身份都当成一个类别,取出的嵌入特征经过一层全连接,做身份分类。
作者先从公式上比较后两者。平滑上界可以写成
交叉熵则是
两者长得几乎一样,差别有两个。第一,交叉熵用可学习的「类别权重」 代表每个身份,而不是直接用其他样本的特征 。第二,交叉熵的分母包含所有其他身份,三元组类的损失只包含这个小批量里抽到的负样本。交叉熵要求一个人和自己的类别比和每一个其他身份都更像,约束比三元组严格得多。
实验结果也很悬殊。在相同的权重设置下,嵌入在检索任务上的 TPR@FAR=0.1,三元组只有 42.2,平滑上界 44.3,交叉熵 88.2,整整翻了一倍。
只有框、没有身份标注的前景锚框,计算嵌入损失时会被忽略。三个尺度的嵌入特征经过同一层全连接,共享同一个特征空间,所以不同尺度检测到的同一个人也能互相比对。
三个损失怎么平衡
每个预测头有三个损失,三个尺度加起来就是九个。最简单的做法是全部等权重相加,但这样几乎训练不起来。
作者比较了几种权重策略:
- 均等权重(Uniform): 检测的 AP 只剩 6.8。嵌入损失的量级比另外两个大得多,整个训练被它主导,检测完全学不好,MOTA 只有 36.9。
- MGDA-UB: 理论上最完备的多任务优化方法,但它给嵌入损失的权重太大,结果和均等权重差不多,AP 8.3。
- 损失归一化(Loss.Norm): 用各损失移动平均的倒数当权重,MOTA 57.9。
- 近似最优权重(App.Opt): 限制成两个独立变量,人工搜索出一组权重,MOTA 64.3。
- 基于不确定性的加权(Uncertainty): 每个损失配一个可学习的参数 ,让网络自己决定权重:
最后这个方法是唯一超过人工搜索的,AP 83.0、TPR 90.4、MOTA 65.8,ID 切换 207 也是最少。次年的 FairMOT 沿用了同一套加权方式。
训练数据
JDE 需要同时有框和身份标注的数据,但跟踪数据集太小。作者把六个公开数据集拼成一个大训练集。ETH 和 CityPersons 只有框,只训练检测;CalTech、MOT16、CUHK-SYSU、PRW 有身份标注,两个分支一起训练。总共约 5.4 万张图像、27 万个框、8,700 个身份。ETH 里和 MOT16 测试集重叠的视频已经剔除。
这个组合后来在 FairMOT 里被称为 MIX,成了 one-shot 跟踪器的标准训练数据。
关联
关联不是这篇的重点,作者设计了一套简单快速的在线关联。每条轨迹记录一个外观状态 和一个卡尔曼滤波的运动状态。每一帧,计算所有检测和轨迹之间的外观相似度 (余弦相似度)与运动距离 (马氏距离),加权成代价:
用匈牙利算法匹配后,轨迹的外观状态用指数移动平均更新:
连续两帧都出现的检测才新建轨迹;30 帧没更新的轨迹才删除,中间的轨迹留在一个缓冲池里,回来时还能接上。
这个 EMA 更新后来被 StrongSORT 和 BoT-SORT 直接借用。作者也提到,把卡尔曼滤波向量化(一次处理所有轨迹)对速度很关键,网络已经很快的时候,关联反而容易成为瓶颈。
讨论
JDE 用 SGD 训练 30 个 epoch,输入分辨率默认 。验证时,检测看 CalTech 验证集的 AP,嵌入看三个数据集上的检索 TPR,跟踪看 MOT15 训练集的 MOTA;最后在 MOT16 测试集上比较。
关联方法
作者先把同一个 JDE 模型分别接上 SORT 和自己的关联方法。在人少的 MOT15 上,自己的方法 MOTA 67.5、IDF1 67.6,SORT 是 66.9 和 55.8,速度也从 44.1 升到 46.2 FPS。在人多的 CVPR19-01 序列上(平均每帧 61 人),速度从 26.4 升到 33.9 FPS,MOTA 和 IDF1 只小幅提升。IDF1 的大幅改善,主要来自外观特征。
和分离式系统比
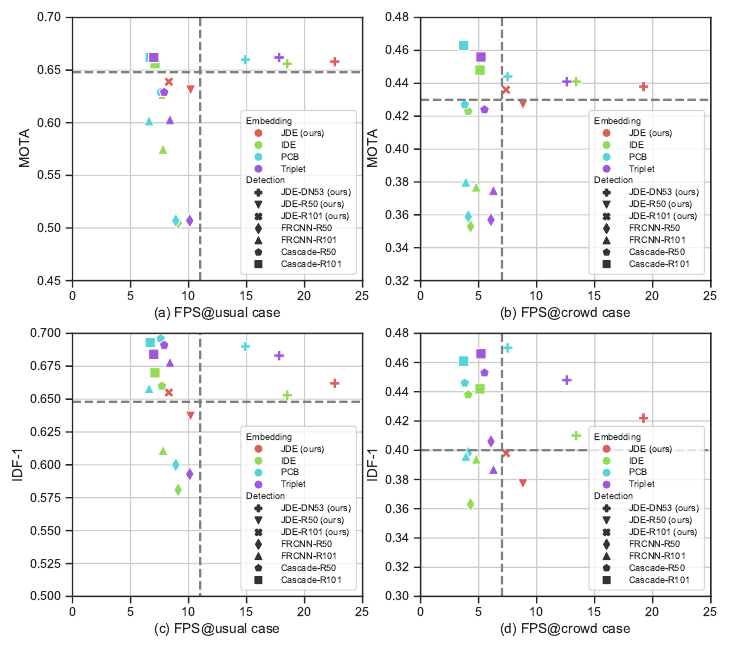
为了公平,作者用完全相同的训练数据,把几种检测器(JDE、Faster R-CNN、Cascade R-CNN)和几种 re-ID 模型(IDE、Triplet、PCB)两两组合,再接上同一套关联。
- 速度与准确度的取舍最好。 在人少的情况下,JDE 每秒 22 帧,MOTA 65.8;最强的组合 Cascade R-CNN(ResNet-101)加 PCB,MOTA 66.2,但只有每秒约 6 帧。
- 人多的时候差距更明显。 所有 SDE 组合在拥挤场景都大幅变慢,因为 re-ID 的时间和人数成正比;JDE 的嵌入和检测一起算,速度几乎不受影响,变慢的部分主要来自关联。
- 联合学习的嵌入不比分开学的差。 固定 JDE 的检测器,换上独立训练的 IDE、Triplet、PCB 嵌入,跟踪准确度都很接近,JDE 甚至略胜 IDE。
但 IDF1 那一侧就没那么好看了。在拥挤场景,JDE 的 IDF1 掉得比强的 SDE 组合更多。
MOT16 测试集
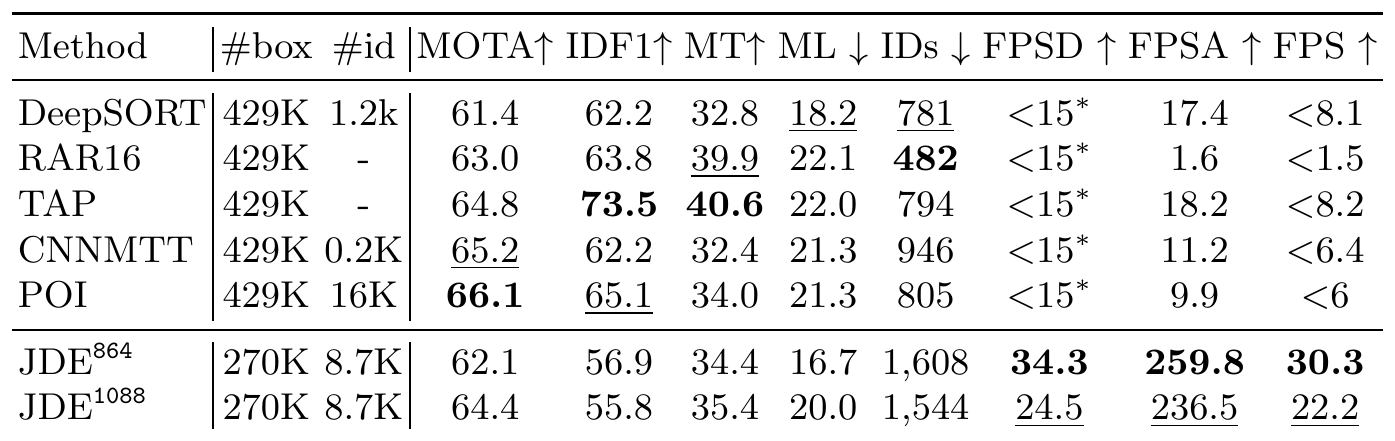
JDE 用了额外的训练数据,所以在 MOT16 的 private 规则下比较。对手都用同一个以大型私有行人数据训练的 Faster R-CNN,差别在 re-ID 模型和关联方式。
MOTA 上,JDE 的 64.4 比 DeepSORT 高 3 分,比 POI 低 1.7 分,而它用来训练的框只有对手的六成多(27 万对 42.9 万个)。速度上,很多方法没有报告完整的时间,作者重新实现了它们共用的检测器来估计上限;就算用这么宽松的上限比较,JDE 每秒 22.2 帧,也快了至少两三倍。把输入宽度缩小到 864,速度提升到 30.3 FPS,MOTA 只掉到 62.1。
但 IDF1 和 ID 切换是 JDE 的明显弱点。IDF1 55.8,比 DeepSORT 的 62.2、POI 的 65.1 都低;ID 切换 1,544,将近其他方法的两倍。
问题出在框上
作者一开始怀疑,是联合学习的嵌入比较弱。但把嵌入换成独立训练的模型之后,IDF1 和 ID 切换几乎没变。
真正的原因在检测。行人大量重叠时,单阶段检测器的框容易漂移、对不准,用对不准的框去取特征,特征就会混进别人的信息,ID 跟着换掉。这些 ID 切换常常发生在轨迹中段,所以 IDF1 掉得特别多。作者把「如何在行人严重重叠时让框更准」留给了未来的研究。
后来
这个问题半年后就有人接手了。FairMOT 认为问题出在锚框。一个锚框可能框到好几个人,好几个锚框也可能对应同一个人,re-ID 特征因此学得含混。它改用无锚框的中心点表示,并把嵌入降到 64 或 128 维。在 FairMOT 的实验里,光是把 JDE 的嵌入从 512 维降到 64 维,MOTA、IDF1、ID 切换就全部变好了。
结论
JDE 把外观特征塞进单阶段检测器,一次前向传播同时输出框和特征,是第一个接近实时的完整多目标跟踪系统。它在 MOT16 上的 MOTA 和分开训练的强系统相近,速度快了两三倍,而且人越多,优势越明显。
这篇里最值得带走的是两个训练细节。嵌入用身份分类的交叉熵,比三元组损失好上一倍;多任务的权重交给不确定性参数去学,比人工搜索还好。这两招在后来的 one-shot 跟踪器里几乎成了标配。
论文标题写的是「Towards」,作者自己也很清楚,框对不准的那一段路,还得留给下一篇来走。