原始论文
Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification
- 发表版本
- ICME 2018会议
- arXiv 首次提交
- arXiv:1809.04427
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmotdt2018,
  title = {{Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification}},
  author = {Long Chen and Haizhou Ai and Zijie Zhuang and Chong Shang},
  year = {2018},
  eprint = {1809.04427},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1809.04427}
}
如果你读过 FairMOT 或 JDE 的代码,关联那一段很可能会看到 MOTDT 这个名字。
FairMOT 的论文写得很直接,它的在线关联「沿用 MOTDT 的分层关联」。ByteTrack 拿来比较的三种经典关联方法,除了 SORT 和 DeepSORT,第三个也是 MOTDT。
这个名字常常出现在别人的表格里,论文本身却只有六页。它是清华大学的 Long Chen、Haizhou Ai 等人在 2018 年发表的,处理的是每个跟踪器都会遇到的问题,检测器不可靠的时候该怎么办。
定义问题
在拥挤的场景里,检测器很容易出错。姿态一变、被别人挡住,就会出现漏检、误报,或者框的位置不准。
离线(batch)方法可以看完整段视频,用未来的帧来修正这些错误,但它们不是实时的,没法用在需要当场给出结果的应用里。这篇论文只做在线跟踪,只能用当前和过去的帧。
传统的 tracking-by-detection 在关联时,候选框只有检测结果。检测器漏掉一个人,这一帧就没有任何框能分给他的轨迹。
作者注意到,检测和跟踪其实可以互补:
- 轨迹的预测可以处理短时间的漏检或框不准。检测器这一帧没找到人,卡尔曼滤波的预测框还在。
- 高置信度的检测可以防止轨迹长期漂移到背景上。预测框一直没有检测来修正,迟早会跑偏。
那就把两者都当成候选框吧。可是检测框和预测框来源不同,要怎么用同一把尺子打分,再从一大堆重叠的框里挑出最好的?
此前 Yan 等人也试过把检测器和跟踪器的输出都当作候选,但用的是颜色直方图、光流这类手工特征。这篇论文想用深度网络来做,而且要实时。
解决问题
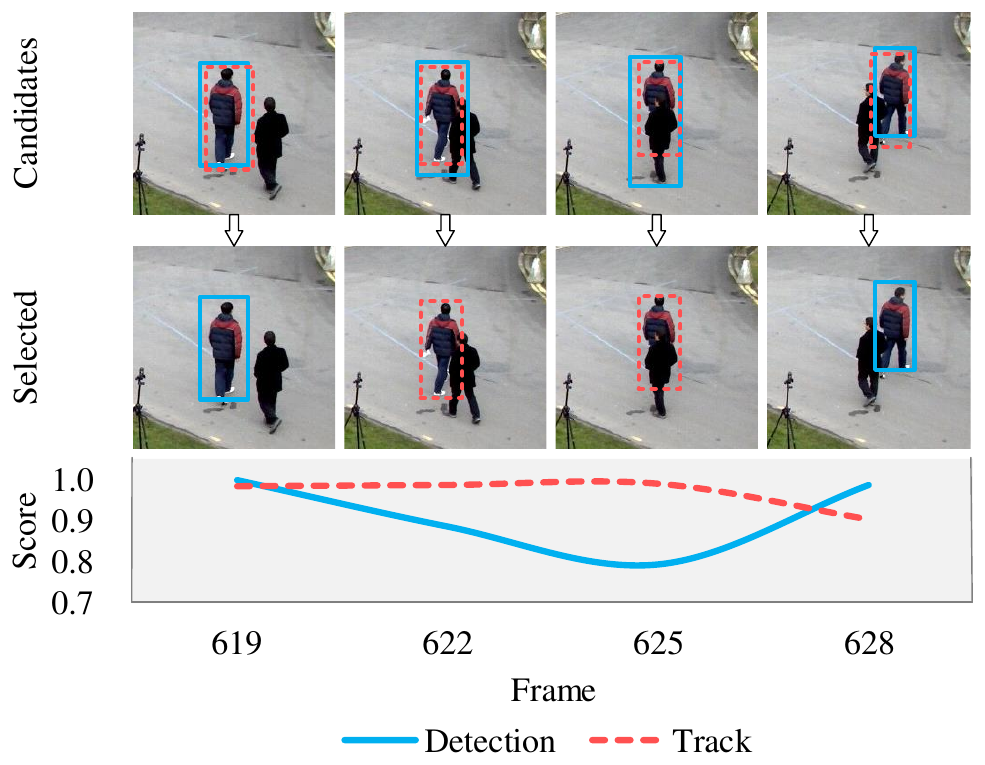
这张图就是整篇论文的思路。蓝色实线是检测框,红色虚线是轨迹的预测框,底下的曲线是两者的分数。
前后几帧,检测框分数较高,被选中;中间第 622 到 625 帧,这个人被挡住一部分,检测框的分数掉下来,预测框反而更可靠,就换成选预测框。
整个方法分两步,先选候选框,再做关联。
一、用同一个分类器给所有候选框打分
检测框加上预测框,数量会很多,而且彼此高度重叠。如果每个框都裁剪下来送进分类网络,太慢了。
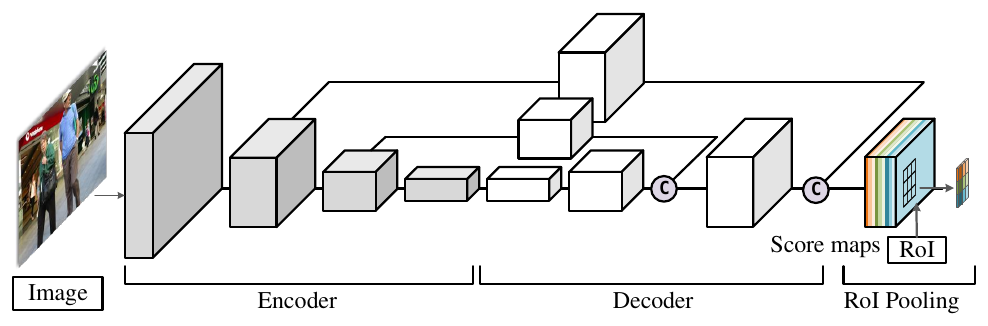
作者改用 R-FCN(region-based fully convolutional network)的做法,整张图像只跑一次网络,输出几张得分图,所有候选框共用这些得分图。
骨干用轻量的 SqueezeNet 当编码器,再接一个带上采样的解码器,把得分图的分辨率拉高。输入 的图像,在 GTX 1080 Ti 上只要 8 毫秒。
最简单的打分方式,是在整张图上算每个点「是人」的概率,再把框内所有点平均。但这样会丢掉空间信息。一个框只盖住半个人,框内的点也都在人身上,平均起来分数照样很高。
R-FCN 用位置敏感的得分图解决这个问题。网络输出 张得分图,每个候选框切成 个格子,每个格子只读「属于自己位置」的那张得分图。最后把 个格子的响应平均,再经过 sigmoid:
我们用 想象一下。网络会输出 9 张得分图,分别对「人的左上角」「人的正上方」……「人的右下角」有响应。一个框正好框住一个人时,左上格读左上图、右下格读右下图,每格都读到高分。如果框往右偏了半个人,框的右半边落在背景上,右侧三格读到的都是低分,平均下来分数就掉了。
这个网络只做分类,不做框的回归。实现中 ,训练数据是在真实框周围随机采样的正样本,以及等量的背景负样本,来源是 MS COCO 和两段 MOT16 训练视频。
二、轨迹置信度:预测框能信多久?
预测框在短时间内有用,时间一长就不可靠了。卡尔曼滤波越久没被检测更新,预测越不准。
作者为每条轨迹定义了一个置信度分数。一条轨迹可能中断又被找回好几次,每次找回都会重新初始化卡尔曼滤波,所以只看最后一段连续的轨迹片段(tracklet):
是这段轨迹片段匹配到过几次检测, 是最后一次匹配到检测之后,已经连续用了几次预测。
这个式子的行为很直观:
- 刚匹配到检测时,,置信度是 1。
- 每多用一次预测, 就加一,置信度按对数往下掉。
- 当 超过 ,置信度就归零,这条轨迹的预测框不能再当候选。
- 一条轨迹至少要匹配到两次检测,才算有足够的观测来建立运动模型,它的预测框才能当候选。
三、统一分数
两种候选框的分数定义为:
检测框的分数就是分类概率;预测框的分数是分类概率再乘上轨迹置信度。一个预测框就算看起来很像人,只要它来自一条很久没被检测确认的轨迹,分数也会被压低。
所有候选框打完分后,做一次非极大值抑制(IoU 阈值 0.3),再丢掉分数低于 0.4 的框。
四、外观特征
关联时要判断候选框和轨迹是不是同一个人,作者用的是 re-ID 特征。网络采用 Zhao 等人提出的部件对齐架构,以 GoogLeNet 的卷积层为骨干,后面接 个分别对应身体不同部位的全连接分支,输出 512 维特征,用欧氏距离比较。
训练数据结合了 Market-1501、CUHK01、CUHK03 三个行人重识别数据集,用 triplet loss 训练:
是同一个人, 是不同的人。已经分得很开的三元组()损失为零,训练就专注在困难样本上。
五、分层关联
这是后来被 JDE、FairMOT 沿用的部分。关联分成两层:
- 第一层:检测候选框 × 轨迹,用外观。 计算 re-ID 特征的距离,阈值 0.4。
- 第二层:剩下的候选框 × 剩下的轨迹,用 IoU。 阈值 0.3。
- 剩下的检测框,新建轨迹。
为什么要分层?预测框是卡尔曼滤波推出来的,在拥挤的场景里,它框到的区域可能混进了别人。用这种框提取外观特征,很容易把别人的样子记进来。所以外观比对只用在检测框上,轨迹的外观也只用匹配上的检测框来更新;预测框只参与第二层的 IoU 匹配。
这样做也更快。每一帧只需要对检测框提取一次 re-ID 特征,预测框完全不用提取。
讨论
实验在 MOT16 上进行,使用官方提供的公开检测。验证集取自 5 段训练视频,用来做消融。
每个组件的贡献
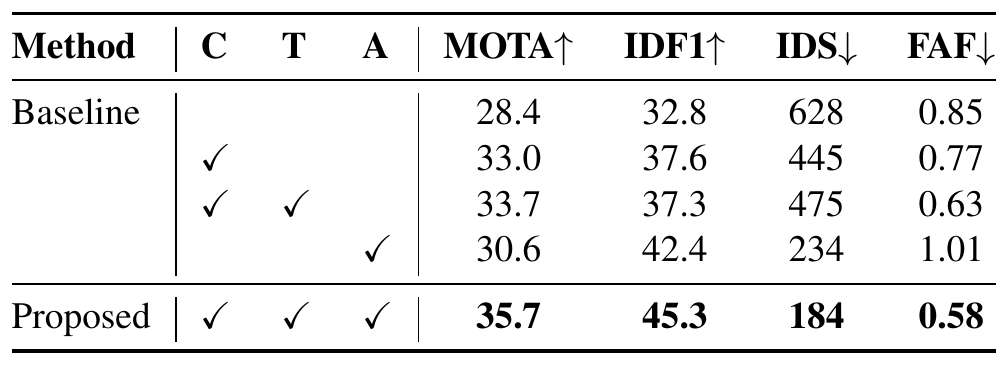
基线是最简单的卡尔曼滤波预测加 IoU 匹配,也就是 SORT 那一套。
- 用分类器从检测框和预测框中挑候选(C),MOTA 从 28.4 升到 33.0,ID 切换从 628 降到 445。把预测框当候选,确实补回了很多漏检。
- 再加上轨迹置信度(T),MOTA 升到 33.7,每帧误报从 0.77 降到 0.63。不可靠的预测框被压下去了,但 ID 切换略增到 475。
- 只加外观特征(A),IDF1 从 32.8 大幅升到 42.4,ID 切换降到 234;但 MOTA 只有 30.6,每帧误报反而升到 1.01。
- 三者都加,MOTA 35.7、IDF1 45.3、ID 切换 184,四个指标都最好。
前两项主要改善检测相关的指标,外观特征主要改善身份相关的指标,两边合起来才都到位。
外观特征本身也做了比较。下表据原论文 Table 2 整理,比较的是在相同框架下换用不同的外观表示:
| 外观表示 | 维度 | MOTA | IDF1 | ID 切换 |
|---|---|---|---|---|
| 不用外观 | – | 33.7 | 37.3 | 475 |
| 颜色直方图 | 750 | 34.9 | 38.6 | 250 |
| HOG | 1152 | 34.6 | 38.5 | 317 |
| 颜色 + HOG | 1902 | 34.7 | 39.3 | 307 |
| re-ID 特征 | 512 | 35.7 | 45.3 | 184 |
手工特征也有帮助,但 IDF1 都只到 39 左右;学出来的 re-ID 特征维度最短,IDF1 却高出 6 分。
速度
作者在最拥挤的 MOT16-03(平均每帧超过 50 人)上测量每帧的处理时间。如果把每个候选框裁剪下来,用 SqueezeNet 加两层全连接逐一分类,每帧要 206.2 毫秒;改用共享得分图的 R-FCN,降到 66.3 毫秒。
MOT16 测试集
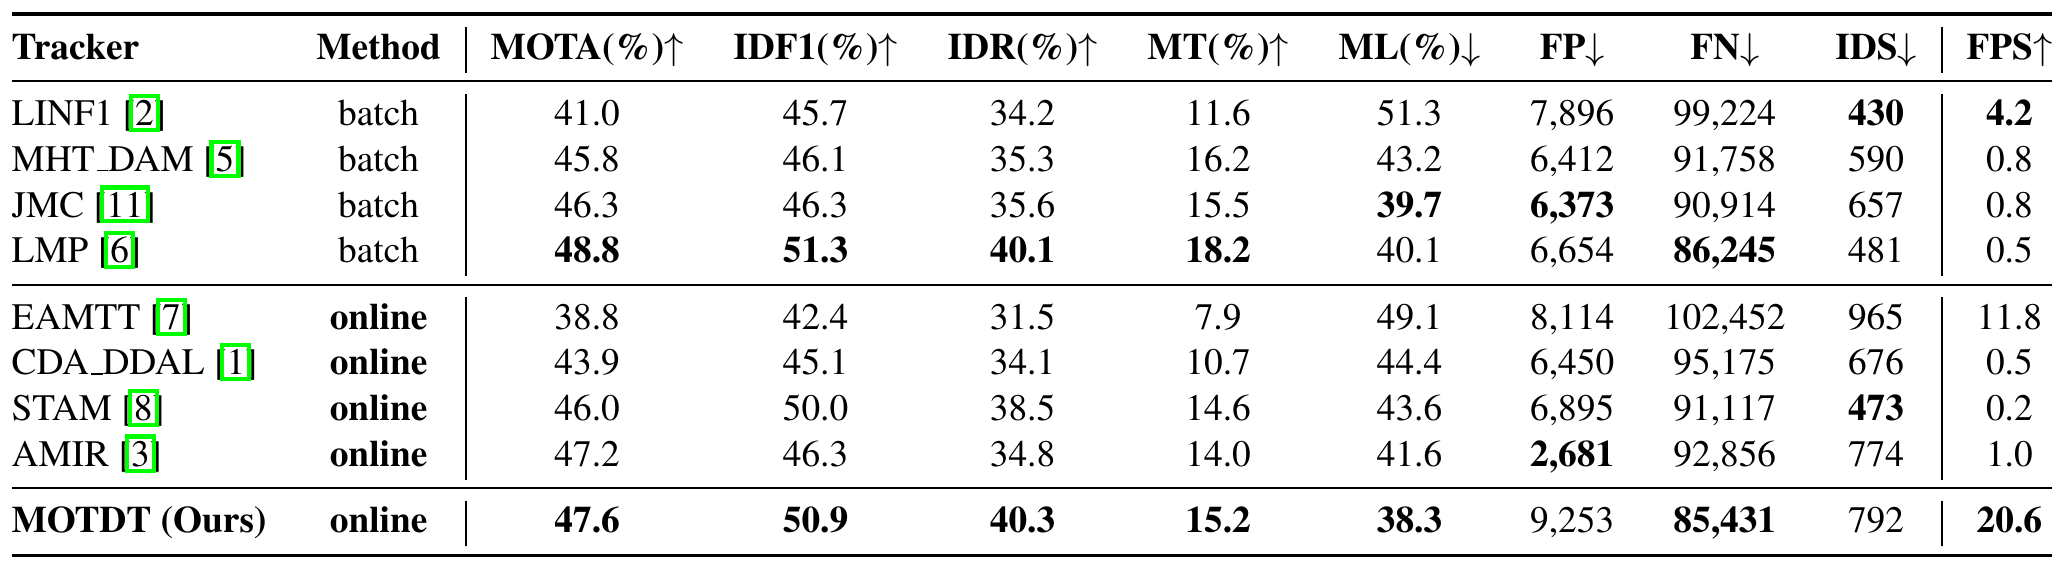
在公开检测的设置下,MOTDT 的 MOTA 47.6、IDF1 50.9,都是表中在线方法最高的,ML 38.3% 和 FN 85,431 甚至是全表最低。速度 20.6 FPS,作者说大约比多数现有方法快 5 到 20 倍;表中多数方法每秒只有 0.2 到 1 帧,差距其实更大。和最好的离线方法 LMP 相比,MOTA 只差 1.2 分,速度却是它的 40 倍。
不过,有两列并不好看。FP 是 9,253,是 AMIR(2,681)的三倍多;ID 切换 792,也高于 STAM 的 473 和 LMP 的 481。本文推测,把预测框当候选,补回漏检的同时,也把一部分不该存在的框留了下来。
后来
作者在结论里写,未来想让分类和外观特征共用卷积层,进一步提升效率。
第二年,清华大学的 Zhongdao Wang 等人发表 JDE,在一个检测网络上同时输出检测框和 re-ID 特征;它的官方代码在关联时,也是先用外观加运动匹配,剩下的再用 IoU。再隔一年,FairMOT 也沿用了同样的两阶段关联。MOTDT 的另一半,也就是「把预测框也当候选」,FairMOT 则没有沿用。
ByteTrack 在 2021 年把 MOTDT 列为比较对象,用同一个 YOLOX 检测器在 MOT17 验证集上跑。MOTDT 的 MOTA 是 75.8,BYTE 是 76.6。ByteTrack 的作者认为,MOTDT 拿预测框当轨迹框,可能会让位置慢慢漂移;BYTE 改从低分的检测框里把人捞回来,位置更准。两篇处理的是同一个问题(检测器不可靠时,怎么才不把人跟丢),选的补救材料却不同。
结论
MOTDT 把检测框和轨迹预测框都当成候选,用一个位置敏感的全卷积分类器给它们打统一的分数,再用轨迹置信度压低太久没被确认的预测。关联时,外观只用在检测框上,剩下的交给 IoU。这套方法在 MOT16 上做到了当时在线方法中最高的 MOTA 和 IDF1,每秒 20 帧。
想给自己的跟踪器加 re-ID 时,分层关联是很实用的起点。外观特征只从可信的检测框提取,预测框只拿来补位。这条规则简单,却直接避免了「把别人的脸记成自己的」这种错误。
至于标题里占了一半篇幅的「候选选择」,后来的跟踪器倒是很少再提起了。