原始论文
Simple Online and Realtime Tracking with a Deep Association Metric
- 发表版本
- ICIP 2017会议
- arXiv 首次提交
- arXiv:1703.07402
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingdeepsort2017,
  title = {{Simple Online and Realtime Tracking with a Deep Association Metric}},
  author = {Nicolai Wojke and Alex Bewley and Dietrich Paulus},
  year = {2017},
  eprint = {1703.07402},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1703.07402}
}
SORT 把跟踪器剃到只剩卡尔曼滤波、IoU 和匈牙利算法,速度飞快,MOTA 也不差。但它的 ID 切换次数一直很难看。
原因不难猜。SORT 只认框的位置和大小,物体被挡住两帧,轨迹就被删掉;等它再出现,跟踪器没有任何线索知道「这个人刚才见过」,只好发一个新 ID。
一年后,SORT 的作者 Alex Bewley 和德国科布伦茨-兰道大学的 Nicolai Wojke、Dietrich Paulus 一起补上了这一块。补的方式很直接,让跟踪器记住每个人长什么样。
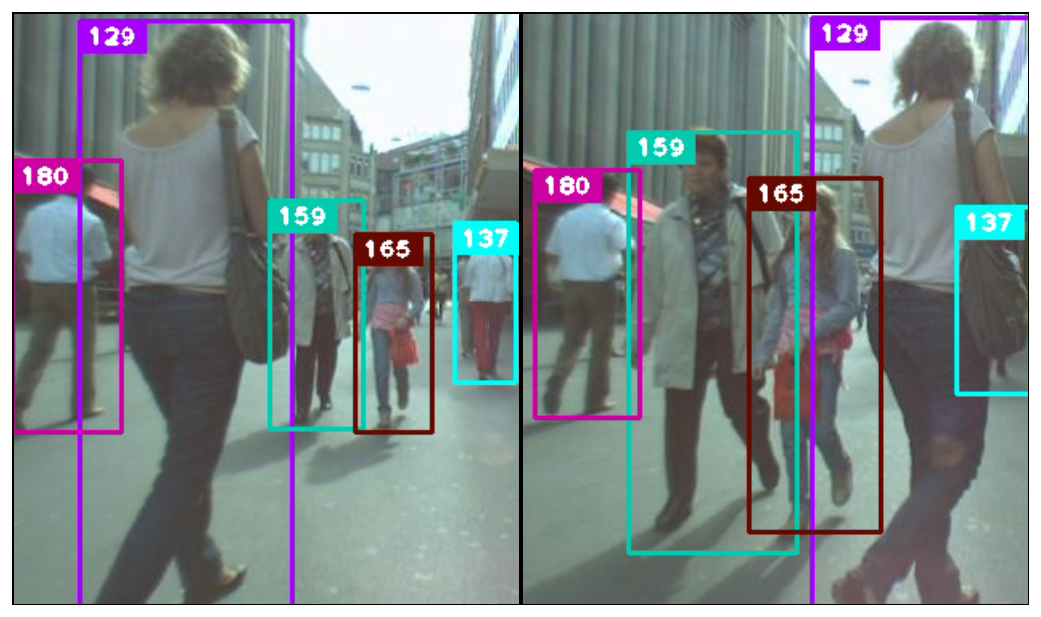
这是 DeepSORT 在 MOT16 上的输出。两张图之间,人群互相交错,前景的 129 从画面中间走到右边,挡住了后面的 137;远处的 159 和 165 走近之后,框大了好几倍。五个人的编号都没变。
这篇只有五页,却成了此后好几年最常被拿来用的跟踪器,名字里的「Deep」也常被误解。我们慢慢看。
定义问题
作者先给 SORT 的 ID 切换找出原因。SORT 用预测框与检测框的 IoU 做匹配,这个度量只有在状态估计很准的时候才可靠。
一旦物体被挡住,卡尔曼滤波只能一直预测,不能更新,预测框越漂越远,和重新出现的检测框重叠不起来。正面视角的街景里,行人互相遮挡是常态,SORT 的轨迹因此不断中断、重发 ID。
要解决这件事,需要一种在位置不可靠的时候仍然能用的线索。作者选了外观。他们用一个在大型行人重识别(person re-identification, re-ID)数据集上训练好的卷积网络,把每个检测框转成一个特征向量。同一个人在不同时间的特征应该接近,不同人的特征应该远离。
设计上延续 SORT 的思路,把复杂的部分放到离线阶段。网络事先训练好,在线跟踪时只做最近邻查询,不做任何在线学习。
解决问题
状态与轨迹管理
卡尔曼滤波的框架大体沿用 SORT,但状态换成了八维:
是框中心, 是宽高比, 是高度,后四项是对应的速度。和 SORT 相比,面积换成了高度,宽高比也有了自己的速度。检测框的 直接当成观测。
每条轨迹 记录一个计数器 ,表示距离上次匹配成功已经过了几帧。预测时加一,匹配成功时归零。超过上限 就认定物体离开了画面,把轨迹删掉。
新轨迹的前三帧是「试用期」(tentative)。这三帧每一帧都必须匹配成功,否则直接删除;撑过三帧才转为确认(confirmed)状态。
SORT 的 是 1,这里的 在实验中设为 30。轨迹可以撑过整整一秒的消失,前提是回来的时候认得出来。
两种距离
匹配仍然是一个指派问题,但代价矩阵换成了两种距离的组合。
第一种是马氏距离(Mahalanobis distance),描述运动:
是第 条轨迹的预测分布投影到观测空间后的均值和协方差, 是第 个检测框。和 IoU 不同,马氏距离会考虑不确定性:它衡量的是检测框距离预测中心「几个标准差」。
这个距离可以用来排除不可能的匹配。观测空间是四维,马氏距离平方服从自由度为 4 的卡方分布,取 95% 置信区间的阈值 ,超过就不允许匹配。
第二种是外观距离。每个检测框经过网络得到一个单位长度的特征 ,每条轨迹保留最近 100 次匹配成功时的特征,组成一个图库 。外观距离取检测特征和图库里最像的那一个之间的余弦距离:
取最小值的好处是,人转身、走进阴影,只要图库里有一张角度相近的特征,就认得出来。外观距离也有自己的阈值 ,由另外的训练数据决定;官方代码默认 0.2。
两者合成最终的代价:
而一个匹配要同时通过两个阈值,才算可行。
作者对两者的分工说得很清楚。马氏距离适合短期预测,物体刚被看见、位置很确定时最有用;外观距离适合长时间遮挡后找回身份,那时候运动信息已经没什么区分度了。
然后是一个常被忽略的细节。在实验中,作者把 设为 0。
也就是说,代价矩阵里只剩外观距离,马氏距离只负责阈值,把位置上不可能的匹配挡掉。作者的理由是,相机明显移动时,图像平面上的位移变化很大,卡尔曼滤波的预测只是粗略估计。许多教程把 DeepSORT 描述成「位置和外观加权相加」,但论文实际跑分用的是「外观排序、运动把关」。
匹配级联
作者没有把所有轨迹和检测框丢进同一个指派问题,而是设计了一个级联(matching cascade)。
为什么要这样做?问题出在马氏距离本身。我们用一维的数字算一次(数字是为了说明而设的)。
假设轨迹 A 上一帧才看到,预测位置在 100,标准差 5;轨迹 B 已经被挡住十几帧,预测位置在 120,但因为一直没有更新,标准差膨胀到 30。现在有一个检测框出现在 108。
- 对 A 来说,检测框差了 8,是 个标准差,马氏距离平方是 2.56。
- 对 B 来说,检测框差了 12,只有 个标准差,马氏距离平方是 0.16。
距离较近、状态也较确定的 A 反而输了。
直觉上,一条轨迹越久没被看见,我们应该越不确定它和任何检测框有关,距离应该变大才对。但马氏距离以标准差为单位,不确定性越大,任何检测框看起来都越「近」。两条轨迹抢同一个框时,它会偏袒那条最不确定的。
级联的做法是按「多久没被看见」分层处理:
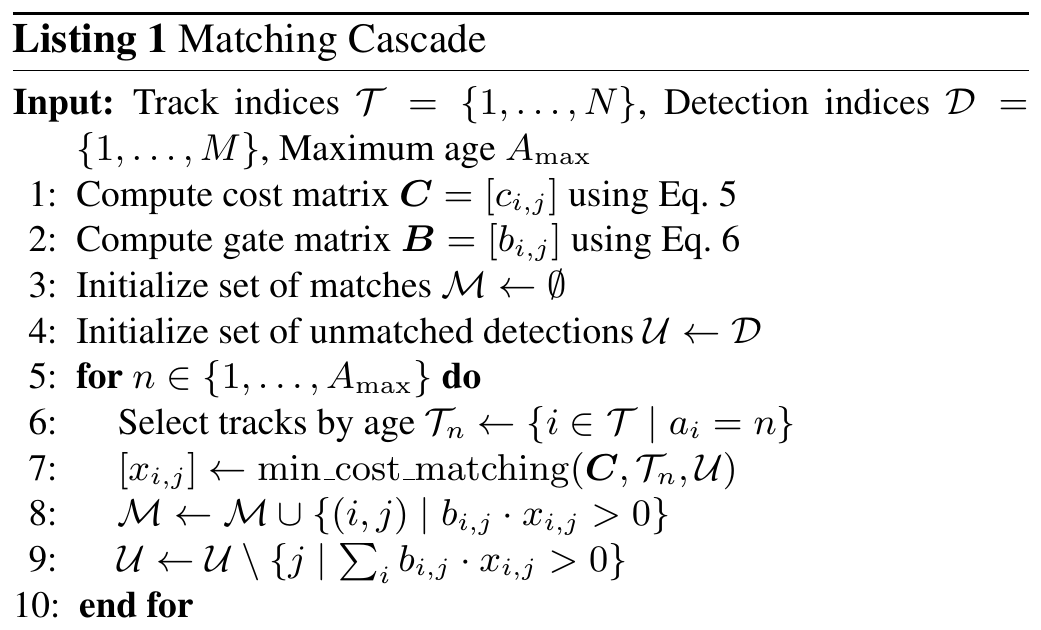
第 5 行的循环从 开始,先处理上一帧才匹配成功的轨迹,让它们先挑检测框;剩下的检测框再交给 的轨迹,依此类推,直到 。刚才的例子里,A 会在第一层就拿走检测框,B 根本轮不到。
级联结束后还有最后一步。把试用期中的轨迹,以及年龄 但没匹配上的轨迹,拿去和剩下的检测框做一次 SORT 式的 IoU 匹配。这一步用来应对外观突然改变的情况,例如被静止的物体挡住半身,也让刚创建、外观图库还很少的轨迹有机会延续。
外观网络
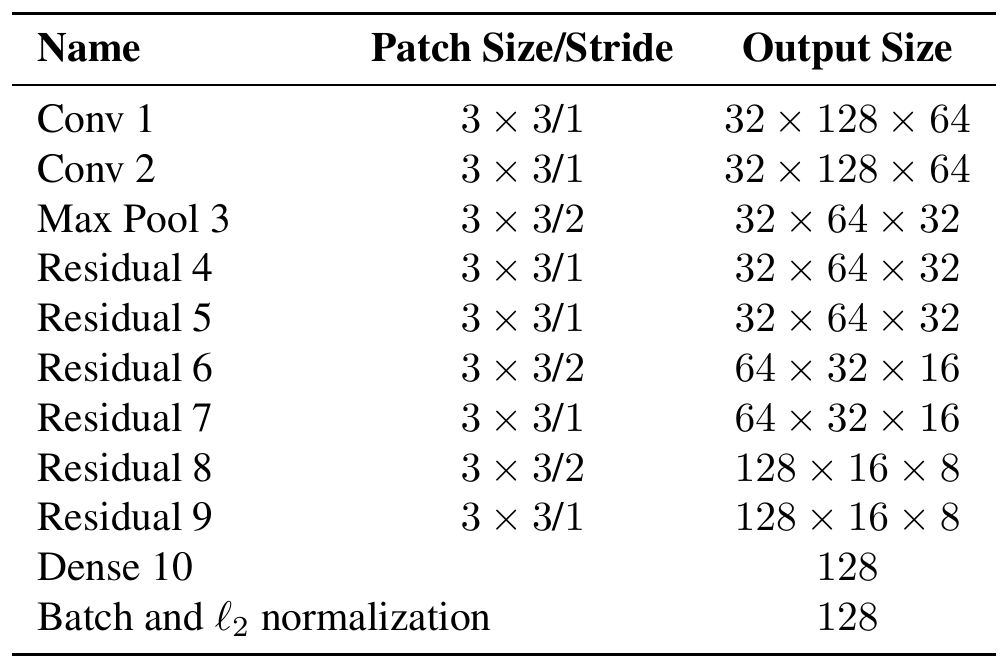
网络是一个宽残差网络,有两层卷积、六个残差块,最后一层全连接输出 128 维。结尾的批归一化和 L2 归一化把特征投影到单位球面上,这样两个特征的内积就是余弦相似度,正好对上前面的外观距离。
整个网络约 280 万个参数,在一块 GTX 1050 笔记本 GPU 上,一次处理 32 个框大约 30 毫秒。训练数据是 MARS 行人重识别数据集,超过 110 万张图像、1,261 个人。
训练细节论文没写,作者说超出了范围。官方代码的说明则指向他们第二年另一篇论文的 cosine metric learning 方法。
讨论
作者在 MOT16 测试集上评估。MOT16 有七段测试视频,包含移动相机的正面街景,也有俯视的监控画面。
检测结果用的是 Yu 等人(POI 这个方法的作者)公开的 Faster R-CNN 检测,它用公开与私有数据训练,质量远高于官方提供的公开检测。为了公平,作者用同一组检测重跑了 SORT。设置是 、,检测置信度阈值 0.3。
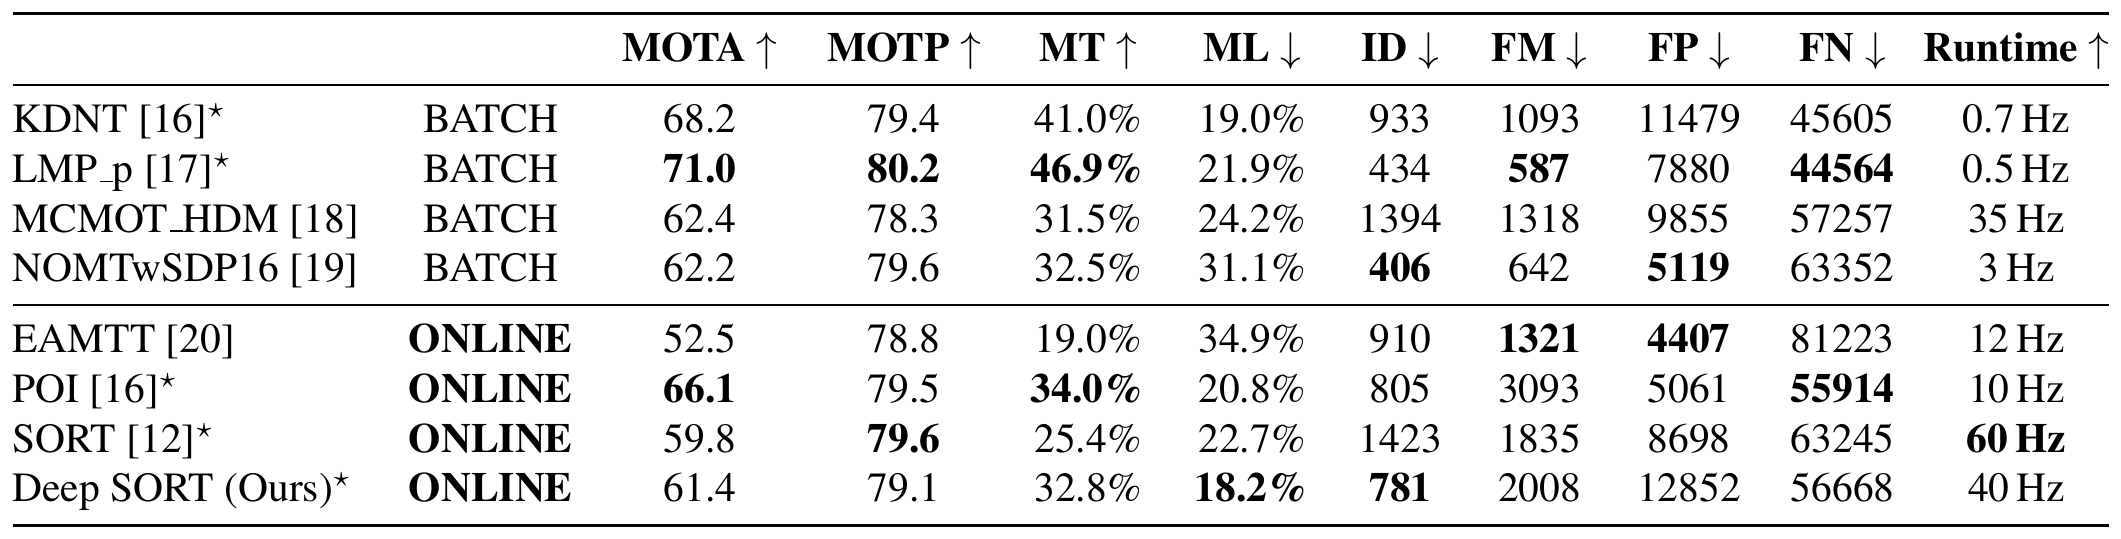
这张表中,标星号的方法都用同一组 POI 检测。我们先比较 SORT 和 Deep SORT 这两行,因为只有它们的差别纯粹来自跟踪器:
- ID 切换从 1423 降到 781,少了约 45%。这是加上外观之后最主要的收获,也是 online 组里最少的。
- MT 从 25.4% 升到 32.8%,ML 从 22.7% 降到 18.2%。能保持身份的时间变长,大部分时间被跟踪到的轨迹多了,几乎跟丢的轨迹少了。
- FM 从 1835 增加到 2008。作者解释,轨迹现在会撑过遮挡与漏检,中间空掉的那几帧就被算成一次断裂。
- FP 从 8698 增加到 12852。这是 MOTA 只从 59.8 升到 61.4 的主因。
最后这一点值得多看一眼。作者检查输出后发现,多出来的误报大多来自检测器在静止背景上偶尔冒出的误判。 让轨迹活得很久,这些零星的误报就被接进轨迹里,形成一条条稳定、停在原地不动的假轨迹。作者也观察到,轨迹很少在误报之间跳来跳去。换句话说,这些误报主要拉低 MOTA,对身份保持的伤害不大。调高检测阈值可能可以大幅改善 MOTA,但论文没有报告这组结果。
和同样使用 POI 检测的 POI 方法相比,Deep SORT 的 MOTA 低了将近 5 分,ID 切换则略少(781 对 805),速度快了好几倍。
速度方面,表中列出 40 Hz;作者在正文里说,整套实现大约 20 Hz,其中将近一半时间花在生成外观特征上。不论哪个数字,都不含检测器本身。
后来
DeepSORT 的代码简单、特征网络可以直接替换,很快成了工程项目的标配。MATLAB 有它的官方示例,GitHub 上「YOLO + DeepSORT」的组合项目更是多到数不清。
五年后,StrongSORT 把它当成翻修的起点,换掉了外观网络和卡尔曼滤波,也把匹配级联拿掉,改回单一的全局指派。他们的消融发现,级联对较弱的跟踪器有帮助,能减少错误匹配;跟踪器变强之后,它反而会束手束脚。在 StrongSORT 的表中,原版 DeepSORT 换成普通匹配后,IDF1 掉了 1.1;逐步强化之后,拿掉级联的好处越来越明显,最强的两个版本分别多了 1.8 和 1.4。
这不算推翻 DeepSORT 的设计,只是说明级联处理的那个问题(不确定的轨迹在马氏距离上占便宜),在外观特征够强、代价矩阵不再以马氏距离为主之后,就没那么严重了。
结论
一个离线训练好的外观网络,加上按轨迹年龄分层的匹配级联,就让 MOT16 上的 ID 切换少了 45%。轨迹能撑过一整秒的消失,跟踪本身仍保持在每秒数十帧。
它的「Deep」只体现在外观特征上。运动模型、匹配、轨迹管理都还是手工规则,所以换一个更好的 re-ID 网络,通常就是最便宜的升级方式。
噢,拿 DeepSORT 去跟踪行人以外的东西时,记得换掉那个在 MARS 上训练的特征网络。它认得一千多个行人,可不认得你的货车。