原始论文
FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking
- arXiv 首次提交
- arXiv:2004.01888
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingfairmot2020,
  title = {{FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking}},
  author = {Yifu Zhang and Chunyu Wang and Xinggang Wang and Wenjun Zeng and Wenyu Liu},
  year = {2020},
  eprint = {2004.01888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01888}
}
DeepSORT 让跟踪器学会认人,代价是每个检测框都要再过一次 re-ID 网络。画面里有十个人,就裁十张图、跑十次特征;有一百个人,就跑一百次。检测器和 re-ID 网络各自从原始图像提取特征,什么都不共享。
人一多,这套系统就慢下来了。
很自然的想法是把两件事放进同一个网络。2019 年前后,Track R-CNN 在 Mask R-CNN 上多接一个 re-ID 头,JDE(Joint Detection and Embedding)在 YOLOv3 上多接一个 re-ID 头,一次前向传播同时输出框和特征。这类方法叫做 one-shot 跟踪器,速度确实上来了,检测也还不错。
但 ID 切换暴增。
华中科技大学与微软亚洲研究院的张一夫、王春雨等人想知道问题出在哪里。他们的答案是,这两个任务在同一个网络里没有被公平对待:检测永远是主角,re-ID 只是陪衬。这篇论文的 arXiv 第一版原本叫「A Simple Baseline for Multi-Object Tracking」,后来才改成现在这个强调「公平」的名字。
定义问题
作者把 one-shot 跟踪器学不好 re-ID 的原因,归纳成三种「不公平」。
锚框造成的不公平
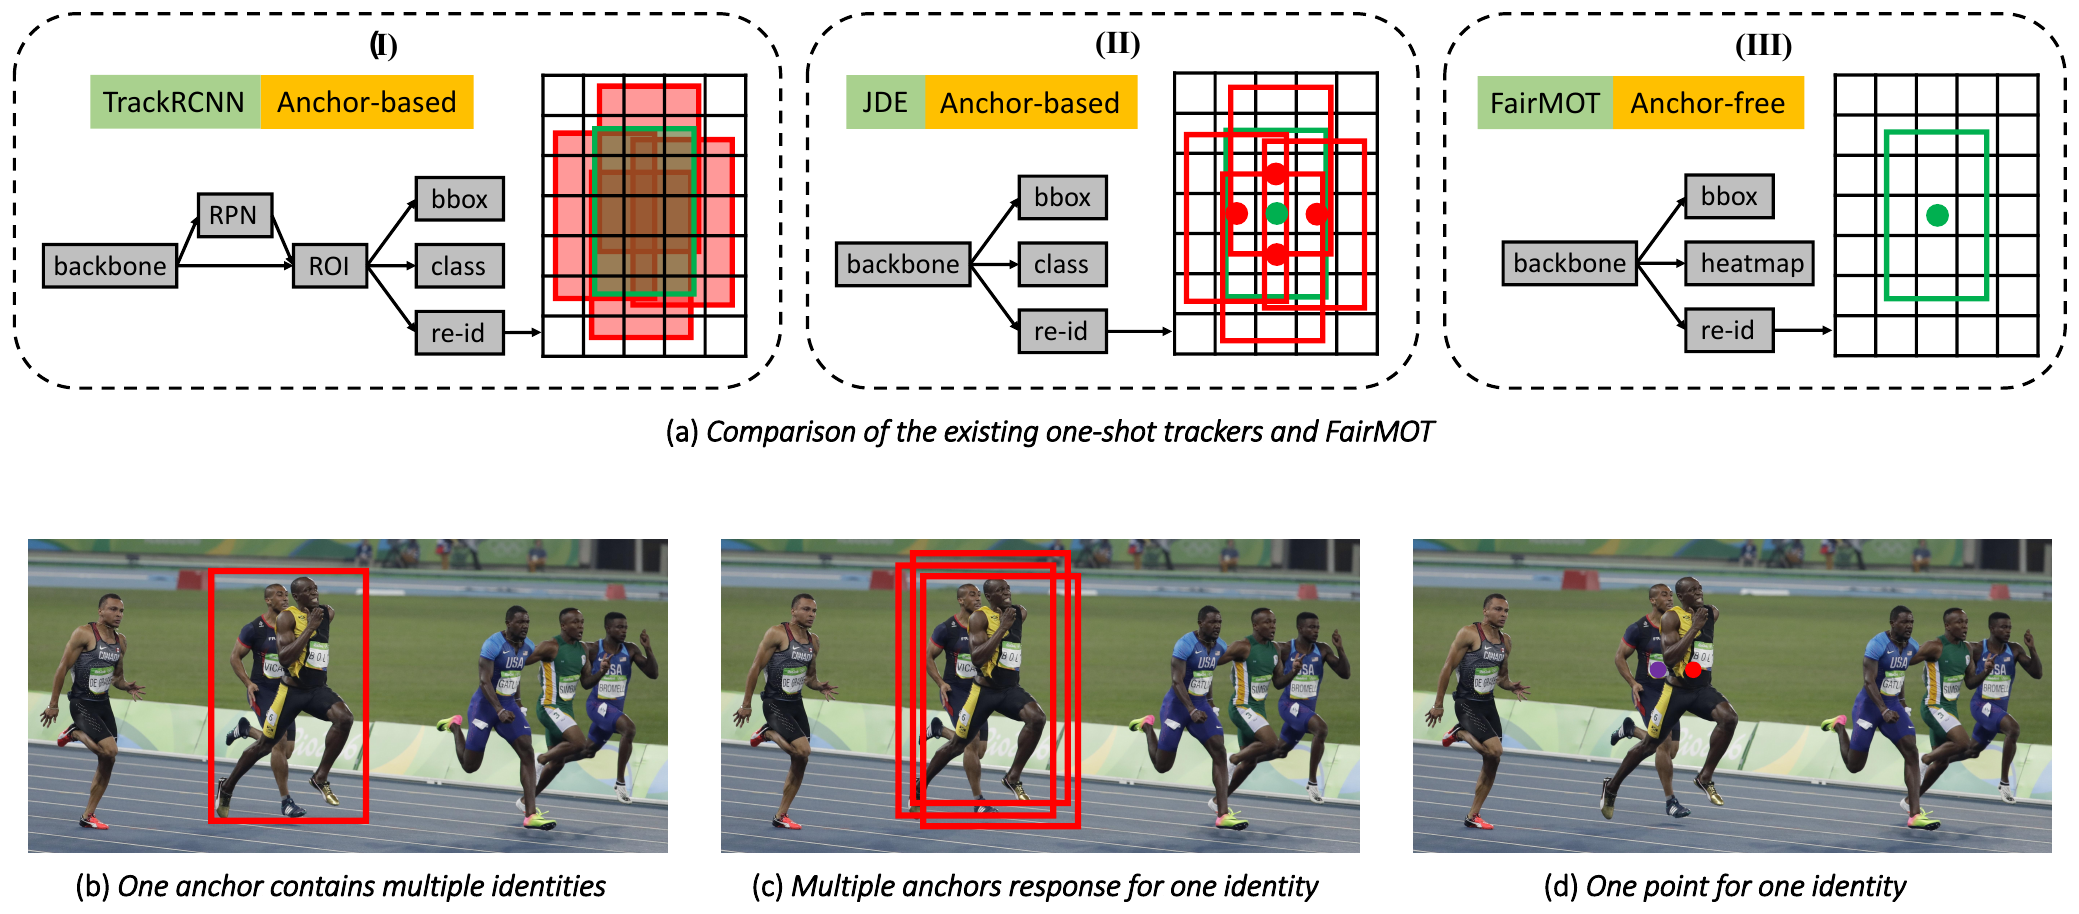
Track R-CNN 和 JDE 都改自以锚框(anchor)为基础的检测器,re-ID 特征也跟着锚框走。这带来三个麻烦:
- re-ID 被当成次要任务。 Track R-CNN 先用 RPN 生成候选框,再从候选框提取 re-ID 特征。候选框不准,特征就没用,所以训练时网络会优先把候选框学好,re-ID 排在后面。
- 一个锚框对应多个人。 图 (b) 的红框同时框到两名运动员。用 RoI-Align 在框里采样,很多采样点落在别人身上或背景上,提取出来的特征就混进了好几个人。
- 多个锚框对应同一个人。 图 (c) 里,三个位置不同的锚框,因为和同一名运动员的 IoU 都够大,都被要求输出同一个身份。这三个锚框看到的图像区域其实不一样,却要学出同一个特征;数据增强稍微平移一下图像,同一个锚框又可能被分配给另一个人。
另外,检测器的特征图通常缩小 8、16、32 倍,对检测还能接受,对 re-ID 就太粗了,锚框的位置很可能没对准物体中心。
特征造成的不公平
检测和 re-ID 要的特征很不一样。检测希望同一类物体的特征越像越好,不管这个人穿什么衣服,都要认出「这是人」;re-ID 却要把同一类的不同个体分开,需要更多底层的外观细节。
两个任务共用同一份特征,就会互相拉扯。
维度造成的不公平
re-ID 领域习惯用 512 或 1024 维的特征,而检测头的输出只有类别数加上几个框坐标。作者认为,两边维度差这么多,会让 re-ID 的损失压过检测。
更重要的是,多目标跟踪的 re-ID 和一般的 re-ID 不一样。一般的 re-ID 要拿一张查询图像去比对上万张候选,需要很高的判别力;跟踪只需要在相邻两帧之间,做少量一对一的匹配。跟踪用不到那么高的维度。
解决问题
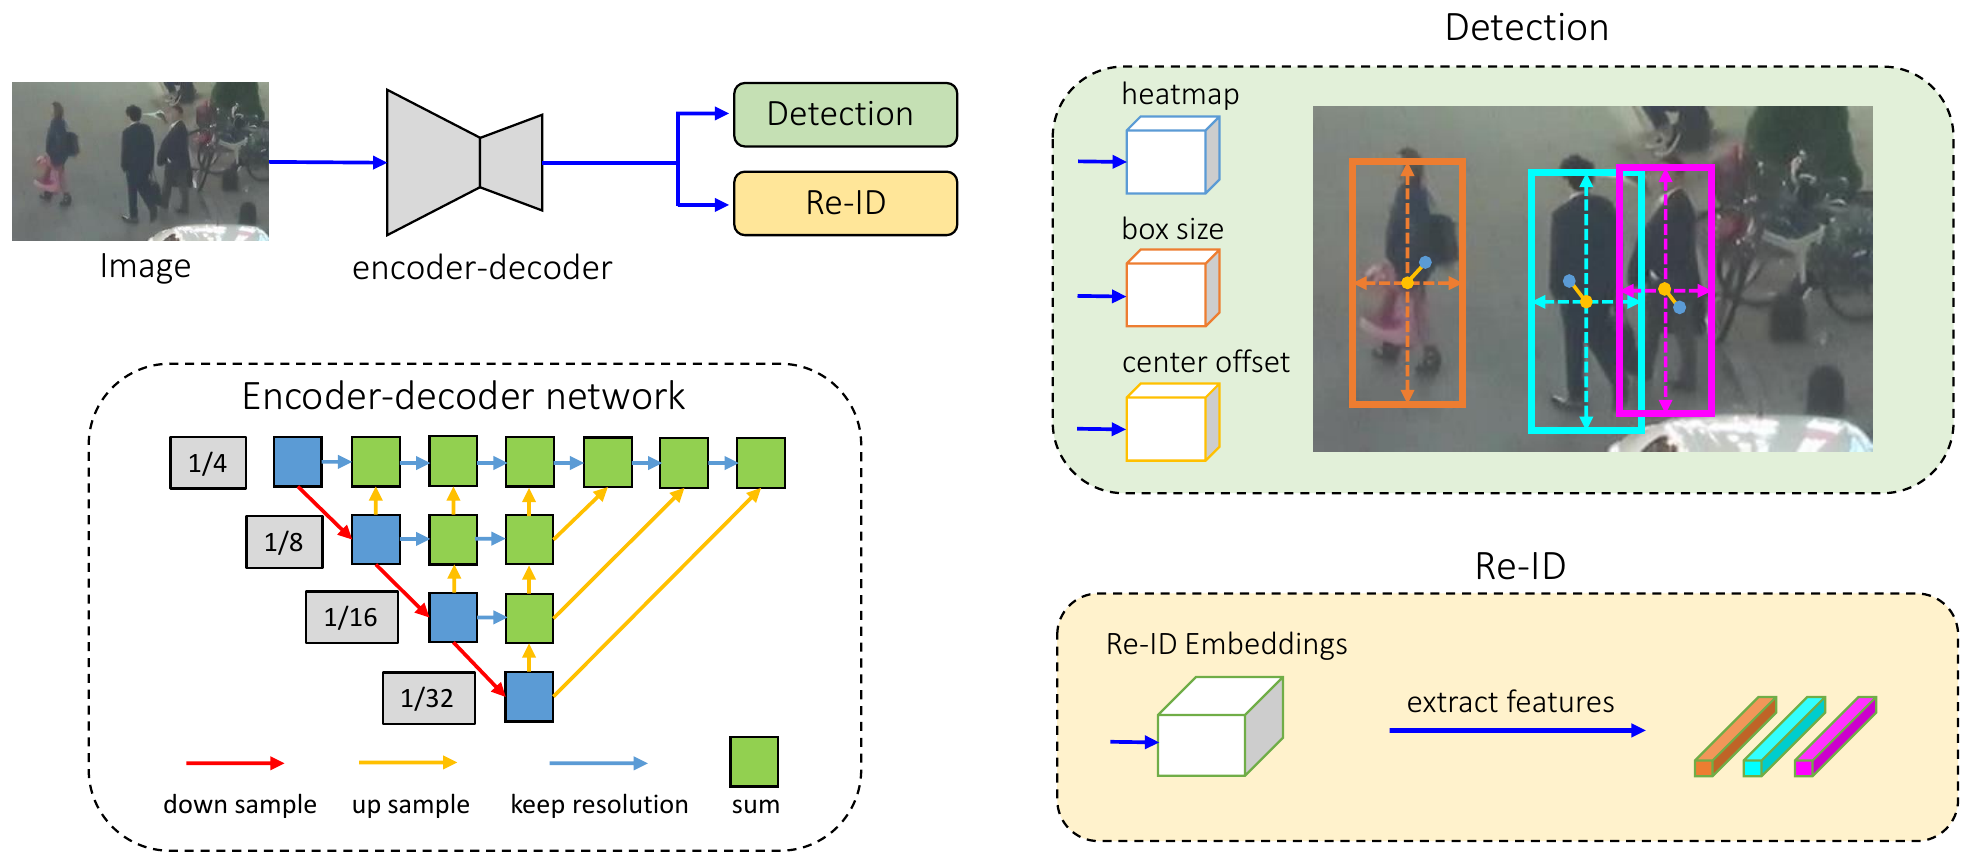
FairMOT 对三个不公平各补一刀。不用锚框,改用 CenterNet 那种以中心点表示物体的检测方式;用多层特征融合的骨干,让两个任务各取所需;把 re-ID 特征的维度压低。
两个分支的结构完全相同,都直接接在骨干输出的同一张特征图上,不分先后。
骨干
骨干是 DLA-34,由 ResNet-34 加上深层聚合(Deep Layer Aggregation)的多层融合结构组成,上采样模块里的卷积全换成可变形卷积(deformable convolution),让感受野能随物体的大小和姿态调整。
输出特征图是输入的 1/4。训练和推理时,输入图像统一缩放到 ,特征图就是 。
跟着一个人走一遍
我们用一个人来看两个分支怎么在同一张特征图上分工。
假设在 的输入图像上,某个人的真实框是 。
第一步,找中心。 框的中心是 。特征图缩小 4 倍,中心落在 ,取整后是特征图上的格子 。
第二步,热图。 热图分支输出一张 的图。训练目标是在 放一个值为 1 的峰,周围以高斯函数往外递减。如果有 个物体,目标热图是
损失用 CenterNet 的 focal loss 形式。峰值位置要预测得接近 1,其他位置要接近 0,但离峰值越近的位置,预测错了扣得越少。
第三步,偏移与大小。 取整时丢掉了 ,最多会有 4 个像素的误差。偏移分支在 这个格子要预测出 ,把中心补回精确位置;大小分支在同一个格子预测框的宽高 。两者都用 L1 损失,大小项的权重 ,沿用 CenterNet 的设置。
第四步,re-ID。 re-ID 分支用一层 128 个卷积核的卷积,输出 ,每个格子都有一个 128 维的特征。这个人的特征,就是 在 的那一根向量 。
FairMOT 的关键设计就在这里。一个人只对应特征图上的一个点,热图、偏移、大小、re-ID 全部从这一点读出来。没有锚框,也就没有「一个锚框两个人」或「三个锚框一个人」的问题。
re-ID 怎么训练
re-ID 的训练被当成分类问题。训练集里每一个身份都是一类,共 类。从物体中心取出的特征,经过一层全连接和 softmax,得到这个物体属于各个身份的概率 ,再用交叉熵计算损失:
训练时只用真实中心点上的特征。推理时,物体中心由热图决定,取出来的特征直接拿去做比对,分类层用不到。
两个任务怎么平衡
检测损失是热图加上框的损失,。两个任务的损失不是直接相加,而是用 Kendall 等人提出的不确定性加权:
和 是可学习的参数。某个任务的损失越大、越不确定,它的权重就会被调小,但 这两项又惩罚权重无限缩小。网络自己决定两边各拿多少。
只用单张图像也能训练
跟踪数据需要跨帧的身份标注,很贵。作者另外提出「单张图像训练」,拿 CrowdHuman 这种只有框、没有身份的行人检测数据,把每一个框都当成一个独立的身份,再对整张图像做旋转、缩放、平移、色彩等增强。
这样训练出来的 re-ID,学的是「这个人和画面里其他人不同」。论文把这个方法称为自监督,官方代码的说明则写成弱监督;不管叫什么,它用的是框标注,省下的是身份标注。
推理与关联
推理时,对热图做一次 的最大池化当作非极大值抑制,保留分数高于阈值的峰值,再从偏移和大小分支算出框,从 re-ID 分支取出特征。
关联沿用 MOTDT 的两阶段做法:
- 第一阶段:外观为主。 用卡尔曼滤波预测每条轨迹的位置,计算马氏距离 ;再算轨迹与检测之间 re-ID 特征的余弦距离 。两者加权成 ,,马氏距离太大的匹配直接排除。用匈牙利算法匹配,阈值 0.4。
- 第二阶段:IoU 补漏。 剩下没匹配上的检测框和轨迹,改用框的 IoU 再匹配一次,阈值 0.5。
轨迹的外观特征每一帧都会更新,以适应外观变化。最后还没匹配上的检测框成为新轨迹;没匹配上的轨迹保留 30 帧,等它可能回来。
讨论
训练数据和 JDE 相同,称为 MIX。其中 ETH 和 CityPersons 只有框,只训练检测分支;CalTech、MOT17、CUHK-SYSU、PRW 有身份标注,两个分支一起训练。消融实验都在 MOT17 验证集上进行。
re-ID 的质量用 TPR@FAR=0.1 衡量,也就是用真实框位置的特征做检索,在误接受率 0.1 时的真阳性率。这个指标不受检测结果影响,只看特征本身好不好。
特征要在哪里取
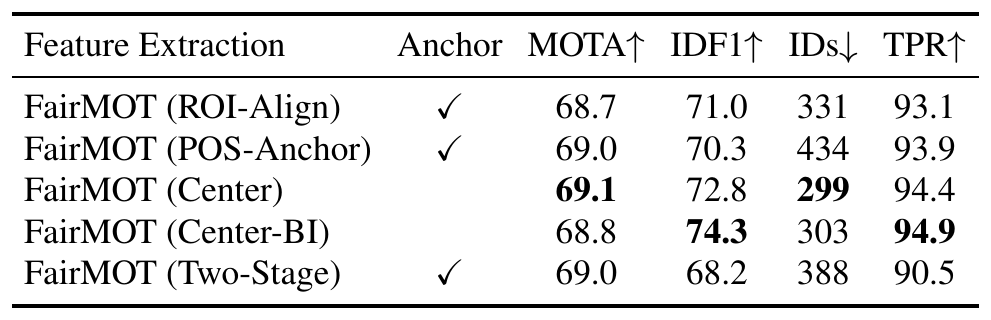
五种方法都建立在 FairMOT 上,唯一的差别是 re-ID 特征从哪里取。ROI-Align 是 Track R-CNN 的做法,POS-Anchor 是 JDE 的做法,Center 是 FairMOT 的做法,Center-BI 在中心用双线性插值取得更精确的位置,Two-Stage 则是先检测、再用检测框做 ROI-Align。
MOTA 几乎都在 69 上下,因为检测分支是一样的。差别在 IDF1 和 ID 切换。Center 的 ID 切换 299,比 POS-Anchor 的 434 少了三成;Center-BI 的 TPR 最高。最差的是 Two-Stage,IDF1 只有 68.2,TPR 掉到 90.5。训练时让 re-ID 依赖检测结果,特征质量确实会被拖累。
检测和 re-ID 真的会打架吗
作者做了一个很直接的实验。拿 ResNet-34 当骨干,一组两个分支一起训练,另一组只训练检测分支、re-ID 分支保持随机初始化。
只训练检测时,AP 从 75.1 升到 76.1;两个任务一起训练,检测确实会被拖累。有意思的是,只训练检测的那组 MOTA 还略高(63.7 对 63.6),但 IDF1 从 67.2 掉到 60.4,TPR 从 90.9 掉到 36.7。MOTA 主要看检测,re-ID 的特征几乎没用时,它也看不出来。
换成有多层融合的 DLA-34 之后,AP 是 81.2、TPR 是 94.4,两边都比 ResNet-34 好。作者的解读是,多层融合让两个任务能从不同层取各自需要的特征,冲突就小了。
骨干的比较也支持这一点。ResNet-50 比 ResNet-34 大,ImageNet 准确度也更高,但 MOTA 只从 63.6 到 63.7,ID 切换反而从 435 增加到 501;加上 FPN 的 ResNet-34 参数比 ResNet-50 少,TPR 却从 90.9 升到 94.2。DLA-34 如果把可变形卷积换回普通卷积,MOTA 会从 69.1 掉到 65.0,AP 从 81.2 掉到 78.1。只从中心一点取特征的方法,很依赖感受野能跟着物体大小调整。
维度低一点更好
把 re-ID 特征从 512 维降到 64 维:
- JDE: MOTA 59.9 → 60.3,IDF1 64.1 → 65.0,ID 切换 536 → 474,TPR 76.8 → 82.0。每一项都变好。
- FairMOT: MOTA 68.5 → 69.2,AP 80.9 → 81.3,ID 切换 312 → 283;但 IDF1 从 73.7 略降到 73.3,TPR 从 94.6 略降到 94.3。
FairMOT 这组结果更细致。高维特征本身的判别力确实稍强,但它会拖累检测,检测一差,整体跟踪就跟着差。作者最后采用 128 维。
损失要怎么加权
固定权重(网格搜索得出)的 MOTA 和 AP 最高,TPR 最低,模型偏向检测;MGDA-UB 的 TPR 最高,MOTA 和 AP 最低,偏向 re-ID。GradNorm 的 IDF1 最高,整体最均衡,但训练时间较长。作者最后选择了稍逊一点、也简单得多的不确定性加权。
关联的三个组件
只用 IoU 关联,ID 切换有 648 次;只用 re-ID 特征,降到 435;re-ID 加卡尔曼滤波,342;三者都用,299。在拥挤或相机快速移动的场景,光靠 IoU 会一直换 ID;物体被部分遮挡时,re-ID 特征又不可靠,这时候需要框和运动来补。
单张图像训练
只用 CrowdHuman 单张图像训练、完全没看过身份标注的模型,直接拿去跟踪 MOT17 验证集,MOTA 是 64.1,IDF1 64.9。先在 CrowdHuman 上预训练、再用 MOT17 微调,MOTA 71.1、IDF1 75.6,比只用 MOT17 训练的 67.5、69.9 高出一截,甚至超过用 MIX 加 MOT17 的 69.1、72.8。
MOTChallenge
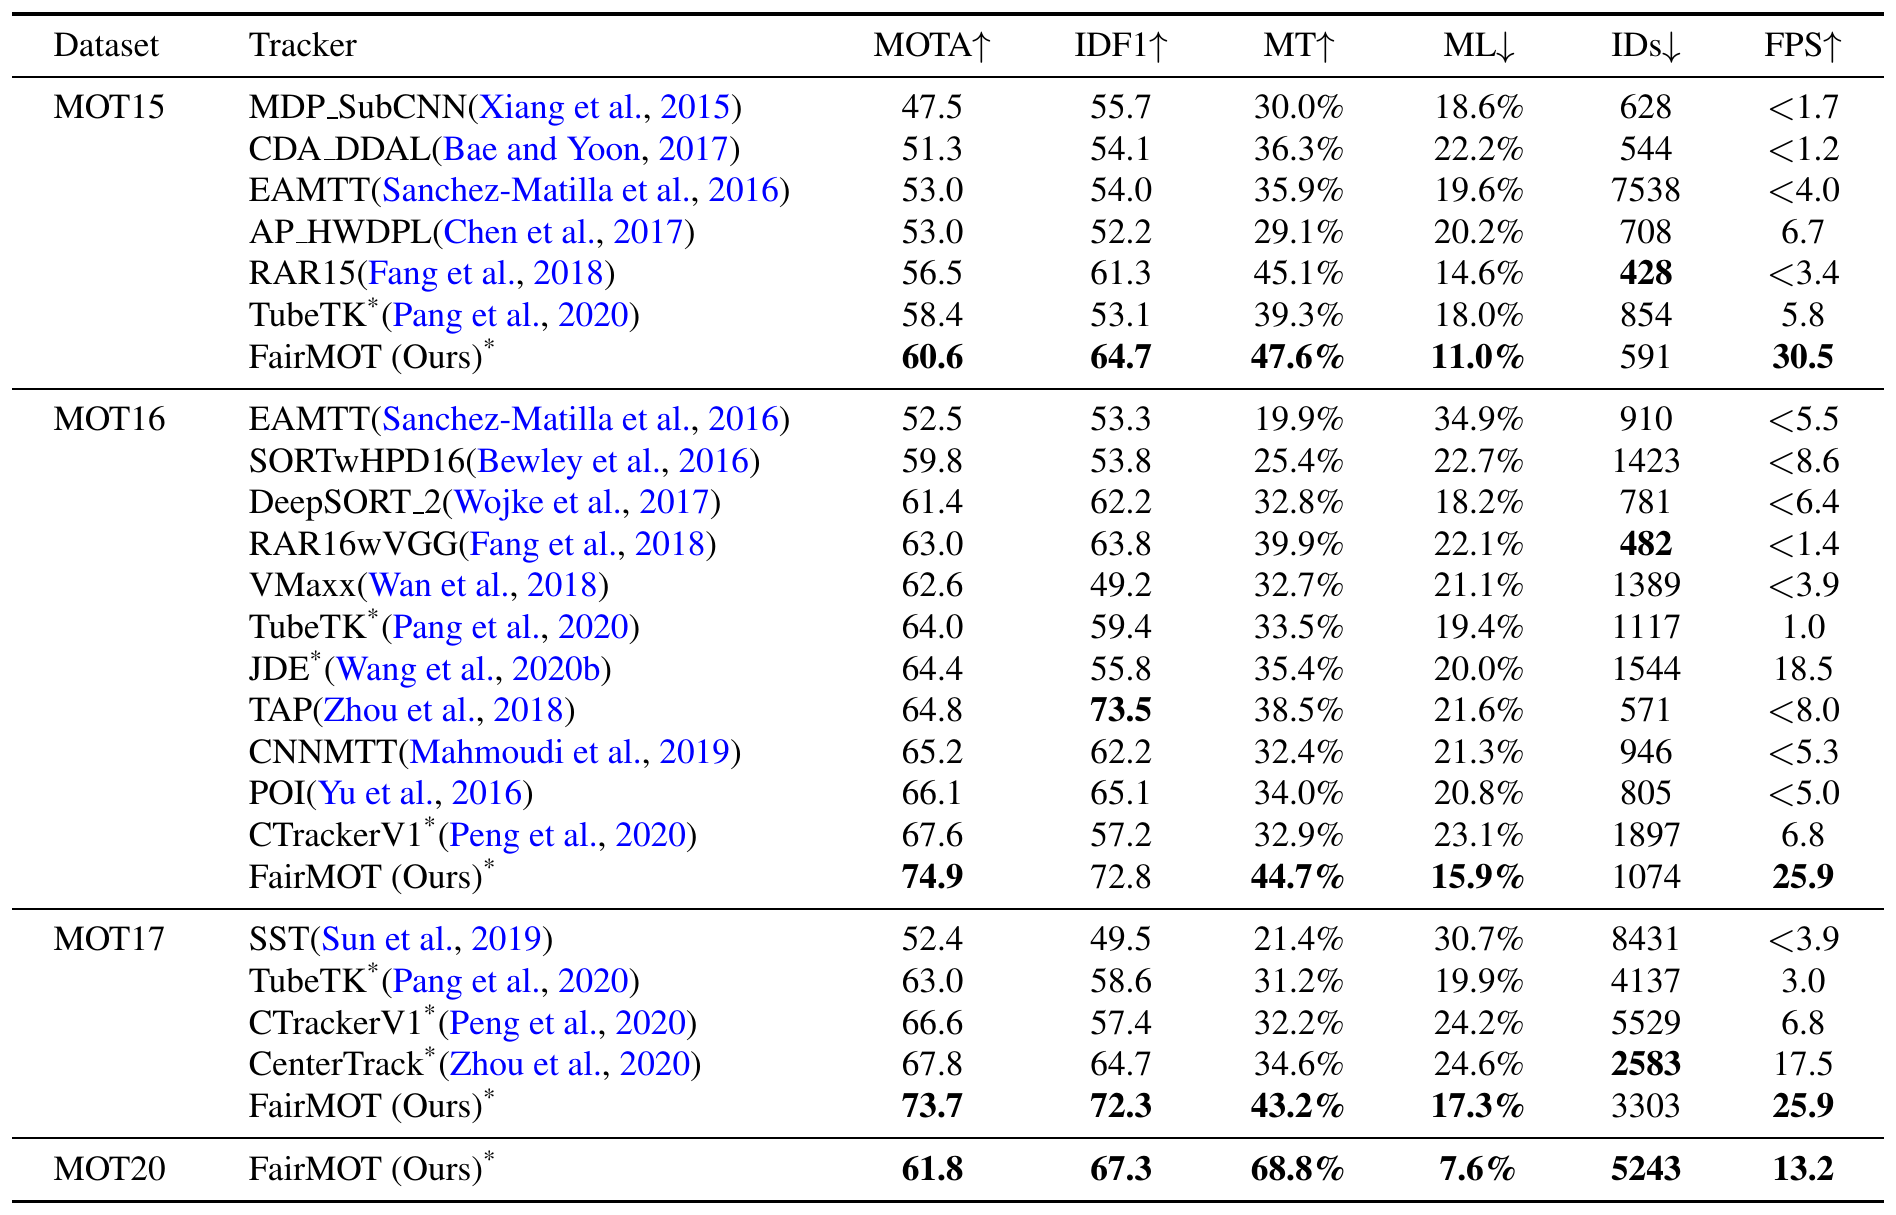
这张表是 private detector 规则,也就是各家用自己的检测器。FPS 同时计入检测和关联,这对 two-step 方法比较严格,也正是 one-shot 跟踪器想证明的事。
FairMOT 在四个数据集上都排第一。MOT17 的 MOTA 73.7、IDF1 72.3,比同为 one-shot 的 CenterTrack 高出约 6 分和 8 分,速度 25.9 FPS。在 MOT16 上,和 DeepSORT(表中的 DeepSORT_2)相比,MOTA 从 61.4 升到 74.9,速度从不到 6.4 FPS 升到 25.9。
不过 ID 切换那一列要细看。MOT16 上,FairMOT 的 1074 次比 DeepSORT_2 的 781 次多。FairMOT 检测得多、MT 高、ML 低,跟踪到的轨迹本来就更多,ID 切换的绝对次数也跟着增加。比较 ID 保持能力时,IDF1 是更合适的指标。
速度方面,FairMOT 在 MOT20 只剩 13.2 FPS。作者分析各部分的耗时发现,检测与 re-ID 的网络推理几乎不受人数影响,卡尔曼滤波和 IoU 匹配只要 1、2 毫秒;随着人数线性增长的,是 re-ID 比对时更新每条轨迹外观特征的时间。
后来
社区后来的批评大多集中在拥挤场景。例如 2023 年的 CSMOT 指出,FairMOT 在拥挤场景中检测不够准,re-ID 特征的判别力也不足,跟踪性能明显下降。本文推测,这和只在中心一点取特征的设计有关。人挤在一起时,一个人的中心点附近,常常就是别人的身体。
结论
one-shot 跟踪器 ID 切换暴增,FairMOT 找到了三个原因。锚框让 re-ID 学到混杂的特征,共享特征让两个任务互相拉扯,高维特征压过检测;对应的解法是以中心点表示物体、用多层融合的骨干、把 re-ID 降到 128 维。结果在四个 MOTChallenge 数据集上都排第一,整个系统每秒约 26 帧。
同一个网络里塞两个任务时,记得另外测 re-ID 的指标。只训练检测的那组,特征已经几乎没用了,MOTA 却还是不动如山。
有趣的是,一年半后张一夫写 ByteTrack 时,在 MOT17 上干脆连 re-ID 都不用了。