原始論文
Towards Real-Time Multi-Object Tracking
- 發表版本
- ECCV 2020會議
- arXiv 首次提交
- arXiv:1909.12605
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingjde2019,
  title = {{Towards Real-Time Multi-Object Tracking}},
  author = {Zhongdao Wang and Liang Zheng and Yixuan Liu and Yali Li and Shengjin Wang},
  year = {2019},
  eprint = {1909.12605},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1909.12605}
}
DeepSORT、POI、MOTDT 這一代追蹤器,做法都差不多。先跑一個偵測器,再把每個偵測框裁下來,送進另一個 re-ID 網路抽外觀特徵。
兩個網路各跑一次,時間就是兩者相加。畫面裡人越多,要跑的 re-ID 就越多,整個系統越慢。
很多論文都說自己是「即時追蹤」,但仔細一看,計時常常只算關聯那一步,偵測器和 re-ID 的時間沒算進去。關聯是即時的,整個追蹤系統卻不是。
清華大學的 Zhongdao Wang 與澳洲國立大學的 Liang Zheng 等人想做一個真正即時的系統。他們讓偵測器順便把人認出來,同一個網路、一次前向傳播,同時輸出偵測框和每個框的外觀特徵。他們把這種作法叫做 JDE(Joint Detection and Embedding)。
定義問題
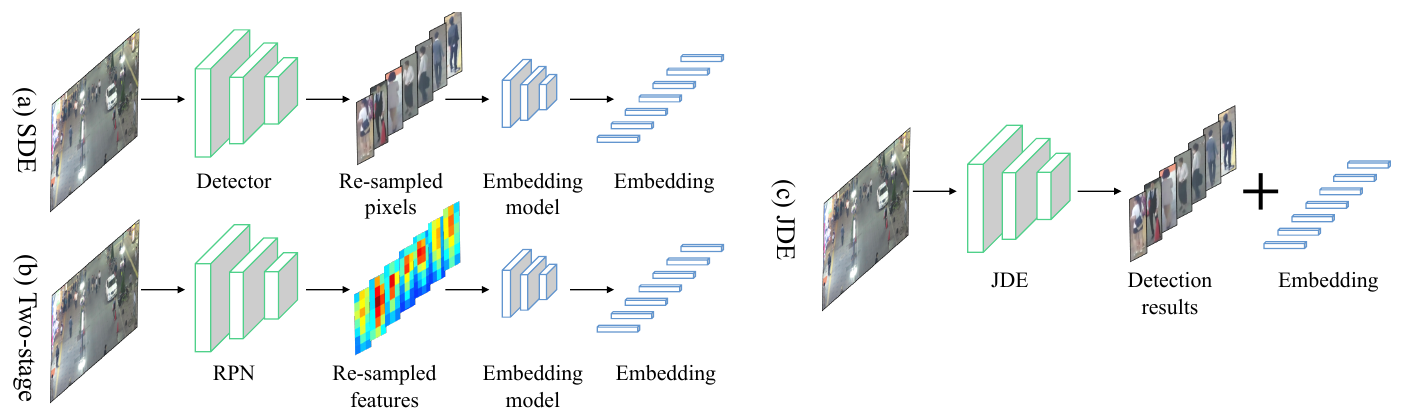
作者把當時的作法分成三類:
- (a) 分開偵測與嵌入(Separate Detection and Embedding, SDE): DeepSORT、POI 都屬於這類。偵測器和 re-ID 模型完全獨立,re-ID 的計算量和人數成正比。
- (b) 兩階段模型: 在 Faster R-CNN 上把第二階段改成學外觀特徵。第一階段的 RPN 照樣輸出框,第二階段從特徵圖上取出每個框的特徵,改用度量學習訓練。這樣能共用一部分計算,但兩階段的設計本身就慢,通常不到每秒 10 幀,而且第二階段的時間一樣會隨人數增加。
- (c) JDE: 在單階段偵測器上直接多加一個輸出,一次前向傳播就得到框和特徵。
要做到 (c),就得讓兩個目標差很多的任務,在同一個網路裡一起學好。作者從訓練資料、網路架構、損失函數、多任務的權重、評估方式五個面向逐一處理。
解決問題
網路架構
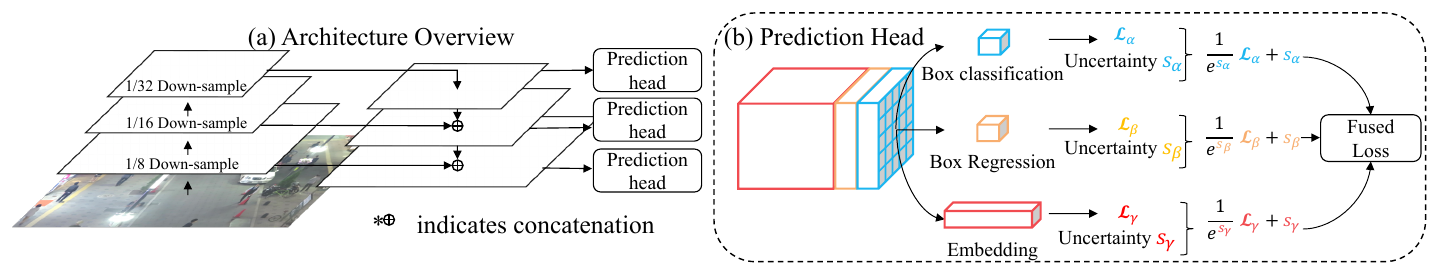
骨幹是 YOLOv3 用的 DarkNet-53,接上特徵金字塔網路(FPN),在三個尺度上做預測,分別是輸入的 1/32、1/16、1/8。行人遠近大小差很多,多尺度預測對偵測有幫助。
每個尺度接一個預測頭,輸出一張大小為 的密集預測圖。 是這個尺度的錨框數, 是嵌入特徵的維度。這張圖分成三份:
- 框分類: ,每個錨框是前景還是背景。
- 框回歸: ,每個錨框的四個修正量。
- 嵌入圖: ,每個位置一個 維的外觀特徵。
我們拿預設的輸入 算一下形狀。三個尺度的特徵圖分別是 、、。論文沒有寫出 的值,FairMOT 的實驗裡 JDE 用的是 512 維。每個尺度 ,所以每個預測頭的輸出通道數是 ,最細的那一層就是一張 的張量。
一個錨框若被判定為前景,就到嵌入圖上同一個位置,取出那裡的 512 維向量,當作這個框的外觀特徵。偵測和外觀特徵是一起算出來的,畫面裡多一個人,計算量也幾乎不變。
偵測分支:為行人調整錨框
偵測分支大致和 RPN 一樣,但做了兩個修改:
- 錨框專為行人設計。 所有錨框的寬高比都是 1:3,總共 12 種大小,每個尺度分到 4 種,寬度從 一路到 像素。
- 前景與背景的門檻。 和真實框 IoU 大於 0.5 算前景,這和一般物件偵測相同;但 IoU 小於 0.4(而不是一般的 0.3)就算背景。作者發現,這樣能有效壓低嚴重遮擋時的誤報。
分類用交叉熵,框回歸用 smooth-L1。
嵌入分支:用分類取代三元組
嵌入要學的是一個空間,讓同一個人的特徵靠在一起、不同人的特徵彼此遠離。最直覺的作法是三元組損失(triplet loss),MOTDT 就是這樣訓練的。但三元組的組合太多,取樣很難,訓練也不太穩定,收斂慢。
作者比較了三種損失:
- 三元組損失: 在一個小批次裡,挖出所有負樣本和最難的正樣本。
- 三元組損失的平滑上界: 一種更穩定、收斂更快的變形。
- 交叉熵: 把訓練集裡每一個身分都當成一個類別,取出的嵌入特徵經過一層全連接,做身分分類。
作者先從公式上比較後兩者。平滑上界可以寫成
交叉熵則是
兩者長得幾乎一樣,差別有兩個。第一,交叉熵用可學習的「類別權重」 代表每個身分,而不是直接用其他樣本的特徵 。第二,交叉熵的分母包含所有其他身分,三元組類的損失只包含這個小批次裡抽到的負樣本。交叉熵要求一個人和自己的類別比和每一個其他身分都像,約束比三元組嚴格得多。
實驗結果也很懸殊。在相同的權重設定下,嵌入在檢索任務上的 TPR@FAR=0.1,三元組只有 42.2,平滑上界 44.3,交叉熵 88.2,整整翻了一倍。
只有框、沒有身分標註的前景錨框,計算嵌入損失時會被忽略。三個尺度的嵌入特徵經過同一層全連接,共用同一個特徵空間,所以不同尺度偵測到的同一個人也能互相比對。
三個損失怎麼平衡
每個預測頭有三個損失,三個尺度加起來就是九個。最簡單的作法是全部等權重相加,但這樣幾乎訓不起來。
作者比較了幾種權重策略:
- 均等權重(Uniform): 偵測的 AP 只剩 6.8。嵌入損失的量級比另外兩個大得多,整個訓練被它主導,偵測完全學不好,MOTA 只有 36.9。
- MGDA-UB: 理論上最完備的多任務最佳化方法,但它給嵌入損失的權重太大,結果和均等權重差不多,AP 8.3。
- 損失正規化(Loss.Norm): 用各損失移動平均的倒數當權重,MOTA 57.9。
- 近似最佳權重(App.Opt): 限制成兩個獨立變數,人工搜尋出一組權重,MOTA 64.3。
- 依不確定性加權(Uncertainty): 每個損失配一個可學習的參數 ,讓網路自己決定權重:
最後這個方法是唯一超過人工搜尋的,AP 83.0、TPR 90.4、MOTA 65.8,ID 切換 207 也是最少。隔年的 FairMOT 沿用了同一套加權方式。
訓練資料
JDE 需要同時有框和身分標註的資料,但追蹤資料集太小。作者把六個公開資料集拼成一個大訓練集。ETH 和 CityPersons 只有框,只訓練偵測;CalTech、MOT16、CUHK-SYSU、PRW 有身分標註,兩個分支一起訓練。總共約 5.4 萬張影像、27 萬個框、8,700 個身分。ETH 裡和 MOT16 測試集重疊的影片已經剔除。
這個組合後來在 FairMOT 裡被稱為 MIX,成了 one-shot 追蹤器的標準訓練資料。
關聯
關聯不是這篇的重點,作者設計了一套簡單快速的線上關聯。每條軌跡記錄一個外觀狀態 和一個卡爾曼濾波的運動狀態。每一幀,計算所有偵測和軌跡之間的外觀相似度 (餘弦相似度)與運動距離 (馬氏距離),加權成成本:
用匈牙利演算法配對後,軌跡的外觀狀態用指數移動平均更新:
連續兩幀都出現的偵測才開新軌跡;30 幀沒更新的軌跡才刪除,中間的軌跡留在一個暫存池裡,回來時還能接上。
這個 EMA 更新後來被 StrongSORT 和 BoT-SORT 直接借用。作者也提到,把卡爾曼濾波向量化(一次處理所有軌跡)對速度很關鍵,網路已經很快的時候,關聯反而容易變成瓶頸。
討論
JDE 用 SGD 訓練 30 個 epoch,輸入解析度預設 。驗證時,偵測看 CalTech 驗證集的 AP,嵌入看三個資料集上的檢索 TPR,追蹤看 MOT15 訓練集的 MOTA;最後在 MOT16 測試集上比較。
關聯方法
作者先把同一個 JDE 模型分別接上 SORT 和自己的關聯方法。在人少的 MOT15 上,自己的方法 MOTA 67.5、IDF1 67.6,SORT 是 66.9 和 55.8,速度也從 44.1 升到 46.2 FPS。在人多的 CVPR19-01 序列上(平均每幀 61 人),速度從 26.4 升到 33.9 FPS,MOTA 和 IDF1 只小幅提升。IDF1 的大幅改善,主要來自外觀特徵。
和分開的系統比
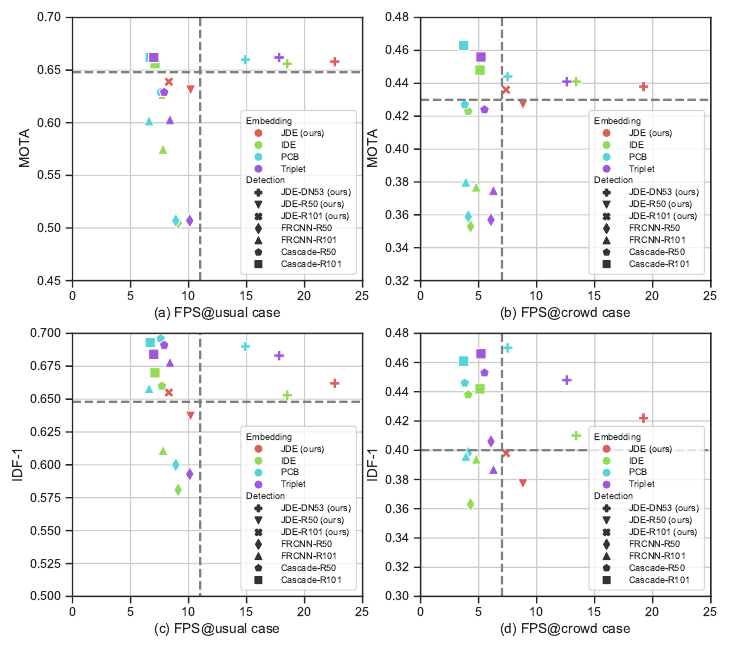
為了公平,作者用完全相同的訓練資料,把幾種偵測器(JDE、Faster R-CNN、Cascade R-CNN)和幾種 re-ID 模型(IDE、Triplet、PCB)兩兩組合,再接上同一套關聯。
- 速度與準確度的取捨最好。 在人少的情況下,JDE 每秒 22 幀,MOTA 65.8;最強的組合 Cascade R-CNN(ResNet-101)加 PCB,MOTA 66.2,但只有每秒約 6 幀。
- 人多的時候差距更明顯。 所有 SDE 組合在擁擠場景都大幅變慢,因為 re-ID 的時間和人數成正比;JDE 的嵌入和偵測一起算,速度幾乎不受影響,變慢的部分主要來自關聯。
- 聯合學習的嵌入不比分開學的差。 固定 JDE 的偵測器,換上獨立訓練的 IDE、Triplet、PCB 嵌入,追蹤準確度都很接近,JDE 甚至略勝 IDE。
但 IDF1 那一側就沒那麼漂亮了。在擁擠場景,JDE 的 IDF1 掉得比強的 SDE 組合更多。
MOT16 測試集
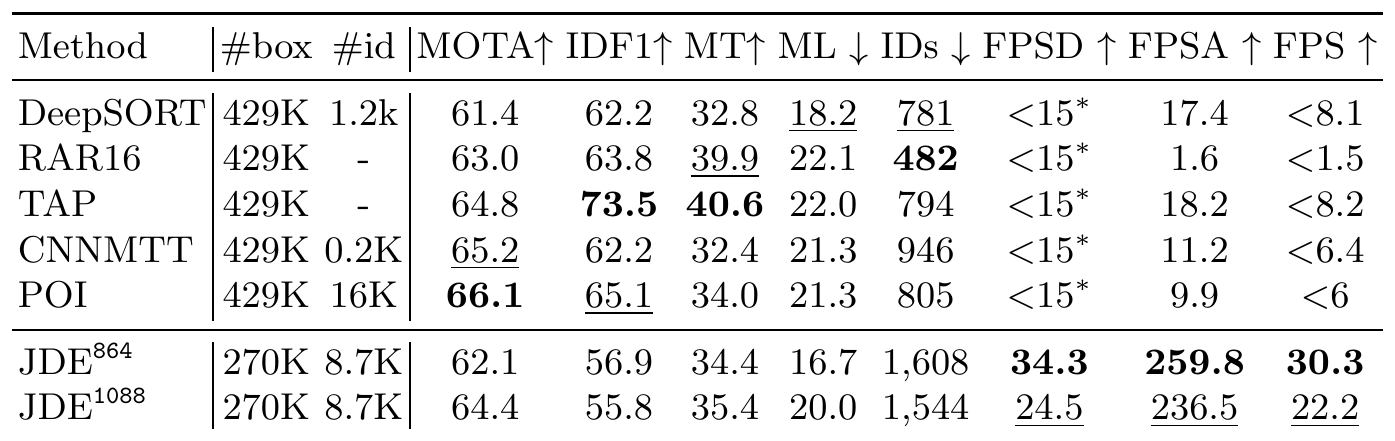
JDE 用了額外的訓練資料,所以在 MOT16 的 private 規則下比較。對手都用同一個以大型私有行人資料訓練的 Faster R-CNN,差別在 re-ID 模型和關聯方式。
MOTA 上,JDE 的 64.4 比 DeepSORT 高 3 分,比 POI 低 1.7 分,而它用來訓練的框只有對手的六成多(27 萬對 42.9 萬個)。速度上,很多方法沒有回報完整的時間,作者重新實作了它們共用的偵測器來估計上限;就算用這麼寬鬆的上限比較,JDE 每秒 22.2 幀,也快了至少兩三倍。把輸入寬度縮小到 864,速度提升到 30.3 FPS,MOTA 只掉到 62.1。
但 IDF1 和 ID 切換是 JDE 的明顯弱點。IDF1 55.8,比 DeepSORT 的 62.2、POI 的 65.1 都低;ID 切換 1,544,將近其他方法的兩倍。
問題出在框
作者一開始懷疑,是聯合學習的嵌入比較弱。但把嵌入換成獨立訓練的模型之後,IDF1 和 ID 切換幾乎沒變。
真正的原因在偵測。行人大量重疊時,單階段偵測器的框容易飄移、對不準,用對不準的框去取特徵,特徵就會混到別人身上,ID 跟著換掉。這些 ID 切換常常發生在軌跡中段,所以 IDF1 掉得特別多。作者把「如何在行人嚴重重疊時讓框更準」留給未來的研究。
後來
這個問題半年後就有人接手了。FairMOT 認為問題出在錨框。一個錨框可能框到好幾個人,好幾個錨框也可能對應同一個人,re-ID 特徵因此學得含糊。它改用無錨框的中心點表示,並把嵌入降到 64 或 128 維。在 FairMOT 的實驗裡,光是把 JDE 的嵌入從 512 維降到 64 維,MOTA、IDF1、ID 切換就全部變好了。
結論
JDE 把外觀特徵塞進單階段偵測器,一次前向傳播同時輸出框和特徵,是第一個接近即時的完整多目標追蹤系統。它在 MOT16 上的 MOTA 和分開訓練的強系統相近,速度快了兩三倍,而且人越多,優勢越明顯。
這篇裡最值得帶走的是兩個訓練細節。嵌入用身分分類的交叉熵,比三元組損失好上一倍;多任務的權重交給不確定性參數去學,比人工搜尋還好。這兩招在後來的 one-shot 追蹤器裡幾乎成了標配。
論文標題寫的是「Towards」,作者自己也很清楚,框對不準的那一段路,還得留給下一篇來走。