原始论文
Quasi-Dense Similarity Learning for Multiple Object Tracking
- 发表版本
- CVPR 2021会议
- arXiv 首次提交
- arXiv:2006.06664
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingqdtrack2020,
  title = {{Quasi-Dense Similarity Learning for Multiple Object Tracking}},
  author = {Jiangmiao Pang and Linlu Qiu and Xia Li and Haofeng Chen and Qi Li and Trevor Darrell and Fisher Yu},
  year = {2020},
  eprint = {2006.06664},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.06664}
}
到了 2020 年,多目标跟踪的关联主要靠位置。
SORT 用 IoU,CenterTrack 预测中心点位移,Tracktor 让检测器的回归头把框推到下一帧。只要检测够准,相邻两帧之间的位置关系就是很强的线索。外观特征通常只在旁边帮忙,用来找回消失了一阵子的目标,而且搜索范围还得限制在附近,因为外观特征不够可靠,范围一放大反而容易认错。
但人类跟踪物体,常常只看长相就够了。浙江大学的 Jiangmiao Pang、ETH Zürich 的 Fisher Yu、UC Berkeley 的 Trevor Darrell 等人认为,外观特征不可靠,是因为训练的方式太浪费。
定义问题
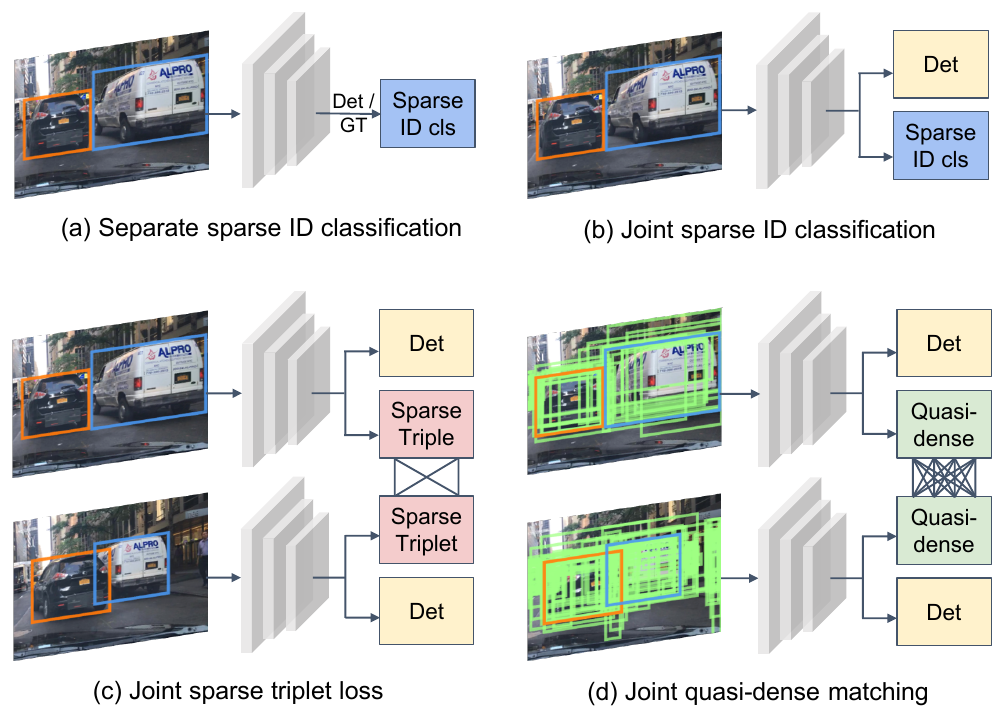
当时学外观特征的方法,大致分成这几种:
- 身份分类: 把训练集里的每个身份当成一类,例如 DeepSORT 的 re-ID 模型,以及 JDE、FairMOT 加在检测器上的嵌入分支。数据集越大,类别数越多,越难扩展。
- 三元组损失: 每个样本只和一个正样本、一个负样本比较。
不管哪一种,训练样本都只有真实框,一张图像上可能就十几个。
可是检测器在每张图像上会提出几百个候选区域。靠近真实框的那些,可以当作额外的正样本;落在背景上的,就是现成的困难负样本。这些区域原本只用来训练检测,学外观时全被丢掉了。
作者想把这些候选区域全部拿来学外观。如果特征空间学得够好,关联时就不需要位置、运动、位移预测,只要在特征空间里找最近邻就好。
解决问题
准密集采样
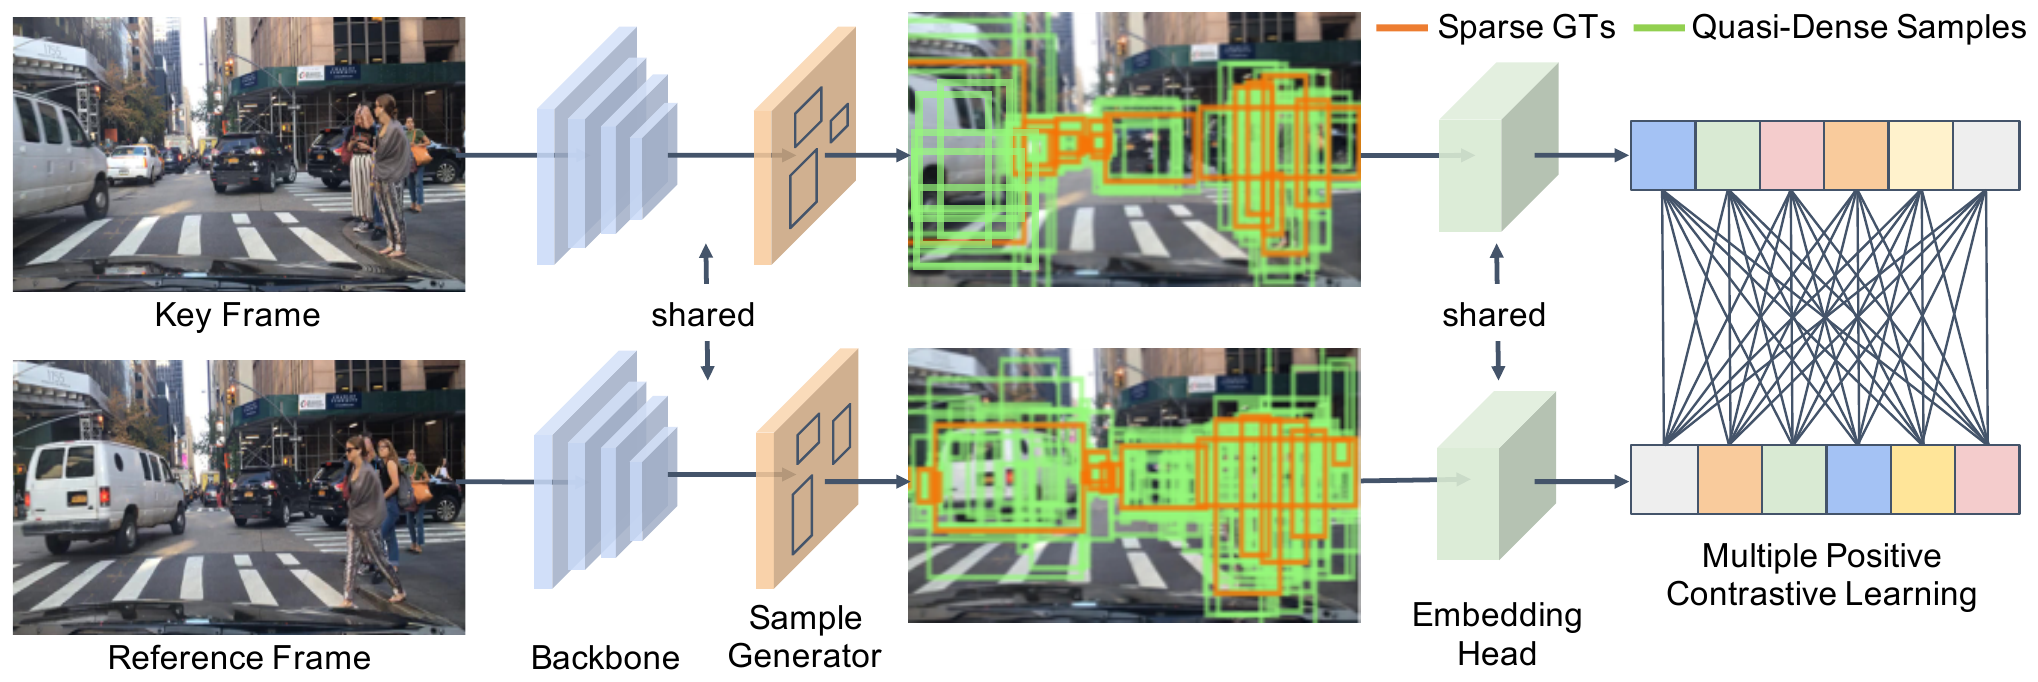
作者把「稠密匹配」定义为在所有像素位置上比对候选框;「准密集」只取可能有物体、有信息量的区域,也就是 RPN 提出的候选框。
检测器是标准的 Faster R-CNN 加 FPN,骨干 ResNet-50。在原本的框分类与框回归头旁边,并行加了一个轻量的嵌入头(4 层卷积加 1 层全连接),每个候选框输出一个 256 维的特征。
训练时,每次取一张关键帧,再从它前后 3 帧内随机挑一张参考帧。两张图像各自跑 RPN,得到候选框:
- 一个候选框和某个真实物体的 IoU 大于 0.7,就算是那个物体的样本;IoU 小于 0.3 就算背景。
- 关键帧上的候选框和参考帧上的候选框,如果属于同一个物体,这一对就是正样本,否则是负样本。
关键帧取 128 个候选框当训练样本,参考帧取 256 个当对比目标,正负各半。每个训练样本要和参考帧上的全部 256 个目标比较。
多正样本的对比损失
只有一个正样本时,可以用标准的 softmax 交叉熵。设 是训练样本的特征, 是正样本, 是负样本:
但准密集采样之后,一个训练样本在参考帧上会有好几个正样本,同一个物体附近的候选框都算。直接把正样本求和放进分子,会让每个负样本被重复计算好几次,正样本却只算一次。
作者先把上式改写成
再把正样本也一起累加:
这样每一组正负样本都被公平地比较一次。
另外加一个辅助的 L2 损失,约束特征的余弦相似度:
正样本对 ,负样本对 。作者说明这个损失的作用是约束 logit 的大小和余弦相似度,并不直接提升效果。
整体损失是
其中 、。附录提到 超过 0.5 时效果会下降。
只靠外观的关联
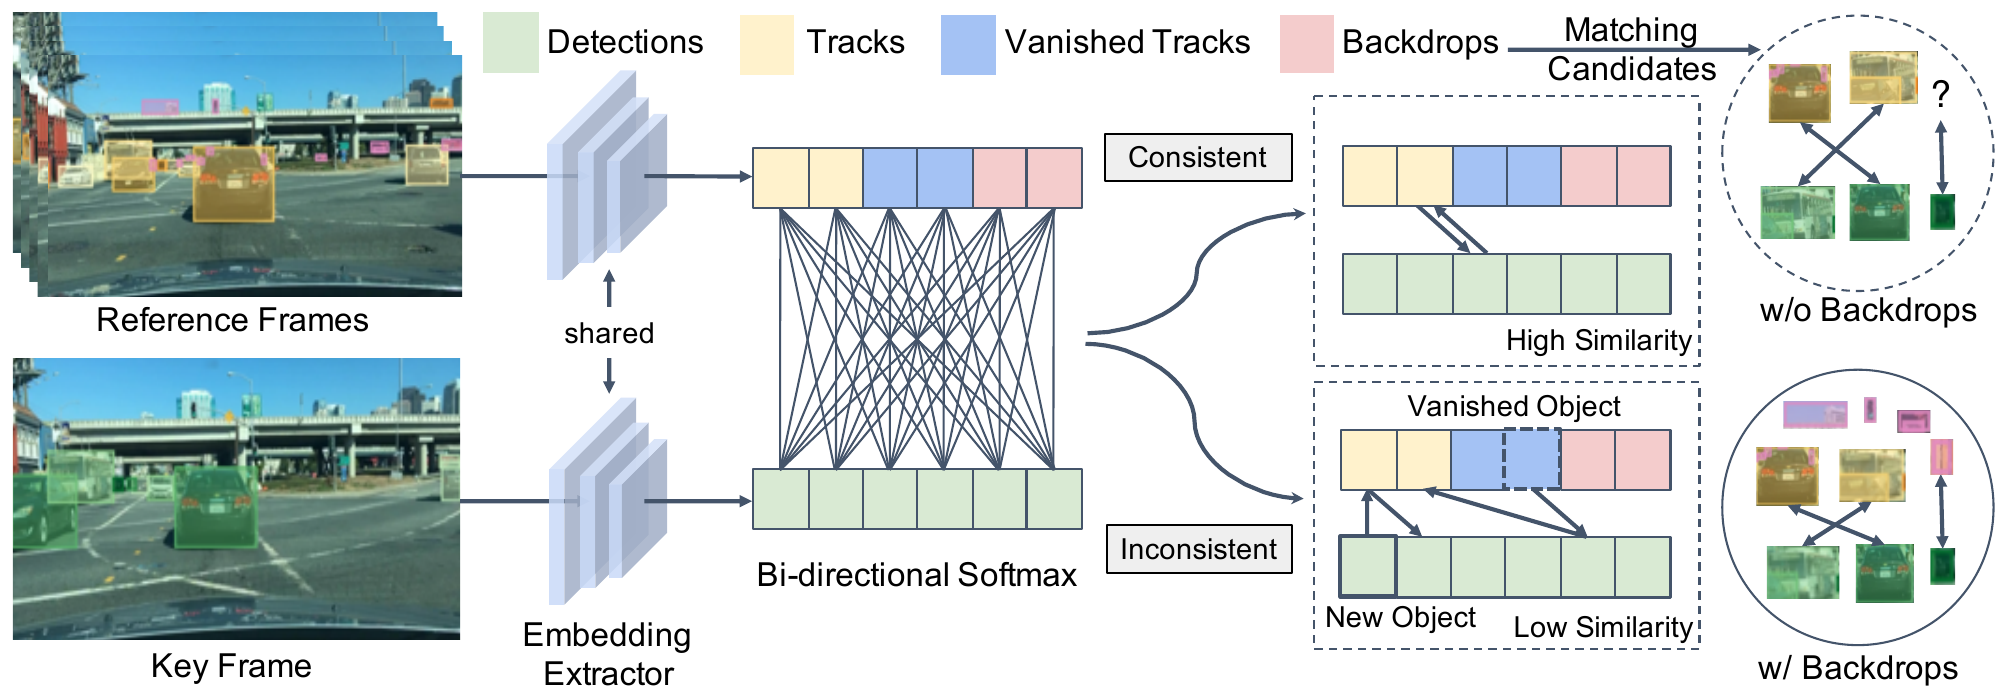
推理时,关联完全不用位置。但只靠特征找最近邻,碰到一个检测根本没有对应的轨迹(新物体、误报),或是有好几个看起来都像的候选,就很麻烦。作者用三个设计来处理。
双向 softmax。 当前帧有 个检测,特征为 ;匹配候选有 个,特征为 。两者的相似度取两个方向 softmax 的平均:
第一项问的是「在所有候选里,检测 最像谁」,第二项问的是「在所有检测里,候选 最像谁」。只有两边互为最近邻时,分数才会高。新出现的物体在候选里找不到真正的对象,两个方向的分数很难同时高,自然不会被匹配上。
保留背景框(backdrops)。 以往的方法会直接丢掉没匹配上任何轨迹的检测。作者认为这些框虽然大多是误报,但下一帧的误报很可能长得跟它一样。把它们保留一帧,当作匹配候选,下一帧的误报就会去配这些背景框,不会被硬塞给真正的轨迹。
跨类别去重。 一般的检测器只在同一类别内做非极大值抑制,同一个位置可能同时出现「行人」和「骑行者」两个框,各自带着几乎一样的特征。作者在关联前再做一次跨类别的非极大值抑制,高置信度框阈值 0.7,低置信度框 0.3。
剩下的都是常见的阈值。检测置信度大于 0.8 才新建轨迹,消失的轨迹保留 10 帧,轨迹特征用动量 0.8 更新,只有同类别的物体可以互相匹配。
讨论
哪些设计有用
| 训练 | 相似度 | 去重 | 背景框 | MOTA | IDF1 | 行人 MOTA | 行人 IDF1 |
|---|---|---|---|---|---|---|---|
| 稀疏 | cosine | 60.4 | 63.0 | 37.6 | 49.7 | ||
| 准密集、单正样本 | cosine | 61.5 | 66.8 | 40.5 | 52.7 | ||
| 准密集、多正样本 | cosine | 62.5 | 67.8 | 44.0 | 54.3 | ||
| 准密集、多正样本 | bi-softmax | 62.9 | 70.0 | 45.5 | 58.8 | ||
| 准密集、多正样本 | bi-softmax | ✓ | 63.2 | 70.1 | 45.5 | 58.3 | |
| 准密集、多正样本 | bi-softmax | ✓ | ✓ | 63.5 | 71.5 | 46.7 | 60.2 |
整理自原论文 Table 4,BDD100K 跟踪验证集。
消融做在 BDD100K 的验证集上。这是一个行车记录仪数据集,有 8 个类别,比 MOT17 大得多。
从稀疏改成准密集,IDF1 从 63.0 升到 67.8。其中光是增加负样本、仍用单正样本的损失,就贡献了 3.8 分,约占这段改善的八成。对比目标越多,就算大部分是负样本,特征也学得更好。多正样本的损失再加 1 分。
推理端,双向 softmax 让 IDF1 再多 2.2 分,行人类别多了 4.5 分。去重和背景框再加 1.5 分。从头到尾,IDF1 总共提升了 8.5 分,ID 切换少了 30%。行人这一类最明显,MOTA 和 IDF1 分别多了 9.1 和 10.5 分。
位置还有没有用
| 外观 | IoU | 运动 | 回归 | mMOTA | mIDF1 |
|---|---|---|---|---|---|
| ✓ | 26.3 | 36.0 | |||
| ✓ | ✓ | 27.7 | 38.5 | ||
| ✓ | ✓ | 28.6 | 39.3 | ||
| ✓ | 36.6 | 50.8 | |||
| ✓ | ✓ | 36.3 | 49.8 | ||
| ✓ | ✓ | ✓ | 36.4 | 49.9 | |
| ✓ | ✓ | ✓ | 36.4 | 50.1 |
整理自原论文 Table 5,BDD100K 跟踪验证集;mMOTA、mIDF1 是 8 个类别的平均。
作者照 Tracktor 的做法,用同一个检测器加上 IoU、运动模型、框回归等位置线索。
没有外观特征时,每多一种位置线索,效果都会提升。但有了准密集学到的外观特征之后,再加任何位置线索都没有帮助,甚至略降。最好的结果就是只用外观。
外观特征学得够好,就不需要位置线索,这是这篇最核心的主张。不过这是在 BDD100K 上的结果。它的跟踪标注是每秒 5 帧,相机又装在行进中的车上,相邻两个标注帧之间,物体的位置和大小都可能变化很大,位置线索本来就没那么可靠。
各个基准
QDTrack 在四个基准上都报告了结果,除了 COCO 预训练以外,没有用额外的训练数据。
- MOT17(私有检测): MOTA 68.7、IDF1 66.3,每秒 20.3 帧。比当时的 CenterTrack 高 0.9 和 1.6 分,而 CenterTrack 还用了额外数据。ID 切换 3,378 比 CenterTrack 的 3,039 多,作者的解释是它的召回率更高,FN 少了 1.4 万个,跟踪到的轨迹越多,换 ID 的机会也越多。
- BDD100K: 测试集 mMOTA 35.5、mIDF1 52.3,比官方基线高出 9.2 和 7.6 分,也赢过 2020 年 BDD100K 跟踪挑战赛的冠军。
- Waymo: 验证集的车辆类别 MOTA 55.6,比 RetinaTrack 高 10.7 分。换上 ResNet-101 和可变形卷积后,测试集上的成绩和 2020 年 Waymo 2D 跟踪挑战赛的冠军相当,而它只是一个单一模型。
- TAO: 这个数据集有数百个类别,长尾分布很严重。整体 AP50 只比基线高 2 到 3 分,但行人这个常见类别是 38.6 对 18.5。
瓶颈在检测
附录里的两个 oracle 实验很有参考价值。
把检测换成真实框,再用 QDTrack 的特征去关联,8 个类别的平均 IDF1 是 88.8,比原本高了 38 分。反过来,检测保持原样、改用真实的跟踪标签去关联,mIDF1 只多 4.3 分。
也就是说,在 BDD100K 上,QDTrack 的关联已经很接近上限,大部分的误差来自检测。失败案例也是如此。漏掉的大多是很小或被挤住的物体,误报是镜子或广告牌里的人。还有一种情况是类别跳变,例如自行车被遮住时,「骑行者」被检测成「行人」,QDTrack 只允许同类别匹配,ID 就断了。
后来
「只用外观就够」这个结论,后来在 MOT17 上被重新检验过。ByteTrack 在 MOT17 的半验证集上,在 QDTrack 的 re-ID 相似度上加入卡尔曼滤波的运动线索,再套上自己的 BYTE 关联。MOTA 从 67.3 变成 67.7,IDF1 从 67.8 升到 72.0,ID 切换从 377 降到 281。行人在监控画面里走得慢又规律,运动线索在这里还是很有用。
DanceTrack 则是另一个极端。那里的舞者穿着相似,外观很难区分,DanceTrack 的作者在自己的关联实验里也发现,直接加上外观比对反而会变差。但在同一篇论文里,换上 YOLOX 检测器重新训练的 QDTrack,HOTA 拿到 54.2,比 ByteTrack 的 47.7 还高,关联准确度 AssA 也是 36.8 对 32.1。准密集学出来的特征,在外观几乎一样的场景里,还是分得出一些差别。
结论
QDTrack 换掉的是学外观特征的采样方式。原本只用十几个真实框,现在把几百个候选框全部拿来互相比较,再配上一个公平处理多个正样本的对比损失。
推理时只剩外观,加上双向 softmax、保留一帧的背景框、跨类别去重这几条简单规则。没有卡尔曼滤波,没有 IoU,在 BDD100K 上加了位置线索反而略差。
背景框那一招特别有意思。大部分跟踪器都在想办法把误报丢掉,QDTrack 却把它们留下来,让下一帧的误报有个地方可以去。