原始论文
MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors
- 发表版本
- CVPR 2023会议
- arXiv 首次提交
- arXiv:2211.09791
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmotrv22022,
  title = {{MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors}},
  author = {Yuang Zhang and Tiancai Wang and Xiangyu Zhang},
  year = {2022},
  eprint = {2211.09791},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.09791}
}
MOTR 把多目标跟踪做成了完全端到端:轨迹查询一帧一帧往下传,新物体交给检测查询,不需要任何匹配或后处理。
在 DanceTrack 上,MOTR 的关联能力是当时最好的,AssA 40.2,比 ByteTrack、OC-SORT 这些靠运动匹配的方法都高。但它的检测不行。DanceTrack 上 DetA 只有 73.5,比 OC-SORT 的 80.3 低一截;到了 MOT17,MOTA 73.4,比 ByteTrack 的 80.3 差了将近 7 分。
上海交通大学的 Yuang Zhang 与旷视的 Tiancai Wang、Xiangyu Zhang,也就是 MOTR 原本团队的成员,认为问题出在同一个解码器要同时学两件事。检测和关联在 MOTR 里互相拉扯,结果检测学不好。
那就找一个现成、很强的检测器来帮忙吧。
定义问题
要把外部检测器接上 MOTR,最直接的做法是学 TransTrack,让轨迹查询预测出框,再用 IoU 和检测器的框匹配。
作者试过,检测只有些微改善,而且又回到了「先预测、再匹配」的老路,MOTR 端到端的特性也没了。
作者想要的是像 tracking-by-detection 那样,把检测结果当成输入,让 MOTR 只需要专心学关联。检测结果要怎么「喂」进一个以查询为核心的 Transformer,就是这篇要解决的问题。
解决问题
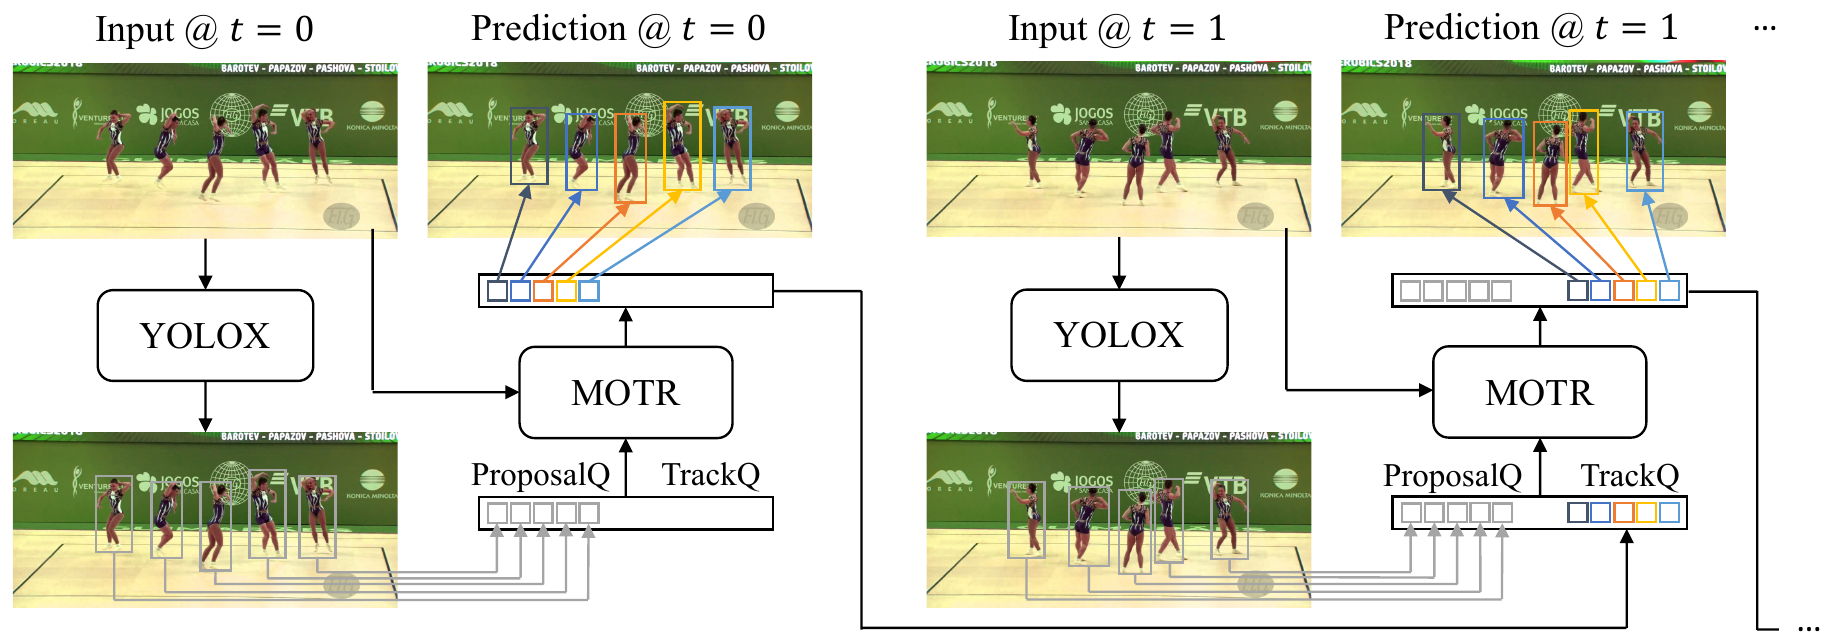
MOTRv2 由一个现成的 YOLOX 检测器,和一个改成锚框式的 MOTR 组成。
锚框式的查询
关键的一步来自 DAB-DETR 这类检测器的想法。查询不只是一个抽象的嵌入,还带着一个明确的锚框(中心、宽、高)。解码器只要预测相对于锚框的偏移量,检测就变得容易很多。
作者把 MOTR 的检测查询和轨迹查询都改成这种锚框式的写法。原本可学习的位置嵌入,换成锚框坐标的 sine-cosine 编码。
这样一来,外部检测器的框就能直接拿来当锚框,检测的先验信息就这样接进了 MOTR。
提议查询
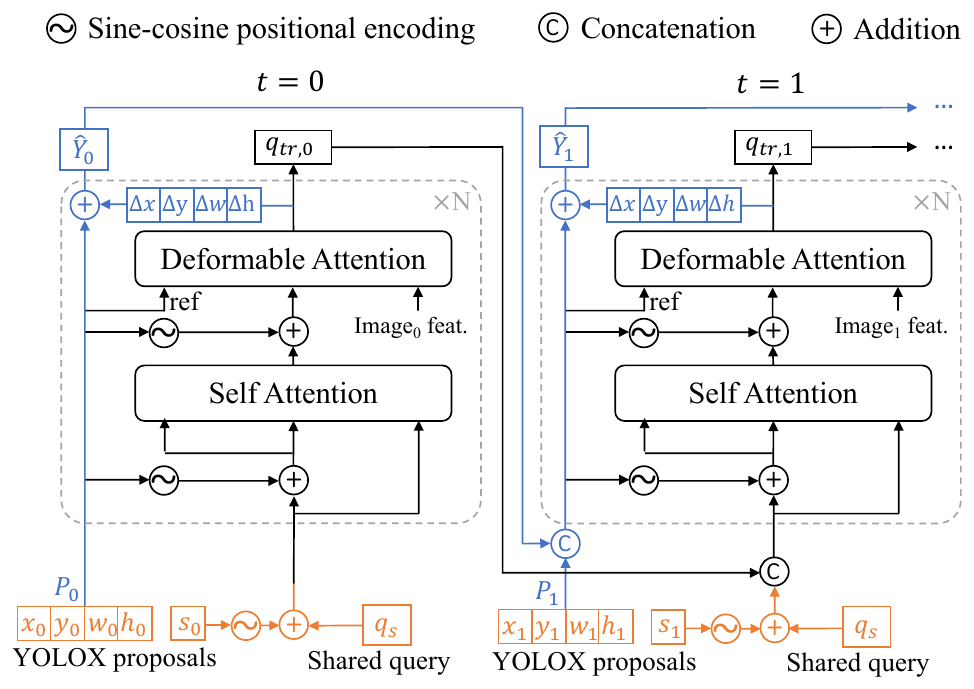
每一帧,YOLOX 会产生 个候选框,每个框有中心 、宽高 和置信度 。为了尽量不漏掉物体,置信度只要超过 0.05 就保留。
提议查询(proposal query)分三步产生:
- 一个可学习的共享查询 ,大小 ,复制成 。
- 每个候选框的置信度 ,用 sine-cosine 编码成一个 维向量。
- 两者相加,就是这一帧的提议查询;候选框本身则作为它们的锚框。
所有提议查询共享同一个嵌入,彼此的差别只来自锚框位置和置信度。另外还保留了 10 个可学习的锚框,用来捡回 YOLOX 漏掉的物体。
置信度要不要编码进去,作者也比较过。完全不用分数,验证集 HOTA 63.0;用线性投影 63.4;用 sine-cosine 编码 63.7。置信度对 MOTR 来说是有用的信息。
框的传递
第一帧只有新物体。提议查询经过解码器,输出相对于 YOLOX 框的偏移量,加回去就是预测框 ;更新后的查询成为轨迹查询 。
之后每一帧,上一帧的轨迹查询 和这一帧的提议查询 拼接在一起;上一帧的预测框 也和这一帧的 YOLOX 框 拼接,当作所有查询的锚框。
分工就此确定。提议查询只负责新出现或先前漏掉的物体,轨迹查询负责重新定位已经在跟踪的物体。两者之间的协调,交给解码器的自注意力。提议查询要看轨迹查询,避免把已经在跟踪的人重复检测一次;轨迹查询也能参考 YOLOX 的框,让位置更准。
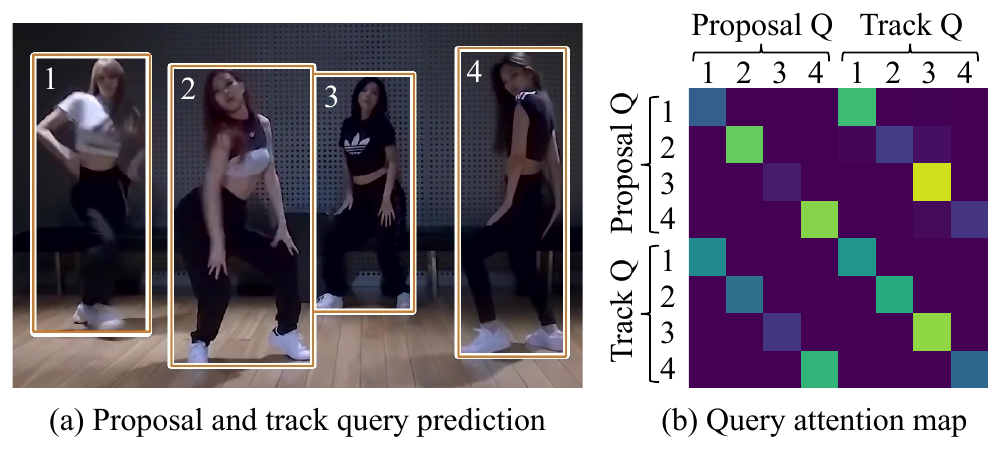
作者把自注意力图画了出来。同一个人的提议查询和轨迹查询之间,注意力明显较高,两者确实在交换信息。
MOTR 原本只传递中心点作为参考点,MOTRv2 传递的是完整的框。作者比较过这两种做法:以 DanceTrack 验证集的 AssA 来看,只传中心点时是 49.2,传整个框时升到 53.1。上一帧框的宽高,对关联很有帮助。
训练
训练时,每个短片段 5 帧,帧与帧的间隔从 1 到 10 随机选。
原本的 MOTR 会人为插入假的轨迹查询、或随机丢掉真的,模拟误报与漏检。MOTRv2 不再这么做,而是直接把置信度高于 0.5 的轨迹查询传下去。训练中自然出现的误报和漏检,就是最真实的数据增强。
在 DanceTrack 和 MOT17 上,YOLOX 本身不再训练,直接使用 DanceTrack 和 ByteTrack 官方发布的权重,在训练前先把所有图像的候选框算好。
另外两个训练技巧:
- 混合 CrowdHuman。 和 MOTR 一样,把 CrowdHuman 的单张图像做成 5 帧的伪视频,和 DanceTrack 一起训练。
- 查询去噪。 借用 DN-DETR 的去噪辅助任务加速收敛。但默认的噪声太大,比相邻两帧之间的移动还大,反而伤害关联;作者把噪声缩小之后,DetA 提升了 2.1 分。
讨论
一步一步加上去
| 设置 | 验证集 HOTA | 测试集 HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| + 实现调整 | 54.8 | |
| + 传递整个框 | 57.1 | |
| + YOLOX 与 CrowdHuman | 63.7 | |
| + 查询去噪 | 64.5 | 69.9 |
| + 额外关联、加入验证集、模型集成 | 73.4 |
整理自原论文 Table 5,DanceTrack;每一行都在上一行的基础上累加。
从 MOTR 的 54.2 到 MOTRv2 的 69.9,测试集 HOTA 多了 15.7 分。最大的一步是接上 YOLOX 并混合 CrowdHuman 训练,验证集一口气多了 6.6 分。
YOLOX 和 CrowdHuman 这一步,作者另外拆开来看:
| CrowdHuman | YOLOX | HOTA | DetA | AssA |
|---|---|---|---|---|
| 57.1 | 66.2 | 49.5 | ||
| ✓ | 60.7 | 74.8 | 49.6 | |
| ✓ | 56.7 | 73.7 | 43.9 | |
| ✓ | ✓ | 63.7 | 76.6 | 53.2 |
整理自原论文 Table 6,DanceTrack 验证集。
只加 CrowdHuman,检测变好了,AssA 却掉了 5.6 分,HOTA 还略降。作者的解释是,CrowdHuman 的伪视频是用仿射变换做出来的,人的「运动」和舞蹈差很多,而且训练会被拉去处理更多困难的检测,偏向检测、牺牲关联。
有了 YOLOX 之后,情况反过来。检测交给 YOLOX,MOTR 不用再为检测挣扎,CrowdHuman 带来的额外数据就能转化成关联能力,AssA 从 49.6 升到 53.2。
这两张表合起来看,正好说明了这篇的核心主张:检测和关联在 MOTR 里互相冲突,把检测卸下来,关联才能学好。
DanceTrack
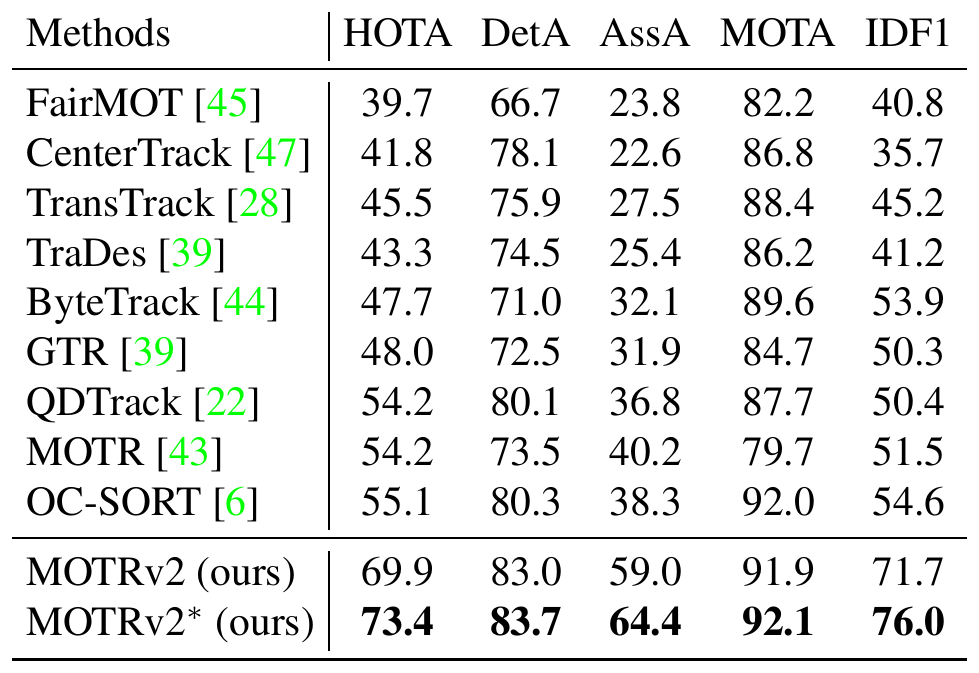
MOTRv2 的 HOTA 69.9,比先前最好的 OC-SORT 高出 14.8 分。AssA 59.0,比 OC-SORT 的 38.3 高了二十分以上;DetA 83.0,也比 OC-SORT 的 80.3 高。关联大幅领先,检测也不再落后。
表上的 MOTRv2* 拿到 73.4,是第一届团体舞多人跟踪挑战赛的冠军。但这个数字另外加入了验证集训练、4 个模型集成,以及一条后处理规则。如果一条轨迹结束后 20 到 100 帧内,刚好只出现一条新轨迹,就把两者视为同一个人。这条规则很实用,但已经不是端到端了。
BDD100K
BDD100K 有 8 个类别。MOTRv2 为每个类别各配一个共享查询,验证集上 mMOTA 43.6、mIDF1 56.5,比先前最好的 Unicorn 高 2.4 和 2.5 分。
和一个同样加了 BDD100K 图像联合训练、也传递整个框、但不用 YOLOX 的 MOTR 相比,mMOTA 多了 8.1 分,mIDF1 多了 8.3 分,YOLOX 的帮助在多类别场景同样明显。
MOT17 与 MOT20
MOT17 上,MOTRv2 的 HOTA 62.0、MOTA 78.6、IDF1 75.0,比 MOTR 的 57.8、73.4、68.6 好很多,但仍比 ByteTrack(63.1、80.3、77.3)和 BoT-SORT(64.6、80.6、79.5)低。
MOT20 也一样。MOTRv2 的 HOTA 60.3,加入 MOT17 联合训练后 61.0,仍低于表上 ByteTrack 的 61.3 和 OC-SORT 的 62.4。
作者把差距归因于数据量。MOT17 的训练视频太少,不够训练一个以查询为核心的跟踪器;加入 MOT17 一起训练之后,MOT20 的差距就缩小了一些。
为了在 MOT17、MOT20 这种拥挤场景用好 YOLOX 的框,作者另外加了「轨迹查询对齐」:把 MOTR 的预测框和 YOLOX 的框用 IoU 做匈牙利匹配,IoU 大于 0.5 的就用 YOLOX 的框取代锚框,没匹配上的预测则视为误报移除。只对齐锚框,MOT17 半验证集的 MOTA 就从 75.9 升到 84.3。查询嵌入本身的传递没有改变,但这一步其实又把 IoU 匹配请回来了。
局限
作者列了三个局限:
- 需要大量数据。 在小数据集上效果不够好,MOT17 就是例子。
- 重复的轨迹查询。 两个人交错而过时,偶尔会有一个轨迹查询跟错人,结果两个轨迹查询跟着同一个人。
- 速度。 在 2080Ti 上,YOLOX 每秒 25 帧,MOTR 每秒 9.5 帧,合起来只有 6.9 帧。
结论
MOTRv2 没有去改 MOTR 的关联,而是把检测交了出去。外部检测器的框变成查询的锚框,MOTR 只需要调整位置、决定谁是谁。
在 DanceTrack 这种检测简单、关联困难的场景,这个分工效果惊人,HOTA 一口气多了将近 15 分。
不过,为了在 MOT17 上跟得更好,作者最后还是用了 IoU 匹配来对齐锚框,再加上一条后处理规则去 DanceTrack 冲冠军。端到端跟踪器想要拿到最好的成绩,最后还是得向 tracking-by-detection 借几招。