原始论文
CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets
- 发表版本
- ICLR 2025会议
- arXiv 首次提交
- arXiv:2305.12724
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingcomot2023,
  title = {{CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets}},
  author = {Feng Yan and Weixin Luo and Yujie Zhong and Yiyang Gan and Lin Ma},
  year = {2023},
  eprint = {2305.12724},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12724}
}
MOTR 把跟踪整个交给 Transformer:每个人一个查询,查询跟着人走过一帧又一帧,不需要卡尔曼滤波,也不需要匈牙利算法。
这个设计很漂亮,成绩却一直追不上 ByteTrack 这类「先检测、再匹配」的方法。后来的 MOTRv2 干脆外挂一个 YOLOX 检测器,成绩上去了,计算量也上去了,原本「端到端」的好处少了一大半。
美团的 Feng Yan、Weixin Luo 等人回头检查 MOTR,发现问题不在跟踪,而在训练时怎么分配标签。
定义问题
检测查询被晾在一边
MOTR 的解码器里有两种查询。跟踪查询负责已经在跟踪的人,每一帧从上一帧延续下来;检测查询负责找新出现的人。
训练时的标签分配叫做 TALA(tracking aware label assignment)。它先把已经在跟踪的人配给对应的跟踪查询,剩下的新生物体,才拿去和检测查询做二分图匹配。
问题出在「剩下的」太少。作者在 DanceTrack 上统计,新出现的人和已经在跟踪的人,比例是 213 比 25,483。舞台上的舞者几乎从第一帧就在了,之后很少有人进场。检测查询大部分时间都没有正样本可以学。
更麻烦的是,TALA 等于在教检测查询:已经有人在跟踪的物体,你别碰。推理时,一旦某条轨迹的跟踪查询跟丢了,检测查询也不会去捡这个人。
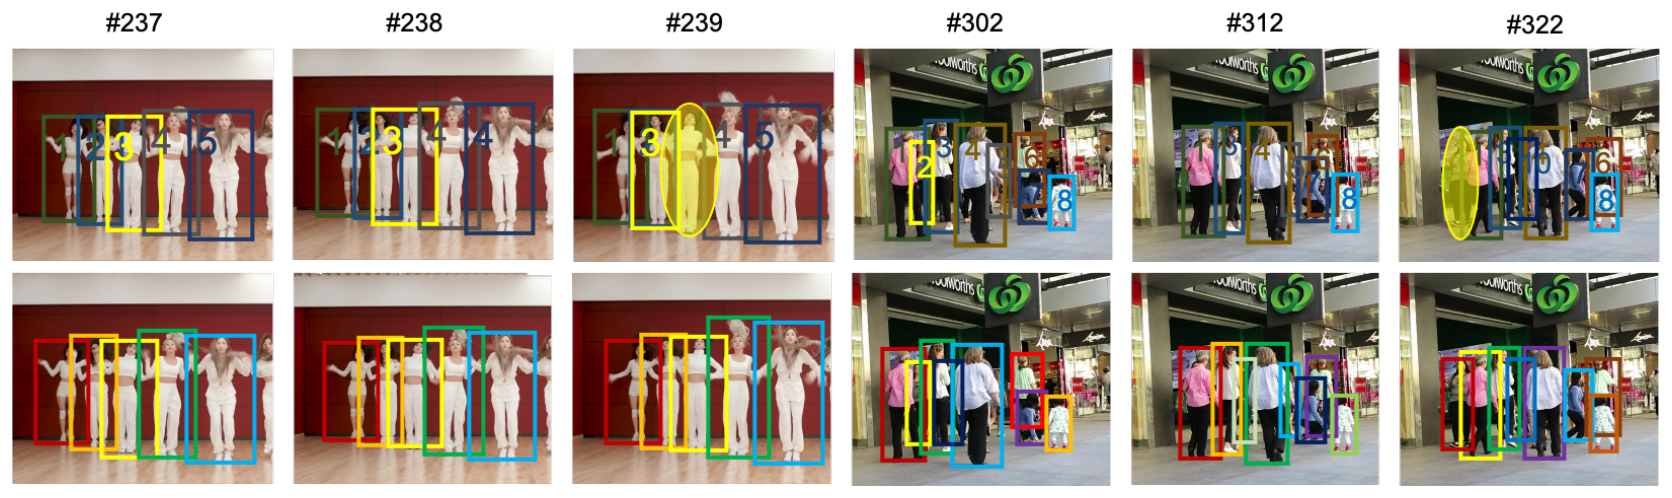
上排是 MOTR 的跟踪结果,下排是同一个模型拿掉跟踪查询、只做检测。下排每个人都框到了,可见 MOTR 不是不会检测,而是跟踪查询在旁边的时候,检测被压下去了。
把每个框都当成检测来衡量
作者把解码器输出的所有框,不分跟踪或检测,全部当成检测结果,用 mAP 来衡量:
| 模型 | 训练用跟踪查询 | 推理用跟踪查询 | mAP |
|---|---|---|---|
| MOTR | ✓ | ✓ | 42.5 |
| MOTR | ✓ | 60.6 | |
| MOTRv2 | ✓ | ✓ | 70.7 |
| MOTRv2 | ✓ | 72.1 | |
| CO-MOT | ✓ | ✓ | 69.1 |
整理自原论文 Table 1,DanceTrack 验证集,最后一层解码器。
同一个 MOTR,推理时拿掉跟踪查询,mAP 就从 42.5 跳到 60.6,多了 18.1。MOTRv2 有 YOLOX 提供的检测结果,拿掉跟踪查询只多 1.4,检测的问题几乎被外挂的检测器解决了。
CO-MOT 的目标,是不靠外挂检测器,让 MOTR 自己的检测能力回来。
解决问题
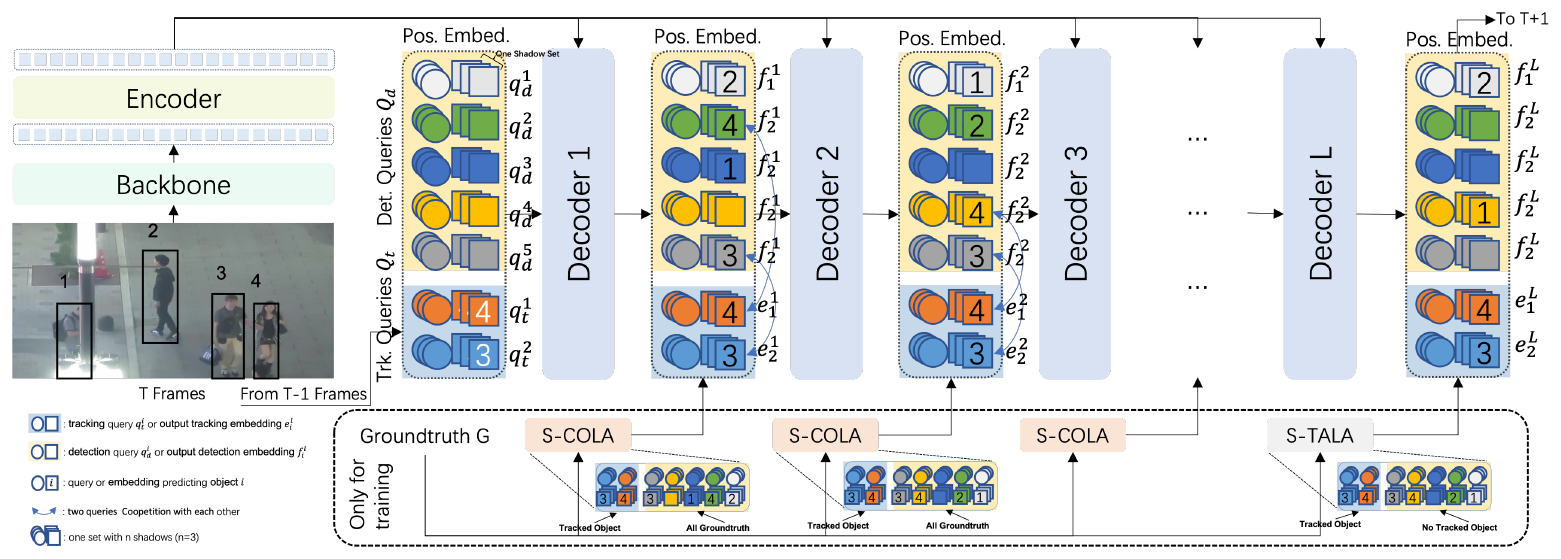
CO-MOT 的架构和 MOTR 一模一样,改的只有训练时的标签分配,分成两部分。
又合作又竞争
第一个改动叫做 COLA(coopetition label assignment),coopetition 是合作(cooperation)和竞争(competition)的合成词。
解码器有六层,COLA 让前五层的检测查询除了新物体之外,也可以配上已经在跟踪的人。也就是说,同一个人在中间层可能同时有一个跟踪查询和一个检测查询在预测他。
最后一层仍然用 TALA,已经在跟踪的人只归跟踪查询。否则推理时同一个人会冒出两条轨迹。
这样做的好处来自解码器里的自注意力。所有查询会互相看,检测查询看到的是这一帧的画面,跟踪查询带着过去的记忆。两者在预测同一个人时,检测查询可以把这一帧的信息传给跟踪查询,在外观变化大的时候帮它一把。
中间层合作,最后一层竞争,所以叫做 coopetition。
每个查询都有影子
第二个改动是影子集合(shadow set)。
DETR 类的模型用一对一匹配,一个物体只有一个查询拿到正样本。Co-DETR、H-DETR 的对策是一对多,让多个查询学同一个物体。CO-MOT 则是把每个查询复制成 个影子,整组一起负责同一个物体。
影子的初始化很讲究。完全随机,同一组的影子差得太多,很难收敛;完全一样,又失去了多出一组的意义。作者把同一组初始化成同一个可学习的向量,再加上标准差 的噪声。差异一开始几乎看不出来,训练结束时扩大到 左右。
训练时,一组影子要选一个代表去做匹配。跟踪查询的组直接配上一帧的目标;检测查询的组,则先算出每个影子对每个物体的匹配代价,再取最大的那个当代表。也就是说,这组影子配给谁,由组里最差的那一个决定。组内其他影子共享匹配结果,一起拿正样本。
推理时反过来,用组内最低的置信度分数判断这组是否跟踪到人,通过了,再输出分数最高的那个影子的框。
一个数正样本的例子
我们用一段训练片段,看看这两个改动让检测查询多学了多少。
CO-MOT 训练时每次取 5 帧。假设 10 位舞者从第 1 帧起都在画面里,中途没人进出,解码器 6 层。
- TALA。 第 1 帧还没有跟踪查询,10 个人全部是新物体,归检测查询。第 2 到 5 帧,所有人都归跟踪查询。检测查询每层只有 10 个正样本,6 层共 60 个。
- COLA。 前 5 层,检测查询可以配上 5 帧里的所有物体,每层 50 个,共 250 个;最后一层维持 10 个。合计 260 个。
- 再加影子。 每组 3 个影子都拿到正样本,检测查询的正样本变成 780 个。
本文整理的算例。
跟踪查询的正样本一个都没少,检测查询的正样本则从 60 个变成 780 个。
讨论
两个改动各自的贡献
| 设置 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| MOTR 基准 | 56.4 | 71.8 | 44.6 | 57.5 |
| +COLA | 60.2 | 73.2 | 49.7 | 62.4 |
| +影子集合 | 59.0 | 72.6 | 48.2 | 59.6 |
| 两者都加 | 61.8 | 73.5 | 52.2 | 63.3 |
整理自原论文 Table 4,DanceTrack 验证集。
COLA 单独加 3.8 HOTA,影子集合单独加 2.6,两者合计 5.4。
有趣的是 DetA 只从 71.8 到 73.5,AssA 却从 44.6 跳到 52.2。COLA 表面上是给检测查询更多正样本,看起来应该帮的是检测,实际上帮的是关联。
检测查询真的在帮忙吗
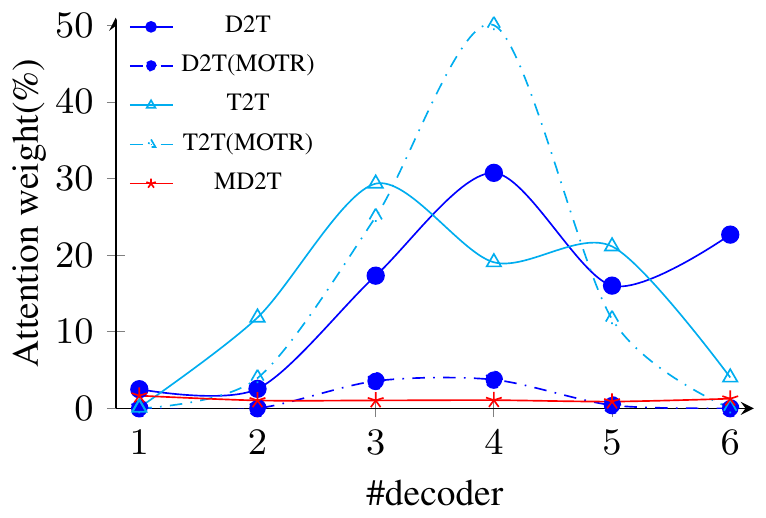
为了确认这件事,作者画出了解码器每一层的注意力权重。两个框的 IoU 超过 0.7,就视为在预测同一个人。
CO-MOT 里,预测同一个人的检测查询,从第 3 层开始对跟踪查询的贡献超过 15%,第 4 和第 6 层甚至超过跟踪查询对自己的注意力。MOTR 里,同样的数值在第 4 层只有 3.74%,CO-MOT 则是 30.74%。
MOTR 的检测查询和跟踪查询负责不同的人,彼此没什么好说的。CO-MOT 让它们在中间层盯着同一个人,信息就流过去了。
影子的细节
- 初始化。 同一向量加微小噪声的 HOTA 是 61.5,完全复制是 60.6,完全随机是 59.6。
- 代表怎么选。 训练用最大代价、推理用最低分数,这个组合最好;推理改用最高分数,不管训练怎么选都最差。训练时让最难的影子决定匹配,模型被迫把每个影子都学好。
- 影子的数量。 3 个最好(61.8),2 个是 61.5;再多就难以收敛。
- COLA 用几层。 只用在第一层 59.0,前三层 59.6,前五层 59.9,用得越多越好。
和其他方法比
在 DanceTrack 测试集上,只用 DanceTrack 训练的 CO-MOT,HOTA 是 65.3,比 MOTR 高 11.1,也高于同样用 ResNet-50 的 MeMOTR(63.4)。加入 CrowdHuman 一起训练的 CO-MOT+,HOTA 69.4,和外挂 YOLOX 的 MOTRv2(69.9)只差 0.5,AssA 则几乎一样(58.9 对 59.0)。
| 模型 | 参数 | 计算量 | 速度 | HOTA |
|---|---|---|---|---|
| MOTR | 40M | 173G | 19 FPS | 54.2 |
| MOTRv2 | 139M | 455G | 14 FPS | 69.9 |
| CO-MOT+ | 40M | 173G | 19 FPS | 69.4 |
整理自原论文 Figure 4,DanceTrack 测试集。
这张表是 CO-MOT 最有说服力的地方。和 MOTR 一样的参数量和计算量,成绩追上 MOTRv2,计算量只有它的 38%,速度快 1.4 倍。改的只有训练方式,推理时没有多付任何代价。
BDD100K 上,TETA 52.8,高于 MOTR 的 50.7,但低于 MOTRv2 的 54.9;不过 AssocA 是 56.2,高于 MOTRv2 的 51.9。
MOT17 还是过不去
MOT17 测试集上,CO-MOT 的 HOTA 是 60.1,比 MOTR 的 57.8 好,但仍低于 ByteTrack 的 63.1;MOTA 72.6 更是落后 ByteTrack 的 80.3 一大截。
作者的解释有两点。第一,MOT17 的训练集只有大约 5,000 帧,对 Transformer 来说太少。第二,MOT17 小目标多:面积不到画面 0.5% 的框,在 MOT17 占 60.26%,在 DanceTrack 只占 1.17%。论文列出的失败案例,多半是很明显的人没有被检测到。
CO-MOT 让 MOTR 的检测能力不再被跟踪压制,但 MOTR 本身检测小物体的能力,它改变不了。
结论
CO-MOT 找到 MOTR 训练时的一个盲点。检测查询被教成「别碰已经在跟踪的人」,结果在跟踪查询跟丢时,没有人能把人捡回来。
COLA 让两种查询在中间层一起看同一个人,影子集合让每个物体有多个查询一起学。两个改动都只影响训练,推理的架构和 MOTR 完全相同。
在 DanceTrack 上,不外挂检测器的 CO-MOT+ 和外挂 YOLOX 的 MOTRv2 只差 0.5 HOTA,计算量却不到它的四成。到了小目标多、数据又少的 MOT17,和先检测再匹配的方法之间,差距还在。