原始论文
TrackFormer: Multi-Object Tracking with Transformers
- 发表版本
- CVPR 2022会议
- arXiv 首次提交
- arXiv:2101.02702
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingtrackformer2021,
  title = {{TrackFormer: Multi-Object Tracking with Transformers}},
  author = {Tim Meinhardt and Alexander Kirillov and Laura Leal-Taixe and Christoph Feichtenhofer},
  year = {2021},
  eprint = {2101.02702},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2101.02702}
}
2019 年的 Tracktor 证明,检测器的框回归头可以直接把上一帧的框推到这一帧,跟踪几乎不用另外训练。CenterTrack 换成中心点和位移,走的也是同一条路线。作者把这类方法叫做「回归式跟踪」(tracking-by-regression)。
但这类方法要拿到顶尖成绩,最后都得补上别的东西。Tracktor 要加 re-ID 和运动模型,其他方法要接图优化。原因是每个框的回归都是独立、局部的,框本身不知道自己是谁,也不知道旁边其他轨迹在做什么。
2020 年,DETR 把目标检测写成集合预测。一组可学习的目标查询(object query),经过 Transformer 解码器,直接输出一组不重复的框,不需要锚框,也不需要非极大值抑制。
Tracktor 的两位作者,慕尼黑工业大学的 Tim Meinhardt 和 Laura Leal-Taixé,与 Facebook AI Research 的 Alexander Kirillov、Christoph Feichtenhofer 合作,把这个想法搬到跟踪上。如果一个查询可以代表一个物体,那让它跟着物体走到下一帧,不就是跟踪了吗?
定义问题
一段视频里有 个物体,每个物体 有一条轨迹 ,记录它从进入到离开画面期间每一帧的框,包括被遮挡的那些帧。
作者把多目标跟踪写成一个逐帧的集合预测问题。每一帧,模型要输出一组带身份的框,包括已经在跟的物体现在在哪里,以及哪些是新出现的物体。
检测、身份维持、新轨迹的建立,全部在同一次解码里完成,不需要另外的匹配步骤、图优化,也不需要显式建模外观或运动。作者把这个新范式称为「注意力式跟踪」(tracking-by-attention)。
解决问题
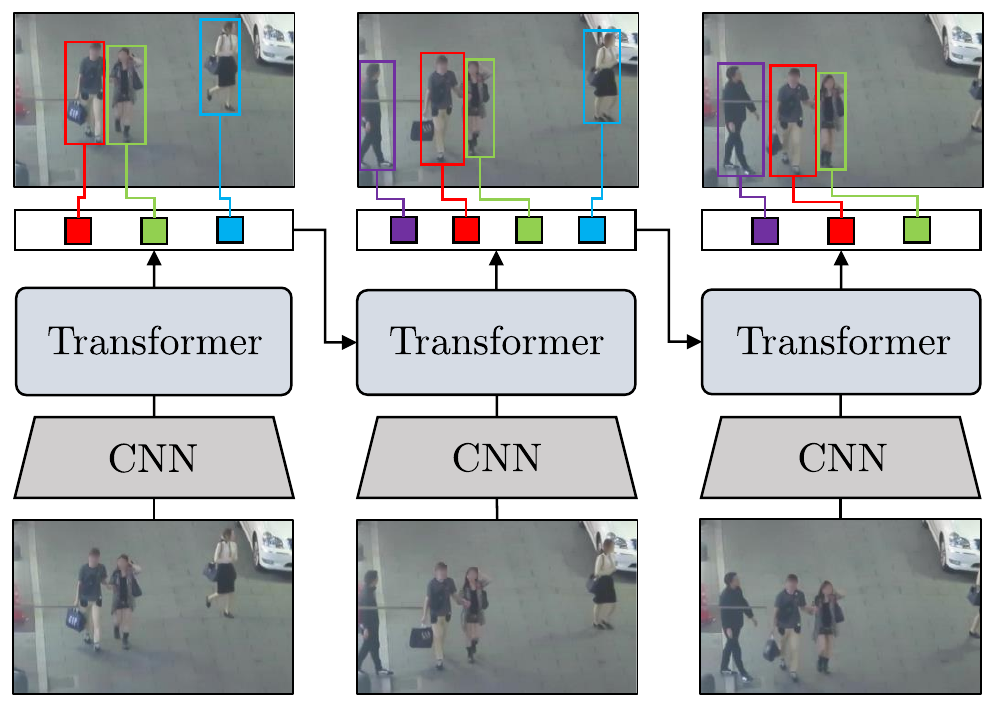
架构
TrackFormer 的骨架就是 Deformable DETR:
- ResNet-50 提取图像特征。
- Transformer 编码器,6 层,对图像特征做自注意力。
- Transformer 解码器,6 层,查询之间做自注意力,再对编码后的图像特征做交叉注意力。
- MLP 把每个输出嵌入映射成框和类别。
和 DETR 不同的地方,全在解码器的查询上。
两种查询
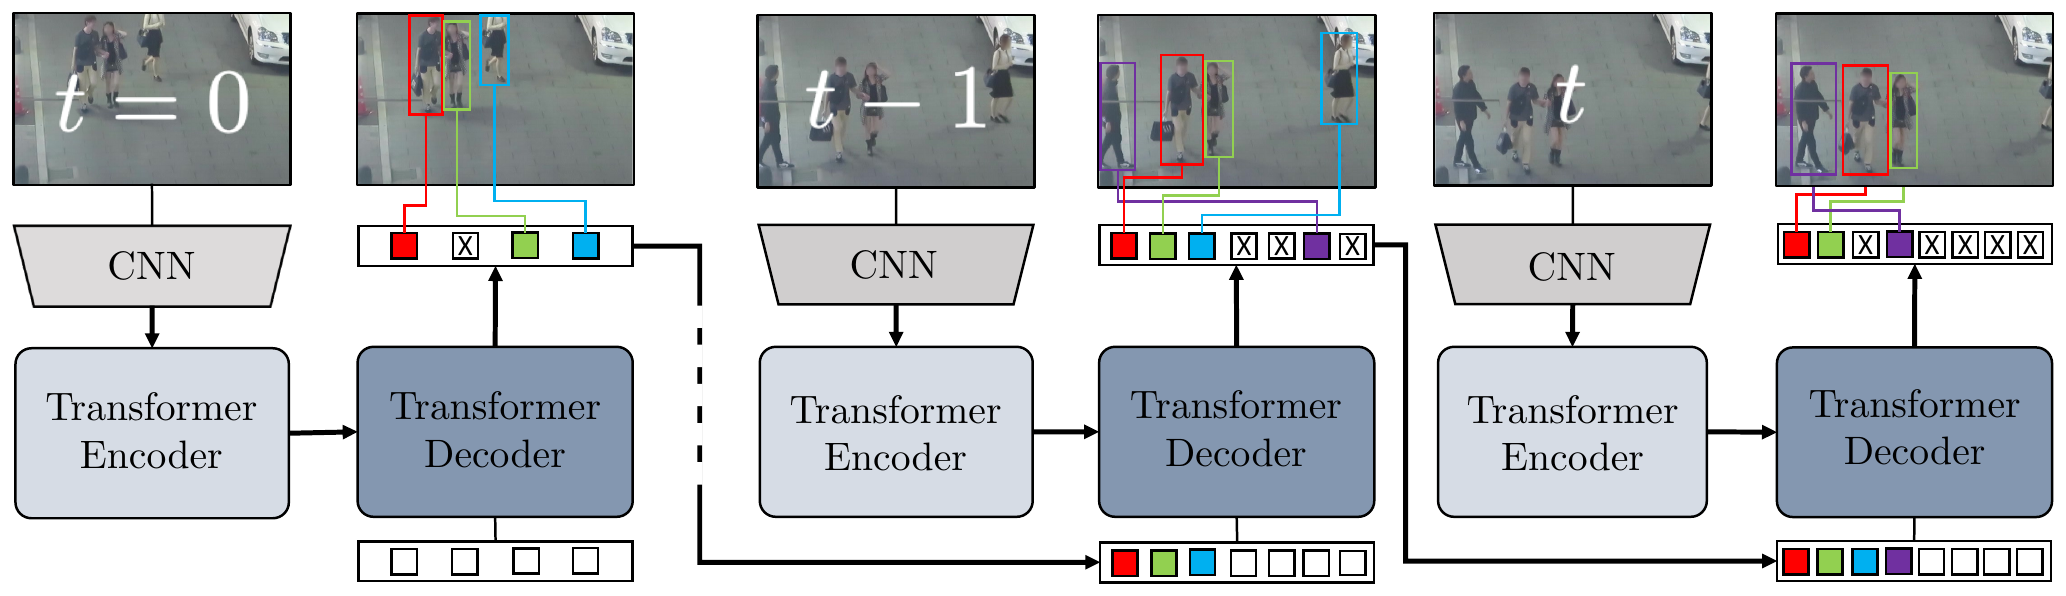
目标查询(object query) 和 DETR 一样,是一组固定、可学习的嵌入,负责在任何一帧发现新的物体。MOT17 每帧最多 52 人,作者用了 500 个目标查询;查询数要远多于画面里的物体数,效果才会好。
轨迹查询(track query) 是这篇的核心。某一帧里,一个目标查询检测到物体(分类分数大于 0.4),它在解码器最后一层的输出嵌入,就直接成为下一帧的一个轨迹查询,并带着一个身份编号。
下一帧,解码器同时处理 个查询。轨迹查询通过交叉注意力,去新图像里找自己的物体,输出更新后的框;更新后的嵌入再传到下下一帧。身份就这样一帧一帧地自回归传下去,从头到尾没有任何匹配。
两种查询之间的自注意力也有作用。目标查询「看得到」轨迹查询,所以不会把已经在跟的人重新检测一次。
为了让轨迹查询更容易找到自己的物体,实现上还有两个细节。轨迹查询在 deformable attention 里的参考点,直接设成上一帧框的中心;解码器的交叉注意力同时看上一帧和这一帧的特征图,用时间编码区分。
轨迹的结束与找回
轨迹查询的分类分数掉到 0.4 以下,或和另一个框的 IoU 超过 0.9 时,就会被移除。作者发现,有些严重重叠的重复框,解码器的自注意力处理不掉,所以保留了这个很宽松的非极大值抑制。
被移除的轨迹查询不会马上丢掉,而是再继续解码 5 帧,但这段期间不输出结果。只要它的分数重新回到 0.4 以上,就恢复成正常的轨迹。这是一种短时间的重识别,靠的还是同一套注意力,不需要额外训练 re-ID。
但轨迹查询里带着位置信息,物体被遮挡太久、移动太远,就找不回来了。
训练
轨迹查询要学会跟着物体走,必须用相邻两帧训练:
- 在第 帧,只用目标查询做检测。
- 检测到的物体变成轨迹查询,和目标查询一起送进第 帧。
第 帧的每个输出要分配给一个真实物体或背景。设 、 是两帧各自的真实身份集合,分配规则是:
- (两帧都在):轨迹查询直接按身份对应,这是硬分配。
- (上一帧有、这一帧消失):对应的轨迹查询要预测成背景。
- (新出现):交给目标查询,用 DETR 的匈牙利算法找代价最小的匹配。
匹配代价由类别概率和框的差异组成:
其中框的代价结合了 L1 距离与广义 IoU:
分配完成后,每个查询的损失是
没被分配到的查询,一律当作背景。
三种增强
只用相邻两帧训练,模型看到的跟踪情境太单纯。作者加了三种增强:
- 拉大帧间距。 第 帧不一定是紧邻的前一帧,而是从 附近一段范围内采样,模拟镜头移动和低帧率。
- 漏检。 以概率 去掉一些轨迹查询,让这些物体在第 帧要由目标查询重新检测。这是让两种查询能一起训练的关键。
- 误报。 以概率 为某个轨迹查询多加一个假的轨迹查询,取自上一帧被判为背景、而且和它重叠很多的输出嵌入。这是在练习遮挡时把轨迹移除。
数据
Transformer 需要大量数据,MOT17 只有 7 段训练视频。作者跟 CenterTrack 一样,用 CrowdHuman 的单张图像模拟相邻两帧,对同一张图做随机缩放与裁剪,幅度最多 20%。
私有检测的模型,先在 CrowdHuman 上从头训练 85 个 epoch,再混合 CrowdHuman 和 MOT17 微调 40 个 epoch,在 7 张 32GB 的 GPU 上大约要两天。
讨论
组件消融
| 设置 | MOTA | Δ | IDF1 | Δ |
|---|---|---|---|---|
| 完整的 TrackFormer | 71.3 | 73.4 | ||
| 去掉 CrowdHuman 预训练 | 69.3 | −2.0 | 71.8 | −1.6 |
| 再去掉轨迹查询的重识别 | 69.2 | −0.1 | 70.4 | −1.4 |
| 再去掉误报增强 | 68.4 | −0.8 | 70.0 | −0.4 |
| 再去掉帧间距增强 | 64.0 | −4.4 | 59.2 | −10.8 |
| 再去掉轨迹查询 | 61.0 | −3.0 | 45.1 | −14.1 |
整理自原论文 Table 3,MOT17 训练集前后各半切分,私有检测;每一行都在上一行的基础上再去掉一项。
这张表是逐行累加的,每一行都比上一行少一个组件。
几种训练技巧里,拉大帧间距的增强影响最大,去掉之后 MOTA 掉 4.4 分、IDF1 掉 10.8 分。只用紧邻两帧训练,模型很快就过拟合,学不到物体移动较大时该怎么跟。
最后一行连轨迹查询都去掉,模型只训练检测,改用 CenterTrack 那种中心距离的贪婪匹配,IDF1 又掉了 14.1 分。这一行代表的就是以往靠规则匹配的做法。
MOT17 与 MOT20
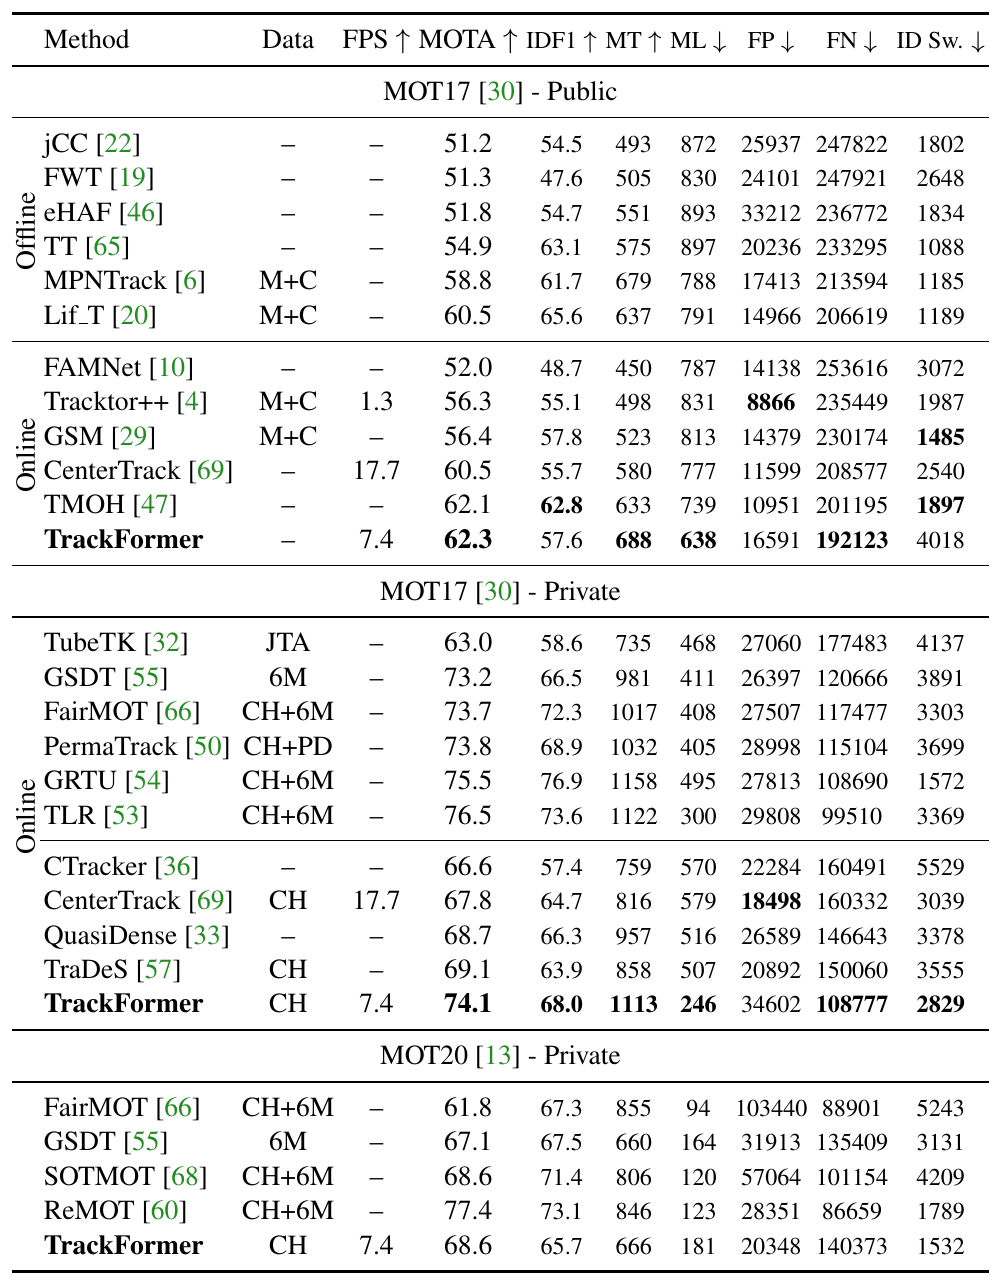
私有检测下,TrackFormer 在 MOT17 拿到 MOTA 74.1、IDF1 68.0。在只用 CrowdHuman 当额外数据的方法里,它的 MOTA 比次佳的 TraDeS 高 5.0 分,比 CenterTrack 高 6.3 分。FN 只有 108,777,比 CenterTrack 少了五万多,召回率高很多。
但表上还有几个用了 6 个额外跟踪数据集的方法,像 FairMOT、GRTU、TLR,IDF1 都比它高。MOT20 上,MOTA 和 SOTMOT 打平,但比 ReMOT 低了将近 9 分,IDF1 也落后。
速度是每秒 7.4 帧,比 CenterTrack 的 17.7 慢了一半以上。
公开检测怎么比
TrackFormer 不是拿检测框做关联的方法,没办法直接拿公开检测当输入。作者改用过滤的方式,只有和某个公开检测框 IoU 大于 0.5 的目标查询,才能开新轨迹。
CenterTrack 也有类似的过滤,但用的是中心点,公开检测的中心落在框内就算。作者在附录里比较了两种过滤,发现中心点的版本下,三种质量差很多的公开检测(DPM、FRCNN、SDP)跑出来的结果几乎一样,等于检测的好坏没有反映出来。IoU 的版本比较严格,分数都会降低,但更接近「用公开检测当输入」的原意。
在 IoU 过滤下,TrackFormer 的 MOTA 62.3,和最好的在线方法相当;但 ID 切换 4,018,是表上最多的。
加上掩码
TrackFormer 也能加一个分割头,在 MOTS20 上做多目标跟踪与分割。作者发现,和掩码一起训练之后,即使只看框的跟踪,IDF1 也会多 1.2 分,掩码信息帮忙解决了训练时一些模棱两可的遮挡情况。
局限与后来
TrackFormer 只在相邻两帧上训练,轨迹查询学到的时间信息很短。作者自己在论文里也写了,超越两帧训练与推理的方法,应该很有潜力。
几个月后的 MOTR 就是这么做的,它把训练拉长到一整段短片段,让轨迹查询跨多帧传递,并把轨迹 NMS 和重识别这类规则都去掉了。另外,MOTR 和后来的 MOTRv2 在比较表里引用的 TrackFormer 成绩,是 MOT17 上 MOTA 65.0、IDF1 63.9,那是较早版本的数字;正式版用 CrowdHuman 模拟相邻帧训练之后,才升到这里的 74.1 和 68.0。
结论
TrackFormer 让一个查询代表一个物体,检测到之后就跟着它一帧一帧往下走。新物体交给目标查询,旧物体交给轨迹查询,两者在同一个解码器里互相看得见,匹配这个步骤就这样消失了。
它的数字并不是全面领先,速度也慢。但它示范了另一种跟踪的写法,之后 MOTR、MOTRv2 都是在这个写法上继续做的。
两年前,Meinhardt 和 Leal-Taixé 用 Tracktor 示范了不专门为跟踪训练也能跟得很好。这一次,跟踪变成要在七张 GPU 上训练两天的事。