原始论文
MOTR: End-to-End Multiple-Object Tracking with Transformer
- 发表版本
- ECCV 2022会议
- arXiv 首次提交
- arXiv:2105.03247
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmotr2021,
  title = {{MOTR: End-to-End Multiple-Object Tracking with Transformer}},
  author = {Fangao Zeng and Bin Dong and Yuang Zhang and Tiancai Wang and Xiangyu Zhang and Yichen Wei},
  year = {2021},
  eprint = {2105.03247},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2105.03247}
}
前面读过的跟踪器,不管用了多少深度学习,最后都有一段手写的关联步骤。
SORT 用 IoU 加匈牙利算法,DeepSORT 加上外观距离和匹配级联,FairMOT 沿用两阶段匹配,CenterTrack 用位移反推再做贪婪匹配。运动靠卡尔曼滤波或学出来的位移,外观靠 re-ID 特征,两者怎么组合、阈值设多少,都是人决定的。这段后处理挡在中间,时间上的信息没办法端到端地流过去。
2020 年,DETR 把目标检测改写成集合预测。一组可学习的目标查询(object query)和图像特征交互,每个查询输出一个框,再用二分图匹配和真实框一对一配对,连非极大值抑制都不用。
检测可以不要后处理,那跟踪呢?
旷视(MEGVII)与上海交通大学的 Fangao Zeng、Bin Dong、Yuang Zhang、Tiancai Wang 等人提出 MOTR,尝试让跟踪器从头到尾都不需要任何手写的匹配。
定义问题
作者从机器翻译得到灵感。翻译模型用一个隐藏状态代表当前的上下文,解码器反复让这个状态和输入特征交互,一个一个地输出译文的词。
多目标跟踪也可以看成类似的问题,输出的是一组序列,每条序列是一个物体的轨迹。如果每条轨迹也有一个隐藏状态,一帧一帧地和图像特征交互、一帧一帧地输出框,ID 就自然跟着这个隐藏状态走,不需要再匹配。
MOTR 把 DETR 的目标查询延伸成轨迹查询(track query),当作轨迹的隐藏状态。这样做要先解决两个问题:
- 一个查询怎么一直跟踪同一个物体? DETR 的目标查询每一帧都可能被分配给画面中任何一个物体,没有身份的概念。
- 新出现和离开的物体怎么办? 画面里的物体数量一直在变,轨迹查询的数量也得跟着变。
解决问题
两种查询
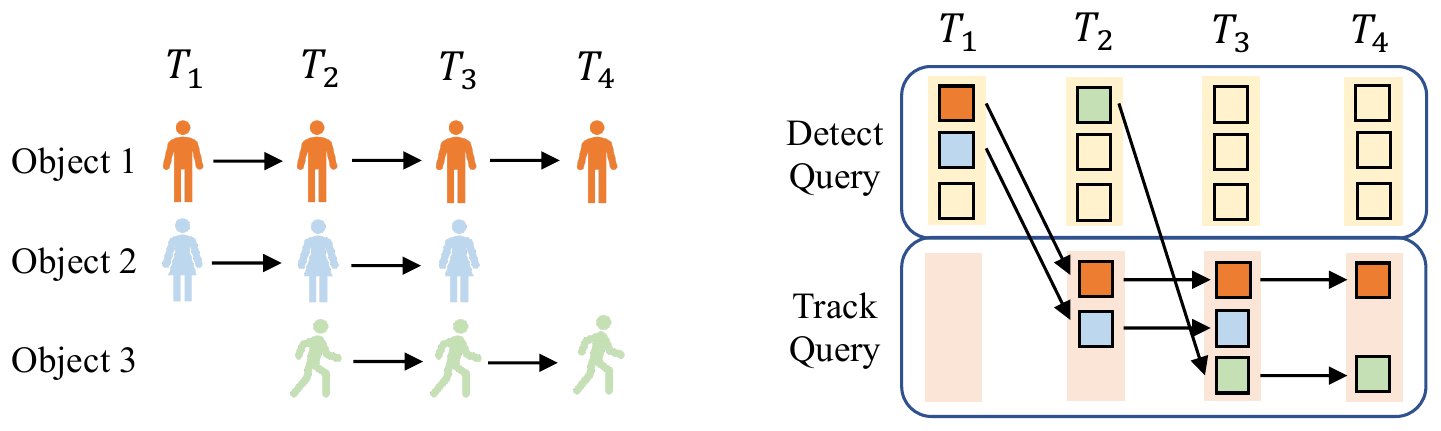
MOTR 把查询分成两种,我们跟着这张图走一遍:
- 检测查询(detect query): 就是 DETR 原本那组数量固定、可学习的目标查询,每一帧都一样。它们只负责找新出现的物体。
- 轨迹查询(track query): 数量可变的一组查询,每一个代表一条已经在跟踪的轨迹。
T1: 一开始还没有任何轨迹,轨迹查询是空的。只有检测查询送进解码器,其中两个找到了物体 1 和物体 2。
T2: 找到物体 1、2 的那两个查询,经过解码器后的隐藏状态,变成下一帧的轨迹查询。T2 时,解码器的输入是「两个轨迹查询 + 一组检测查询」。两个轨迹查询各自输出物体 1、2 的新框,ID 不变;检测查询里有一个找到了新出现的物体 3。
T3: 物体 3 的隐藏状态也加入轨迹查询,现在有三个。
T4: 物体 2 离开了,它的轨迹查询从集合中移除。
整个过程中,每个轨迹查询从诞生到移除都只代表一个物体。跟踪的结果,就是同一个轨迹查询在每一帧输出的框连起来。
标签怎么分配
训练时,DETR 用二分图匹配决定每个查询该负责哪个真实物体。MOTR 把这件事改成「轨迹感知的标签分配」(Tracklet-Aware Label Assignment, TALA),两种查询分开处理:
- 检测查询: 只和这一帧新出现的物体做二分图匹配。
- 轨迹查询: 不参与匹配,直接沿用上一帧的分配。上一帧负责物体 1 的查询,这一帧还是负责物体 1。
写成式子,第 帧轨迹查询的分配 ,是上一帧轨迹查询的分配加上上一帧新物体的分配:
推理时没有标签,检测查询怎么知道不要去找已经在跟踪的物体?两种查询会一起送进解码器,自注意力会压低那些找到已跟踪物体的检测查询的分数。这和 DETR 不用 NMS 也不会输出重复框的道理相同。
整体架构
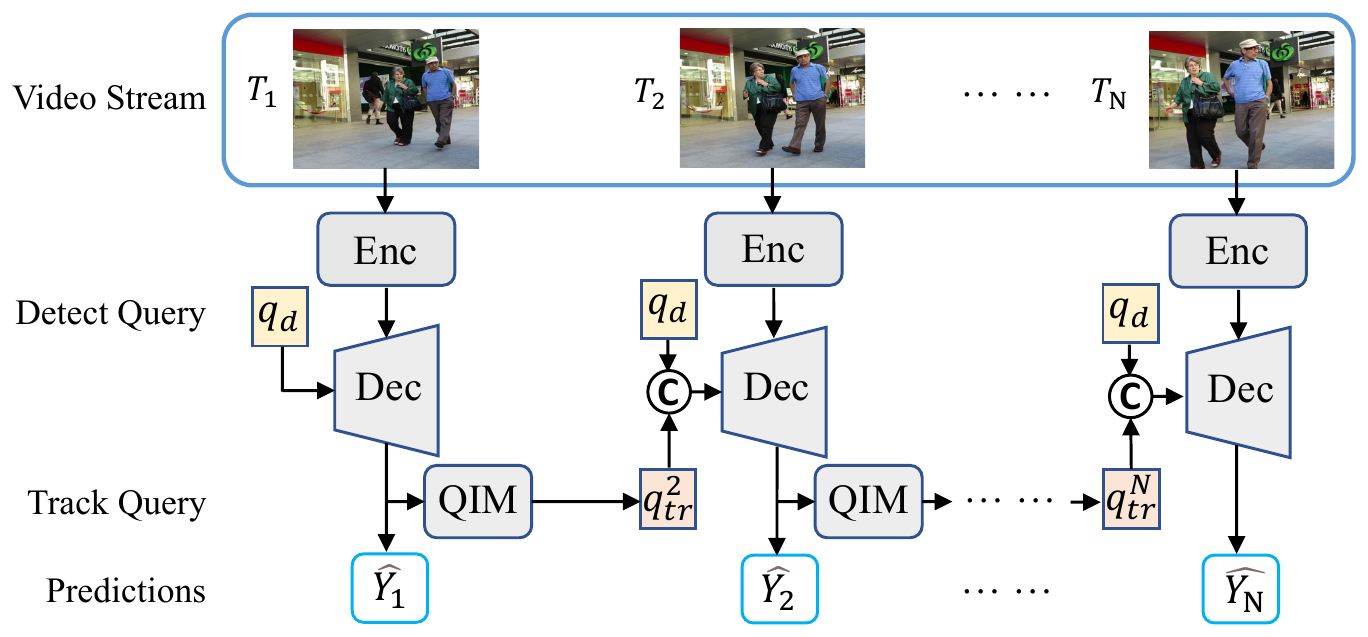
骨干是 ResNet-50,检测框架是 Deformable DETR。每一帧经过骨干和 Transformer 编码器得到特征;解码器的输入是上一帧的轨迹查询拼接检测查询,输出的隐藏状态一方面用来预测框和类别,另一方面送进查询交互模块(Query Interaction Module, QIM),产生下一帧的轨迹查询。
QIM 负责两件事。
物体的进出。 训练时,若某个物体在真实标注中消失,或预测框和真实框的 IoU 低于 0.5,它的隐藏状态就被丢掉;新物体则依据检测查询的匹配结果保留。推理时改用分类分数:检测查询的分数高于入场阈值 ,才变成新的轨迹;轨迹查询的分数连续 帧低于退场阈值 ,才被移除。
时间聚合网络(Temporal Aggregation Network, TAN)。这是一层修改过的 Transformer 解码器层。对每个已跟踪的物体,把上一帧的轨迹查询和这一帧的隐藏状态相加,作为多头自注意力的 query 和 key,这一帧的隐藏状态作为 value,再经过前馈网络。这给了轨迹查询一条捷径,把历史信息带进来。TAN 的输出再和新物体的隐藏状态拼接,成为下一帧的轨迹查询。
用整段视频算损失
卡尔曼滤波的匀速假设是人写的;MOTR 的运动模型要从数据里学。但如果只用相邻两帧训练,网络只看得到很短的运动,学不到遮挡后重新出现这类长时间的变化。
作者提出集体平均损失(Collective Average Loss, CAL)。训练时一次输入一段视频片段,收集每一帧的预测,算完整段的损失后,再除以整段视频中真实物体的总数:
是第 帧的真实物体数。单帧损失 和 DETR 一样,是 focal loss、L1 损失与 GIoU 损失的加权和。
片段长度从 2 帧开始,训练过程中逐步增加到 3、4、5 帧。作者说,这种渐进式的增加能提升训练效率与稳定性。
几个训练技巧
真实视频里,新物体出现和旧物体离开的情况都不多。作者用两个随机操作制造更多样本:
- 以概率 随机删掉一些轨迹查询,让检测查询有机会练习「找新物体」。
- 以概率 把误报的查询插进轨迹查询,让模型练习「让不存在的物体退场」。
另外,训练片段的帧不是连续取的,而是以随机间隔采样,模拟不同的帧率与较大的运动。
和同期的 TransTrack、TrackFormer 相比,作者强调 MOTR 完全不需要后处理。TransTrack 在相邻两帧检测成对的短轨迹,再用 IoU 匹配串成长轨迹;TrackFormer 也有轨迹查询的想法,但只在相邻两帧之间学习,仍需要轨迹 NMS 和 re-ID 特征来过滤重复的轨迹。作者也特别声明,这项工作在 TrackFormer 和 TransTrack 上传 arXiv 之前就已独立开始。
讨论
MOTR 在 8 张 V100 上训练,每个批次是一段 5 帧的片段。在 MOT17 上训练 200 个 epoch,数据是 MOT17 训练集加上 CrowdHuman 验证集约 5000 张静态图像(沿用 CenterTrack 的随机平移生成伪片段)。输入图像短边缩放到 800,推理速度在 V100 上约 7.5 FPS。
MOT17:一个尴尬的结果
在 MOT17 测试集上,MOTR 的 HOTA 是 57.8,IDF1 68.6,MOTA 73.4,ID 切换 2439。
和同为 Transformer 的方法比,IDF1 比 TransTrack 和 TrackFormer 都高 4.7;HOTA 比 TransTrack 高 3.7,MOTA 比 TrackFormer 的 65.0 高得多。但 TransTrack 的 MOTA(74.5)比 MOTR 高。作者推测,TransTrack 把检测和跟踪分成两个分支,检测表现比较好;MOTR 的检测查询会被轨迹查询压制,新物体的检测受到限制。
和 CNN 方法比就更尴尬了。ByteTrack 的 HOTA 63.1、MOTA 80.3、IDF1 77.3,MOTR 每一项都输。作者在论文里直接用了「frustratingly inferior」来形容。他们的解释是,MOT17 上的成绩主要由检测质量决定,而各家用的检测器不同,很难公平比较运动建模的能力,所以 MOT17 不足以完整评估 MOTR。
DanceTrack:主场
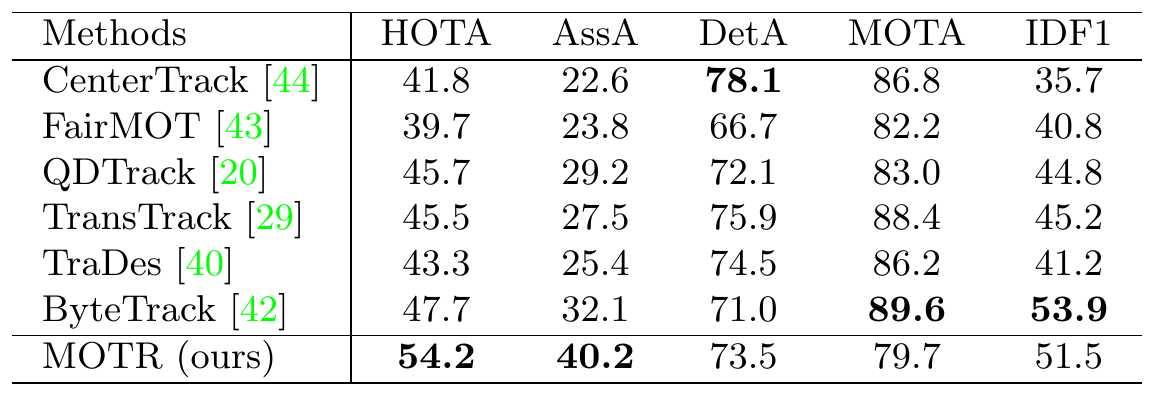
DanceTrack 是一个舞蹈场景的数据集,舞者穿着相似、动作复杂、频繁交错,检测不难,难在关联。
这里 MOTR 的 HOTA 是 54.2,比 ByteTrack 的 47.7 高 6.5;AssA 40.2 对 32.1,高了 8.1。但 DetA 73.5 低于 CenterTrack 的 78.1 和 TransTrack 的 75.9,MOTA 79.7 更是全表最低。
这张表把 MOTR 的强项和弱点并排得很清楚。AssA 高,说明轨迹查询确实学会了跨帧维持身份;DetA 和 MOTA 低,说明它找物体的能力不如其他方法。这正好呼应前一篇 HOTA 笔记讲的,看 HOTA 的时候要顺手看 DetA 和 AssA。
在多类别的 BDD100K 验证集上,MOTR 的 mMOTA 是 32.0,ID 切换 3493,比基线方法的 8315 少很多。作者认为,以 re-ID 为主的方法很难处理类别与物体数量很多的情况,MOTR 只要改分类头的类别数就能处理多类别跟踪。
消融:每个设计值多少
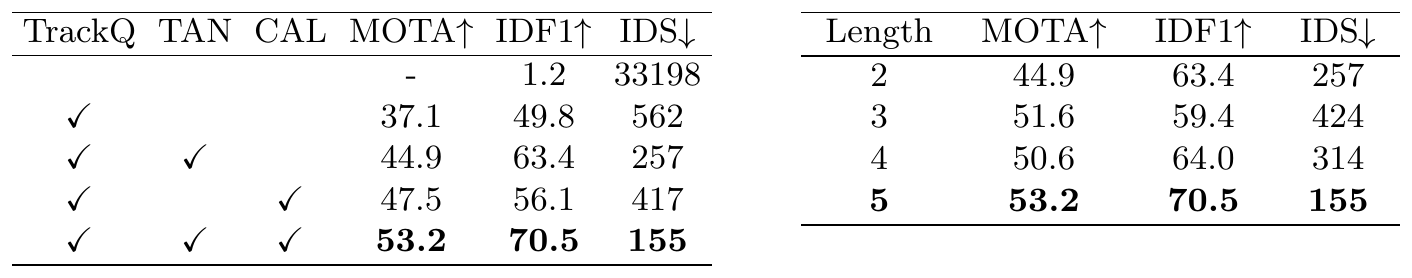
消融实验在 MOT17 训练集上训练,在 MOT15 训练集上验证。
左表从最原始的版本开始。只有目标查询、没有轨迹查询时,每一帧的物体都被当成新物体,ID 切换高达 33198 次,IDF1 只有 1.2。加上轨迹查询后,IDF1 升到 49.8,ID 切换降到 562。光是轨迹查询本身,就让跟踪成立了。
TAN 和 CAL 各自都有帮助。只加 TAN,MOTA 多 7.8、IDF1 多 13.6;只加 CAL,MOTA 多 10.4。两者都加,MOTA 53.2、IDF1 70.5、ID 切换 155。
右表是 CAL 的片段长度。从 2 帧增加到 5 帧,MOTA 从 44.9 升到 53.2,IDF1 从 63.4 升到 70.5,ID 切换从 257 降到 155。中间的过程并不平顺,长度 3 时 IDF1 还掉到 59.4、ID 切换增加到 424,但最长的 5 帧在三项指标上都最好。作者观察到,多帧的 CAL 明显减少了遮挡场景中的重复框、ID 切换和漏检。
还有几组训练技巧的消融。随机删除轨迹查询的概率 在 0.1 时最好;插入误报查询的概率 在 0.3 时 MOTA 最高,但 IDF1 从 0.1 开始就一路下降。训练时的随机采样间隔以 10 最好,ID 切换 155;间隔 3 和 5 分别是 218 和 324,间隔 12 又略微变差。作者认为间隔太小容易陷入局部最优,太大则学不到这么长距离的变化。
作者自己承认的局限
作者在论文最后列了两个局限。第一,检测新物体的能力远不理想,MOTA 不够好。检测查询被压制、不去找已跟踪的物体,这可能违背了目标查询的本性,也限制了新物体的检测。第二,查询在帧与帧之间依次传递,训练效率受限;他们试过 VisTR 那种并行解码,处理不了多目标跟踪的复杂情况。
后来
第一个局限很快就有了回应。一年多后,同一个团队发表 MOTRv2,把预训练的 YOLOX 检测结果当作锚框式的查询送进 MOTR,让检测交给专门的检测器,MOTR 专心做关联。端到端跟踪和检测之间的冲突,后来也成了这条路线反复讨论的主题,MeMOTR、MOTIP 等后续方法都以 MOTR 一系为比较对象。
ByteTrack 则从另一个方向印证了 MOTR 在 MOT17 上的处境。同样在 MOT17 上,一个好的检测器加上一套精心设计的匹配规则,就能拿到 MOTR 拿不到的分数。
结论
把 DETR 的目标查询延伸成跟着物体走的轨迹查询,用 TALA 分配标签,用 QIM 处理进出与时间聚合,用整段视频的集体平均损失训练。MOTR 从头到尾不需要任何手写的匹配规则,在关联困难的 DanceTrack 上,HOTA 比 ByteTrack 高 6.5。
代价写在 DetA 和 MOTA 那两列。轨迹查询和检测查询挤在同一个解码器里,新物体比较难被找到;在检测主导分数的 MOT17 上,它就输给了简单得多的 ByteTrack。
至于论文里那句「frustratingly inferior」,大概是这一系列论文里最诚实的一句话。