原始論文
CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets
- 發表版本
- ICLR 2025會議
- arXiv 首次提交
- arXiv:2305.12724
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingcomot2023,
  title = {{CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets}},
  author = {Feng Yan and Weixin Luo and Yujie Zhong and Yiyang Gan and Lin Ma},
  year = {2023},
  eprint = {2305.12724},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12724}
}
MOTR 把追蹤整個交給 Transformer:每個人一個查詢,查詢跟著人走過一幀又一幀,不需要卡爾曼濾波,也不需要匈牙利演算法。
這個設計很漂亮,成績卻一直追不上 ByteTrack 這類「先偵測、再配對」的方法。後來的 MOTRv2 乾脆外掛一個 YOLOX 偵測器,成績上去了,計算量也上去了,原本「端到端」的好處少了一大半。
美團的 Feng Yan、Weixin Luo 等人回頭檢查 MOTR,發現問題不在追蹤,而在訓練時怎麼分配標籤。
定義問題
偵測查詢被晾在一邊
MOTR 的解碼器裡有兩種查詢。追蹤查詢負責已經在追的人,每一幀從上一幀延續下來;偵測查詢負責找新出現的人。
訓練時的標籤分配叫做 TALA(tracking aware label assignment)。它先把已經在追的人配給對應的追蹤查詢,剩下的新生物體,才拿去和偵測查詢做二部匹配。
問題出在「剩下的」太少。作者在 DanceTrack 上統計,新出現的人和已經在追的人,比例是 213 比 25,483。舞台上的舞者幾乎從第一幀就在了,之後很少有人進場。偵測查詢大部分時間都沒有正樣本可以學。
更麻煩的是,TALA 等於在教偵測查詢:已經有人在追的物體,你別碰。推論時,一旦某條軌跡的追蹤查詢跟丟了,偵測查詢也不會去撿這個人。
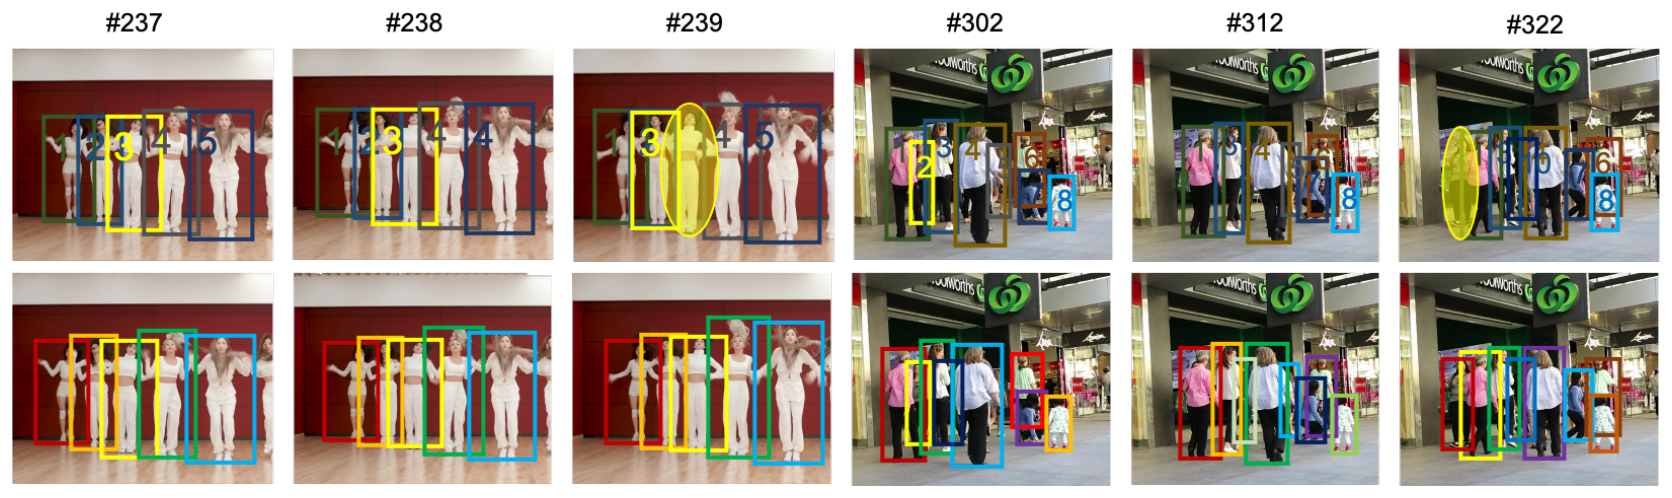
上排是 MOTR 的追蹤結果,下排是同一個模型拿掉追蹤查詢、只做偵測。下排每個人都框到了,可見 MOTR 不是不會偵測,而是追蹤查詢在旁邊的時候,偵測被壓下去了。
把每個框都當成偵測來量
作者把解碼器輸出的所有框,不分追蹤或偵測,全部當成偵測結果,用 mAP 來量:
| 模型 | 訓練用追蹤查詢 | 推論用追蹤查詢 | mAP |
|---|---|---|---|
| MOTR | ✓ | ✓ | 42.5 |
| MOTR | ✓ | 60.6 | |
| MOTRv2 | ✓ | ✓ | 70.7 |
| MOTRv2 | ✓ | 72.1 | |
| CO-MOT | ✓ | ✓ | 69.1 |
整理自原論文 Table 1,DanceTrack 驗證集,最後一層解碼器。
同一個 MOTR,推論時拿掉追蹤查詢,mAP 就從 42.5 跳到 60.6,多了 18.1。MOTRv2 有 YOLOX 提供的偵測結果,拿掉追蹤查詢只多 1.4,偵測的問題幾乎被外掛的偵測器解決了。
CO-MOT 的目標,是不靠外掛偵測器,讓 MOTR 自己的偵測能力回來。
解決問題
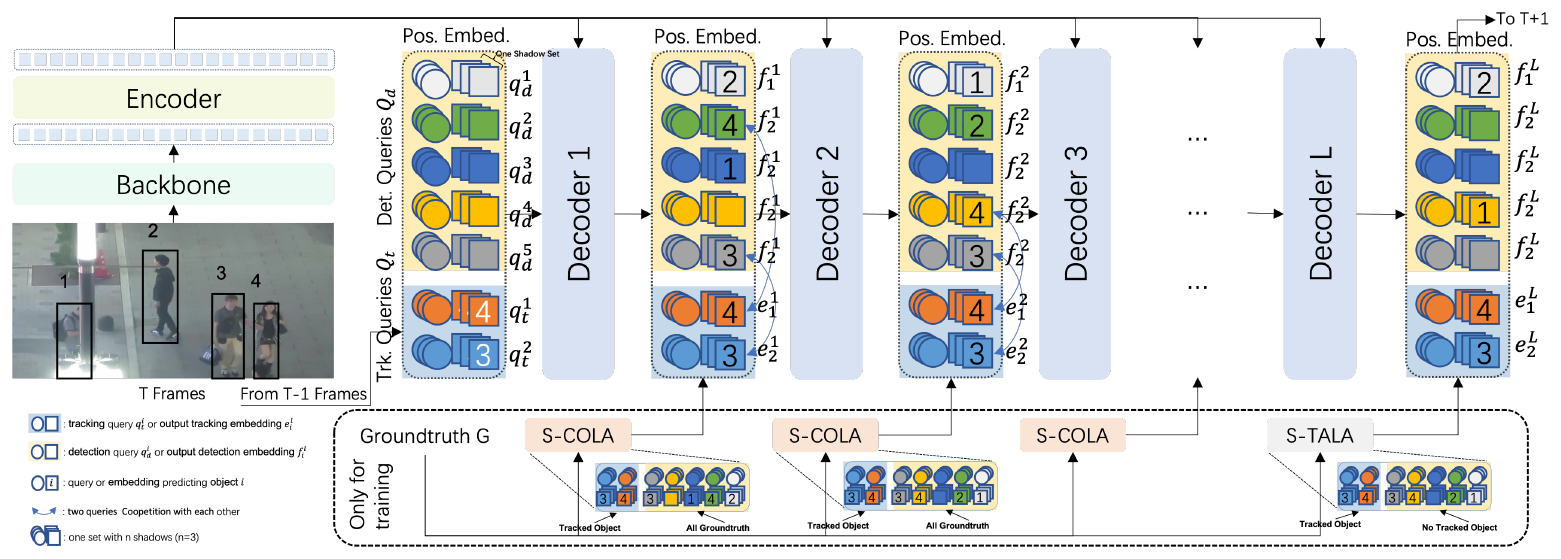
CO-MOT 的架構和 MOTR 一模一樣,改的只有訓練時的標籤分配,分成兩部分。
又合作又競爭
第一個改動叫做 COLA(coopetition label assignment),coopetition 是合作(cooperation)和競爭(competition)的合成字。
解碼器有六層,COLA 讓前五層的偵測查詢除了新物體之外,也可以配上已經在追的人。也就是說,同一個人在中間層可能同時有一個追蹤查詢和一個偵測查詢在預測他。
最後一層仍然用 TALA,已經在追的人只歸追蹤查詢。否則推論時同一個人會冒出兩條軌跡。
這樣做的好處來自解碼器裡的自注意力。所有查詢會互相看,偵測查詢看到的是這一幀的畫面,追蹤查詢帶著過去的記憶。兩者在預測同一個人時,偵測查詢可以把這一幀的資訊傳給追蹤查詢,在外觀變化大的時候幫它一把。
中間層合作,最後一層競爭,所以叫做 coopetition。
每個查詢都有影子
第二個改動是影子集合(shadow set)。
DETR 類的模型用一對一匹配,一個物體只有一個查詢拿到正樣本。Co-DETR、H-DETR 的對策是一對多,讓多個查詢學同一個物體。CO-MOT 則是把每個查詢複製成 個影子,整組一起負責同一個物體。
影子的初始化很講究。完全隨機,同一組的影子差太多,很難收斂;完全一樣,又失去了多一組的意義。作者把同一組初始化成同一個可學的向量,再加上標準差 的雜訊。差異一開始幾乎看不出來,訓練結束時擴大到 左右。
訓練時,一組影子要選一個代表去做匹配。追蹤查詢的組直接配上一幀的目標;偵測查詢的組,則先算出每個影子對每個物體的匹配成本,再取最大的那個當代表。也就是說,這組影子配給誰,由組裡最差的那一個決定。組內其他影子共用匹配結果,一起拿正樣本。
推論時反過來,用組內最低的信心分數判斷這組是否追到人,通過了,再輸出分數最高的那個影子的框。
一個數正樣本的例子
我們用一段訓練片段,看看這兩個改動讓偵測查詢多學了多少。
CO-MOT 訓練時每次取 5 幀。假設 10 位舞者從第 1 幀起都在畫面裡,中途沒人進出,解碼器 6 層。
- TALA。 第 1 幀還沒有追蹤查詢,10 個人全部是新物體,歸偵測查詢。第 2 到 5 幀,所有人都歸追蹤查詢。偵測查詢每層只有 10 個正樣本,6 層共 60 個。
- COLA。 前 5 層,偵測查詢可以配上 5 幀裡的所有物體,每層 50 個,共 250 個;最後一層維持 10 個。合計 260 個。
- 再加影子。 每組 3 個影子都拿到正樣本,偵測查詢的正樣本變成 780 個。
本文整理的算例。
追蹤查詢的正樣本一個都沒少,偵測查詢的正樣本則從 60 個變成 780 個。
討論
兩個改動各自的貢獻
| 設定 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| MOTR 基準 | 56.4 | 71.8 | 44.6 | 57.5 |
| +COLA | 60.2 | 73.2 | 49.7 | 62.4 |
| +影子集合 | 59.0 | 72.6 | 48.2 | 59.6 |
| 兩者都加 | 61.8 | 73.5 | 52.2 | 63.3 |
整理自原論文 Table 4,DanceTrack 驗證集。
COLA 單獨加 3.8 HOTA,影子集合單獨加 2.6,兩者合計 5.4。
有趣的是 DetA 只從 71.8 到 73.5,AssA 卻從 44.6 跳到 52.2。COLA 表面上是給偵測查詢更多正樣本,看起來應該幫偵測,實際上幫的是關聯。
偵測查詢真的在幫忙嗎
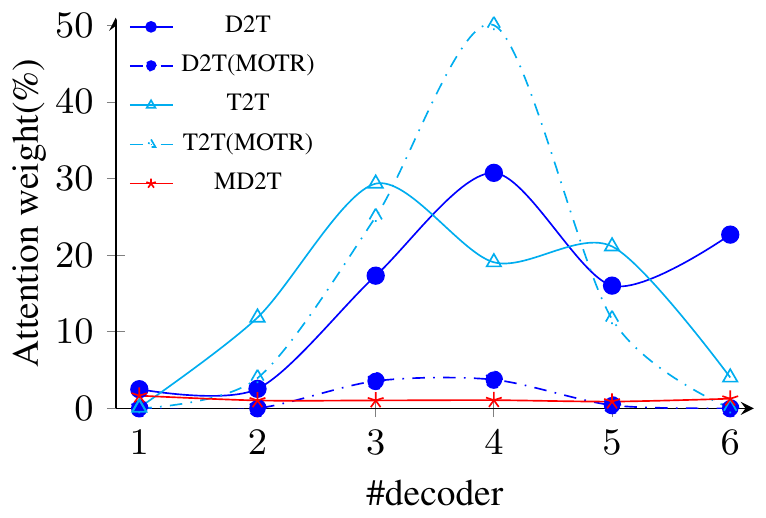
為了確認這件事,作者畫出解碼器每一層的注意力權重。兩個框的 IoU 超過 0.7,就視為預測同一個人。
CO-MOT 裡,預測同一個人的偵測查詢,從第 3 層開始對追蹤查詢的貢獻超過 15%,第 4 和第 6 層甚至超過追蹤查詢對自己的注意力。MOTR 裡,同樣的數值在第 4 層只有 3.74%,CO-MOT 則是 30.74%。
MOTR 的偵測查詢和追蹤查詢負責不同的人,彼此沒什麼好說的。CO-MOT 讓它們在中間層盯著同一個人,資訊就流過去了。
影子的細節
- 初始化。 同一向量加微小雜訊的 HOTA 是 61.5,完全複製 60.6,完全隨機 59.6。
- 代表怎麼選。 訓練用最大成本、推論用最低分數,組合最好;推論改用最高分數,不管訓練怎麼選都最差。訓練時讓最難的影子決定匹配,模型被迫把每個影子都學好。
- 影子的數量。 3 個最好(61.8),2 個是 61.5;再多就難收斂。
- COLA 用幾層。 只用在第一層 59.0,前三層 59.6,前五層 59.9,用得越多越好。
和其他方法比
在 DanceTrack 測試集,只用 DanceTrack 訓練的 CO-MOT,HOTA 是 65.3,比 MOTR 高 11.1,也高於同樣用 ResNet-50 的 MeMOTR(63.4)。加入 CrowdHuman 一起訓練的 CO-MOT+,HOTA 69.4,和外掛 YOLOX 的 MOTRv2(69.9)只差 0.5,AssA 則幾乎一樣(58.9 對 59.0)。
| 模型 | 參數 | 計算量 | 速度 | HOTA |
|---|---|---|---|---|
| MOTR | 40M | 173G | 19 FPS | 54.2 |
| MOTRv2 | 139M | 455G | 14 FPS | 69.9 |
| CO-MOT+ | 40M | 173G | 19 FPS | 69.4 |
整理自原論文 Figure 4,DanceTrack 測試集。
這張表是 CO-MOT 最有說服力的地方。和 MOTR 一樣的參數量和計算量,成績追上 MOTRv2,計算量只有它的 38%,速度快 1.4 倍。改的只有訓練方式,推論時沒有多付任何代價。
BDD100K 上,TETA 52.8,高於 MOTR 的 50.7,但低於 MOTRv2 的 54.9;不過 AssocA 是 56.2,高於 MOTRv2 的 51.9。
MOT17 還是過不去
MOT17 測試集上,CO-MOT 的 HOTA 是 60.1,比 MOTR 的 57.8 好,但仍低於 ByteTrack 的 63.1;MOTA 72.6 更是落後 ByteTrack 的 80.3 一大截。
作者的解釋有兩點。第一,MOT17 的訓練集只有大約 5,000 幀,對 Transformer 來說太少。第二,MOT17 小目標多:面積不到畫面 0.5% 的框,在 MOT17 佔 60.26%,在 DanceTrack 只佔 1.17%。論文列出的失敗案例,多半是明顯的人沒有被偵測到。
CO-MOT 讓 MOTR 的偵測能力不再被追蹤壓制,但 MOTR 本身偵測小物體的能力,它改變不了。
結論
CO-MOT 找到 MOTR 訓練時的一個盲點。偵測查詢被教成「別碰已經在追的人」,結果在追蹤查詢跟丟時,沒有人能把人撿回來。
COLA 讓兩種查詢在中間層一起看同一個人,影子集合讓每個物體有多個查詢一起學。兩個改動都只影響訓練,推論的架構和 MOTR 完全相同。
在 DanceTrack 上,不外掛偵測器的 CO-MOT+ 和外掛 YOLOX 的 MOTRv2 只差 0.5 HOTA,計算量卻不到它的四成。到了小目標多、資料又少的 MOT17,和先偵測再配對的方法之間,差距還在。