原始论文
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2305.18290
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningdpo2023,
  title = {{Direct Preference Optimization: Your Language Model is Secretly a Reward Model}},
  author = {Rafael Rafailov and Archit Sharma and Eric Mitchell and Stefano Ermon and Christopher D. Manning and Chelsea Finn},
  year = {2023},
  eprint = {2305.18290},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.18290}
}
RLHF 的流程到了 2023 年已经很固定了。先做监督微调(SFT),再收集人类对两个回答的偏好、训练一个奖励模型,最后用 PPO 让语言模型去拿高分,同时用 KL 惩罚拉住它,别离原来的模型太远。
这套流程很有效,ChatGPT 就是这样训练出来的,但也很麻烦。PPO 训练时要同时放着好几个大模型,包括正在训练的策略、固定不动的参考模型、奖励模型,通常还有一个价值函数;而且训练过程中要不断从策略采样,超参数又多,很容易训练不稳定。
Stanford 的 Rafailov、Sharma、Mitchell 等人在这篇论文里给出了一个有点出人意料的结果。RLHF 想优化的那个目标,其实可以不用强化学习,只用一个二分类损失就能直接求解。奖励模型也不用另外训练,因为语言模型本身就隐含了一个。
定义问题
先把 RLHF 写成式子。
给定提示词 ,SFT 模型生成两个回答,标注者选出比较好的 和比较差的 。假设这些偏好背后有一个看不到的真实奖励 ,并且服从 Bradley-Terry 模型,也就是「 胜过 」的概率由两者的奖励差决定:
第一步用最大似然训练奖励模型 :
第二步让策略 去拿高分,但不能离参考模型 (通常就是 SFT 模型)太远:
控制拉得多紧。语言生成是离散的,这个目标没办法直接求导,所以才需要 PPO 这类强化学习算法。
问题是,这两步能不能并成一步?
解决问题
最优策略有闭式解
关键在第二步那个带 KL 约束的最大化问题。前人已经证明,它的最优解可以直接写出来:
意思是,从参考模型出发,奖励越高的回答,概率就乘上越大的倍数,再整体归一化。
既然有闭式解,为什么大家还要用 PPO?因为 要把所有可能的回答加总,对语言模型来说根本算不出来。
换个方向写
作者的做法是把上式反过来,两边取对数,用策略来表示奖励:
还在,但它只和提示词 有关,和回答 无关。而 Bradley-Terry 模型只看两个回答的奖励差,同一个提示词下的两个回答一相减, 就消掉了:
隐式奖励和原来的奖励只差 。这个常数对同一个提示的每个回答都一样,两个回答的奖励一相减就消掉了,所以上式只用策略,就能算出和原来的奖励完全相同的偏好概率。
DPO 的损失
既然偏好概率可以只用策略写出来,就直接拿它取代奖励模型那一步的最大似然。把 换成要训练的 :
和奖励模型的损失长得一模一样,只是 换成了 。训练语言模型,就等于在训练一个奖励模型,而这个奖励模型对应的最优策略,就是语言模型自己。论文的副标题「你的语言模型其实是一个奖励模型」说的就是这个。
作者也证明了,这样的变量替换没有限制住能表示的奖励函数。和 一样只依赖提示词的那一部分,本来就不影响偏好概率,也不影响最优策略;每一类等价的奖励函数,都能用 的形式表示。
实现只要几行,论文附录直接给出了 PyTorch 代码。我们拿两组偏好试算一下,每个回答的对数概率是整句的总和:
import torch
import torch.nn.functional as F

def dpo_loss(pi_logps, ref_logps, yw_idxs, yl_idxs, beta):
    """论文附录 B 的实现"""
    pi_yw_logps, pi_yl_logps = pi_logps[yw_idxs], pi_logps[yl_idxs]
    ref_yw_logps, ref_yl_logps = ref_logps[yw_idxs], ref_logps[yl_idxs]
    pi_logratios = pi_yw_logps - pi_yl_logps
    ref_logratios = ref_yw_logps - ref_yl_logps
    losses = -F.logsigmoid(beta * (pi_logratios - ref_logratios))
    rewards = beta * (pi_logps - ref_logps).detach()
    return losses, rewards

# 两组偏好:回答 0 胜过 1,回答 2 胜过 3(整句回答的对数概率)
ref_logps = torch.tensor([-12.0, -11.0, -20.0, -21.0])
pi_logps = torch.tensor([-11.0, -12.0, -21.0, -18.0], requires_grad=True)
yw, yl = torch.tensor([0, 2]), torch.tensor([1, 3])

losses, rewards = dpo_loss(pi_logps, ref_logps, yw, yl, beta=0.1)
losses.sum().backward()
print(losses.detach().numpy().round(3), rewards.numpy().round(2))
print(pi_logps.grad.numpy().round(3))

# [0.598 0.913] [ 0.1 -0.1 -0.1  0.3]
# [-0.045  0.045 -0.06   0.06 ]
第一组,策略已经比参考模型更偏好好的回答,隐式奖励是 0.1 对 −0.1,排序正确,损失 0.598。第二组,策略反而把差的回答 3 的概率拉高了,隐式奖励 −0.1 对 0.3,排错了,损失 0.913。
梯度的方向是一样的,好的回答概率往上推、差的往下压。差别在大小,第二组的梯度是 0.06,第一组是 0.045。把梯度展开来看就知道原因:
是隐式奖励。隐式奖励排错得越多,那组样本的权重越大;已经排对的,权重就小。作者也指出,去掉这个权重的简化版本会让语言模型退化,附录里有对应的实验。
整个流程只剩两步。对每个提示词采样两个回答、请人标注偏好,然后直接用 DPO 损失训练。实践中更常见的是直接拿现成的偏好数据集来用;参考模型最好是当初生成这些回答的 SFT 模型,没有的话,就先用偏好数据里好的那个回答做一次监督微调,当作参考模型。
超参数几乎不用调。论文默认 ,摘要任务用 ,批大小 64,RMSprop,学习率 ,前 150 步线性预热。
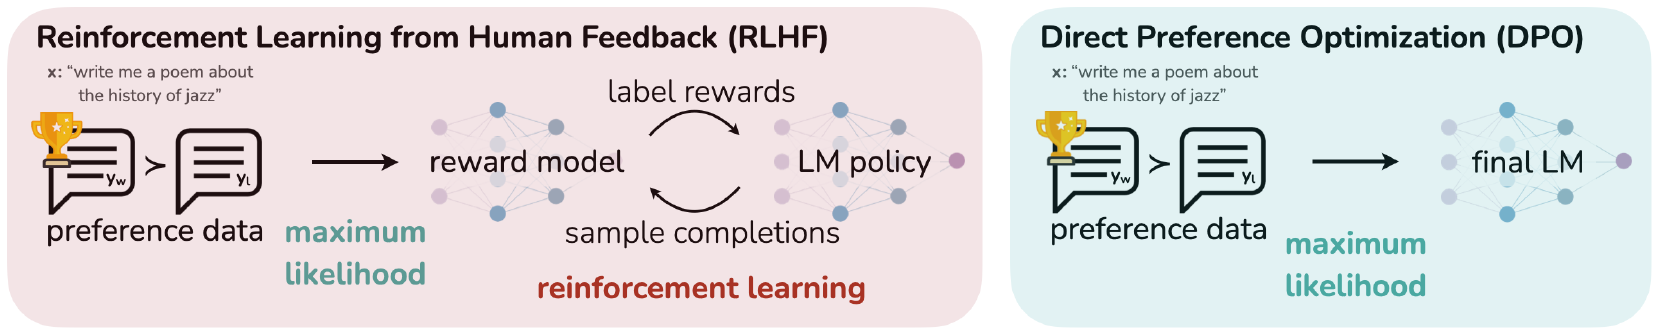
左右两边放在一起看就很清楚。RLHF 的奖励模型和强化学习循环,整个被一个最大似然的步骤取代了。
讨论
作者用三个任务做比较,模型最大 60 亿参数。
同一个目标,谁优化得更好
第一个任务是可控的情感生成。给出 IMDb 影评的开头,模型要接着写出正面的评论。这里的偏好由一个预训练好的情感分类器产生,所以「真实奖励」是已知的,可以精确地比较不同算法。模型是 GPT-2-large。
RLHF 的目标既要拿高分、又要离参考模型近,所以比较时不能只看分数,要看奖励和 KL 散度之间的取舍。作者对每种方法扫了不同的超参数,一共 22 组训练。
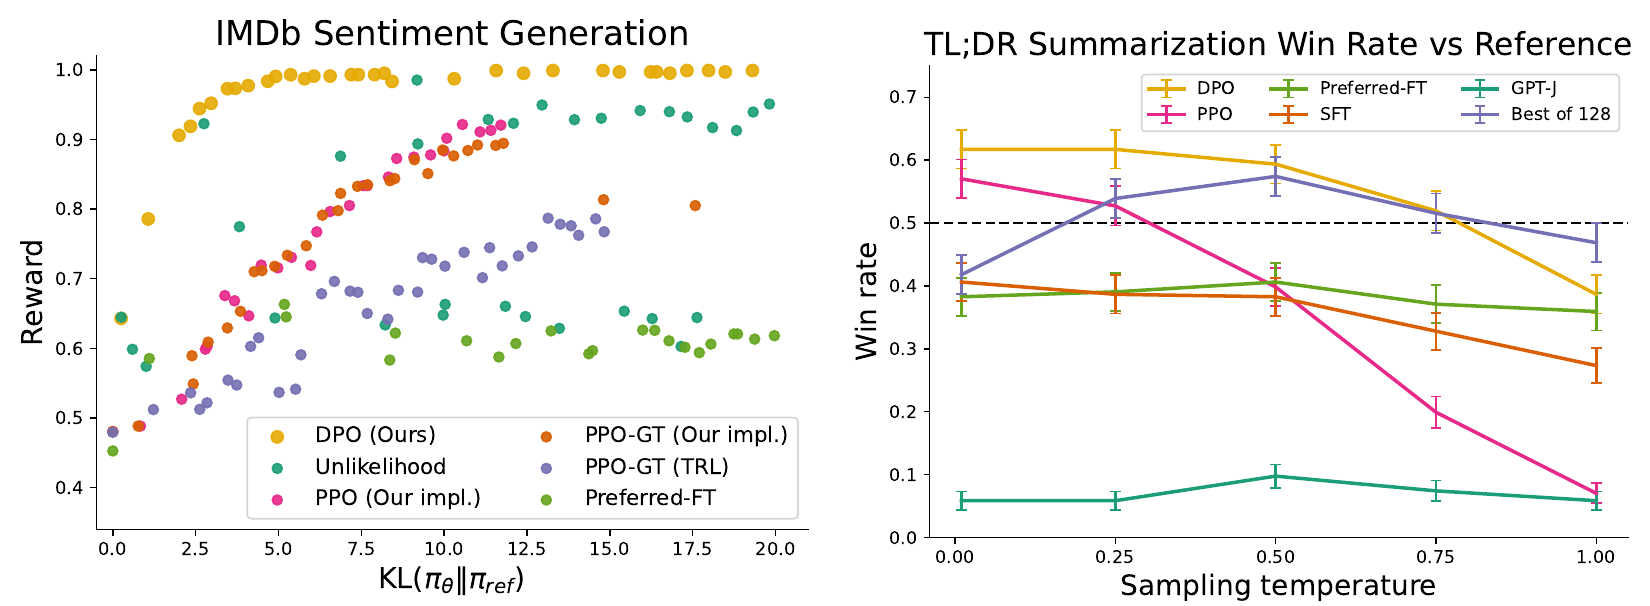
先看左图。横轴是和参考模型的 KL 散度,纵轴是奖励,越往左上越好。黄色的 DPO 在 KL 很小的地方就把奖励推到接近 1,整条前沿都压在其他方法上面。PPO 优化的是同一个目标,效率却明显差一截;连能直接读取真实奖励的 PPO-GT,前沿也不如 DPO。
摘要与对话
右图是第二个任务,Reddit TL;DR 摘要,用的正是 Stiennon 等人收集的人类偏好。所有方法都从同一个 GPT-J SFT 模型出发,请 GPT-4 判断模型的摘要和人写的参考摘要哪个好。
DPO 在温度 0 时胜率约 61%,PPO 在它最好的温度(也是 0)约 57%。更明显的差别在温度升高时,PPO 一路掉到和没微调的 GPT-J 差不多,DPO 则稳定得多。作者也做了人工评估,DPO(温度 0.25)对上 PPO(温度 0),有 58% 的时候被偏好。
第三个任务是 Anthropic HH 的单轮对话,数据有约 17 万段对话,每段结尾附两个回答和人类偏好。这里没有现成的 SFT 模型,作者先拿 Pythia-2.8B 在偏好数据里好的回答上微调,当作参考模型,再做 DPO。
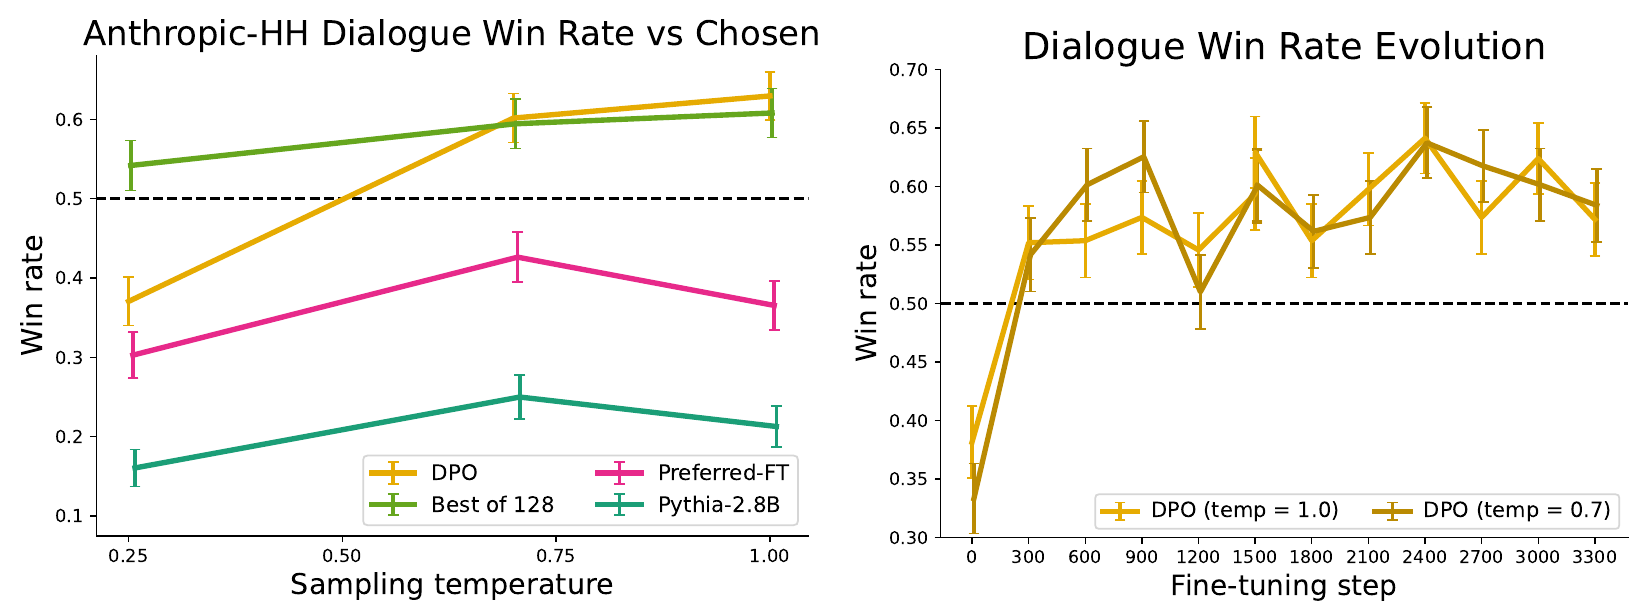
虚线 0.5 代表和数据集里被选中的回答打平。DPO 是唯一能超过这条线、又不必大量采样的方法;best of 128 也超过了,但每个问题都要抽 128 个回答再用奖励模型挑,推理成本高得多。作者也试了一个公开的 PPO 版本,找不到任何提示词或温度能让它胜过原来的 Pythia-2.8B。右图则显示 DPO 收敛得很快,几百步就到了最佳水平附近。
换到没见过的数据
作者把在 TL;DR 上训练的模型直接拿去摘要 CNN/DailyMail 的新闻,看看会不会只学到 Reddit 的样子。用 GPT-4 判断相对于人写摘要的胜率,温度 0 时 DPO 是 0.36、PPO 是 0.26;温度 0.25 时是 0.31 对 0.23。DPO 仍然领先,而且 PPO 训练时还多用了 Reddit 上没有标注的提示词。
GPT-4 当评委可信吗
整个实验都靠 GPT-4 当评委,作者也检查了它和人类的一致程度。用最简单的提示词问「哪个摘要更好地涵盖了重点」时,GPT-4 比人类更偏好冗长、重复的摘要;换成同时要求简洁的提示词,GPT-4 的判断就更接近人类。在三组比较里,GPT-4 和人类的一致率在 67% 到 86% 之间,人类彼此之间是 65% 到 87%,大致相当。
还没回答的问题
作者自己列了几个:
- DPO 的策略换到没见过的数据上,表现能不能一直和用显式奖励模型训练的方法一样好?上面那个新闻摘要实验只是初步的证据。
- 奖励过度优化在 DPO 里会以什么形式出现?对话实验里,DPO 的胜率在训练后段略有下滑,会不会就是一个例子?
- 实验最大只到 6B,能不能扩展到大好几个数量级的模型?
- GPT-4 的评分会随提示词改变,怎么从自动评委那里拿到可靠的判断?
后来的事
DPO 很快就被大量采用。2024 年的 Llama 3 后训练就是好几轮的 SFT 加 DPO,Meta 也比较过 PPO,结论是 DPO 在大模型上更省算力,在指令遵循上表现也更好;同年的 Tülu 3 把 DPO 放在 SFT 之后,作为完全公开的后训练配方的一环。
反对的声音也有。2024 年的 Is DPO Superior to PPO for LLM Alignment? 认为,DPO 可能找到有偏的解,利用偏好数据分布之外的回答;当模型自己的输出和偏好数据的分布差得很远时,表现会明显下降。他们把 PPO 好好调参之后,在对话和代码生成上都胜过了 DPO,在最难的编程竞赛题上差距最大。
而到了 2025 年,推理模型又把强化学习请了回来,只是这次的奖励往往来自可以自动验证的答案,而不是人类偏好。
结论
DPO 的核心是一次变量替换。KL 约束下的最优策略有闭式解,把它反过来用策略表示奖励,难算的配分函数在 Bradley-Terry 的相减里消掉,RLHF 就变成了一个二分类损失。不用训练奖励模型,不用在训练中采样,也不用 PPO 那一大堆超参数。
如果你手上有成对的偏好数据,DPO 会是最先该试的方法;但记得参考模型要尽量贴近生成这些数据的模型,分布差得太远,它的表现就会打折扣。
论文说强化学习可以不用;一年后,Llama 3 的后训练真的把 PPO 换成了 DPO。